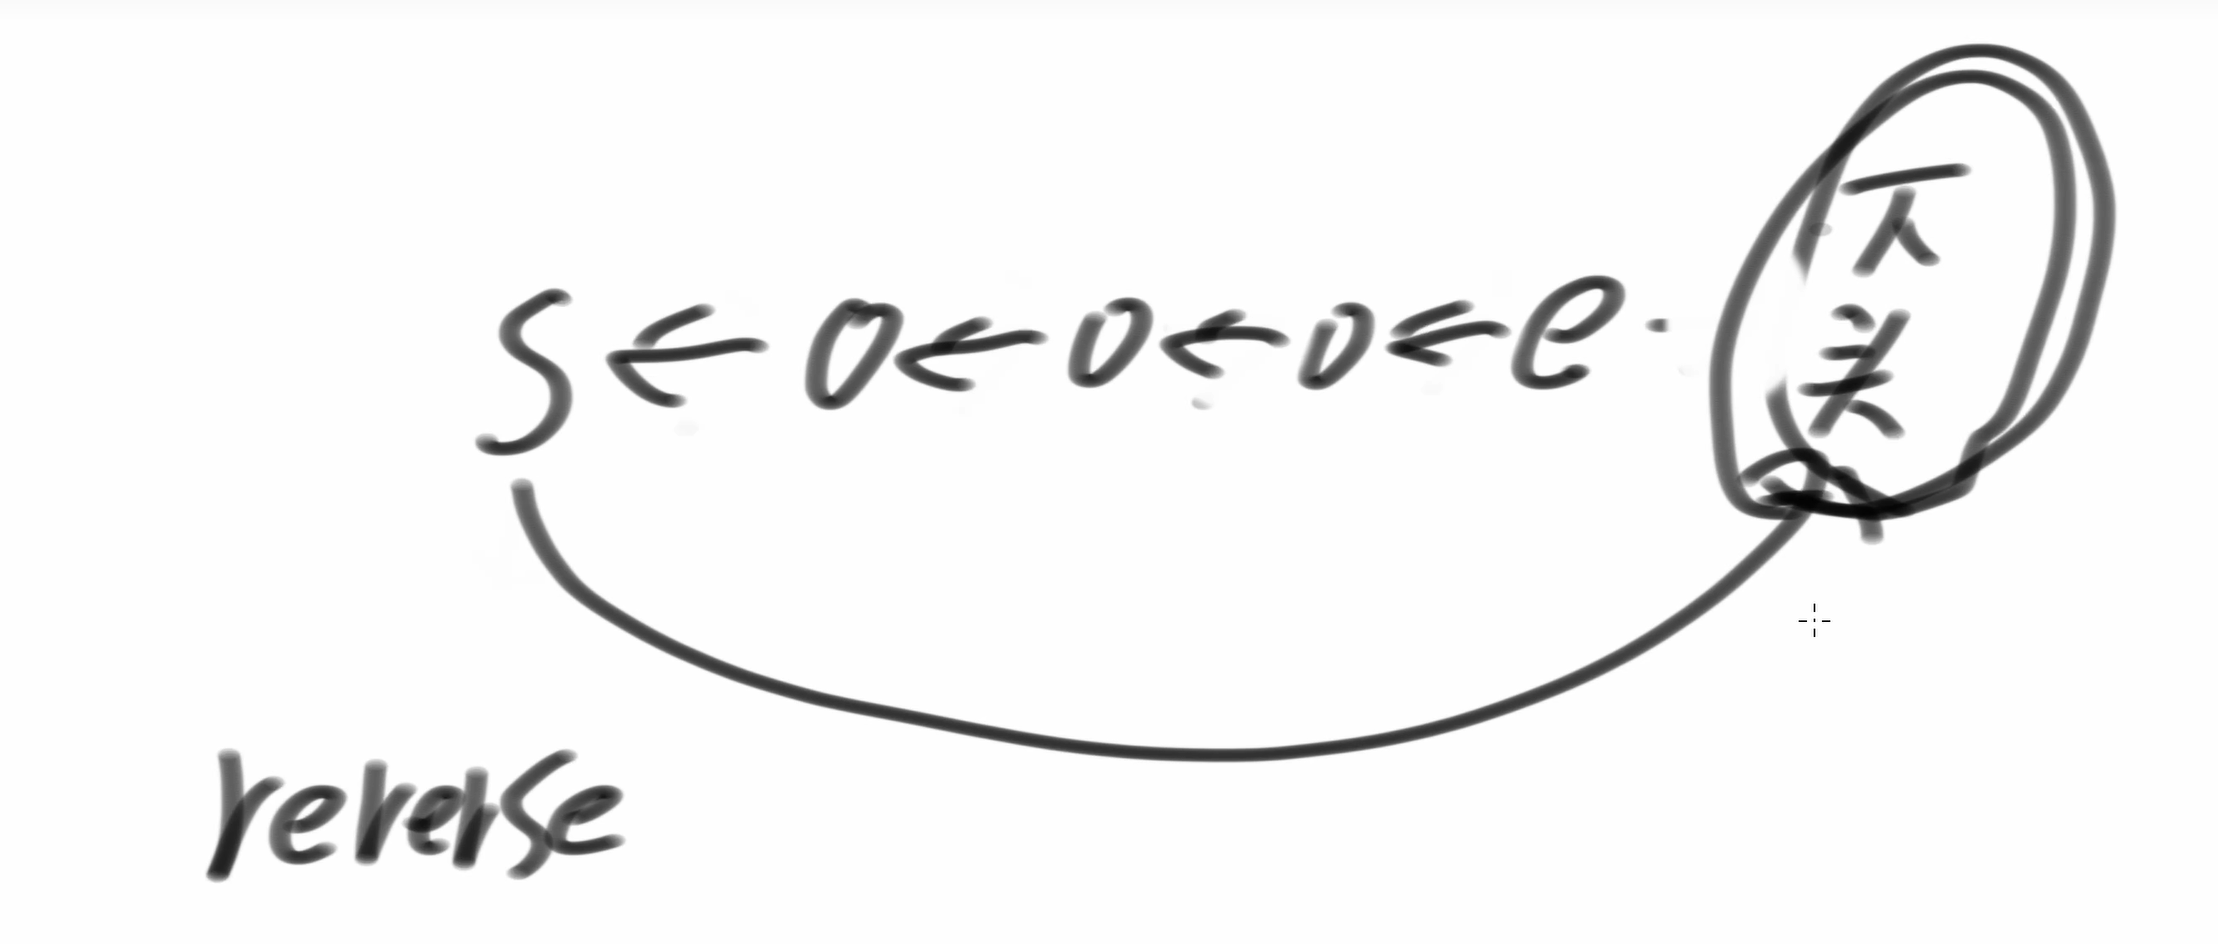0%

引言

参照的是左程云的课程:https://space.bilibili.com/8888480/lists/3509640?type=series

本笔记是讲解039的内容,总结了嵌套类问题的递归解题套路。这类问题的共同特点是存在嵌套结构(如括号嵌套),需要用递归来处理。

前置知识

在学习嵌套类问题之前,需要掌握以下基础知识:

  • 讲解017、020、021、023、036、037、038
  • 这些章节都分析过递归,尤其是讲解038,不熟悉的同学可以先熟悉一下

039【必备】嵌套类问题的递归解题套路

核心解题思路

基本套路模板

嵌套类问题的解题套路可以概括为:

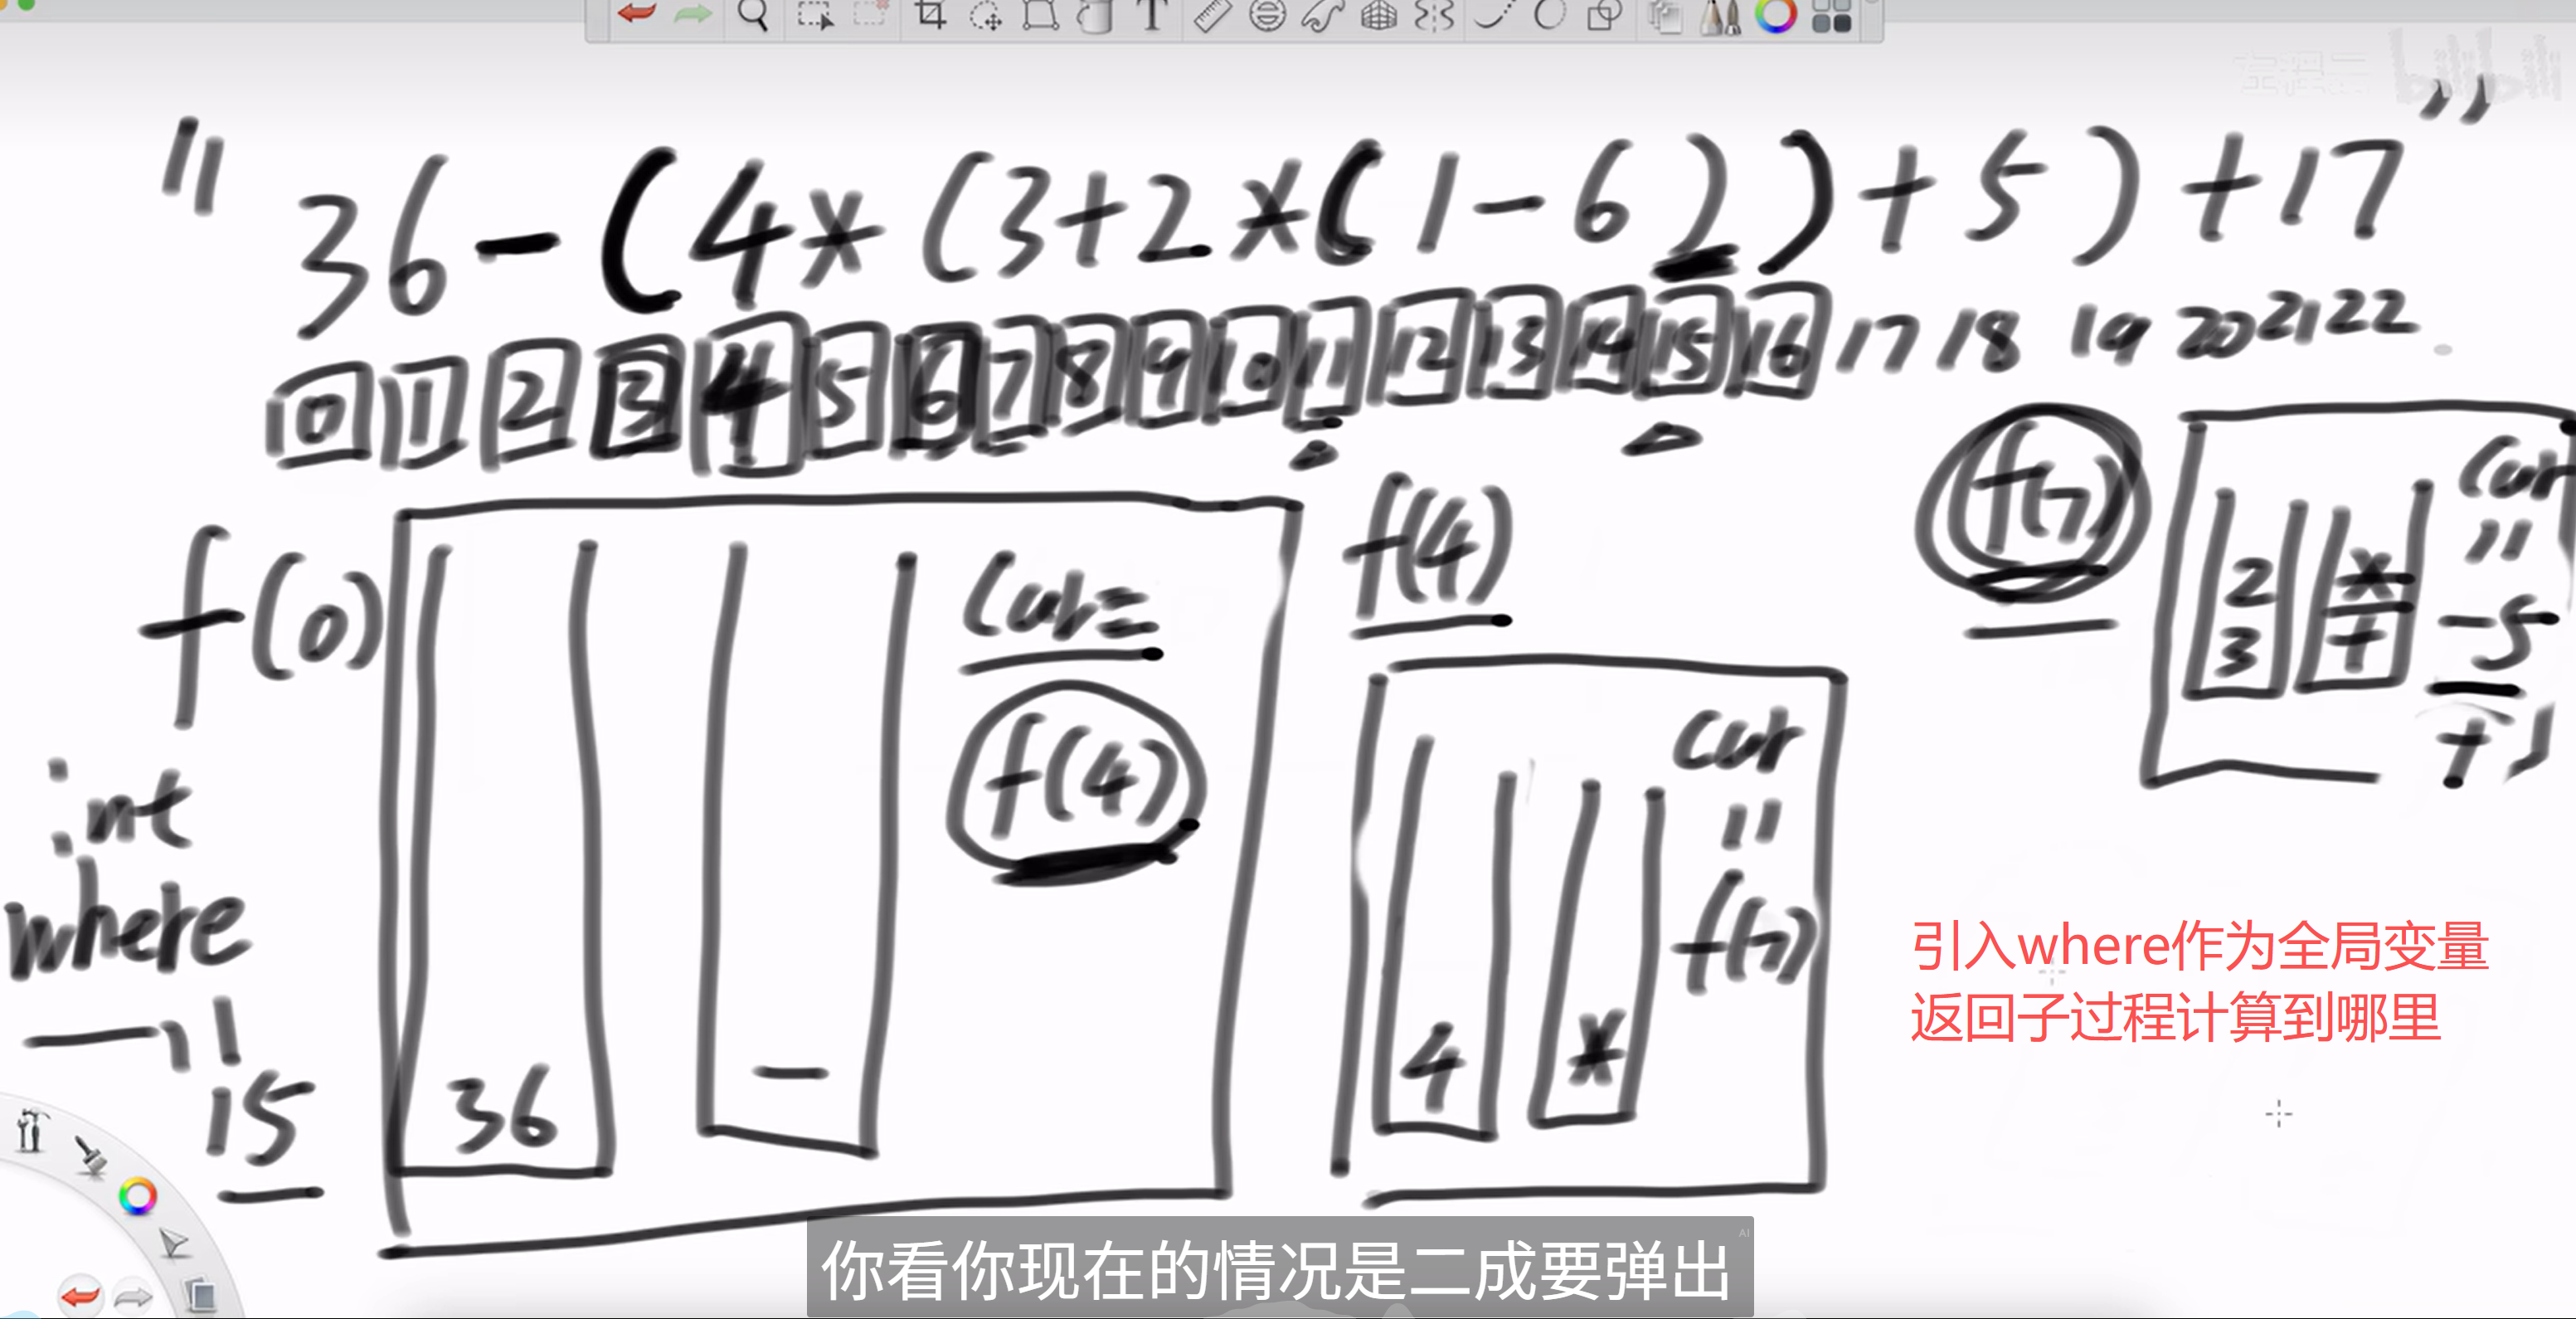
  1. 定义全局变量 where:记录当前解析到的位置
  2. 递归函数 f(i):从位置i开始解析,遇到字符串终止或嵌套条件终止就返回
  3. 返回值机制:f(i)负责这一段的结果,返回前更新全局变量where
  4. 位置传递:让上级函数通过where知道解析到了什么位置,进而继续

执行细节

  • 如果f(i)遇到嵌套条件开始,就调用下级递归去处理嵌套
  • 下级会负责嵌套部分的计算结果
  • f(i)下级处理完成后,可以根据下级更新的全局变量where,知道该从什么位置继续解析

题目一:含有嵌套的表达式求值

问题描述

请写一个整数计算器,支持加减乘三种运算和括号。

  • 数据范围:0 < |s| < 100,保证计算结果始终在整型范围内
  • 要求:空间复杂度 O(n),时间复杂度 O(n)

测试链接:

核心思想

使用递归处理括号嵌套,同时用两个列表分别存储数字和操作符。通过push辅助函数处理运算优先级:

  • 乘除法优先级高:遇到时立即计算,并更新数字列表的最后一个数
  • 加减法优先级低:先将数字和操作符存入列表
  • 遇到左括号(:递归调用自身 _f 来计算括号内的值,把它当作一个整体的数字
  • 遇到右括号 ) 或字符串末尾:结束当前层级的计算,并对 numbers 和 ops 列表中的加减法进行最终求和

实现三种运算符的底层逻辑

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
class Solution:
def calculate(self, s: str) -> int:
"""
主函数,初始化共享索引并启动递归
"""
self.where = 0
return self._f(list(s), 0)

# s[i....]开始计算,遇到字符串终止 或者 遇到)停止
# 返回 : 自己负责的这一段,计算的结果
# 返回之间,更新全局变量where,为了上游函数知道从哪继续!
def _f(self, s: List[str], i: int) -> int:
"""
递归函数,处理一个括号内的或整个表达式的求值
"""
cur = 0
numbers = []
ops = []

while i < len(s) and s[i] != ')': # 未终止且未遇到右括号
if s[i].isdigit(): # 是数字
cur = cur * 10 + int(s[i])
i += 1
elif s[i] != '(': # 不是左括号
# 遇到了运算符 + - * /
self._push(numbers, ops, cur, s[i])
i += 1
cur = 0
else: # 是左括号
# i (.....)
# 遇到了左括号!
# 递归调用 f,计算括号内的结果
cur = self._f(s, i + 1)
# 递归返回后,where 指向了 ')' 的位置,i 需要跳到 ')' 之后
i = self.where + 1

# 如果碰到了右括号,将最后一个数字(或括号运算结果)加入列表,并更新全局索引
self._push(numbers, ops, cur, '+') # 末尾添加一个 '+' 不影响最终计算
# 更新全局索引,让上级函数知道从哪继续
self.where = i
return self._compute(numbers, ops)

def _push(self, numbers: List[int], ops: List[str], cur: int, op: str):
"""辅助函数,处理数字和操作符的入栈逻辑,并处理乘除法"""
if not numbers or ops[-1] == '+' or ops[-1] == '-':
# 如果是第一个数,或者前一个运算符是+或-,直接入栈
numbers.append(cur)
ops.append(op)
else:
# 如果前一个运算符是*或/,立即计算
top_number = numbers[-1]
top_op = ops[-1]
if top_op == '*':
numbers[-1] = top_number * cur
else: # top_op == '/'
# Python 的 // 是向下取整,题目要求向零取整
numbers[-1] = int(top_number / cur)
ops[-1] = op # 更新操作符

# 具体例子
# 原始:3 * 4 + 5
# 处理到 * 4 时:
# - numbers: [3, 4] → [12] (3*4=12)
# - ops: ['*'] → ['+'] (更新操作符)
# 这样下一个数字 5 就能正确地与 12 进行加法运算

def _compute(self, numbers: List[int], ops: List[str]) -> int:
"""辅助函数,计算只有加减法的最终结果"""
ans = numbers[0]
for i in range(1, len(numbers)):
ans += numbers[i] if ops[i - 1] == '+' else -numbers[i]
return ans

算法分析

  • 时间复杂度:O(n)
  • 空间复杂度:O(n)
  • 核心技巧:递归处理嵌套 + 分离处理优先级

题目二:含有嵌套的字符串解码

问题描述

给定一个经过编码的字符串,返回它解码后的字符串。
编码规则为:k[encoded_string],表示其中方括号内部的 encoded_string 正好重复 k 次。

示例:输入:s = "3[a2[c]]",输出:"accaccacc"

测试链接:https://leetcode.cn/problems/decode-string/

核心思想

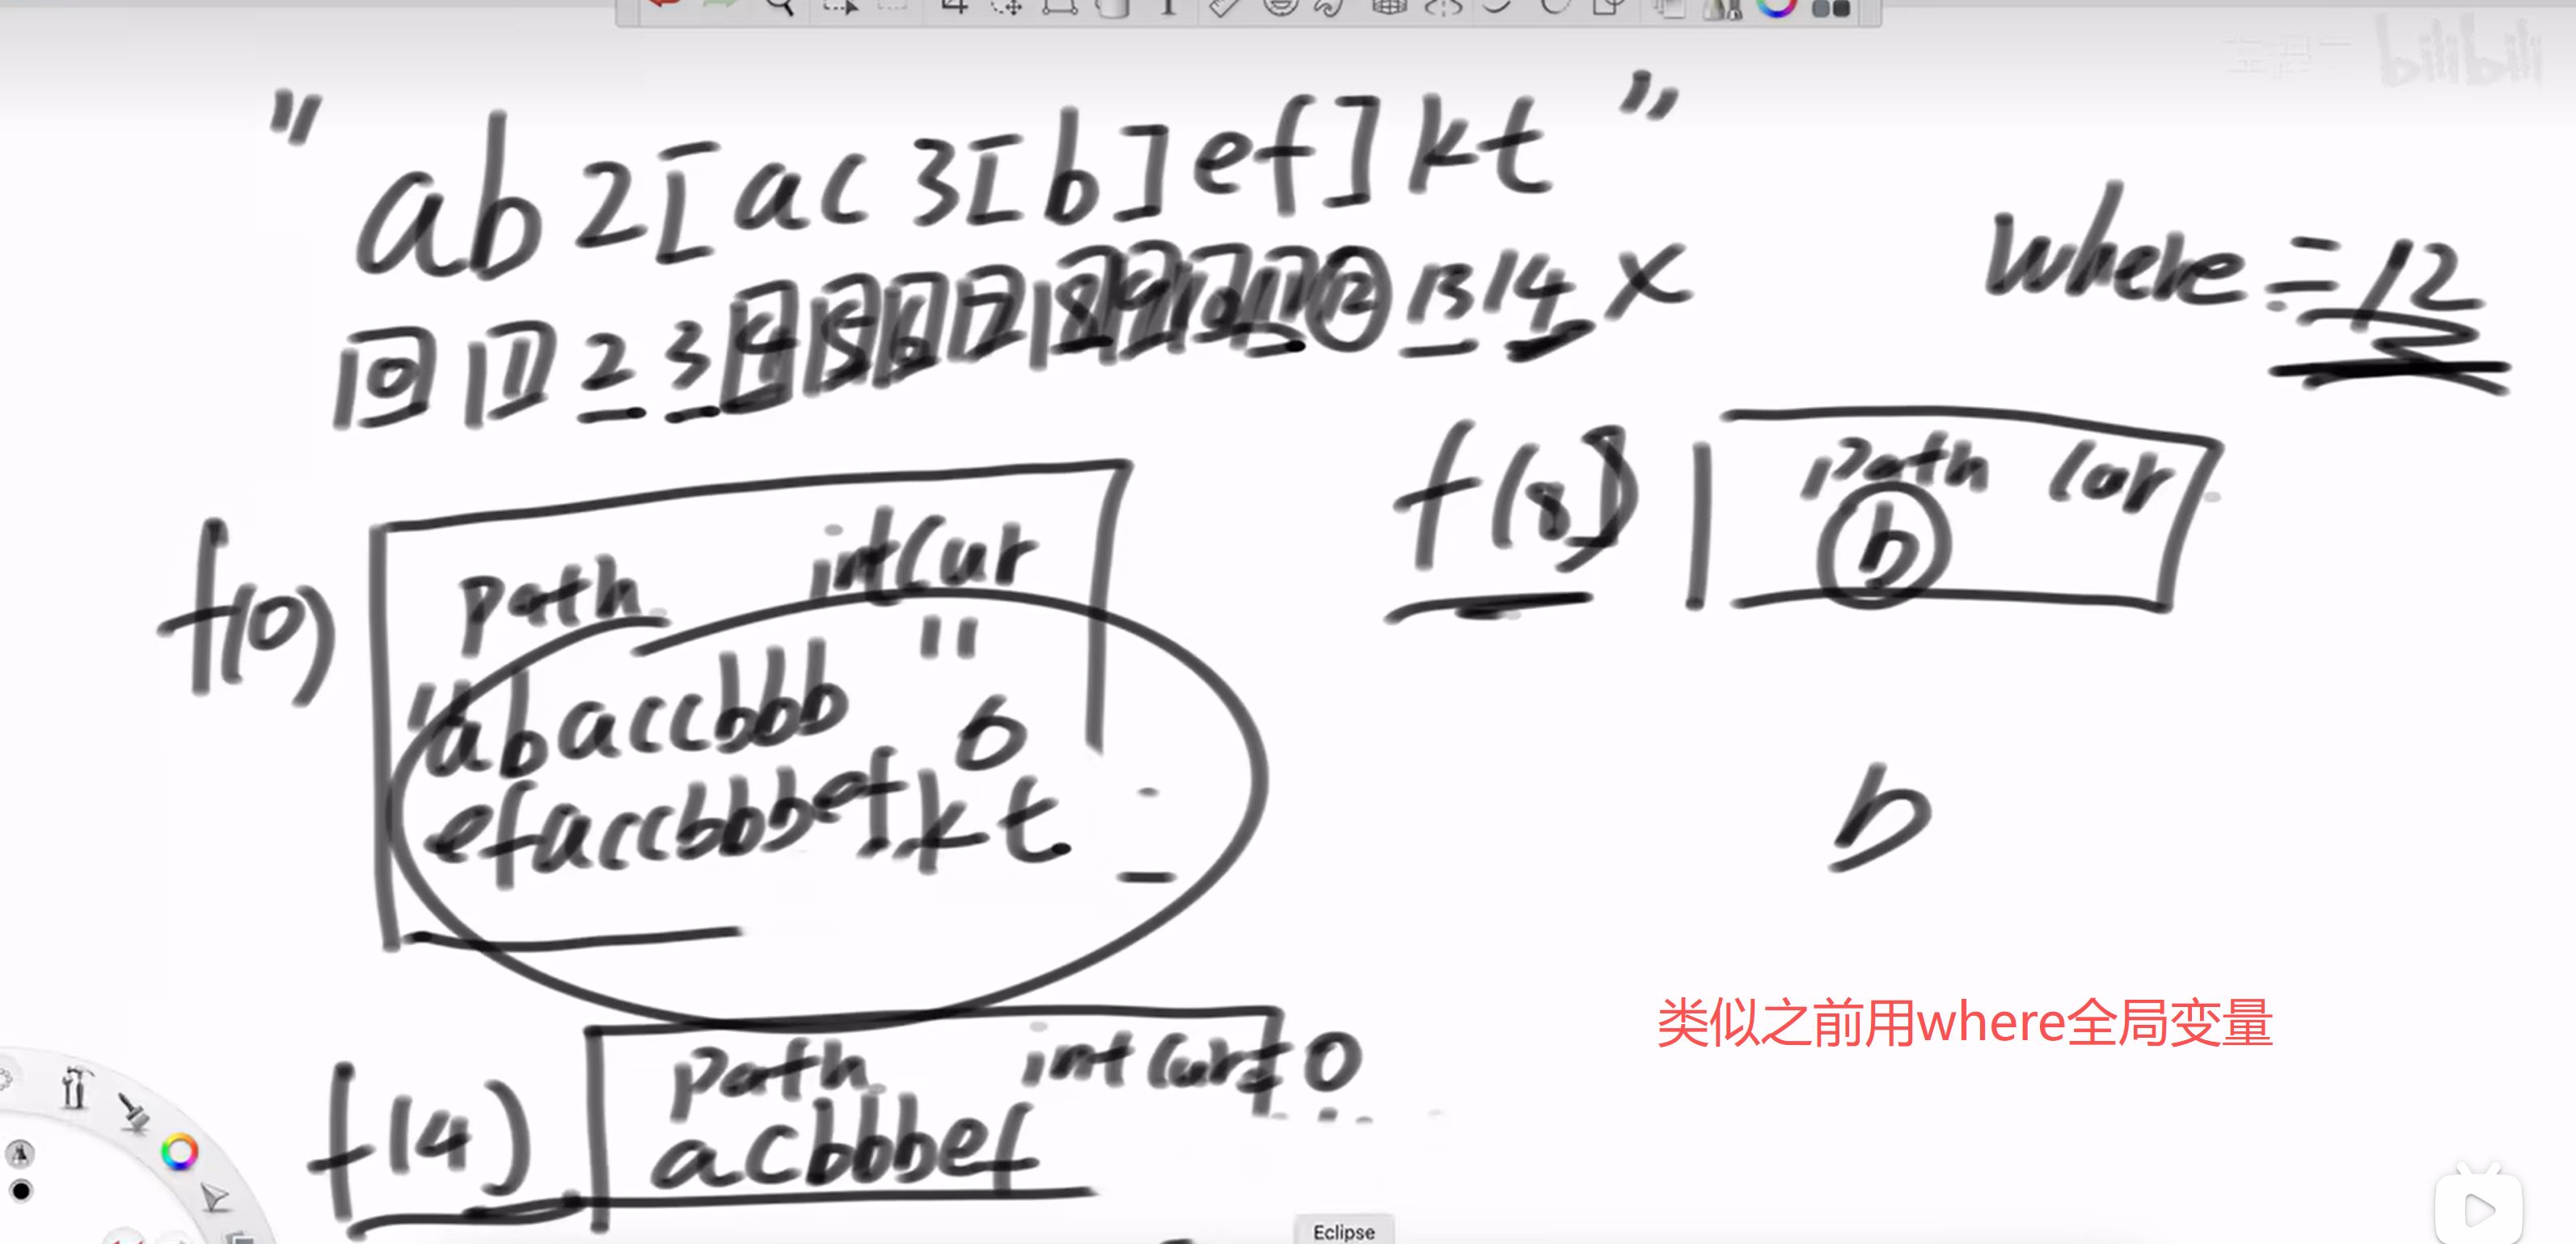
递归解码嵌套字符串。有嵌套就一定有数字:

  • 遇到字母:直接拼接到当前层级的结果 path 中
  • 遇到数字:累加成一个完整的数字 cnt,这代表后续 [] 内字符串的重复次数
  • 遇到左括号[:说明进入了一个新的嵌套层级。此时,递归调用 _f 来解码 [] 内的子问题。递归返回后,将得到的子字符串重复 cnt 次,拼接到 path 中。
  • 遇到右括号 ] 或字符串末尾:当前层级解码结束,返回 path。

where全局变量
解码嵌套字符串

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
class Solution:
def decodeString(self, s: str) -> str:
"""
主函数,初始化共享索引并启动递归
"""
self.where = 0
return self._f(list(s), 0)

# s[i....]开始计算,遇到字符串终止 或者 遇到 ] 停止
# 返回 : 自己负责的这一段字符串的结果
# 返回之间,更新全局变量where,为了上游函数知道从哪继续!
def _f(self, s: list, i: int) -> str:
"""
递归函数,解码一个层级的字符串
"""
path = []
cnt = 0
while i < len(s) and s[i] != ']':
if 'a' <= s[i] <= 'z' or 'A' <= s[i] <= 'Z': # 比较范围
path.append(s[i])
i += 1
elif s[i].isdigit():
cnt = cnt * 10 + int(s[i])
i += 1
else:
# 遇到 [
# 递归调用 f 来解码括号内的内容
inner_str = self._f(s, i + 1)
# 将解码后的子串重复 cnt 次
path.append(cnt * inner_str)
# 更新 i 到 ']' 之后的位置
i = self.where + 1
# 重置 cnt
cnt = 0

# 更新全局索引,以便上层函数知道从哪里继续
self.where = i
return "".join(path)

算法分析

  • 时间复杂度:O(n)
  • 空间复杂度:O(n)
  • 核心技巧:递归处理嵌套 + 字符串重复

题目三:含有嵌套的分子式求原子数量

问题描述

给你一个字符串化学式 formula,返回每种原子的数量。

  • 原子总是以一个大写字母开始,接着跟随0个或任意个小写字母
  • 如果数量大于1,原子后会跟着数字表示原子的数量
  • 如果数量等于1则不会跟数字

测试链接:https://leetcode.cn/problems/number-of-atoms/

核心思想

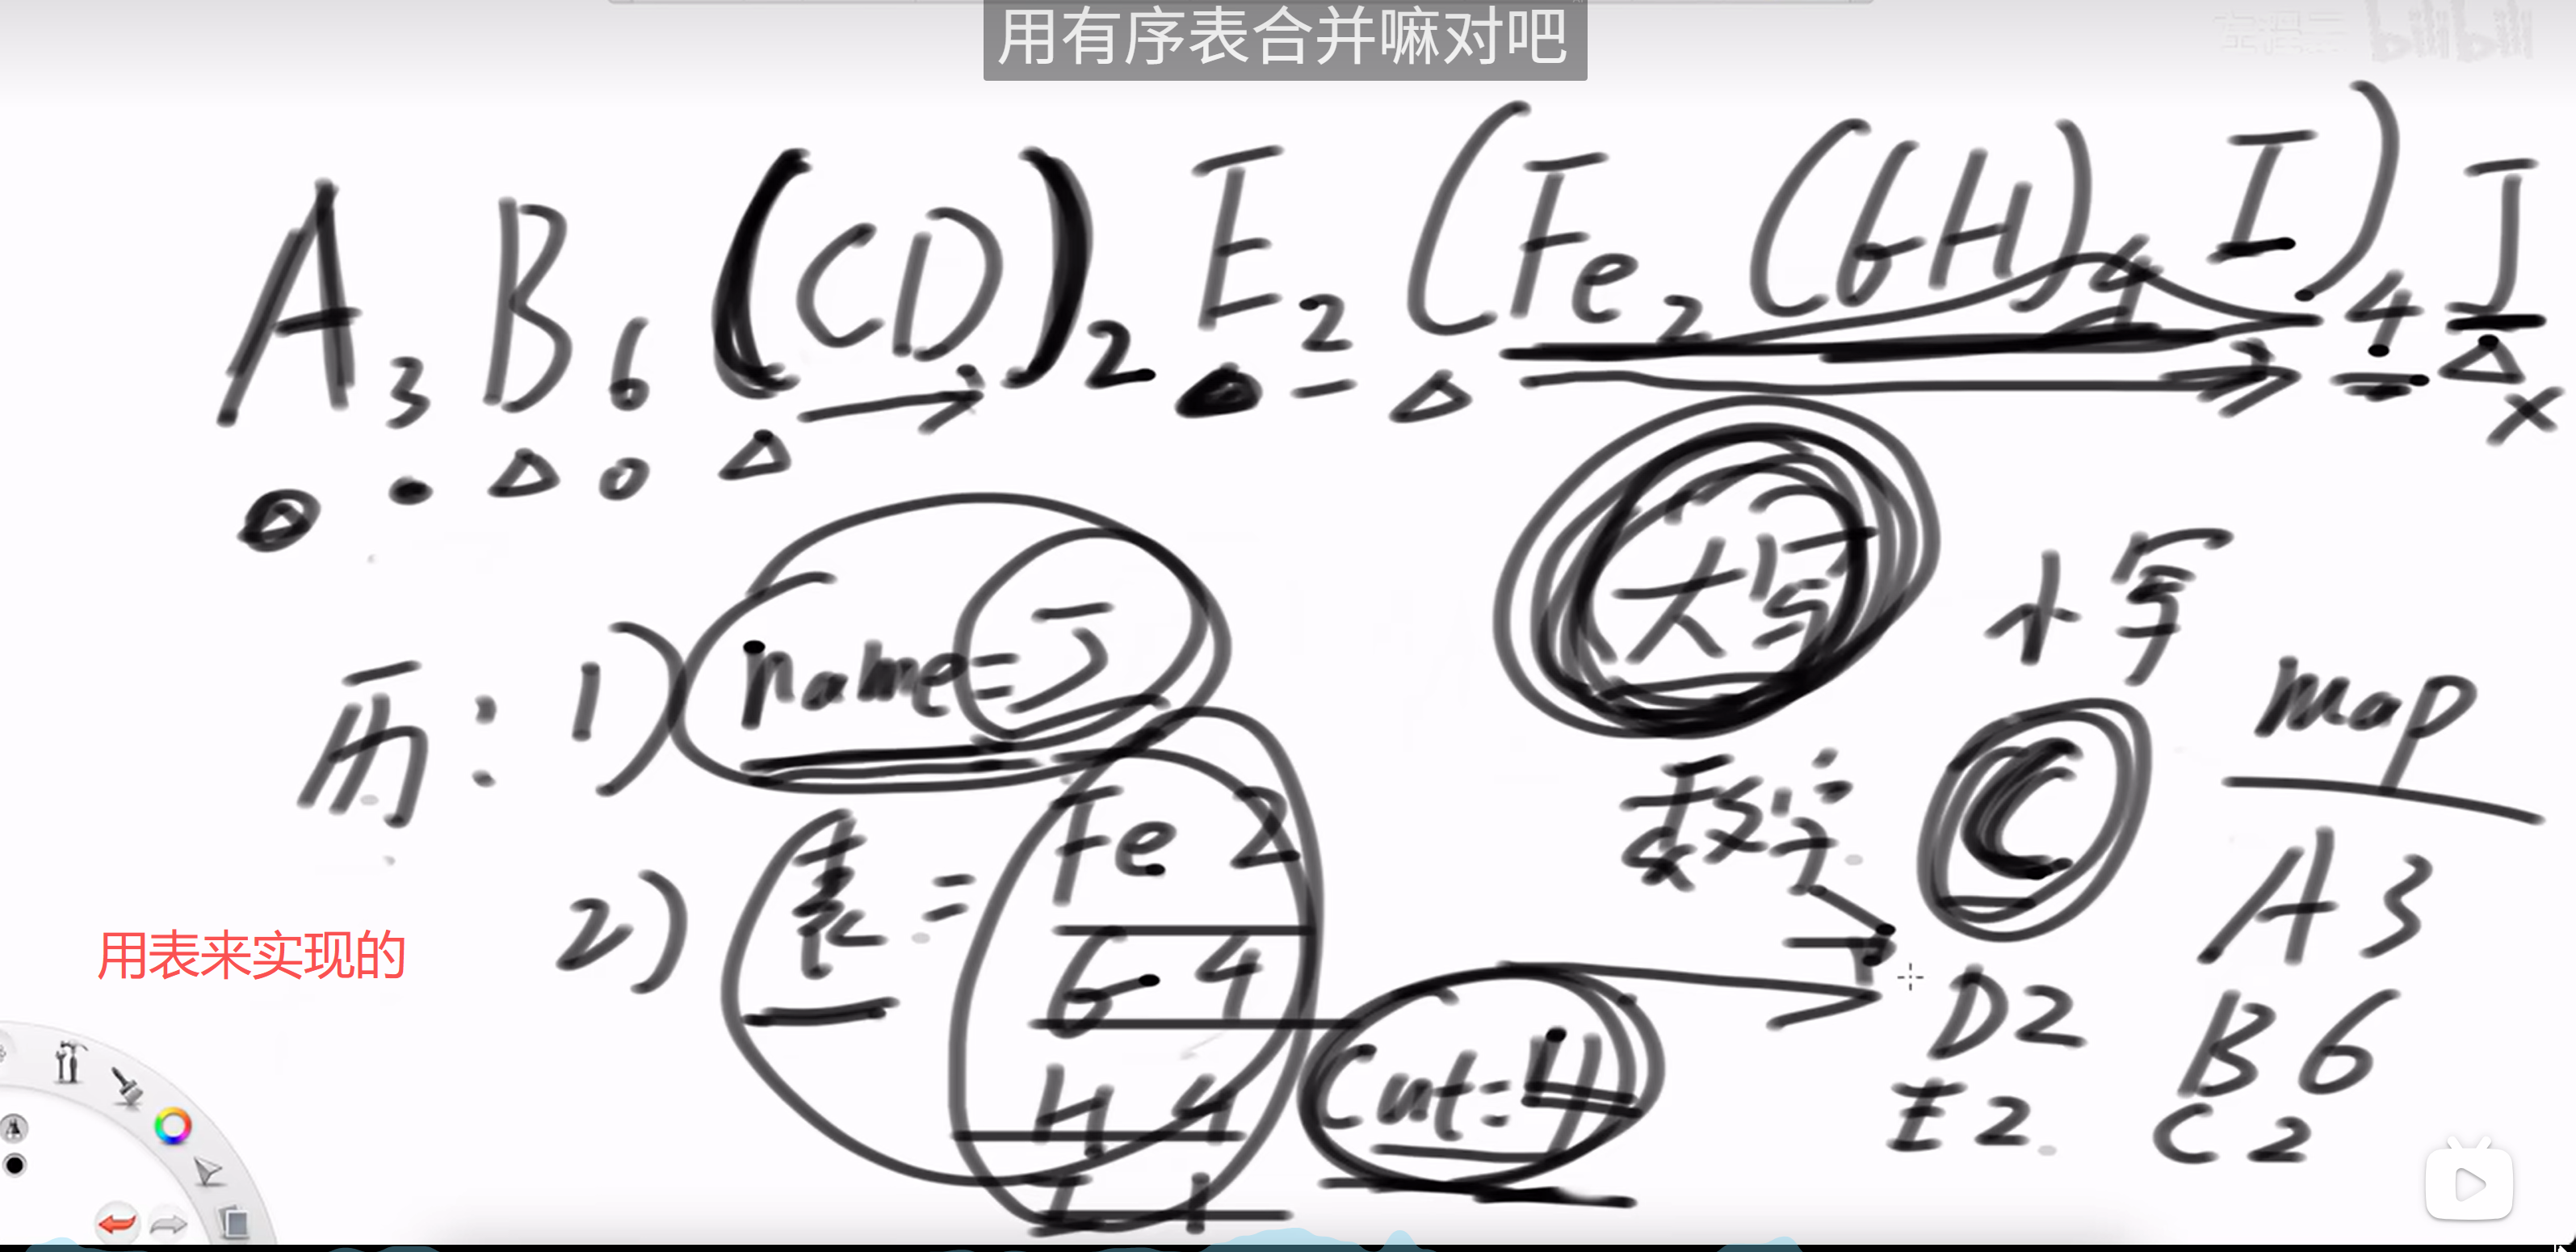
递归解析嵌套分子式,返回原子计数字典

具体流程如下:

  • 循环解析当前层级,直到遇到 ‘)’ 或字符串末尾。
  • 解析过程中维护三个状态:name (当前原子名), pre (括号内解析结果的字典), cnt (倍数)。
  • 当遇到下一个大写字母或左括号 ( 时,说明前一个“单元”(原子或括号)已经解析完毕,
    调用 _fill 函数将其信息合并到当前层级的总结果 ans 字典中。
  • 遇到 (,递归调用 _f 获取括号内的原子构成,存入 pre 字典。
  • 遇到大写字母,开始一个新的原子名 name。
  • 遇到小写字母,追加到 name。
  • 遇到数字,累加成倍数 cnt。

解读原子个数

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
from collections import defaultdict

class Solution:
def countOfAtoms(self, formula: str) -> str:
"""
主函数,初始化共享索引并启动递归,最后格式化输出
"""
self.where = 0
# 调用递归函数获取原子计数的字典
atom_map = self._f(list(formula), 0)

# 构建最终的输出字符串
ans = []
# 按原子名称的字母顺序排序,返回有序表
for key in sorted(atom_map.keys()):
ans.append(key) # 先添加原子名称再添加数量
cnt = atom_map[key]
if cnt > 1:
ans.append(str(cnt))
return "".join(ans)

def _f(self, s: list, i: int) -> dict:
"""
递归函数,解析一个层级的分子式,返回一个字典
"""
ans = defaultdict(int) # 创建默认字典
name = [] # 存储当前原子名称
pre = None # 历史记录
cnt = 0

while i < len(s) and s[i] != ')':
if 'A' <= s[i] <= 'Z' or s[i] == '(':
# 遇到新单元,先把之前收集的信息处理掉
self._fill(ans, name, pre, cnt)
# 重置状态
name.clear() # 清空列表中的所有元素
pre = None
cnt = 0 # 重置倍数

if 'A' <= s[i] <= 'Z':
name.append(s[i])
i += 1 # 移动到下一个字符
else: # 遇到 (
# 递归处理括号内的表达式
pre = self._f(s, i + 1)
i = self.where + 1
elif 'a' <= s[i] <= 'z':
name.append(s[i])
i += 1
else: # 遇到数字
cnt = cnt * 10 + int(s[i])
i += 1

# 循环结束,处理最后一个单元
self._fill(ans, name, pre, cnt)
# 更新全局索引
self.where = i
return ans

def _fill(self, ans: dict, name: list, pre: dict, cnt: int):
"""辅助函数,将一个解析完的单元(原子或括号)合并到总结果中"""
if name or pre:
# 如果没有数字,倍数默认为1
cnt = 1 if cnt == 0 else cnt
if name:
# 如果是原子,直接累加数量
key = "".join(name)
ans[key] += cnt
else: # 如果是括号内的字典 pre
# 遍历字典,将其中每个原子的数量乘以倍数 cnt,再累加
for key, val in pre.items():
ans[key] += val * cnt

算法分析

  • 时间复杂度:O(n)
  • 空间复杂度:O(n)
  • 核心技巧:递归处理嵌套 + 字典合并

核心套路总结

1. 递归函数设计模板

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
class Solution:
def solve(self, s: str):
"""主函数,初始化全局变量"""
self.where = 0
return self._f(list(s), 0)

def _f(self, s: list, i: int):
"""递归函数核心模板"""
# 初始化当前层级的状态变量
result = [] # 或其他适当的数据结构

while i < len(s) and s[i] != 终止条件:
if 普通字符处理:
# 直接处理
i += 1
elif 嵌套开始标志:
# 递归调用处理嵌套
nested_result = self._f(s, i + 1)
# 处理递归结果
result.append(nested_result)
# 更新位置
i = self.where + 1
else:
# 其他情况处理
i += 1

# 更新全局位置
self.where = i
return result

2. 全局变量where的作用

1
2
3
4
# where的三个关键作用:
# 1. 记录当前递归函数解析到的位置
# 2. 让上级函数知道下级函数处理到哪里了
# 3. 实现递归层级之间的位置传递

3. 嵌套处理的通用策略

1
2
3
4
5
6
7
8
9
10
# 遇到嵌套开始标志时:
if s[i] == '(' or s[i] == '[': # 根据具体问题调整
# 1. 递归调用处理嵌套内容
nested_result = self._f(s, i + 1)

# 2. 处理递归返回的结果
process_nested_result(nested_result)

# 3. 更新当前位置到嵌套结束后
i = self.where + 1

复杂度分析总结

题目 时间复杂度 空间复杂度 核心数据结构
表达式求值 O(n) O(n) 列表 + 递归栈
字符串解码 O(n) O(n) 字符串 + 递归栈
分子式解析 O(n) O(n) 字典 + 递归栈

学习建议

1. 理解递归本质

  • 递归是处理嵌套结构的自然选择
  • 每一层递归负责处理一个层级的内容
  • 通过全局变量实现层级间的信息传递

2. 掌握状态管理

  • 明确每层递归需要维护哪些状态
  • 合理设计辅助函数处理复杂逻辑
  • 注意状态的重置和更新时机

3. 练习边界处理

  • 递归终止条件的设计
  • 嵌套边界的正确处理
  • 特殊情况的考虑(空字符串、单字符等)

4. 优化技巧

  • 使用合适的数据结构(列表、字典、栈等)
  • 避免重复计算和冗余操作
  • 考虑空间复杂度的优化

5. 调试方法

  • 画出递归调用的层级关系图
  • 追踪全局变量where的变化
  • 验证每层递归的输入输出

通过掌握这个通用的嵌套类问题解题套路,可以有效解决包含括号、方括号等嵌套结构的各类算法问题。关键在于理解递归的层级关系和全局变量的作用机制。

引言

参照的是左程云的课程:https://space.bilibili.com/8888480/lists/3509640?type=series

本笔记是 038【必备】常见经典递归过程解析 的内容,总结了7道经典递归题目,涵盖了递归的核心思想和技巧,包括带路径的递归、不带路径的递归、回溯算法等重要概念。

前置知识

在学习本节内容之前,建议先熟悉以下章节:

  • 讲解017、020、021、023、036、037(这些章节都分析过递归)

重要概念

递归与回溯的关系

  • 任何递归都是DFS且非常灵活
  • 回溯这个术语并不重要,它只是递归过程中的恢复现场操作
  • 带路径的递归 vs 不带路径的递归:大部分DP和状态压缩DP可以认为是路径简化了结构

038【必备】常见经典递归过程解析

题目一:返回字符串全部子序列(去重)

问题描述

返回字符串全部子序列,子序列要求去重。

测试链接:https://www.nowcoder.com/practice/92e6247998294f2c933906fdedbc6e6a

核心思想

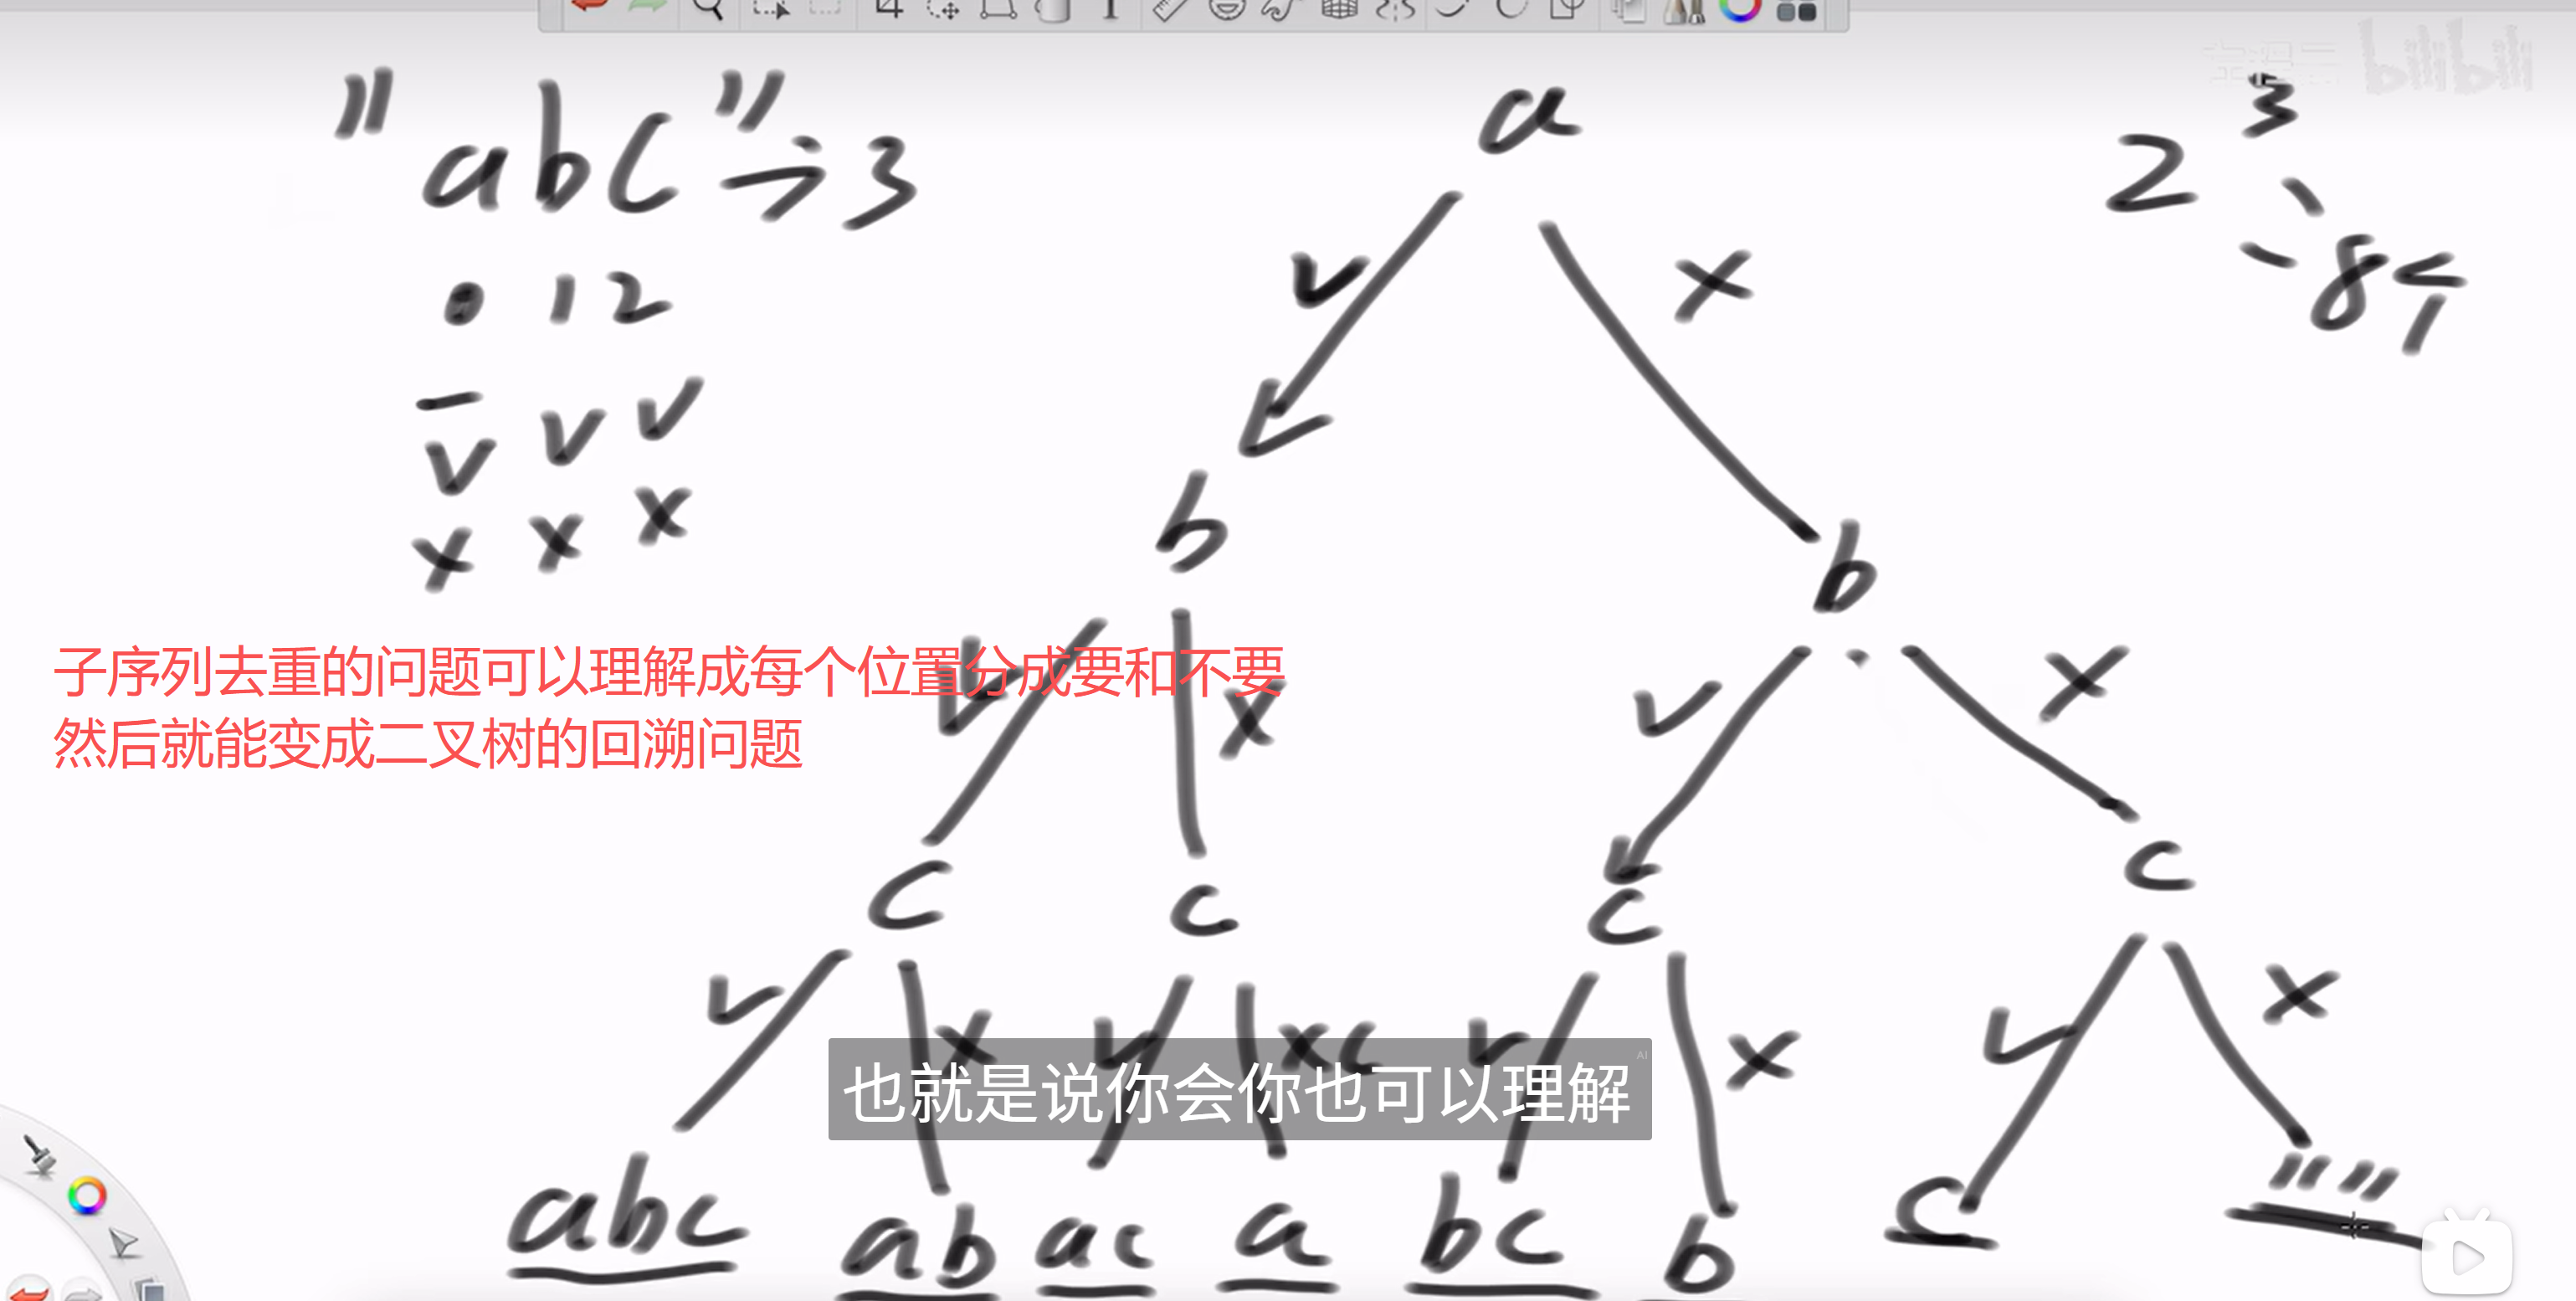
使用递归的方式,对于字符串中的每一个字符,我们都有两种选择:

  1. 将该字符包含在当前子序列中
  2. 不将该字符包含在当前子序列中

通过递归遍历所有这些选择,就能得到所有可能的子序列。

子序列去重

算法实现

方法一:使用列表作为路径

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
class Solution:
def generatePermutation1(self, s: str) -> List[str]:
"""
主函数,初始化并调用递归函数 f1
"""
# 使用集合 set 来自动处理重复的子序列
result_set = set()
# path 使用列表来模拟 Java 的 StringBuilder,方便添加和删除字符
path = []
self._f1(s, 0, path, result_set)
return sorted(list(result_set))

def _f1(self, s: str, i: int, path: List[str], result_set: Set[str]):
"""
递归函数,用于生成所有子序列
s[i...],之前决定的路径path,set收集结果时去重
"""
# base case: 当索引 i 到达字符串末尾时,所有字符都已考虑完毕
if i == len(s):
result_set.add("".join(path))
else:
# 决策1: 选择当前字符 s[i]
path.append(s[i]) # 加到路径中去
self._f1(s, i + 1, path, result_set)

# 回溯:撤销选择,为下一种决策做准备
path.pop() # 从路径中移除,删掉最后一个字符

# 决策2: 不选择当前字符 s[i]
self._f1(s, i + 1, path, result_set)

方法二:使用固定长度列表和size指针

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
class Solution:
def generatePermutation2(self, s: str) -> List[str]:
"""
主函数,初始化并调用递归函数 f2
"""
result_set = set()
# 预先分配一个与原字符串等长的列表作为路径容器
path = [''] * len(s)
self._f2(s, 0, path, 0, result_set)
return sorted(list(result_set))

def _f2(self, s: str, i: int, path: List[str], size: int, result_set: Set[str]):
"""
与f1思想相同,但使用不同的方式来维护路径
这方法不用回溯,因为path是固定长度的列表,size指针来表示有效字符长度
"""
if i == len(s):
# path[:size] 表示路径中的有效部分
result_set.add("".join(path[:size]))
# path[:size]: 取列表/序列 path 的前 size 个元素(左闭右开,不会越界,超过长度就取到末尾)
# "".join(...): 用空字符串作为分隔符,把可迭代对象里的“字符串元素”拼接成一个整体字符串
# result_set.add(...): 将结果添加到集合中,自动去重
else:
# 决策1: 选择当前字符 s[i],将其放入 path 的 size 位置
path[size] = s[i]
self._f2(s, i + 1, path, size + 1, result_set) #size+1表明有效字符长度+1,指针后移

# 决策2: 不选择当前字符 s[i],直接进入下一层递归
self._f2(s, i + 1, path, size, result_set)

算法分析

  • 时间复杂度:O(2^n × n),子序列个数2^n,平均长度O(n)级别
  • 空间复杂度:O(2^n × n)
  • 核心技巧:递归选择 + set去重

题目二:返回数组的所有组合(去重)

问题描述

给你一个整数数组 nums,其中可能包含重复元素,请你返回该数组所有可能的组合。答案不能包含重复的组合。

测试链接:https://leetcode.cn/problems/subsets-ii/

核心思想

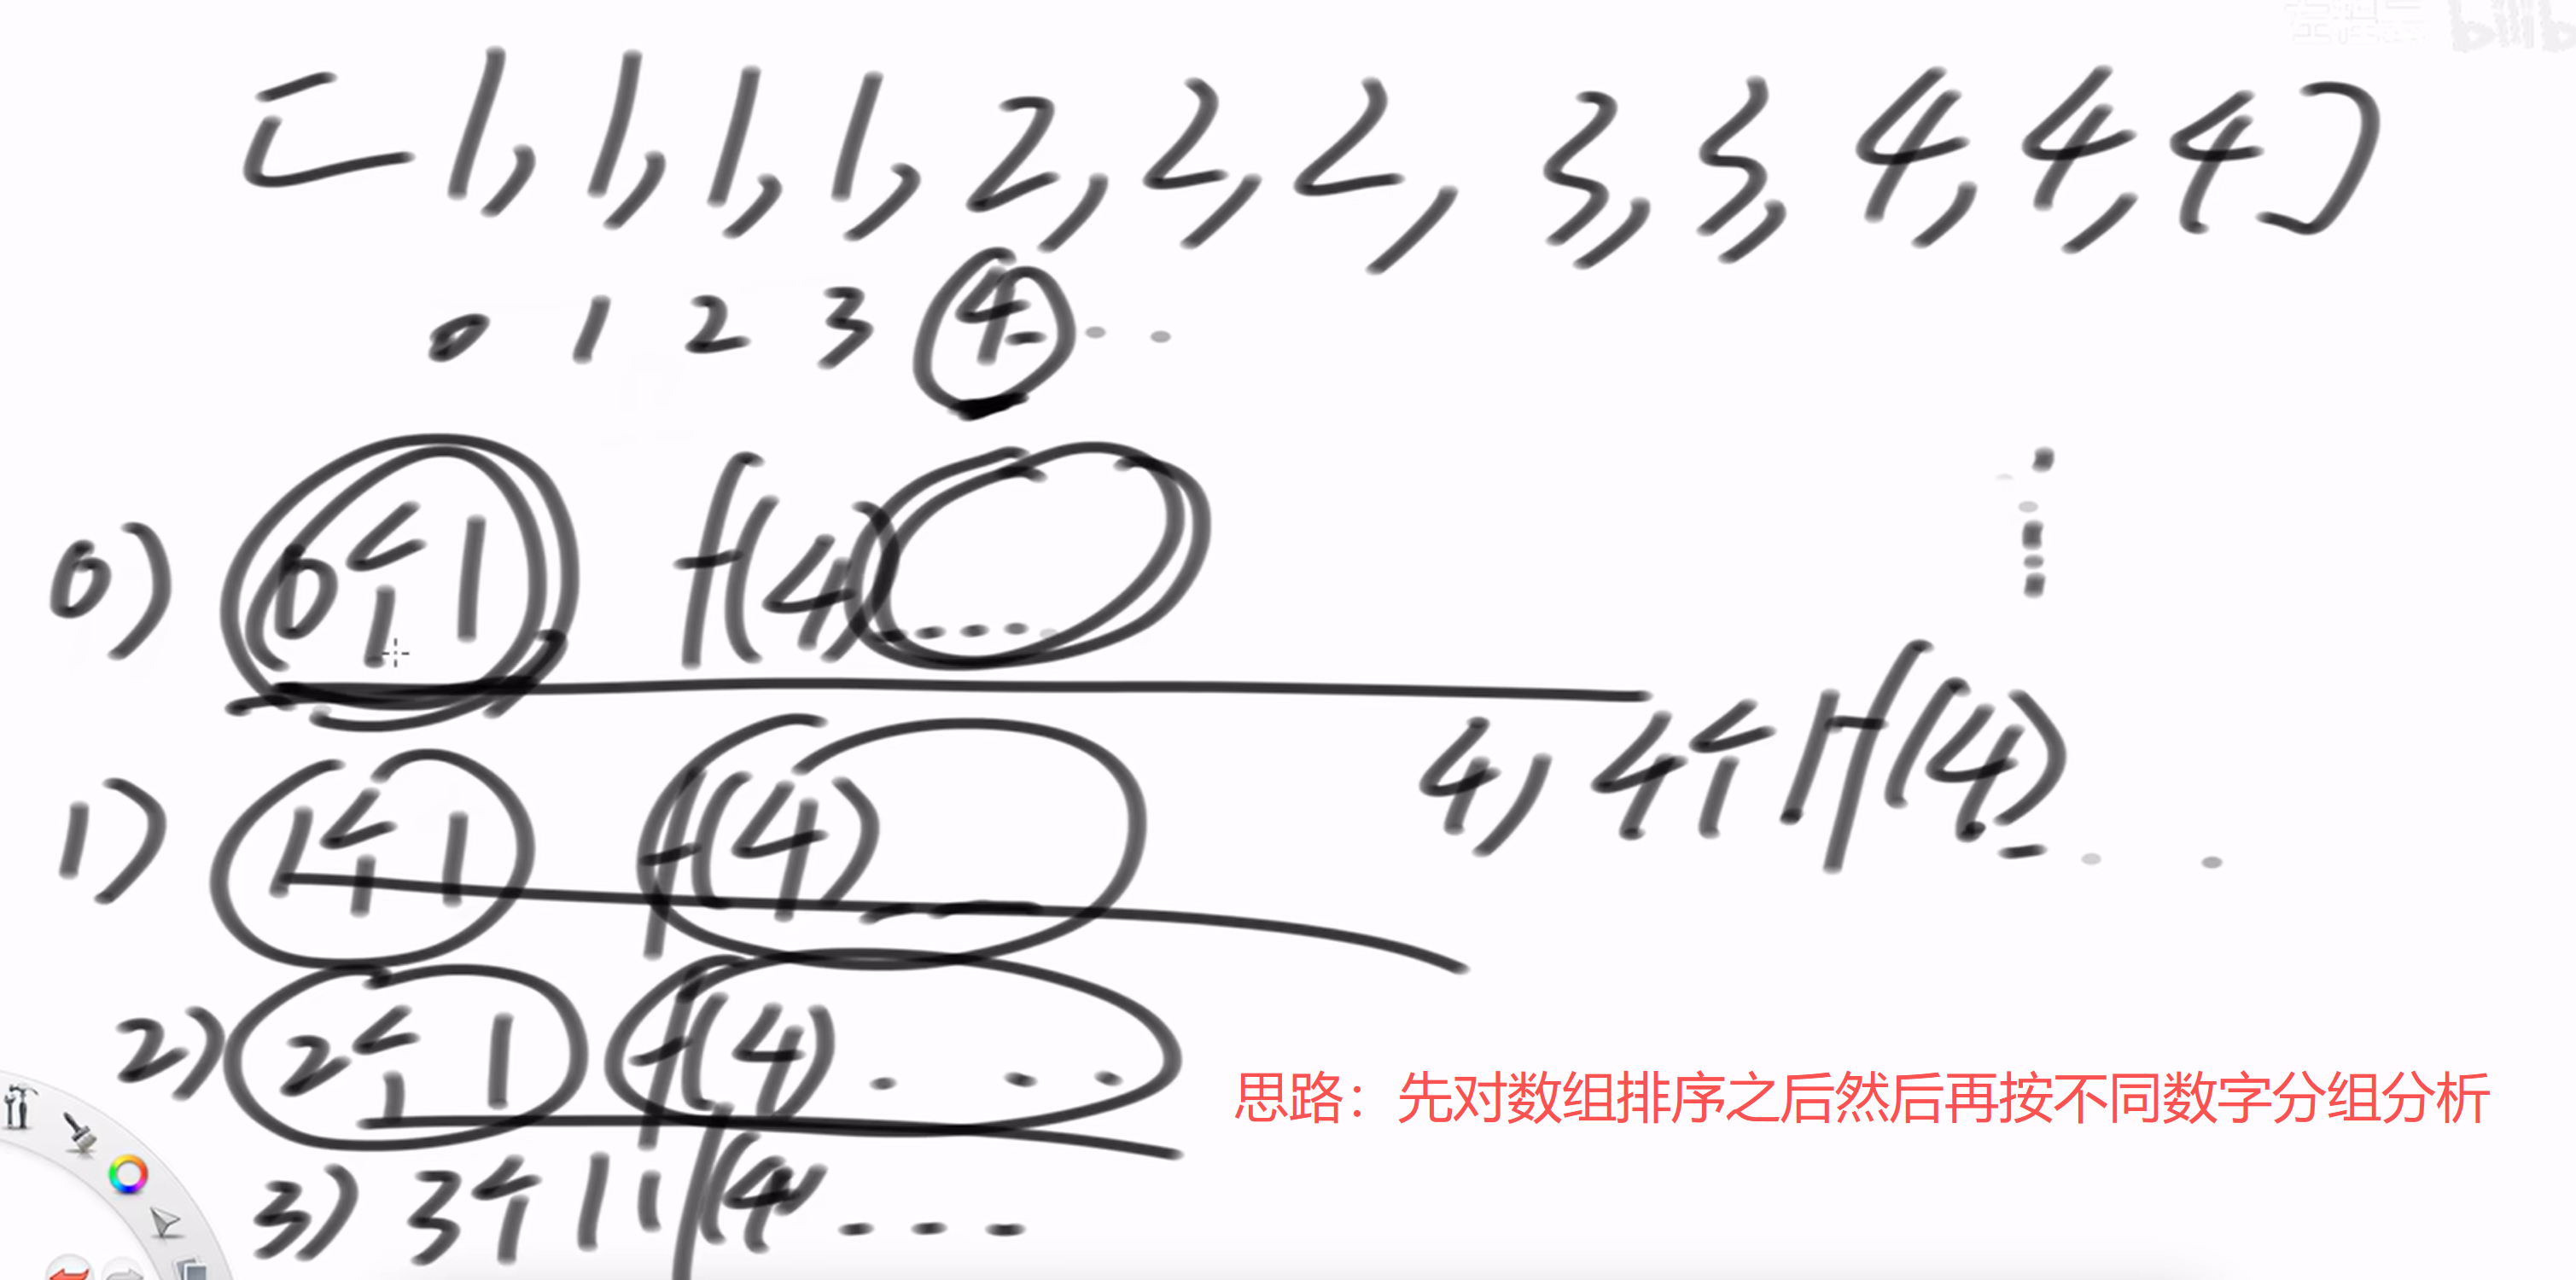
与生成子序列(排列)不同,这里通过一次性决策一组相同数字的方式来避免重复。

  1. 先对数组排序。
  2. 在递归到位置 i 时,首先找到下一个与 nums[i] 不同的数的位置 j。
    这表示从 i 到 j-1 都是相同的数。
  3. 决策1:这组相同的数一个都不要。直接从 j 位置继续递归。
  4. 决策2:依次决策要1个、2个…直到 j-i 个相同的数。
    每做一次选择,就将数加入路径,然后从 j 位置继续递归。

生成不同的组合

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
class Solution:
def subsetsWithDup(self, nums: List[int]) -> List[List[int]]:
"""
主函数,初始化并调用递归函数
"""
ans = []
# 排序是关键,它使得相同的元素相邻,便于后续去重处理
nums.sort()
path = [0] * len(nums)
self._f(nums, 0, path, 0, ans)
return ans

def _f(self, nums: List[int], i: int, path: List[int], size: int, ans: List[List[int]]):
"""
递归函数,生成不重复的组合
"""
# base case: 当 i 到达数组末尾时,形成一个组合
if i == len(nums):
ans.append(path[:size])
else:
# 找到下一个不同于 nums[i] 的元素的位置 j
j = i + 1
while j < len(nums) and nums[j] == nums[i]:
j += 1

# 决策1: 当前数 nums[i] 一个都不要
self._f(nums, j, path, size, ans)

# 决策2: 依次尝试要 1 个、2 个... k 个 nums[i]
# 从这一段相同数字里,依次选择 1 个、2 个、…、(j-i) 个放入路径,然后递归从 j 开始,即处理下一组数去
for k in range(i, j):
path[size] = nums[k]
size += 1
# 每次选择后,都从下一个不同的数 j 开始继续递归
self._f(nums, j, path, size, ans)

区别:set去重 vs 剪枝去重

  • 剪枝去重:当有相同的元素时,不进入递归,直接跳过,避免重复计算。(本题有用到这方面的考虑)
  • set去重:当有相同的元素时,会进入递归,但最终结果会去重。(但是题目1没有)

算法分析

  • 时间复杂度:O(2^n × n),所有不重复组合数量≤2^n
  • 空间复杂度:O(2^n × n)
  • 核心技巧:排序 + 剪枝去重

题目三:返回没有重复值数组的全部排列

问题描述

没有重复项数字的全排列。

测试链接:https://leetcode.cn/problems/permutations/

核心思想

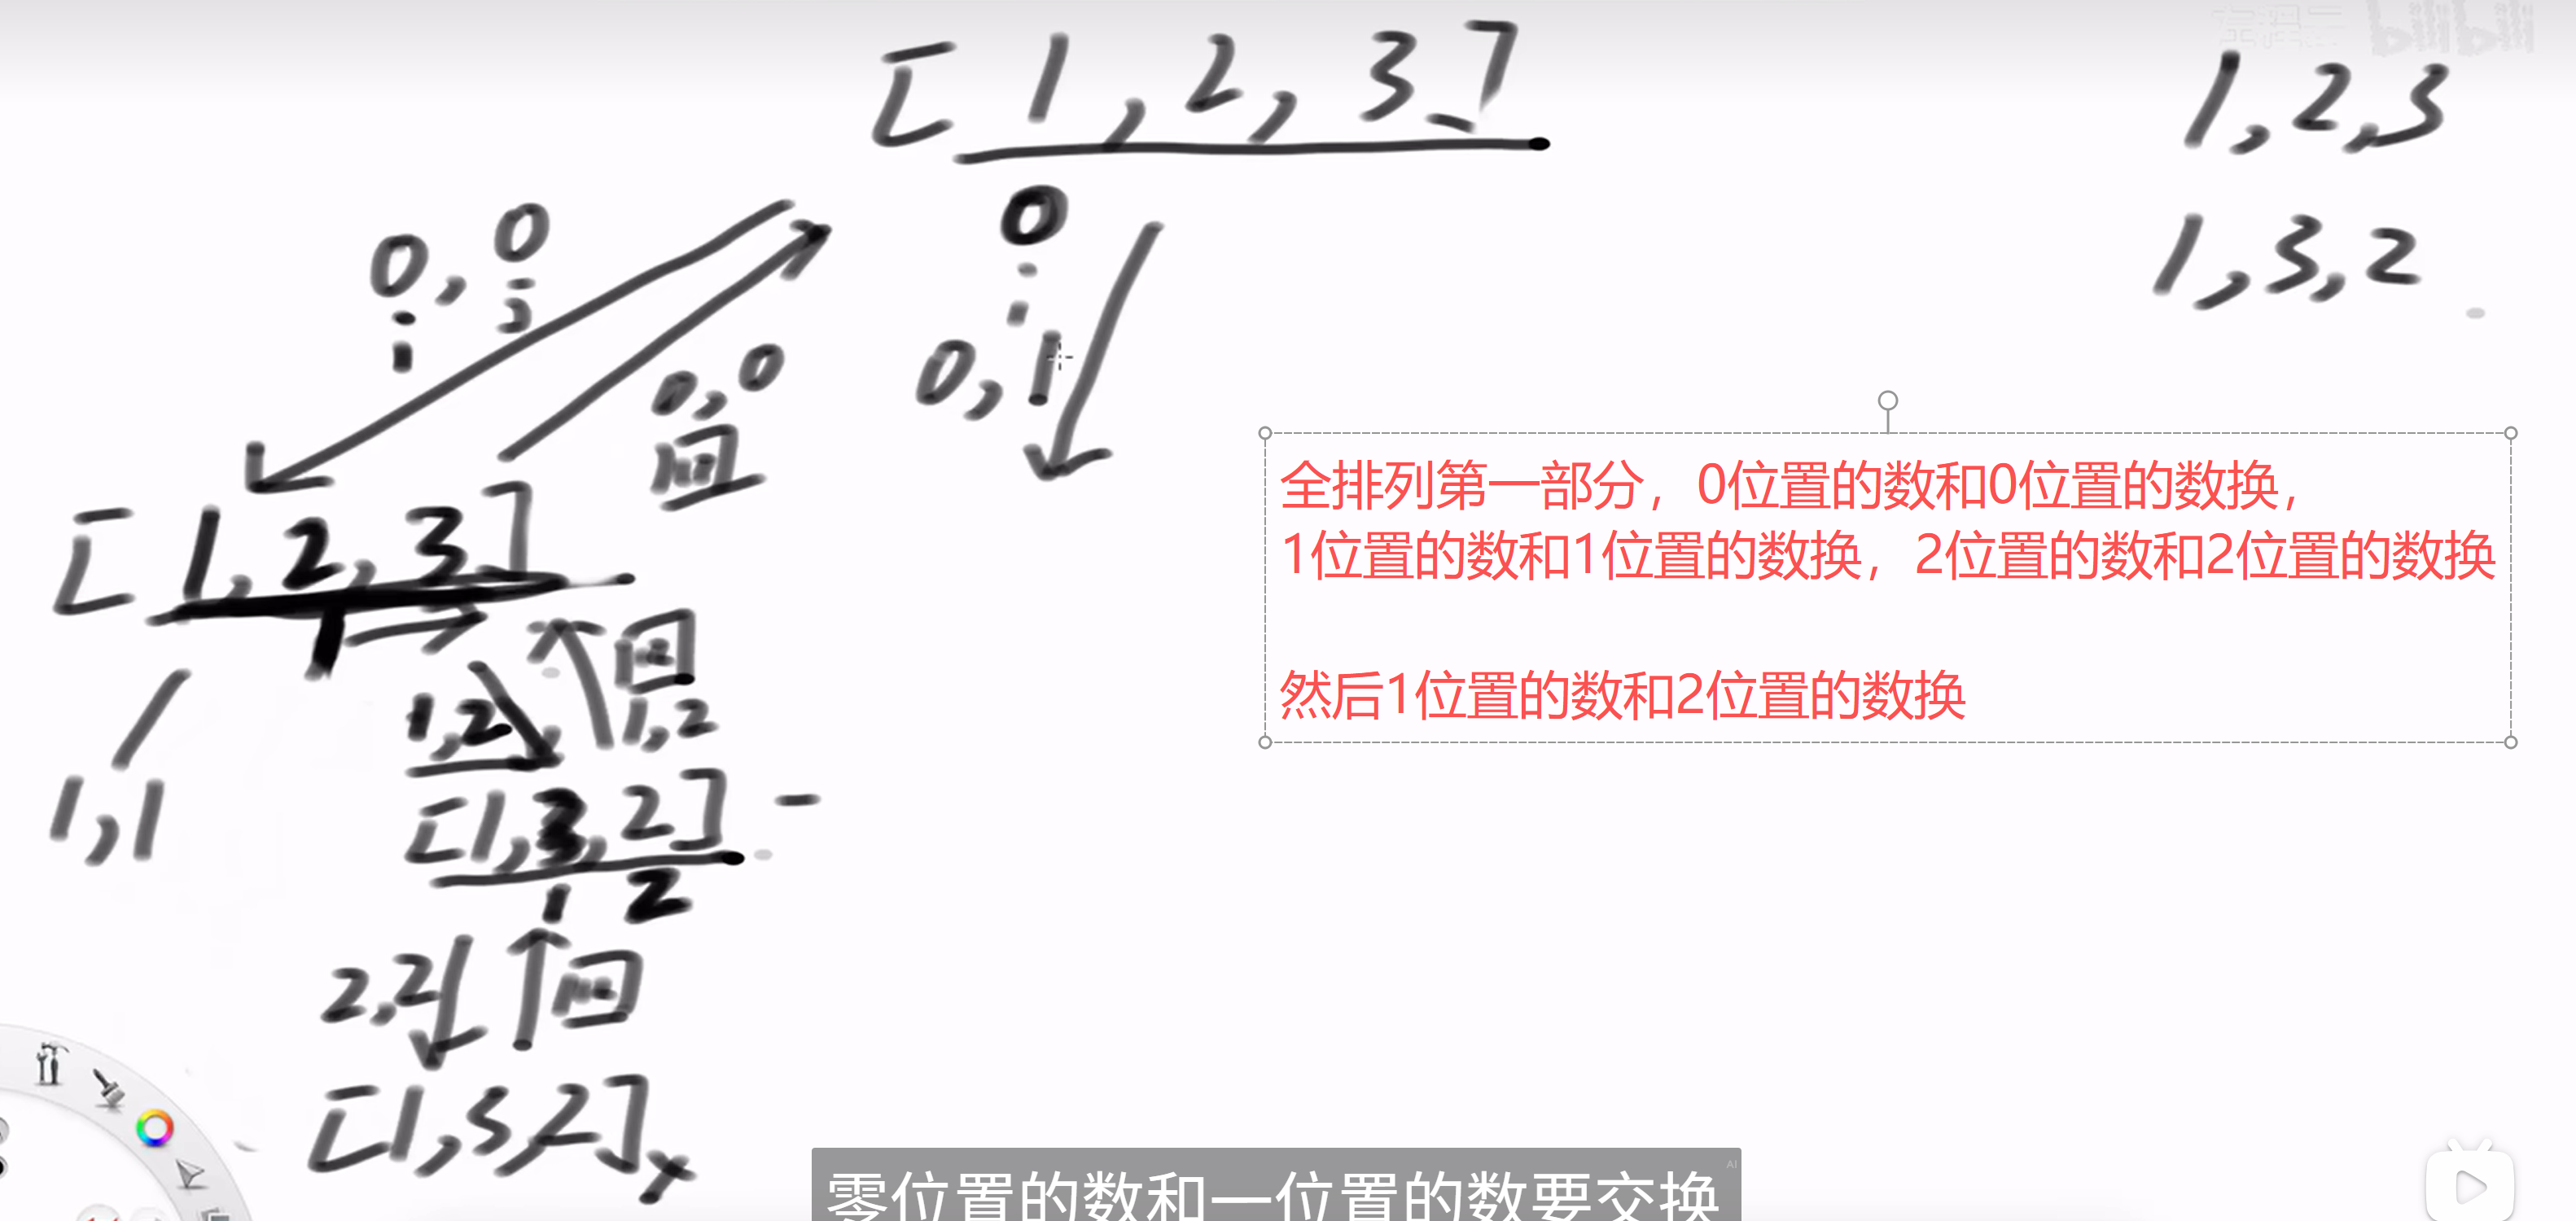
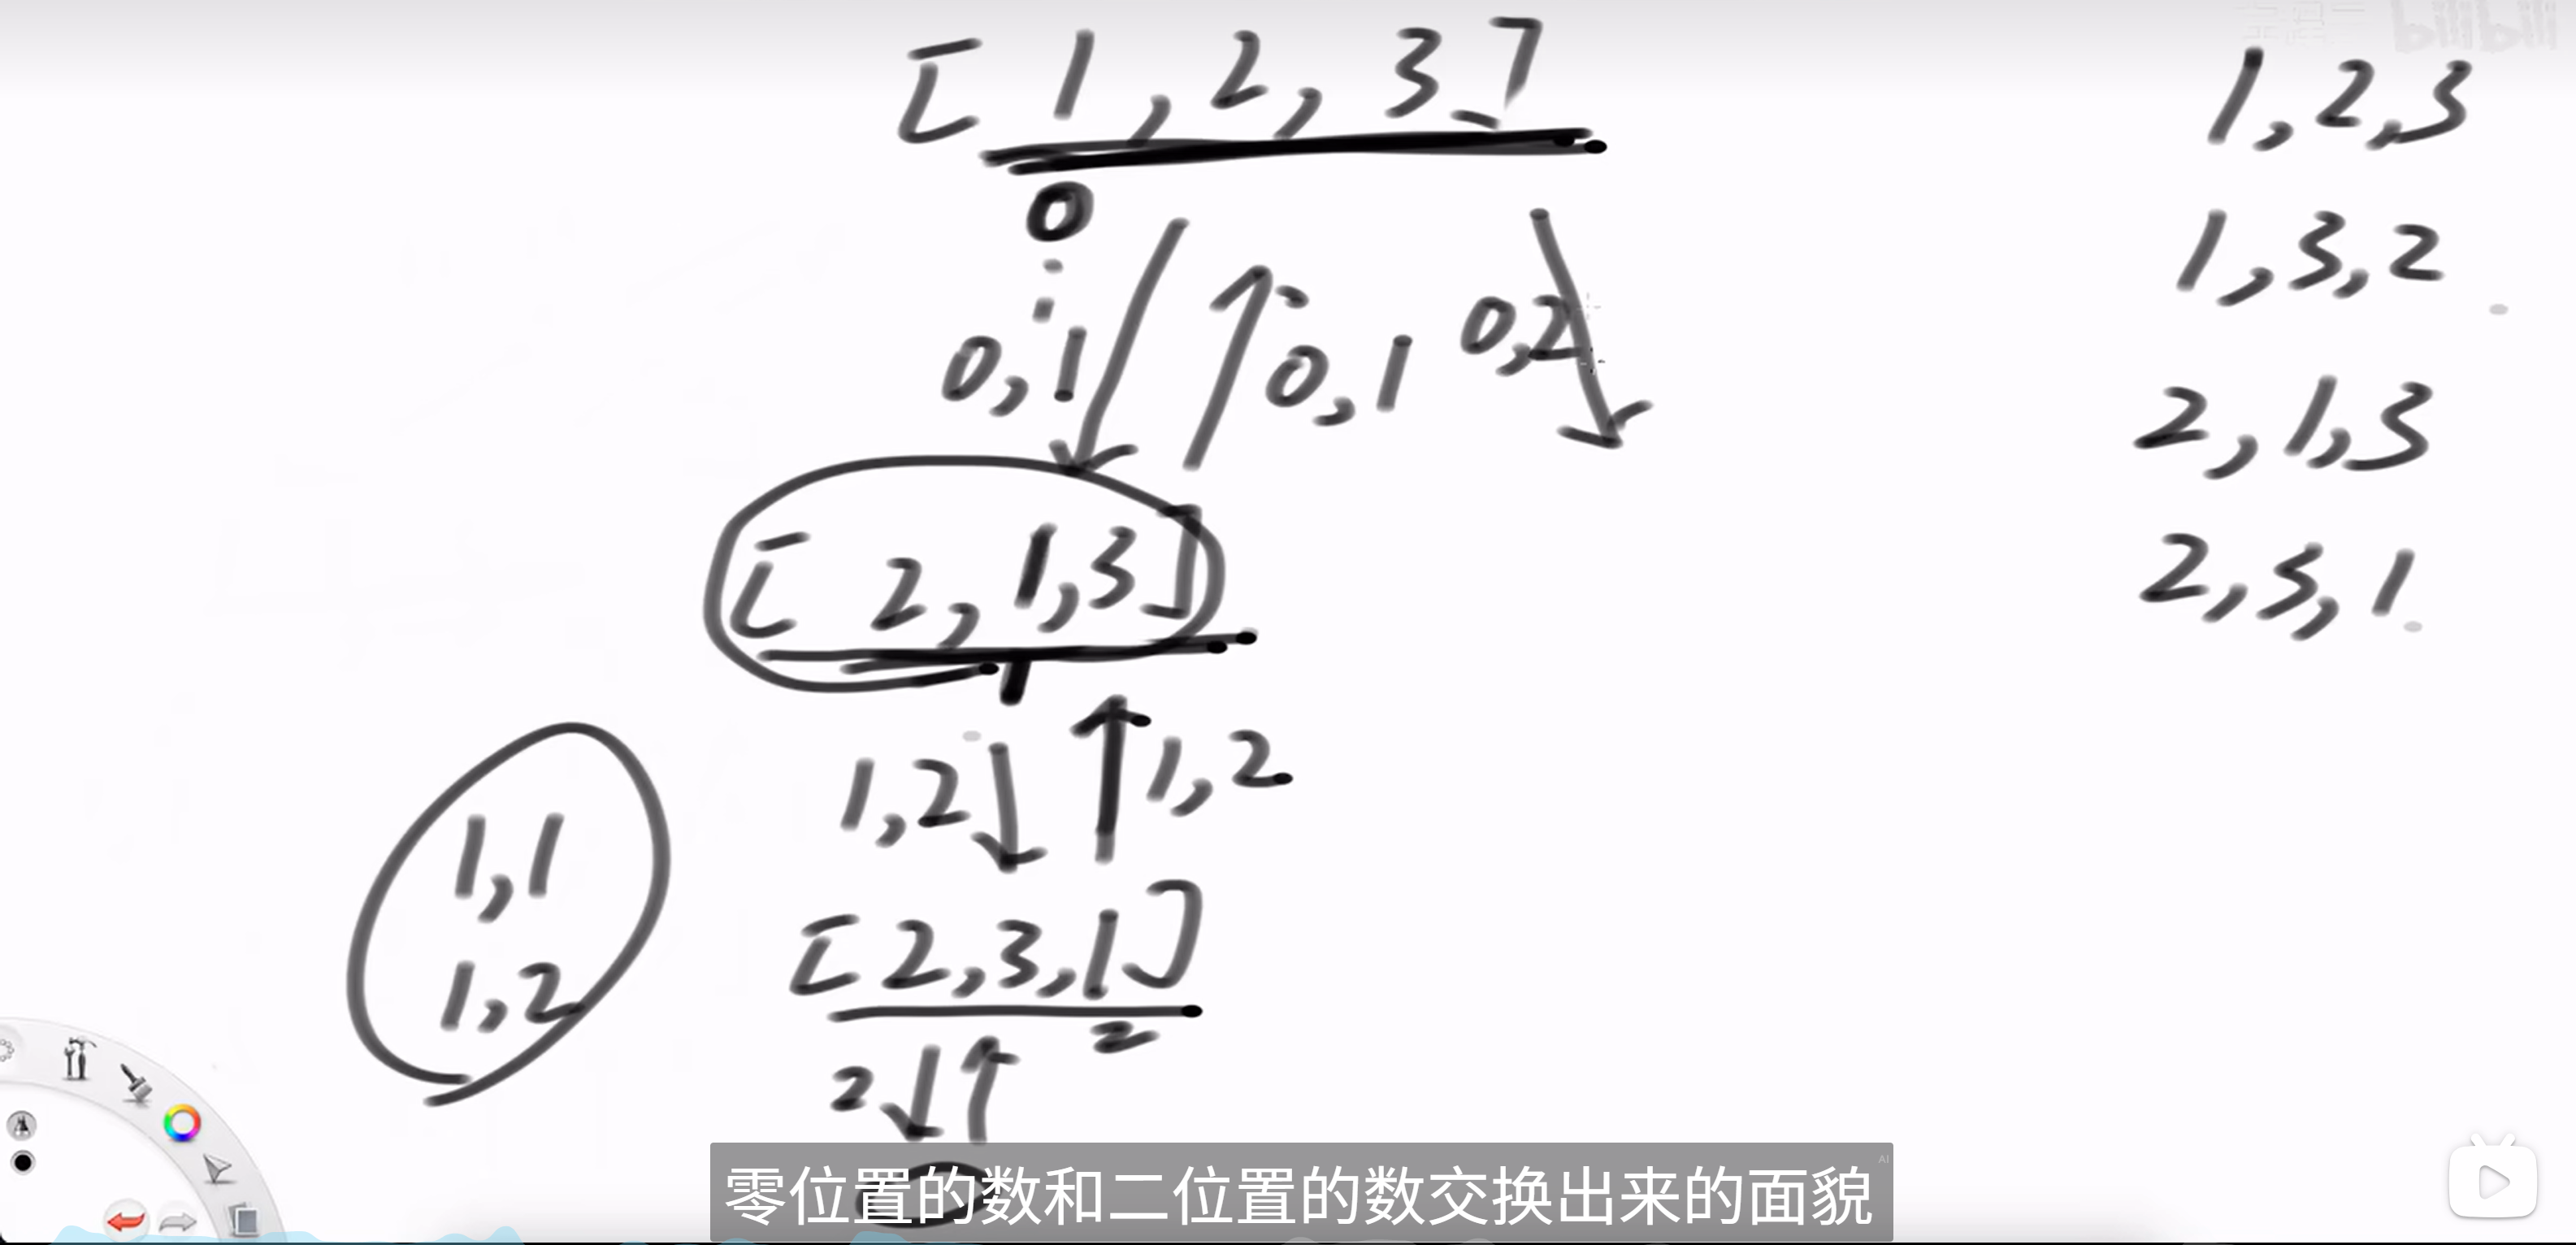
使用交换模型:

  1. 递归函数 _f(nums, i) 的任务是确定数组中第 i 个位置应该放哪个数。
  2. 我们可以从 i 到 len(nums)-1 的范围内选择一个数,将它与 nums[i] 交换,
    这样就确定了第 i 位。
  3. 然后递归调用 _f(nums, i+1) 去确定第 i+1 位。
  4. 当 i 到达数组末尾时,一个完整的排列就形成了。
  5. 递归返回后,必须将之前交换的元素换回来(回溯),以确保不影响其他分支的决策。

全排列(1)
全排列(2)

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
class Solution:
def permute(self, nums: List[int]) -> List[List[int]]:
"""
主函数,初始化并调用递归函数
"""
ans = []
self._f(nums, 0, ans) # 复用了原数组做路径
return ans

def _f(self, nums: List[int], i: int, ans: List[List[int]]):
"""
递归函数,生成全排列
核心思想 (交换模型)
"""
# base case: 当 i 到达数组长度时,一个完整的排列就形成了
if i == len(nums):
ans.append(nums[:]) # 将当前排列的副本加入结果列表
else:
# 尝试将 i 到 len(nums)-1 的每个数放到 i 位置上
for j in range(i, len(nums)):
# 将 nums[j] 换到当前要确定的 i 位置
self._swap(nums, i, j)
# 递归去确定下一个位置 i+1
self._f(nums, i + 1, ans)
# 回溯:将数组恢复原样,以便 for 循环下一次迭代能正确执行
self._swap(nums, i, j)

def _swap(self, nums: List[int], i: int, j: int):
nums[i], nums[j] = nums[j], nums[i]

算法分析

  • 时间复杂度:O(n! × n)
  • 空间复杂度:O(n!)
  • 核心技巧:交换模型 + 回溯

题目四:返回可能有重复值数组的全部排列(去重)

问题描述

有重复项数组的去重全排列。

测试链接:https://leetcode.cn/problems/permutations-ii/

核心思想

核心思想 (在交换模型基础上增加剪枝逻辑):
与生成无重复数字的全排列思路基本一致,但增加了一个去重机制。

  1. 在确定第 i 个位置的数时,我们遍历 j from i to len-1。
  2. 为了防止产生重复排列,我们规定:在第 i 个位置,一个数只能被放一次。
    例如,对于 [1, 2, 2],在确定第0位时,我们尝试放第一个 2,
    就不应该再尝试放第二个 2,因为这两种情况后续会产生完全相同的排列。
  3. 使用一个集合 seen (或 set) 来记录在当前位置 i 已经尝试过的数字。
    如果 nums[j] 已经被放过,就跳过。

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
class Solution:
def permuteUnique(self, nums: List[int]) -> List[List[int]]:
"""
主函数,初始化并调用递归函数
"""
ans = []
self._f(nums, 0, ans)
return ans

def _f(self, nums: List[int], i: int, ans: List[List[int]]):
"""
递归函数,生成不重复的全排列
在交换模型基础上增加剪枝逻辑
"""
if i == len(nums):
ans.append(nums[:])
else:
# seen 集合用于记录在当前 i 位置上已经尝试过的数字
seen: Set[int] = set()
for j in range(i, len(nums)):
# nums[j]没有来到过i位置,才会去尝试
if nums[j] not in seen:
# 记录下来,表示 nums[j] 这个值已经在 i 位置上用过了
seen.add(nums[j])
# 交换,将 nums[j] 放到 i 位置
self._swap(nums, i, j)
# 递归处理下一个位置
self._f(nums, i + 1, ans)
# 回溯,恢复数组
self._swap(nums, i, j)

def _swap(self, nums: List[int], i: int, j: int):
nums[i], nums[j] = nums[j], nums[i]

算法分析

  • 时间复杂度:O(n! × n)
  • 空间复杂度:O(n!)
  • 核心技巧:交换模型 + 集合去重

题目五:用递归逆序一个栈

问题描述

用递归函数逆序栈,不能使用任何额外的数据结构。

核心思想

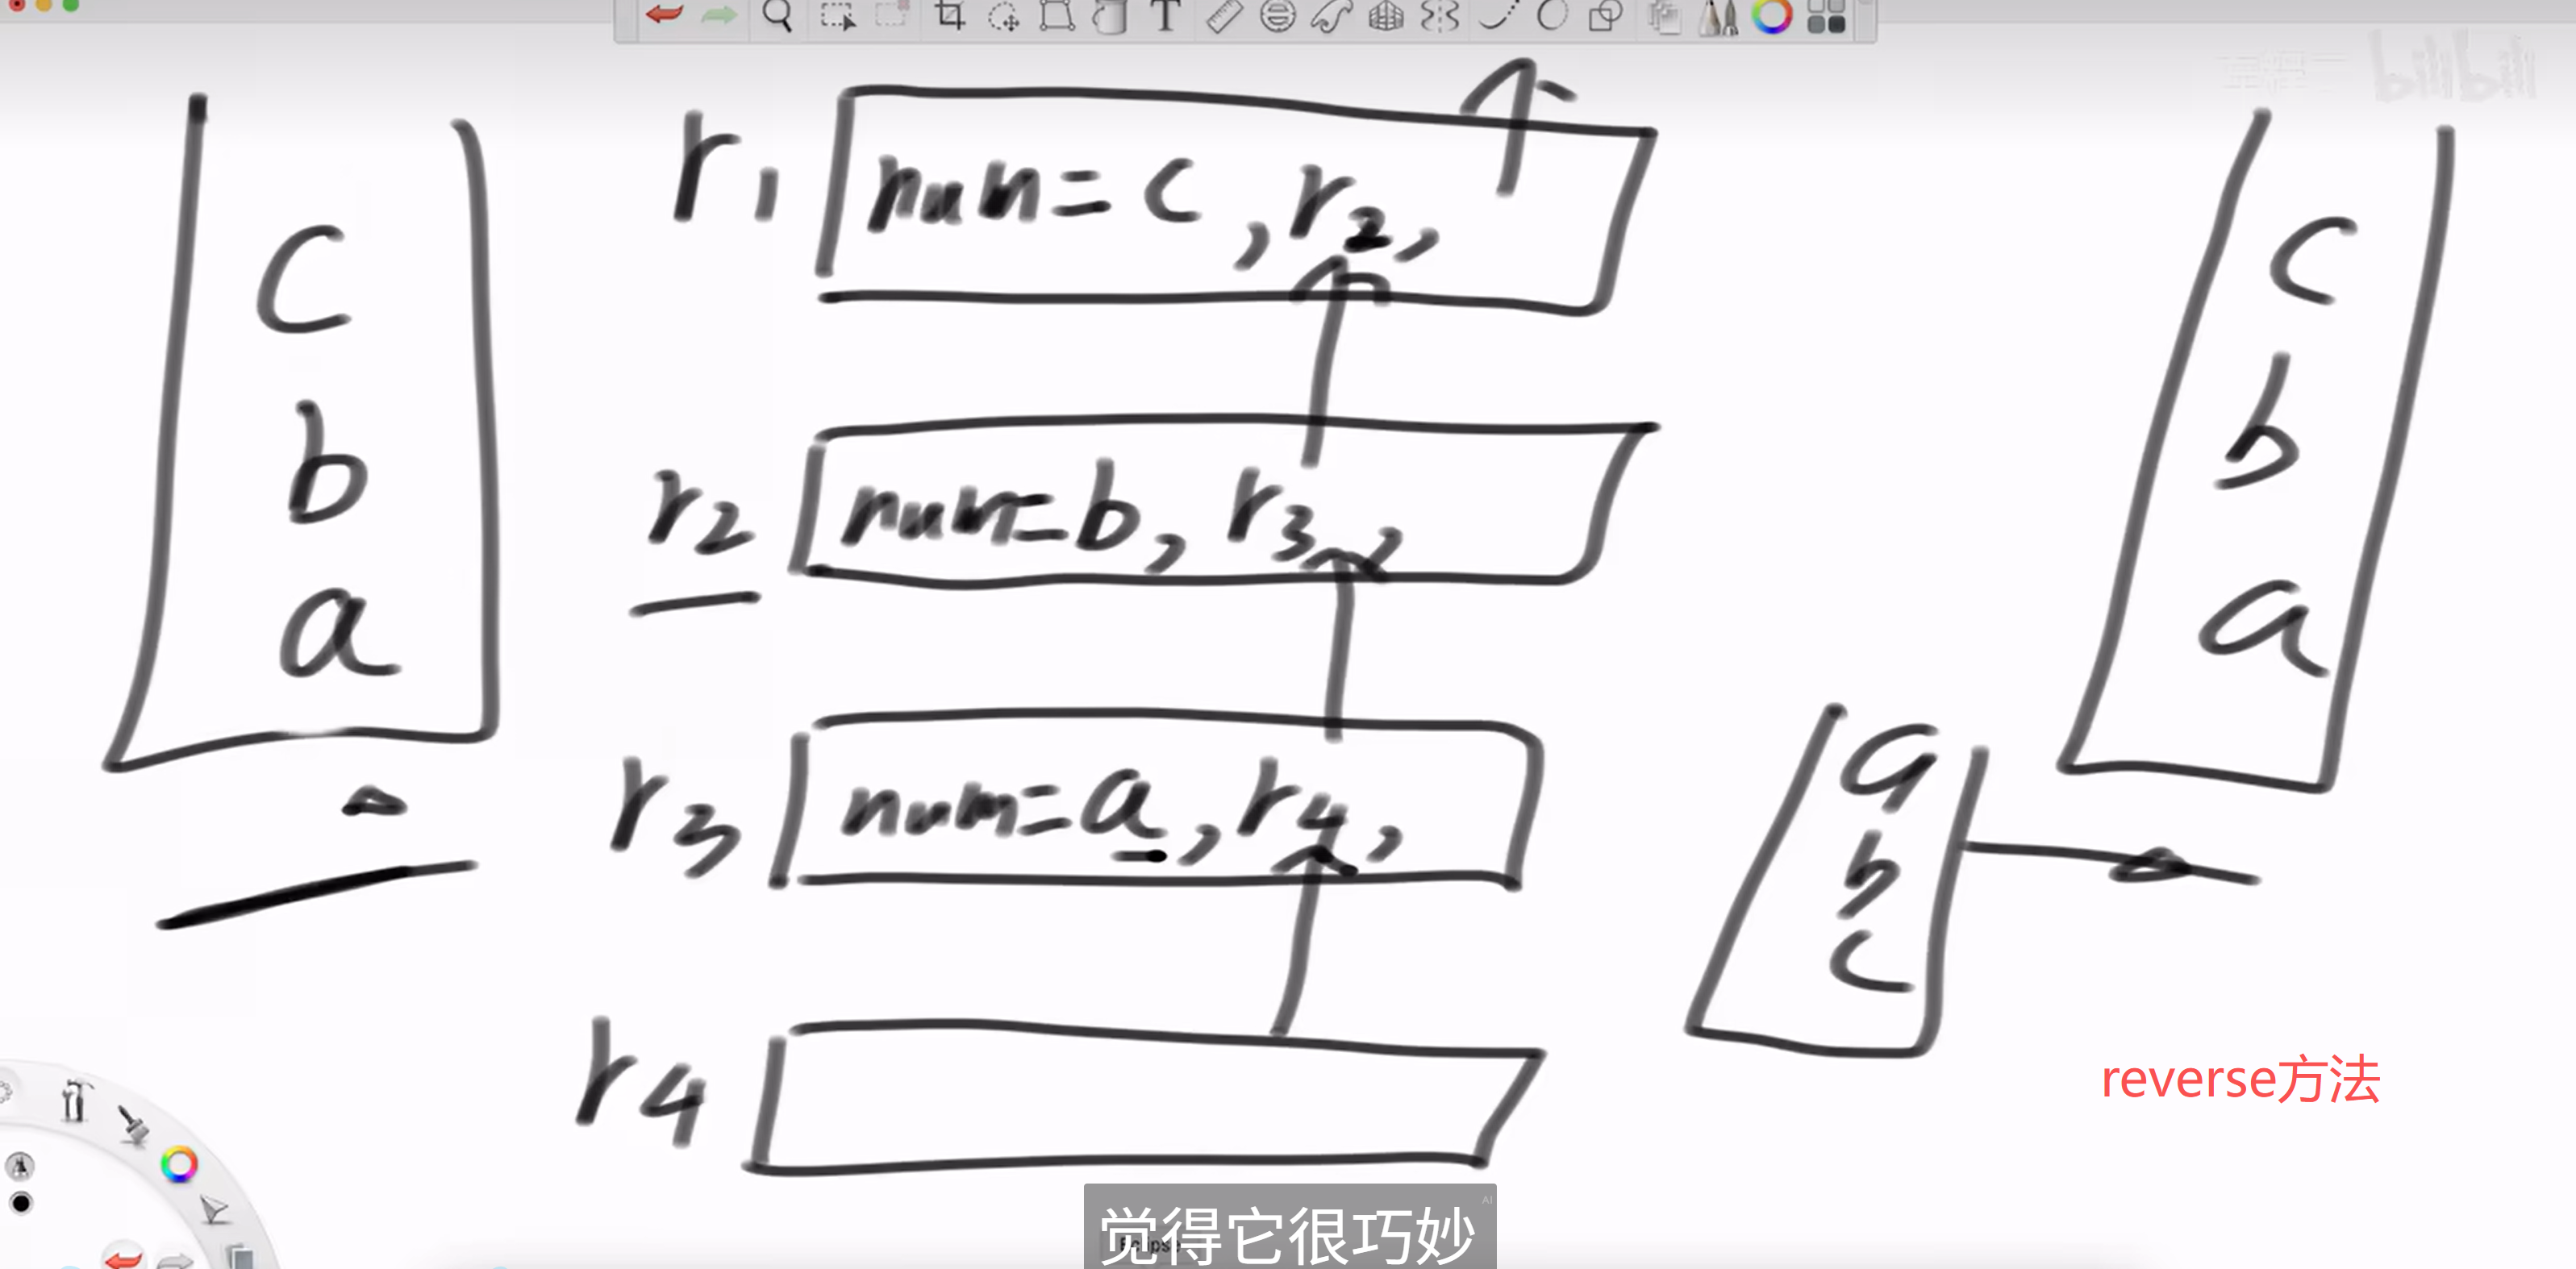
需要两个递归函数:

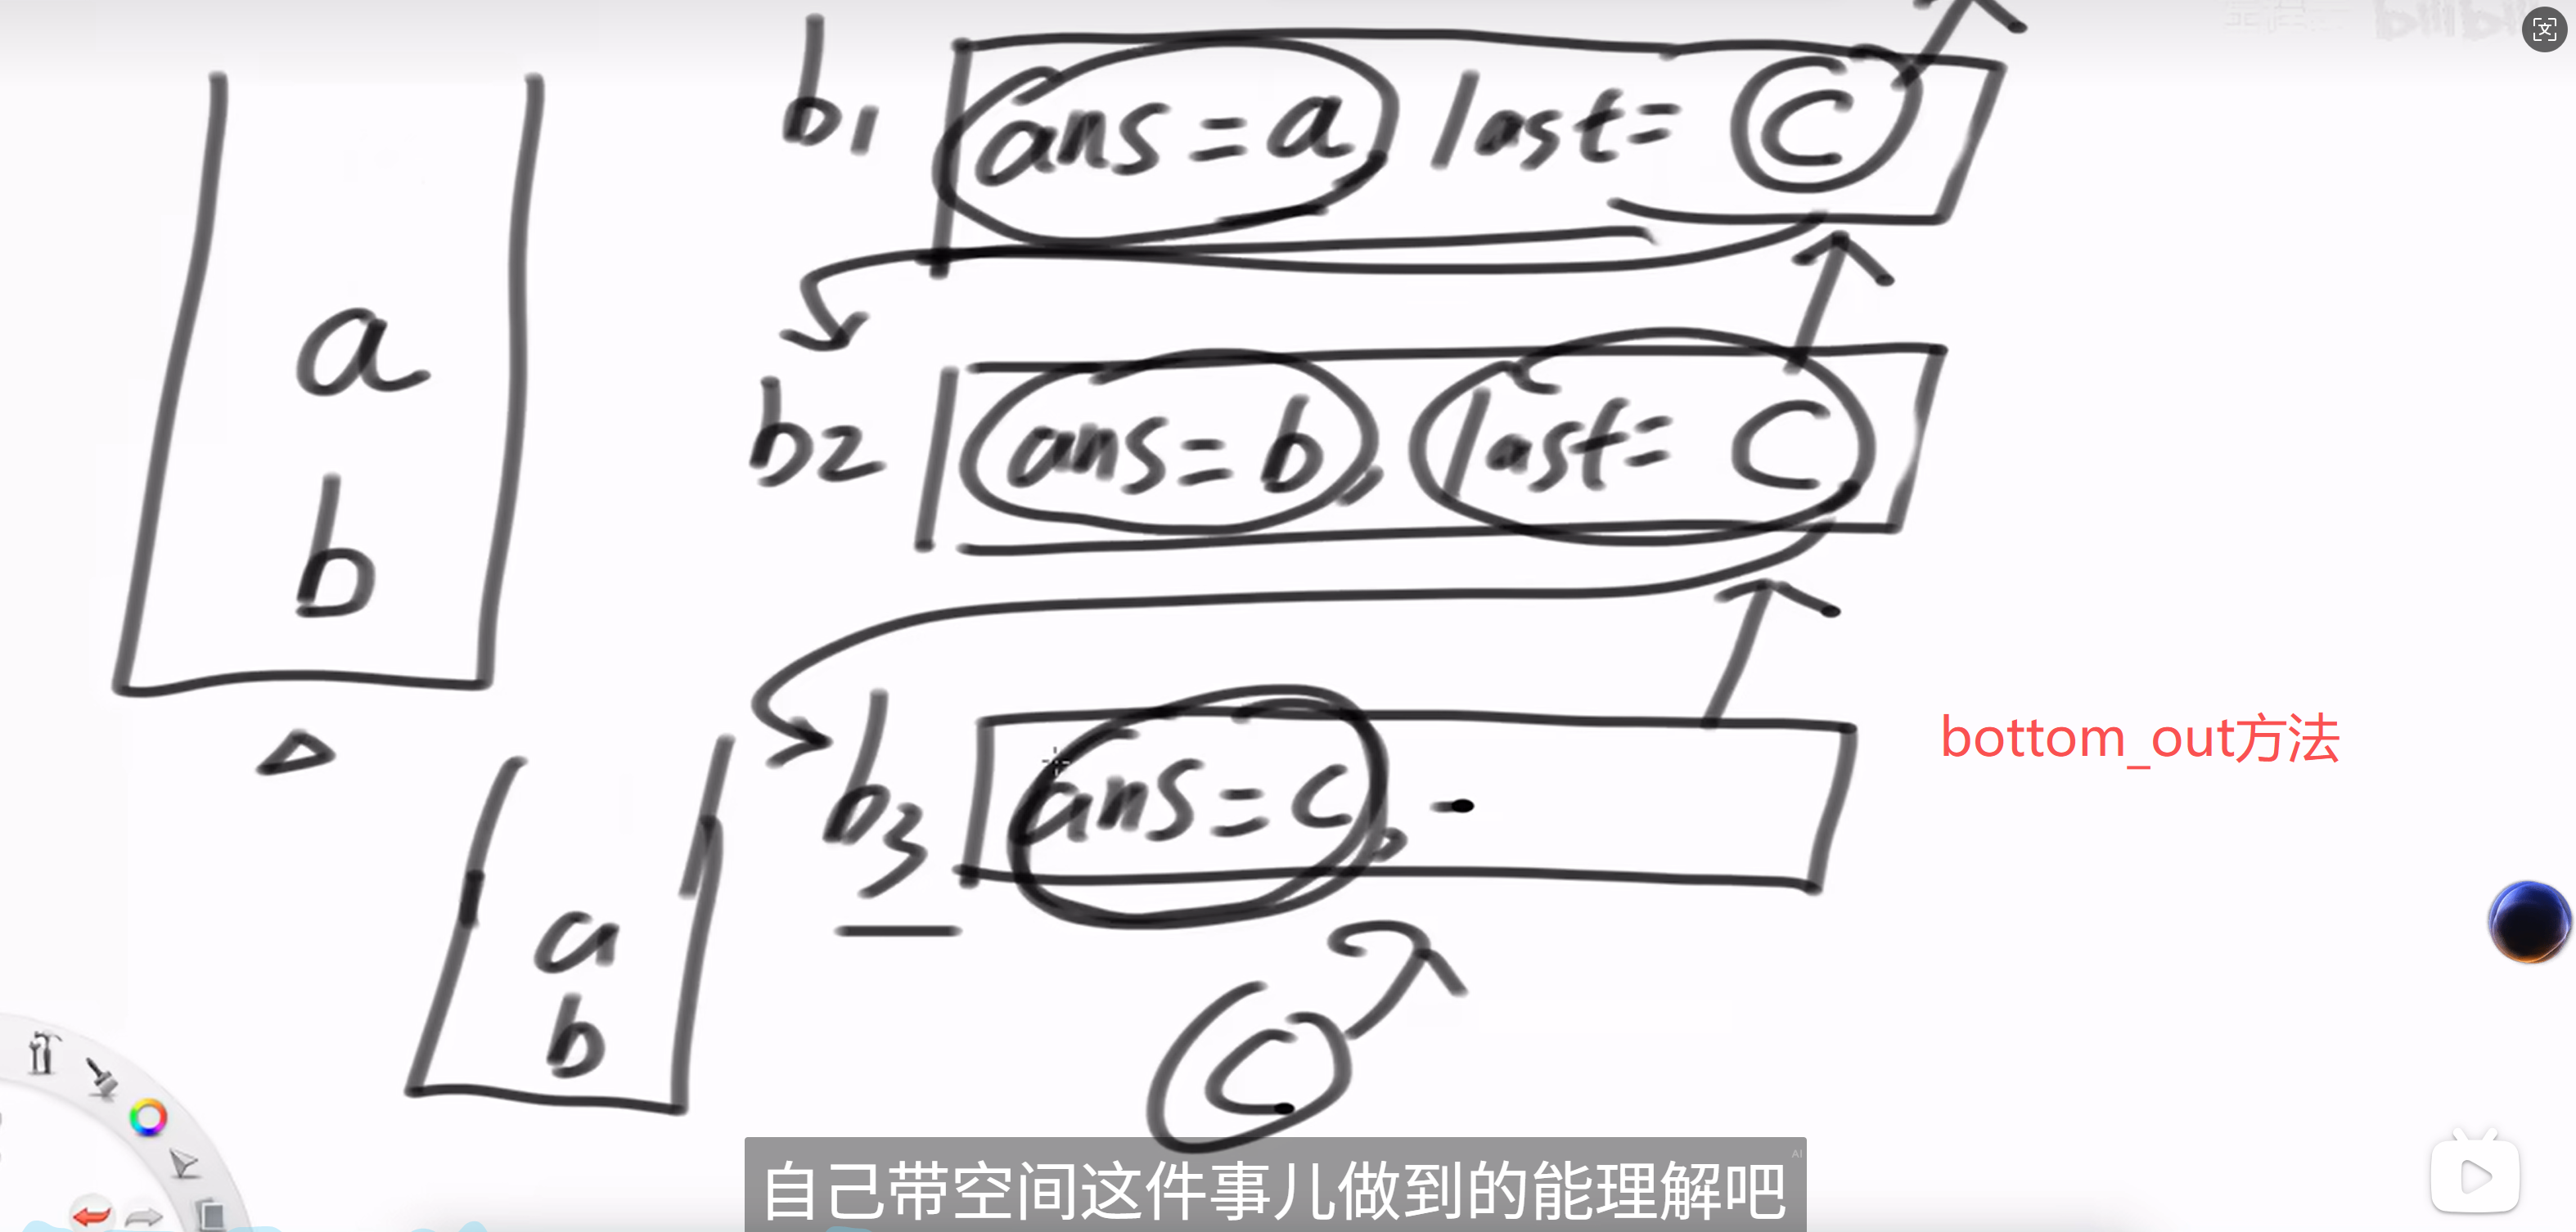
  1. bottom_out:移除并返回栈底元素,同时保持其他元素顺序不变
  2. reverse:利用bottom_out函数来逆序整个栈

逆序栈bottom_out方法
逆序栈reverse方法

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
class Solution:
def reverse(self, stack: List[int]):
"""
主递归函数,用于逆序整个栈。
核心思想:
1. 假设有一个函数 `_bottom_out` 可以移除并返回栈底元素。
2. `reverse` 函数首先调用 `_bottom_out` 得到栈底元素 `num`。
3. 然后,递归调用 `reverse` 来逆序剩下的 n-1 个元素的栈。
4. 最后,将之前取出的栈底元素 `num` 压入已逆序的栈中,此时它就成了新的栈顶。
"""
if not stack:
return

# 递归地移除并获取栈底元素
num = self._bottom_out(stack)
# 递归地逆序剩余的栈
self.reverse(stack)
# 将取出的栈底元素压入栈顶
stack.append(num)

def _bottom_out(self, stack: List[int]) -> int:
"""
辅助递归函数,移除并返回栈底元素,同时保持其他元素顺序不变。
核心思想:
1. 弹出栈顶元素 `ans`。
2. 如果栈空了,说明 `ans` 就是我们想要的栈底元素,返回它。
3. 如果栈不空,递归调用 `_bottom_out` 获取剩下部分的栈底元素 `last`。
4. 在递归返回的过程中,将之前弹出的 `ans` 重新压栈,以恢复栈的状态。
5. 将从递归深处得到的 `last` 一路返回上去。
"""
ans = stack.pop()
if not stack:
return ans # 如果栈空了,说明ans就是栈底元素
else:
last = self._bottom_out(stack) # 递归获取剩下部分的栈底元素
stack.append(ans) # 在递归返回过程中,将之前弹出的ans重新压栈
return last # 将从递归深处得到的last一路返回上去

执行过程示例

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
原栈: [1, 2, 3, 4, 5] (5在栈顶)

第1次reverse调用:
bottom_out取出栈底1,栈变为[2, 3, 4, 5]
递归reverse([2, 3, 4, 5])
返回后将1压入栈顶

第2次reverse调用:
bottom_out取出栈底2,栈变为[3, 4, 5]
递归reverse([3, 4, 5])
返回后将2压入栈顶

...以此类推

最终结果: [1, 2, 3, 4, 5] (1在栈顶)

算法分析

  • 时间复杂度:O(n²)
  • 空间复杂度:O(n) (递归栈空间)
  • 核心技巧:双递归函数配合

题目六:用递归排序一个栈

问题描述

用递归函数排序栈,只能使用栈提供的push、pop、isEmpty三个方法,以及递归函数。要求排完序后,从栈顶到栈底从小到大。

除此之外不能使用任何的容器,数组也不行。就是排序过程中只能用:(1) 栈提供的push、pop、isEmpty三个方法,(2) 递归函数,并且返回值最多为单个整数

核心思想

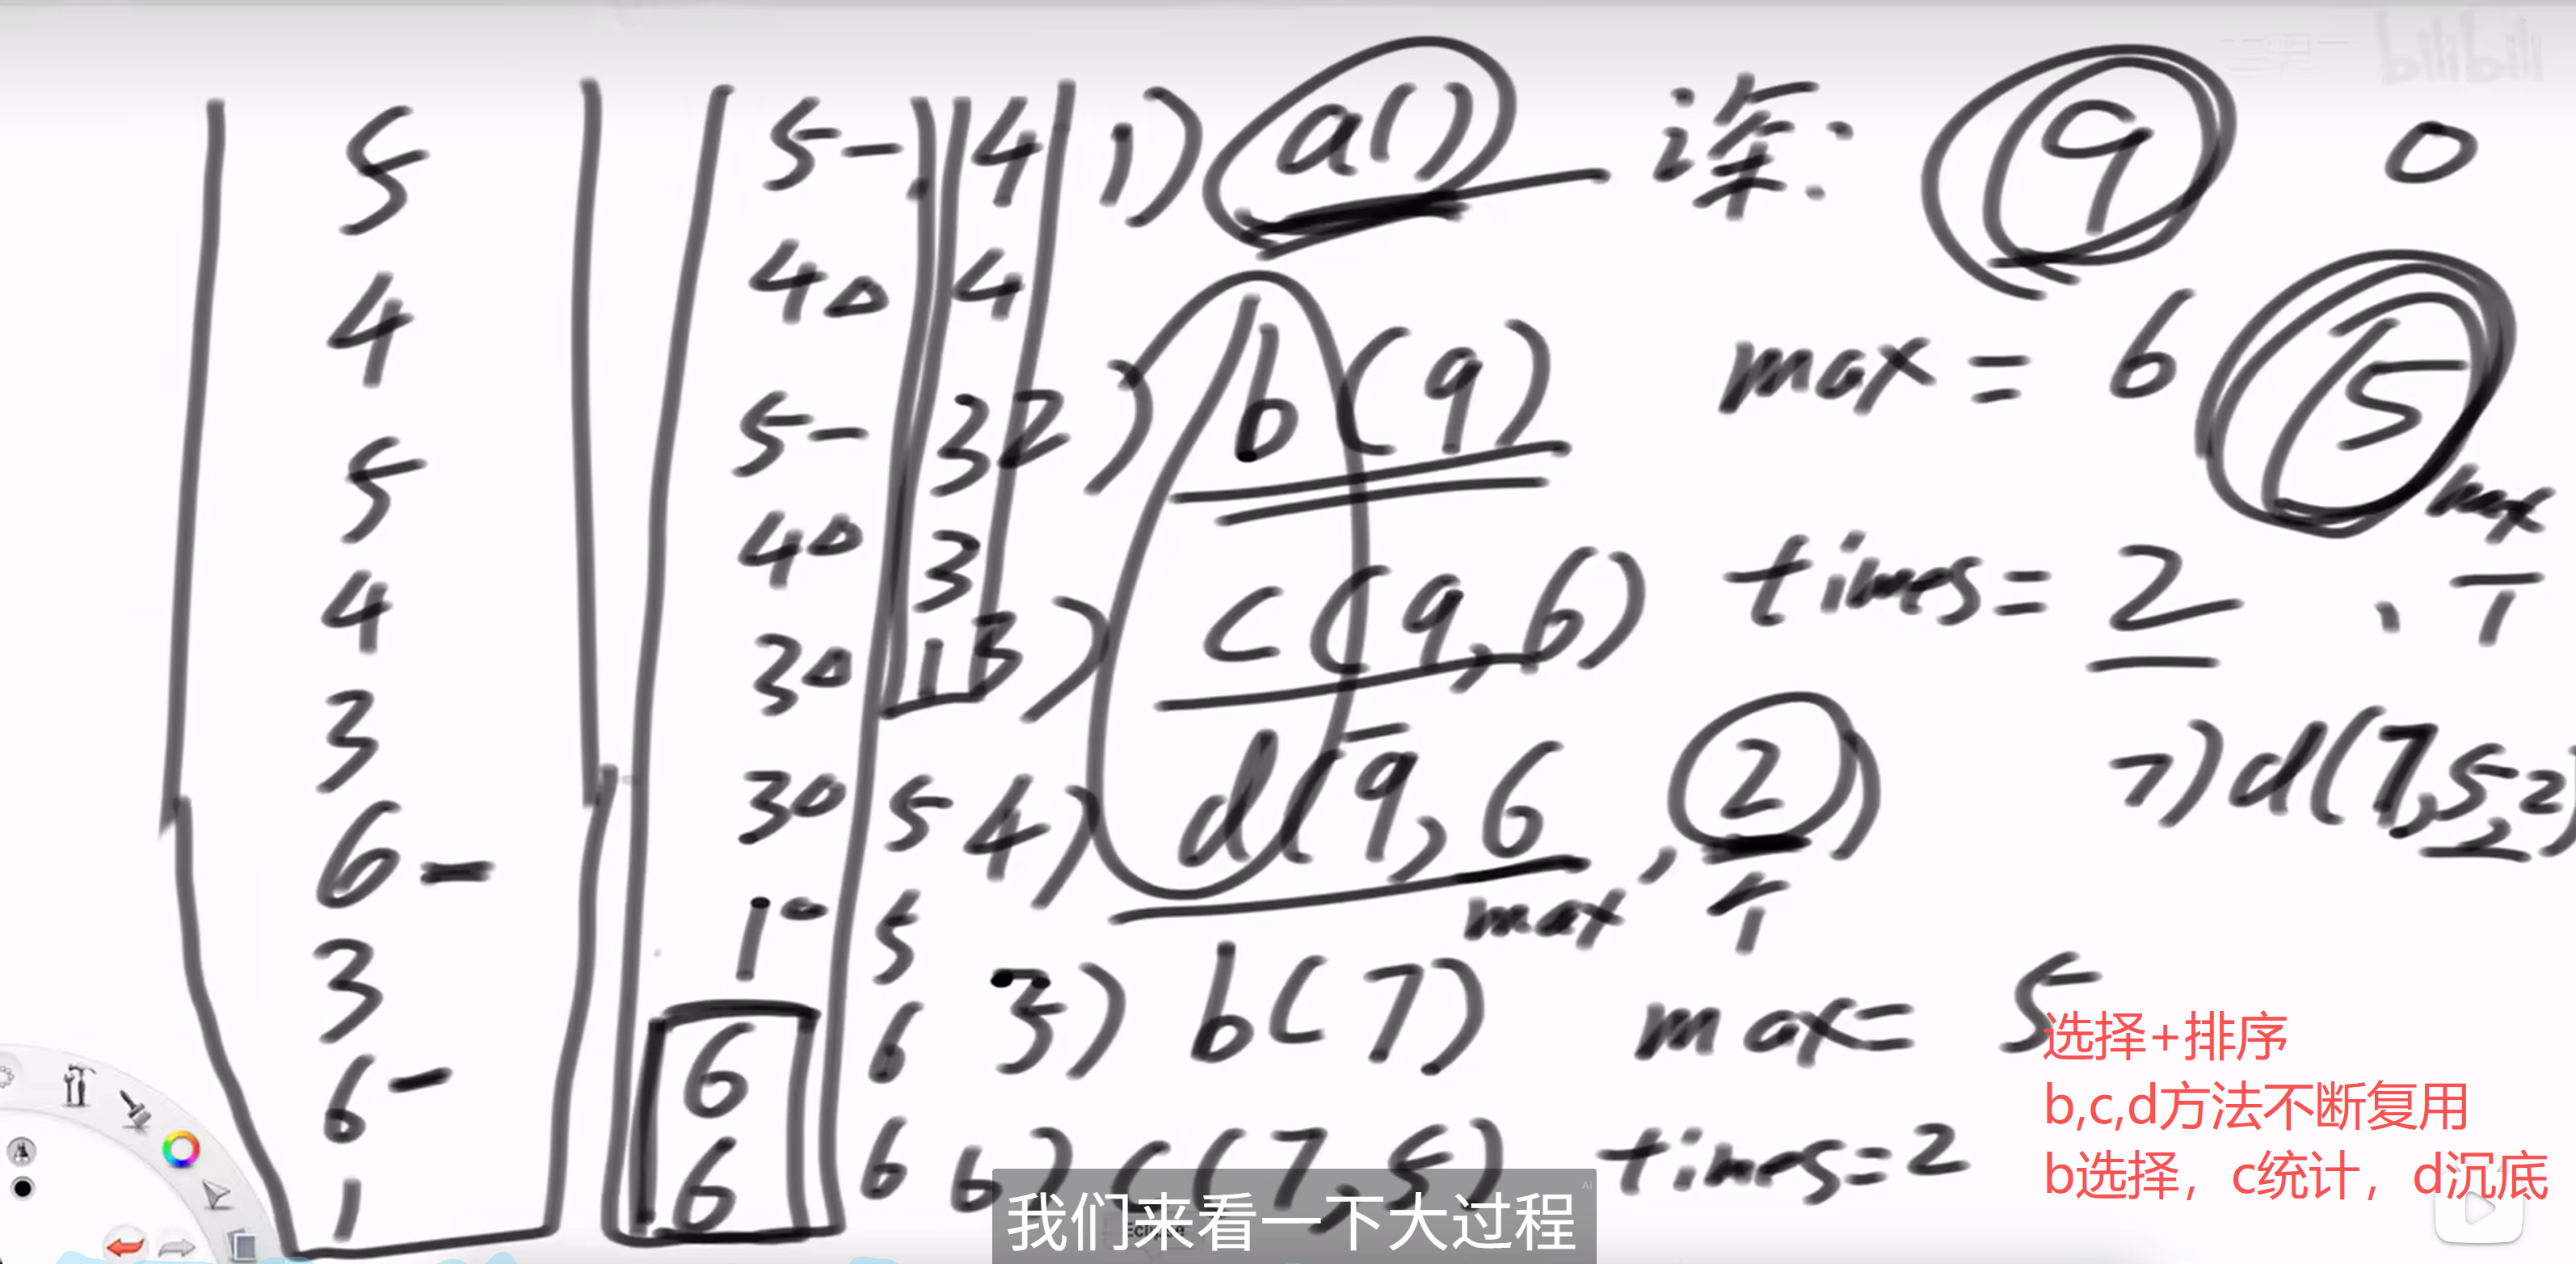
这是一个类似选择排序的递归实现。

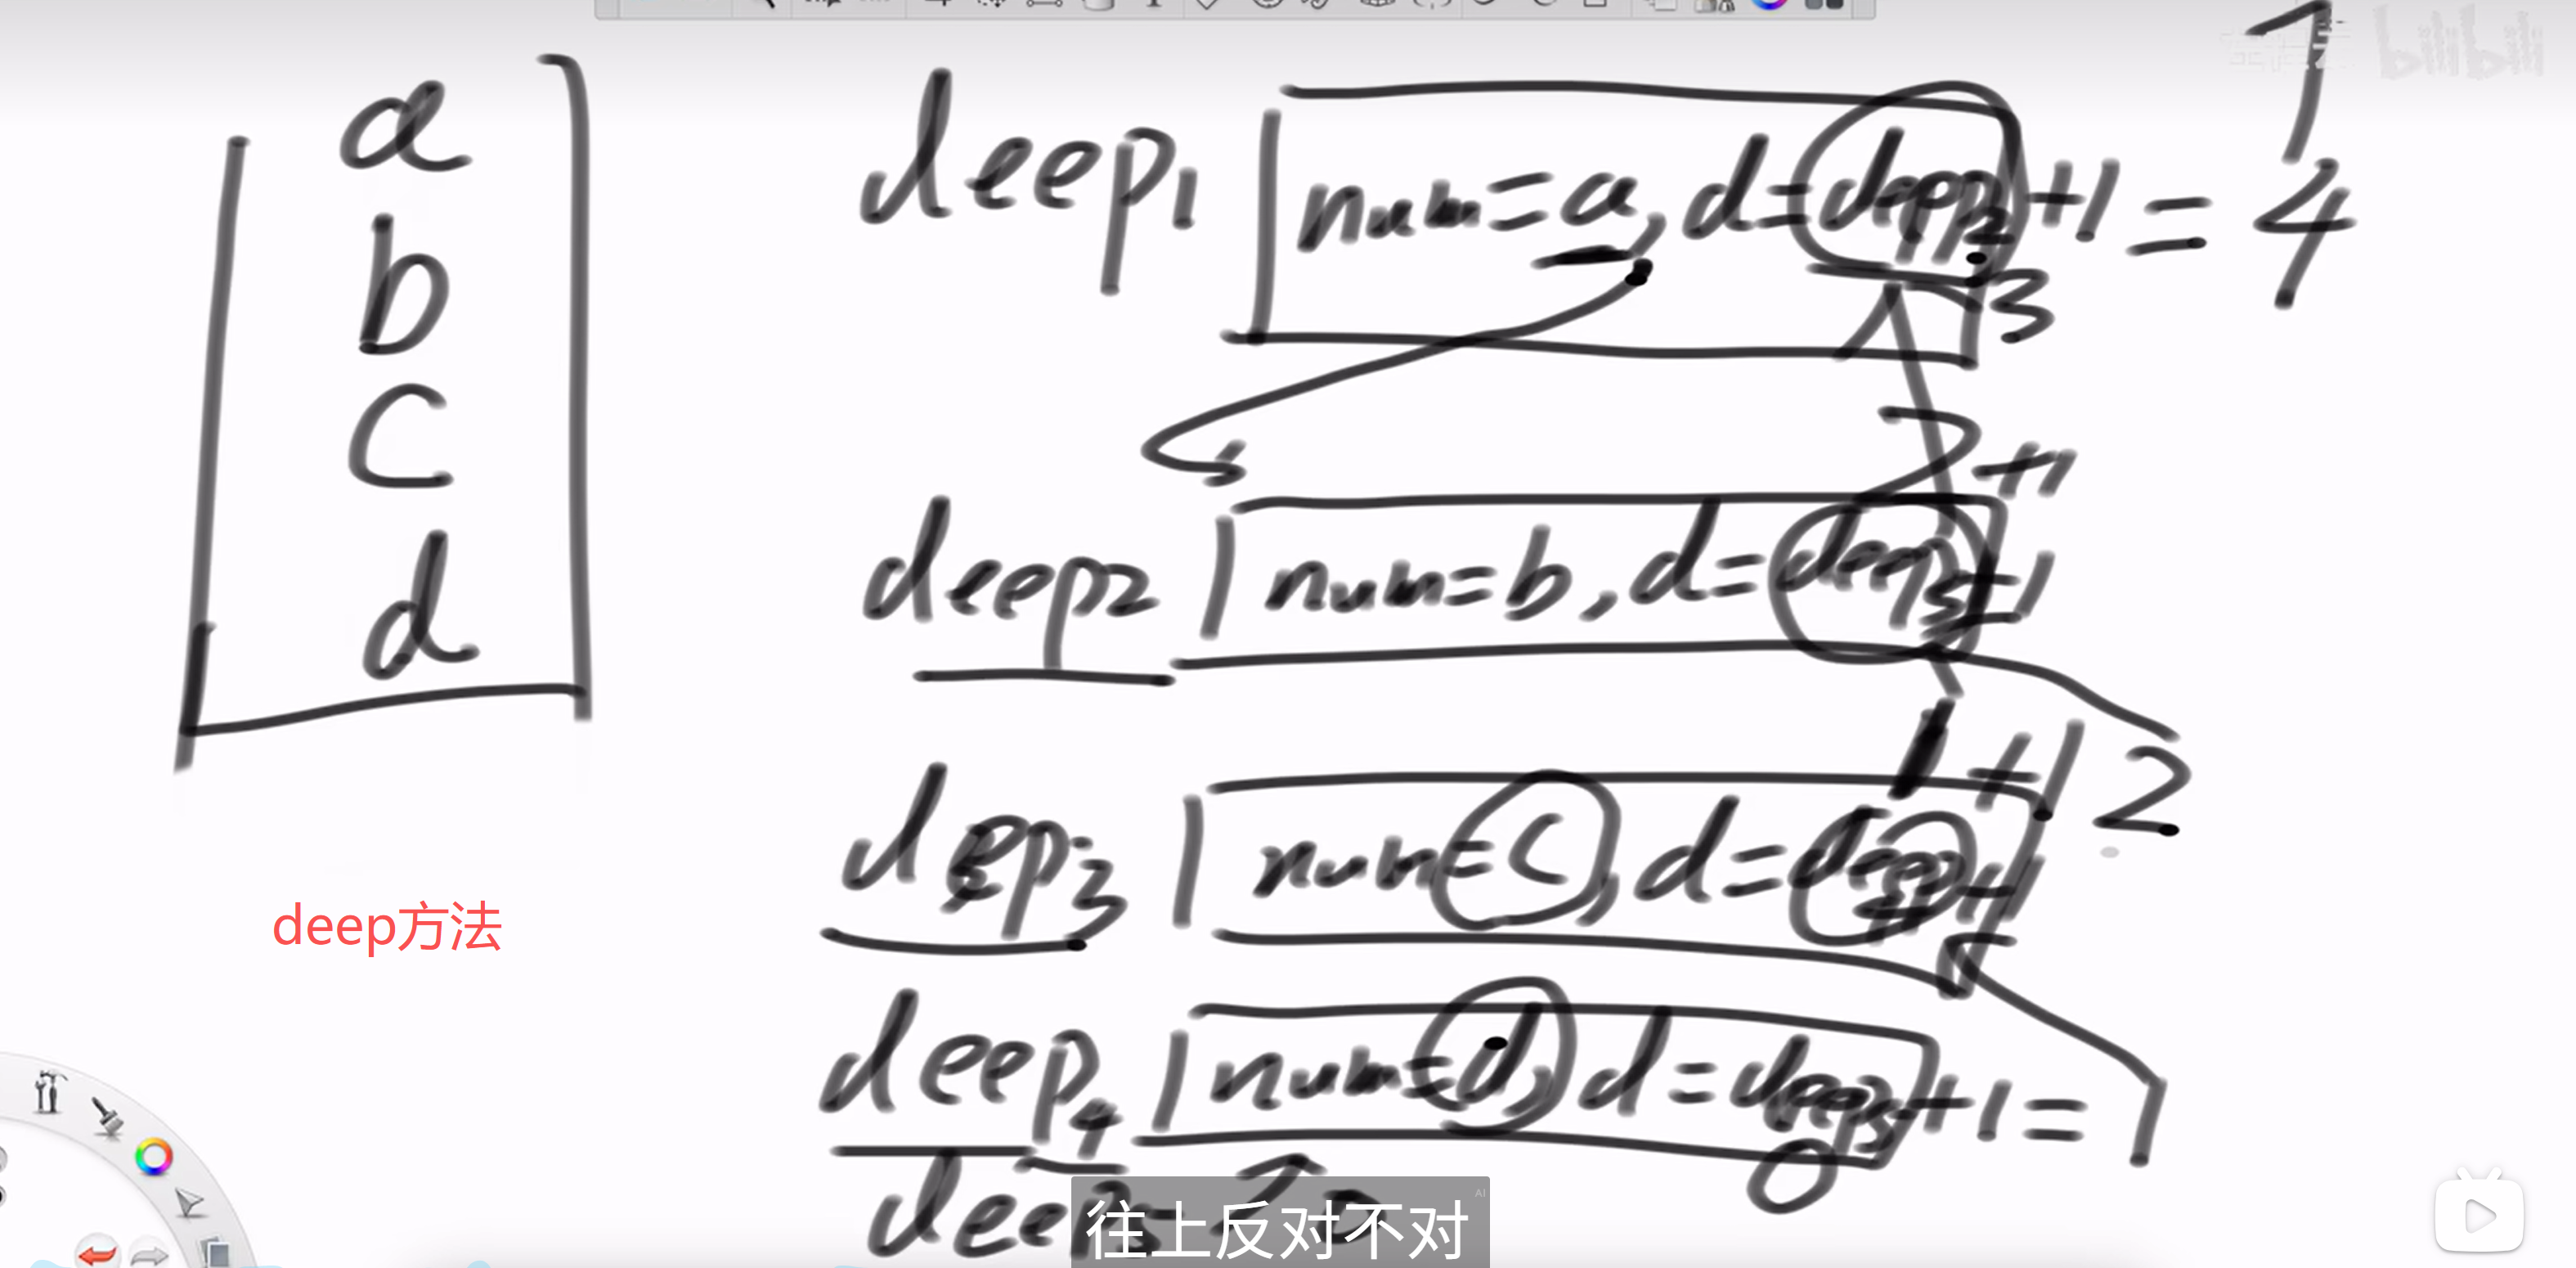
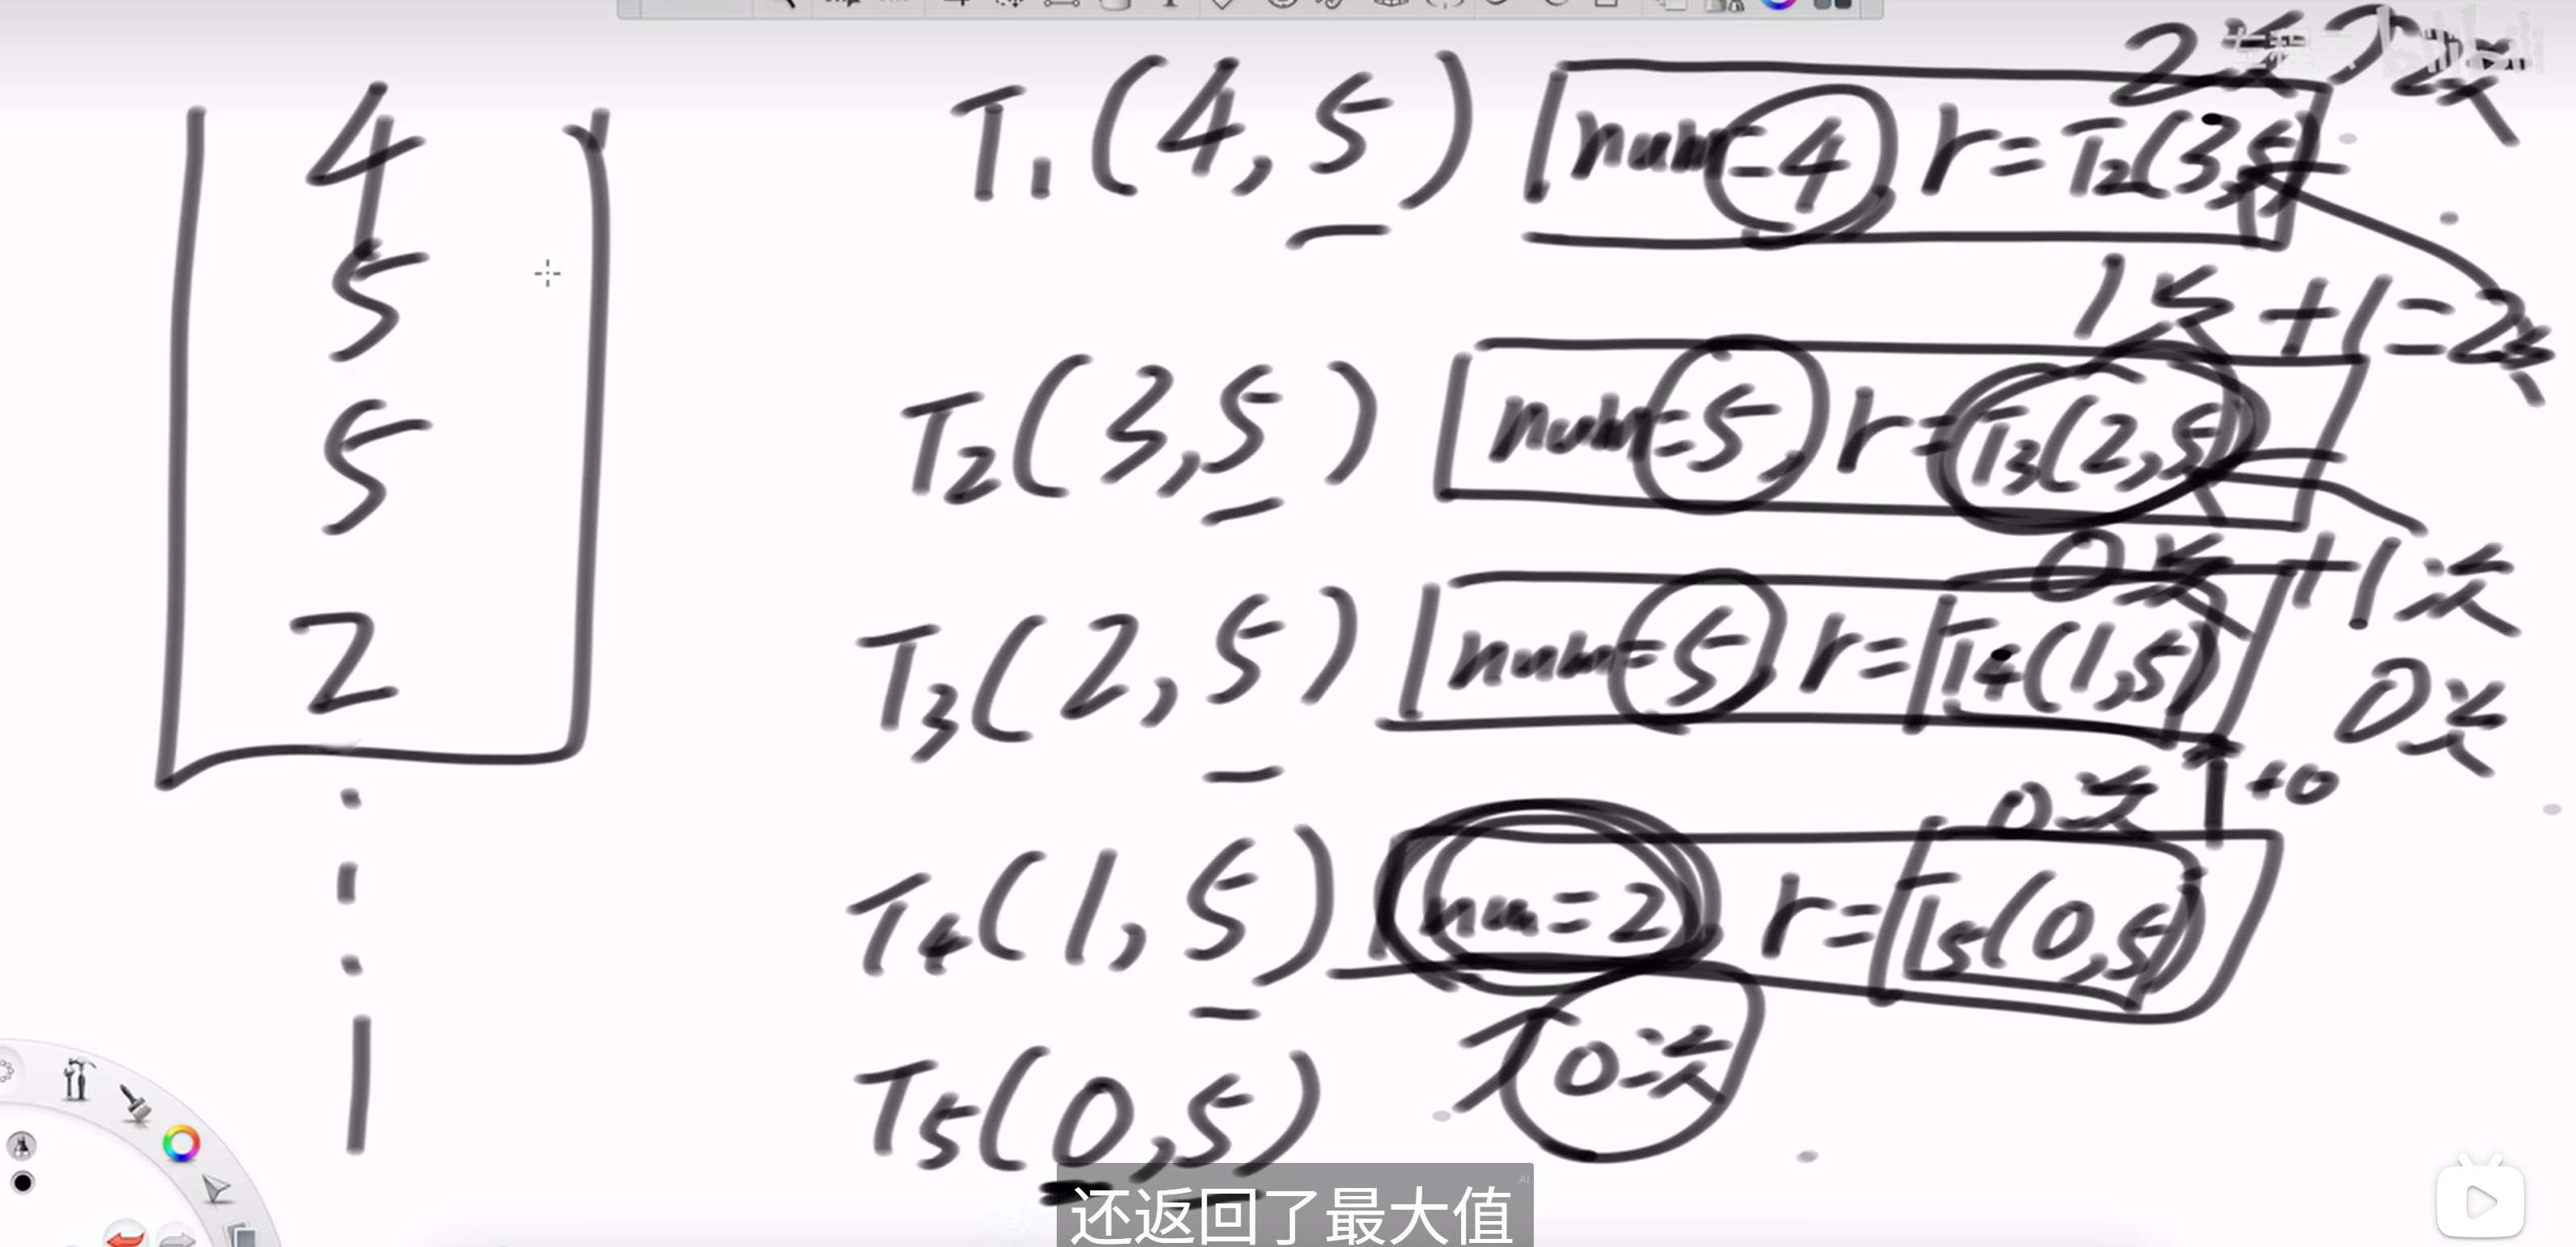
  1. 整个排序过程分为 deep 轮,deep 是当前未排序部分的栈深度。
  2. 在每一轮中,目标是找出这 deep 个元素中的最大值(可能不止一个),并将它们“沉”到这 deep 个元素的最底部。
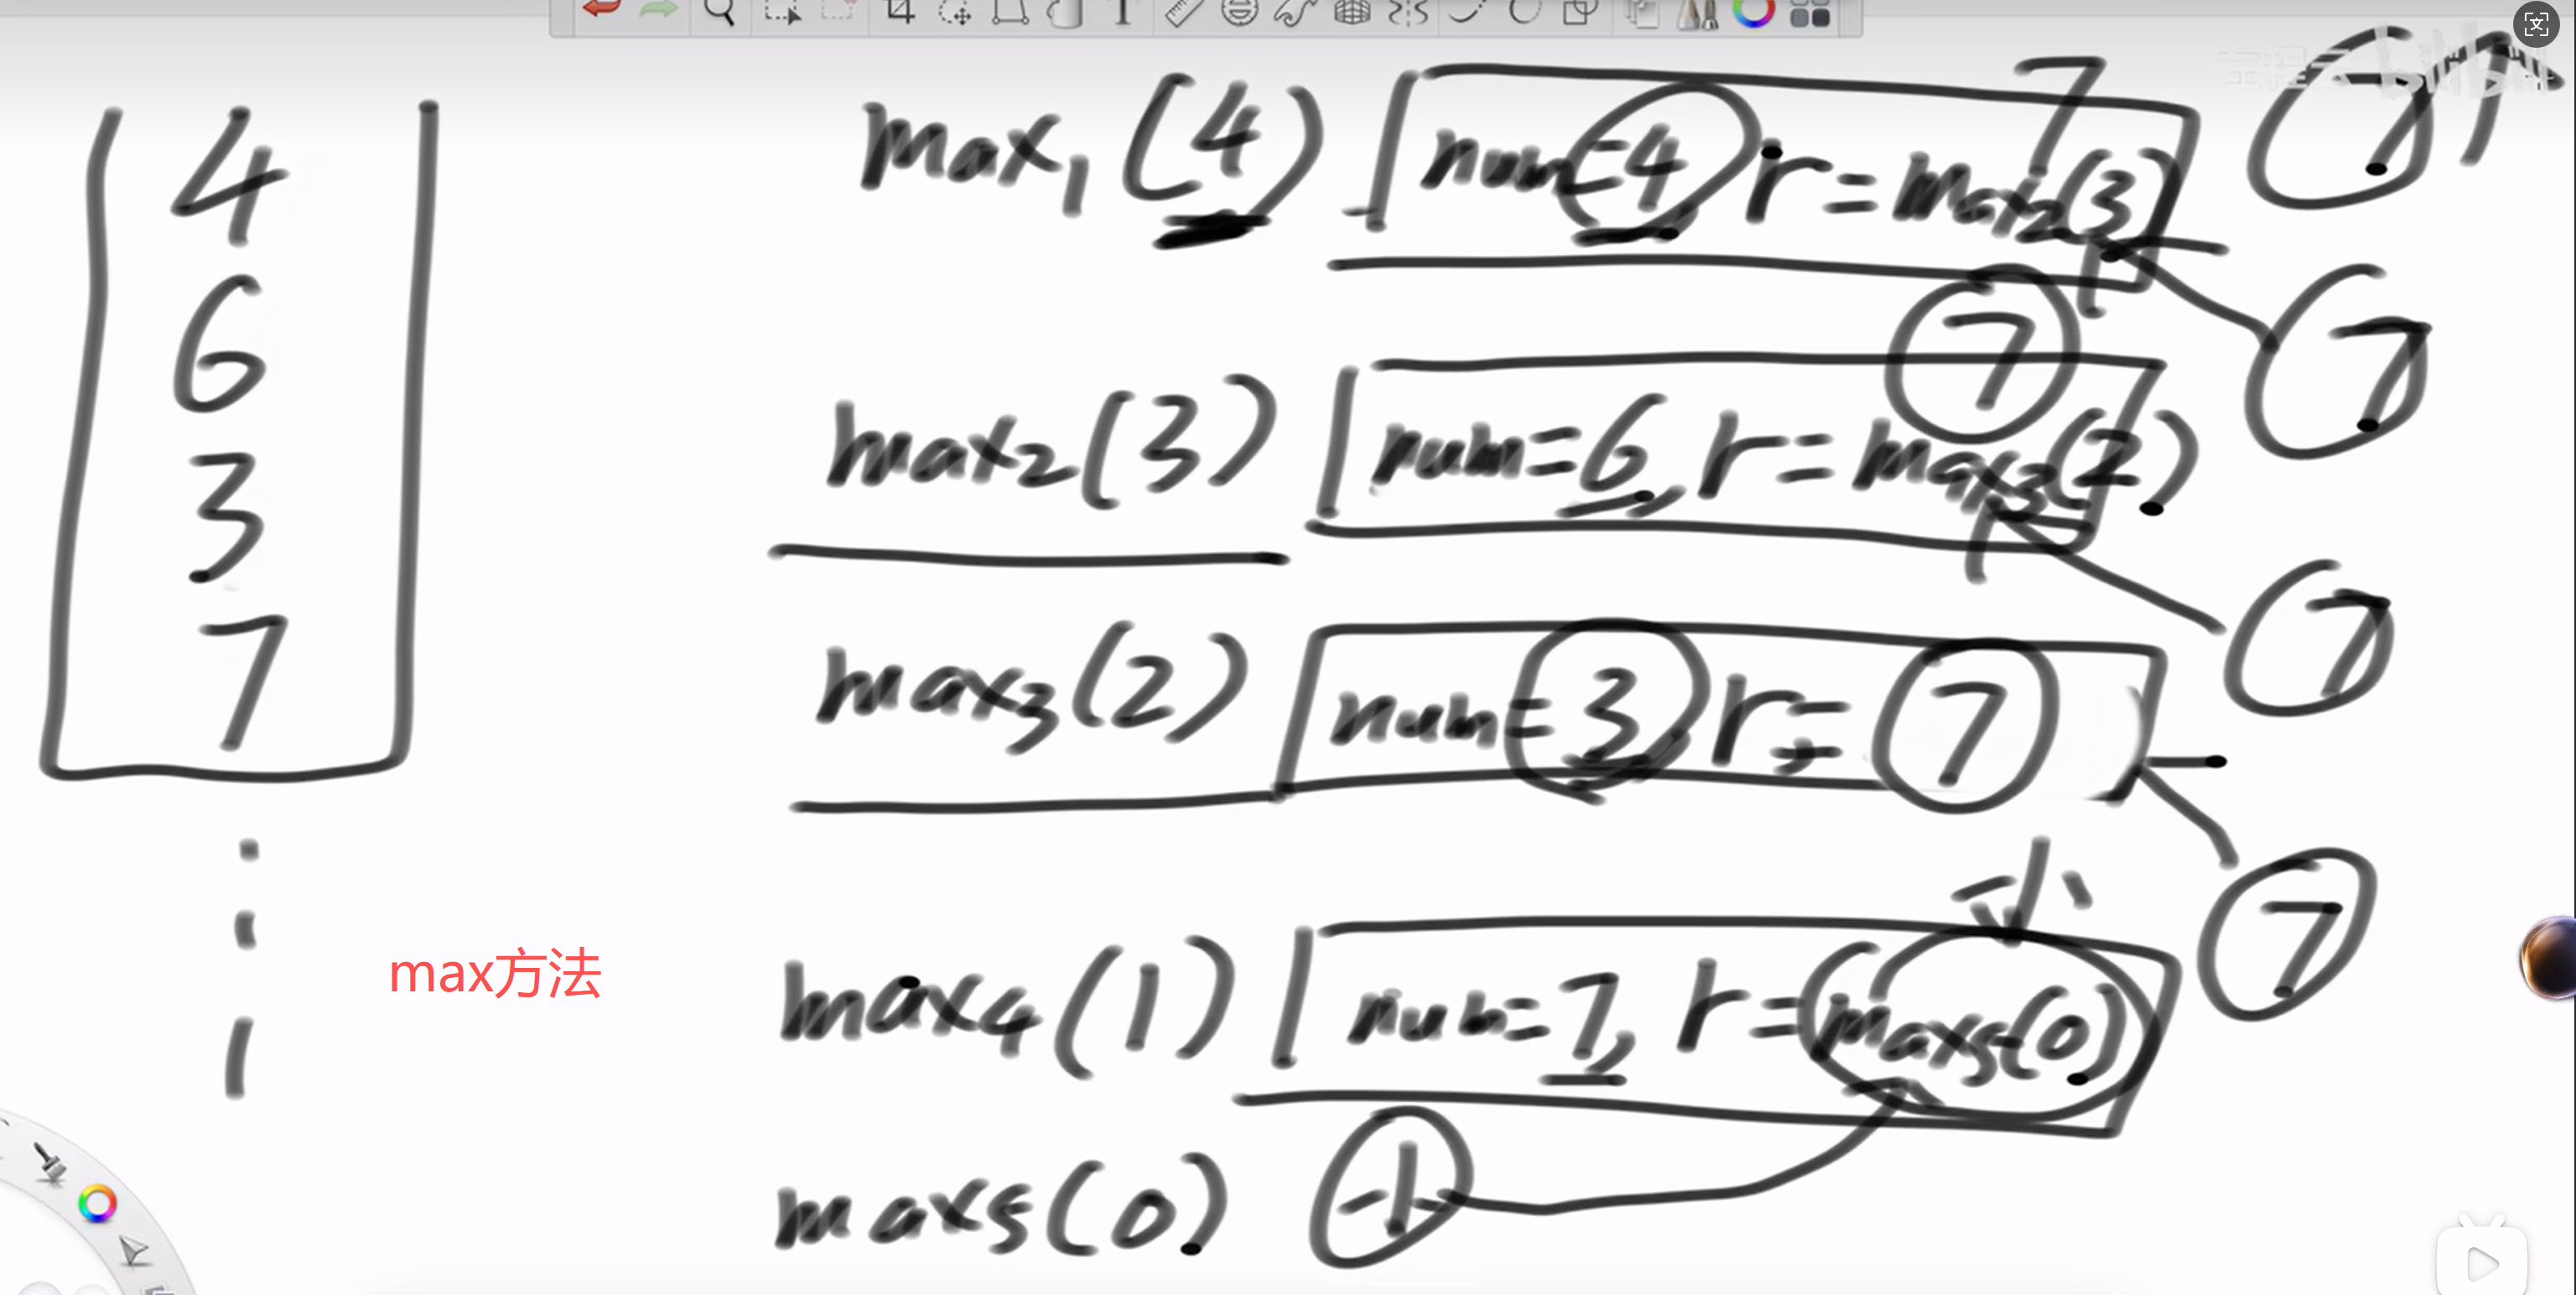
  3. _max() 函数:递归地在 deep 层中找到最大值。
  4. _times() 函数:递归地在 deep 层中统计这个最大值出现了几次 k。
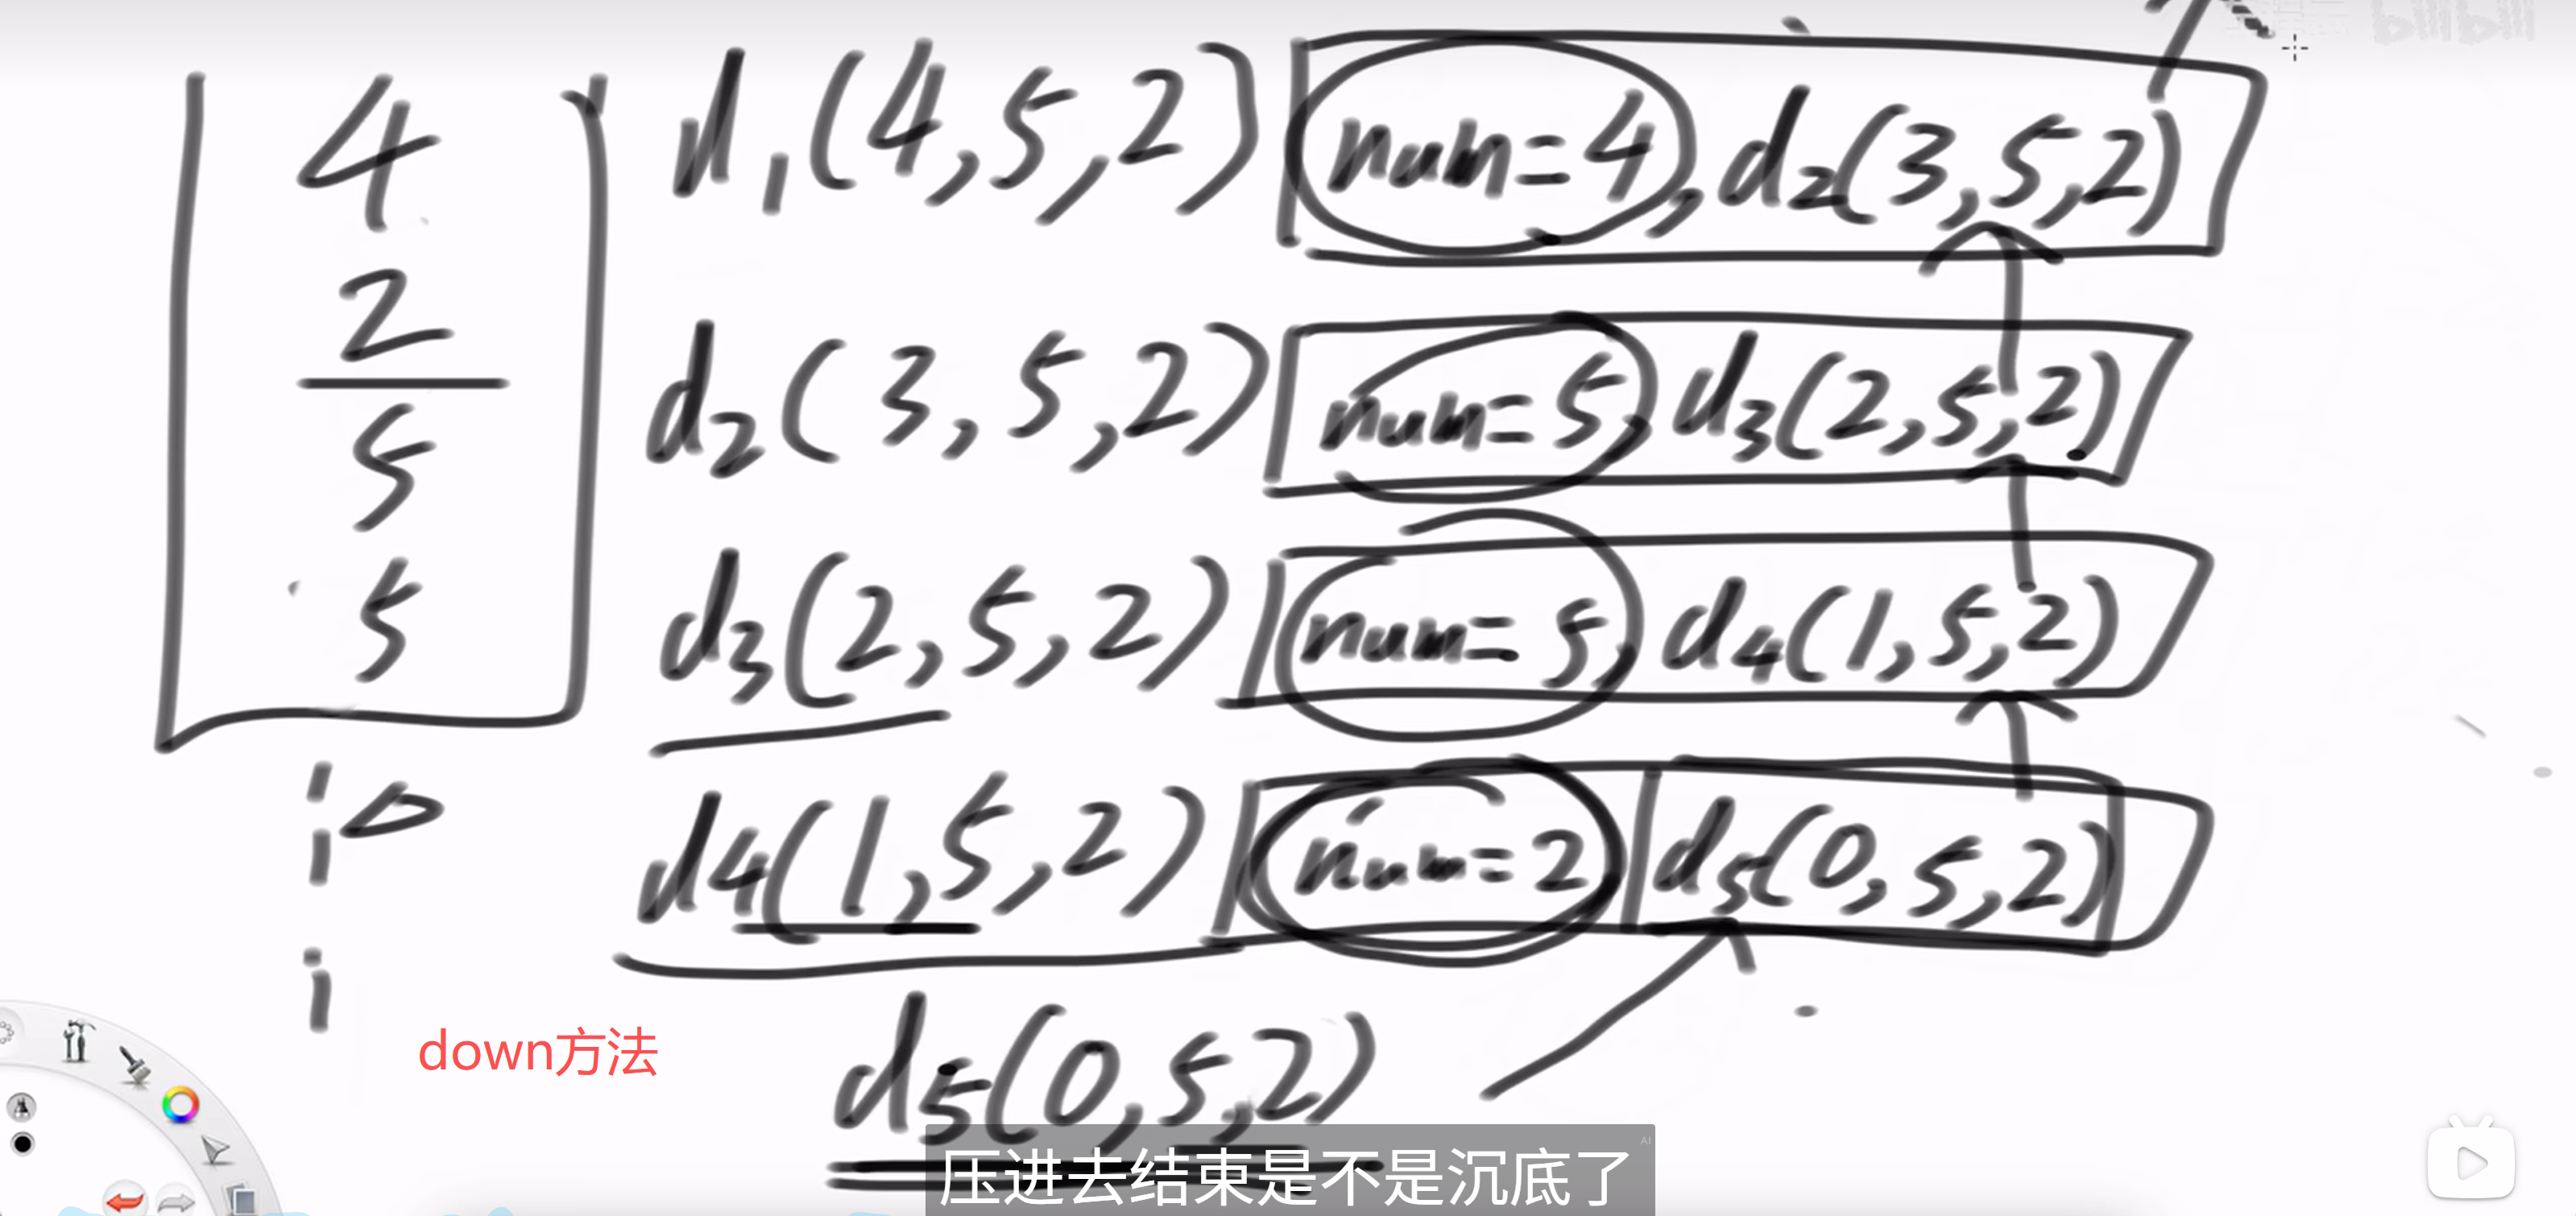
  5. _down() 函数:递归地将这 k 个最大值移动到 deep 层的底部,同时保持其他 deep-k 个元素的相对顺序。
  6. 完成一轮后,未排序的深度减少 k (deep -= k),然后对剩下的 deep 个元素重复此过程。

排列栈_整体框架
排列栈_deep方法
排列栈_max方法
排列栈_times方法
排列栈_down方法

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
class Solution:
def sort_stack(self, stack: List[int]):
deep = self._deep(stack)
while deep > 0:
# 找到当前 deep 范围内的最大值
maximum = self._max(stack, deep)
# 统计最大值出现的次数
k = self._times(stack, deep, maximum)
# 将这 k 个最大值沉底
self._down(stack, deep, maximum, k)
# 待排序的深度减少 k
deep -= k

def _deep(self, stack: List[int]) -> int:
"""返回栈的深度,不改变栈的数据状况"""
if not stack:
return 0
num = stack.pop()
deep = self._deep(stack) + 1
stack.append(num) # 恢复现场
return deep

def _max(self, stack: List[int], deep: int) -> int:
"""从栈当前的顶部开始,往下数deep层,返回这deep层里的最大值"""
if deep == 0:
return -float('inf') # 返回一个极小值作为基准
num = stack.pop()
rest_max = self._max(stack, deep - 1)
current_max = max(num, rest_max)
stack.append(num) # 恢复现场
return current_max

def _times(self, stack: List[int], deep: int, maximum: int) -> int:
"""返回maximum在deep层中出现的次数,不改变栈的数据状况"""
if deep == 0:
return 0
num = stack.pop()
rest_times = self._times(stack, deep - 1, maximum)
times = rest_times + (1 if num == maximum else 0)
stack.append(num) # 恢复现场
return times

def _down(self, stack: List[int], deep: int, maximum: int, k: int):
"""将k个最大值沉到deep层的底部,剩下的数据状况不变"""
if deep == 0:
# 递归到底部时,先把k个最大值压入栈
for _ in range(k):
stack.append(maximum)
else:
num = stack.pop()
self._down(stack, deep - 1, maximum, k)
# 在递归返回时,只把非最大值的元素压回去
if num != maximum:
stack.append(num)

算法分析

  • 时间复杂度:O(n²)
  • 空间复杂度:O(n) (递归栈空间)
  • 核心技巧:多递归函数配合 + 选择排序思想

题目七:打印n层汉诺塔问题的最优移动轨迹

问题描述

打印n层汉诺塔问题的最优移动轨迹。

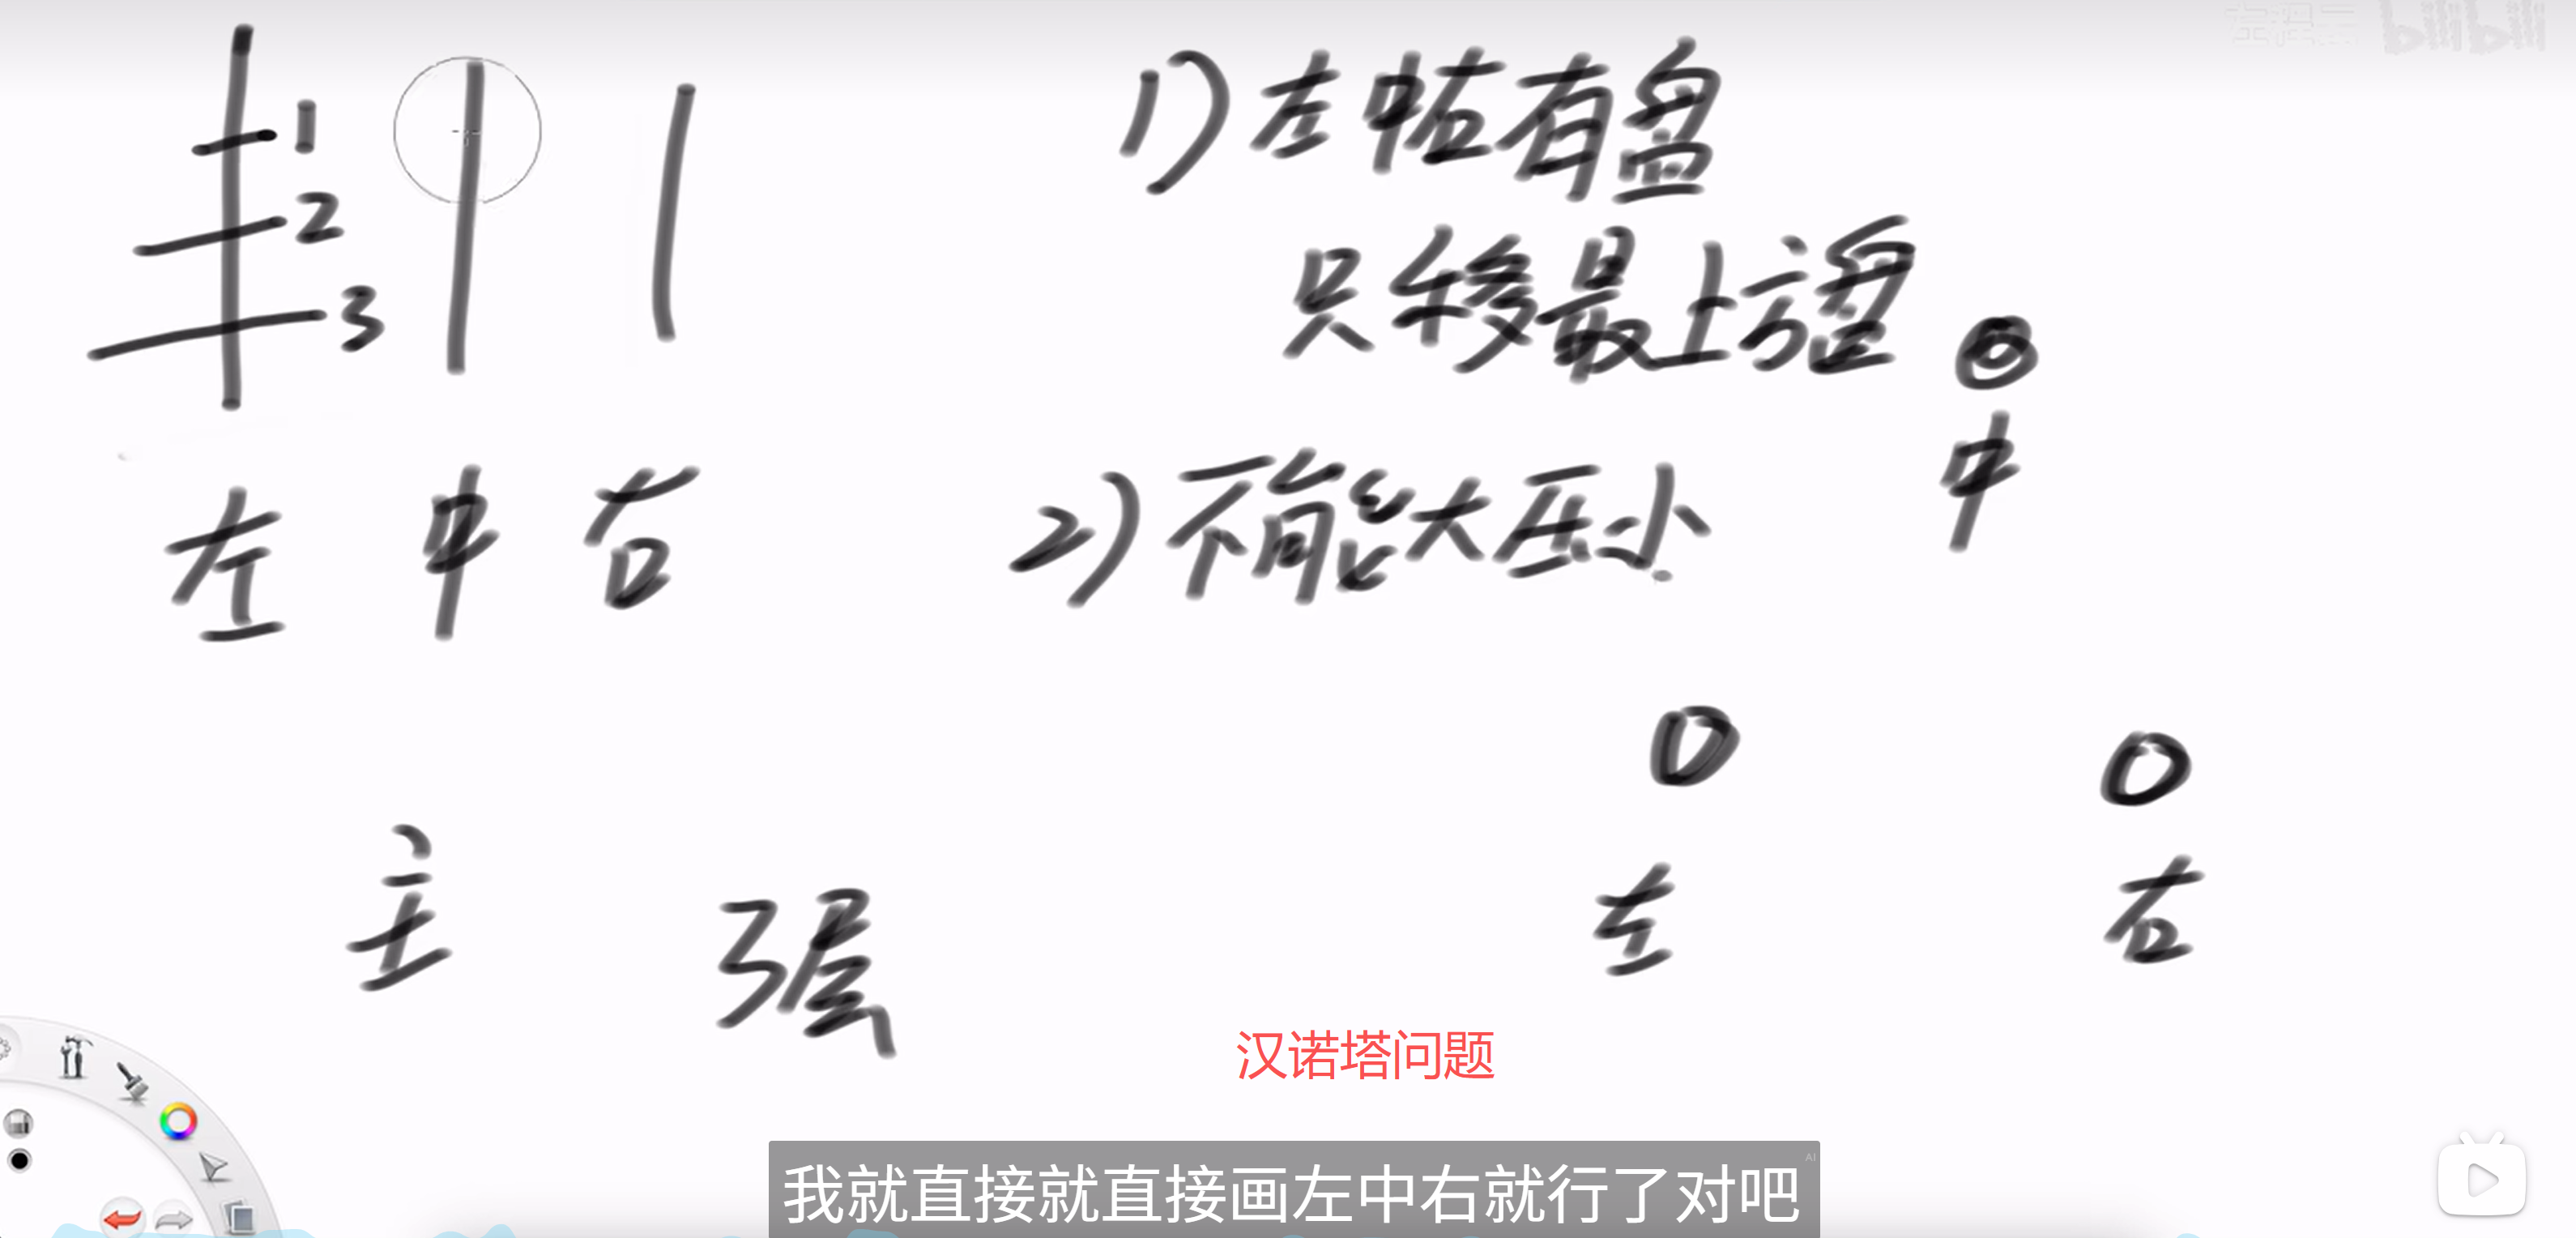
核心思想

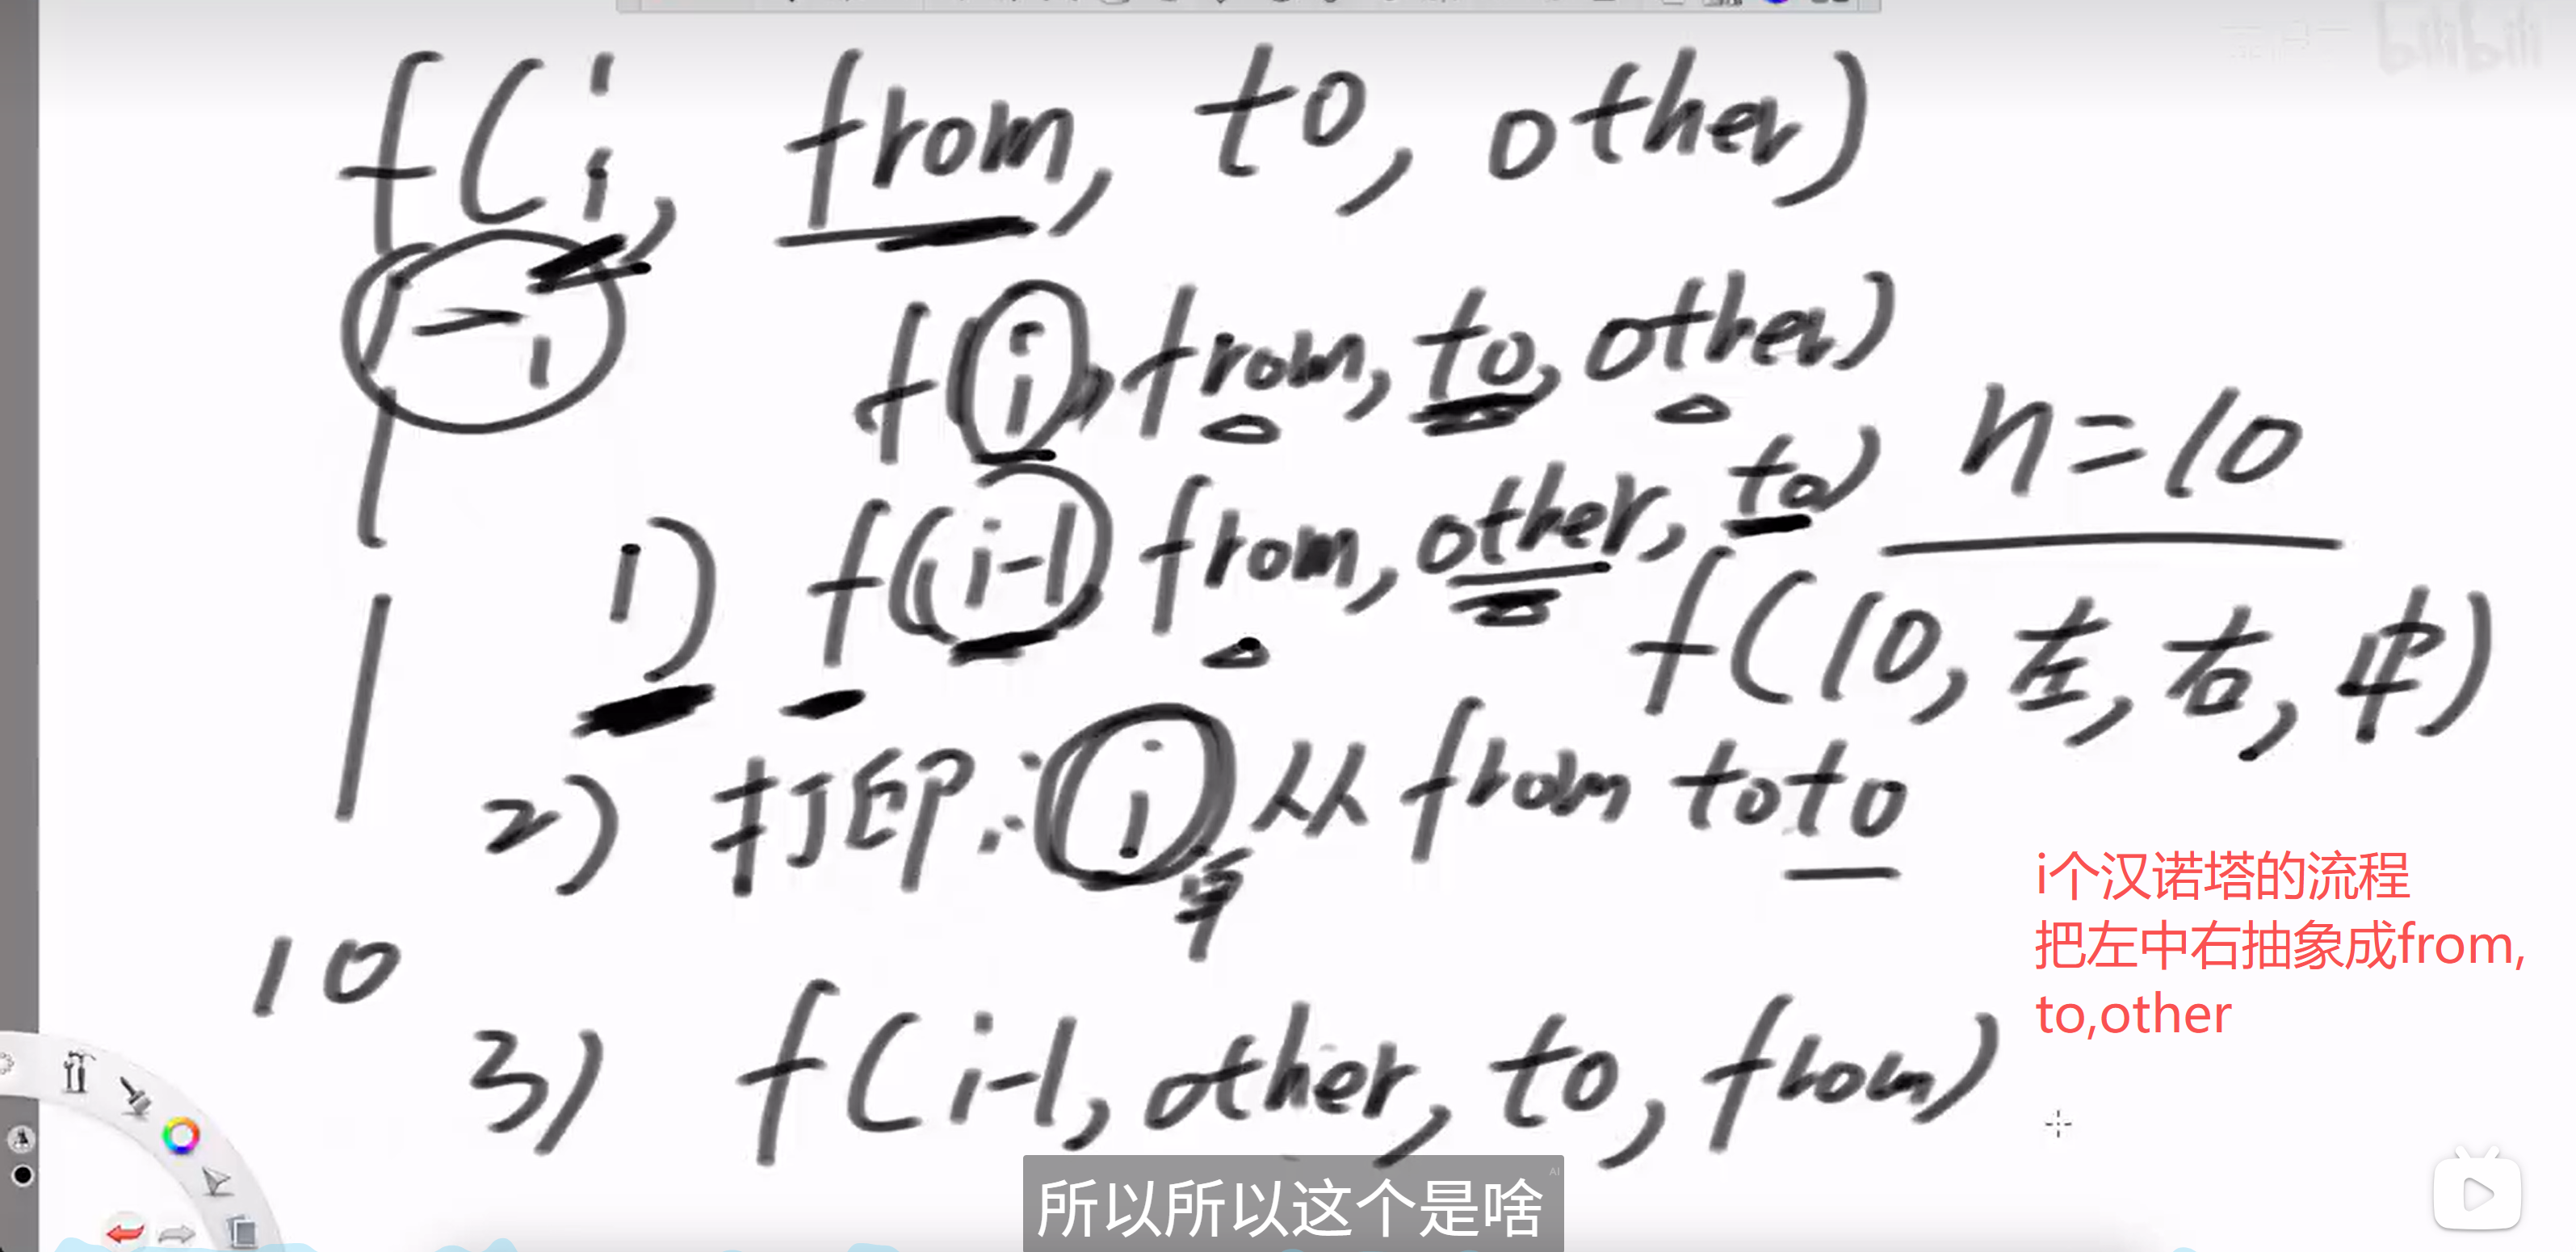
这是一个经典的递归分治问题。要将 i 个盘子从 A 移动到 C:

  1. 先将 i-1 个盘子从 A 移动到 B (辅助柱)。
  2. 再将第 i 个盘子 (最大的那个) 从 A 移动到 C。
  3. 最后将 i-1 个盘子从 B 移动到 C。
    这个过程完美地将一个大问题分解为两个规模更小的相同问题和一个简单的单步操作。

汉诺塔问题描述
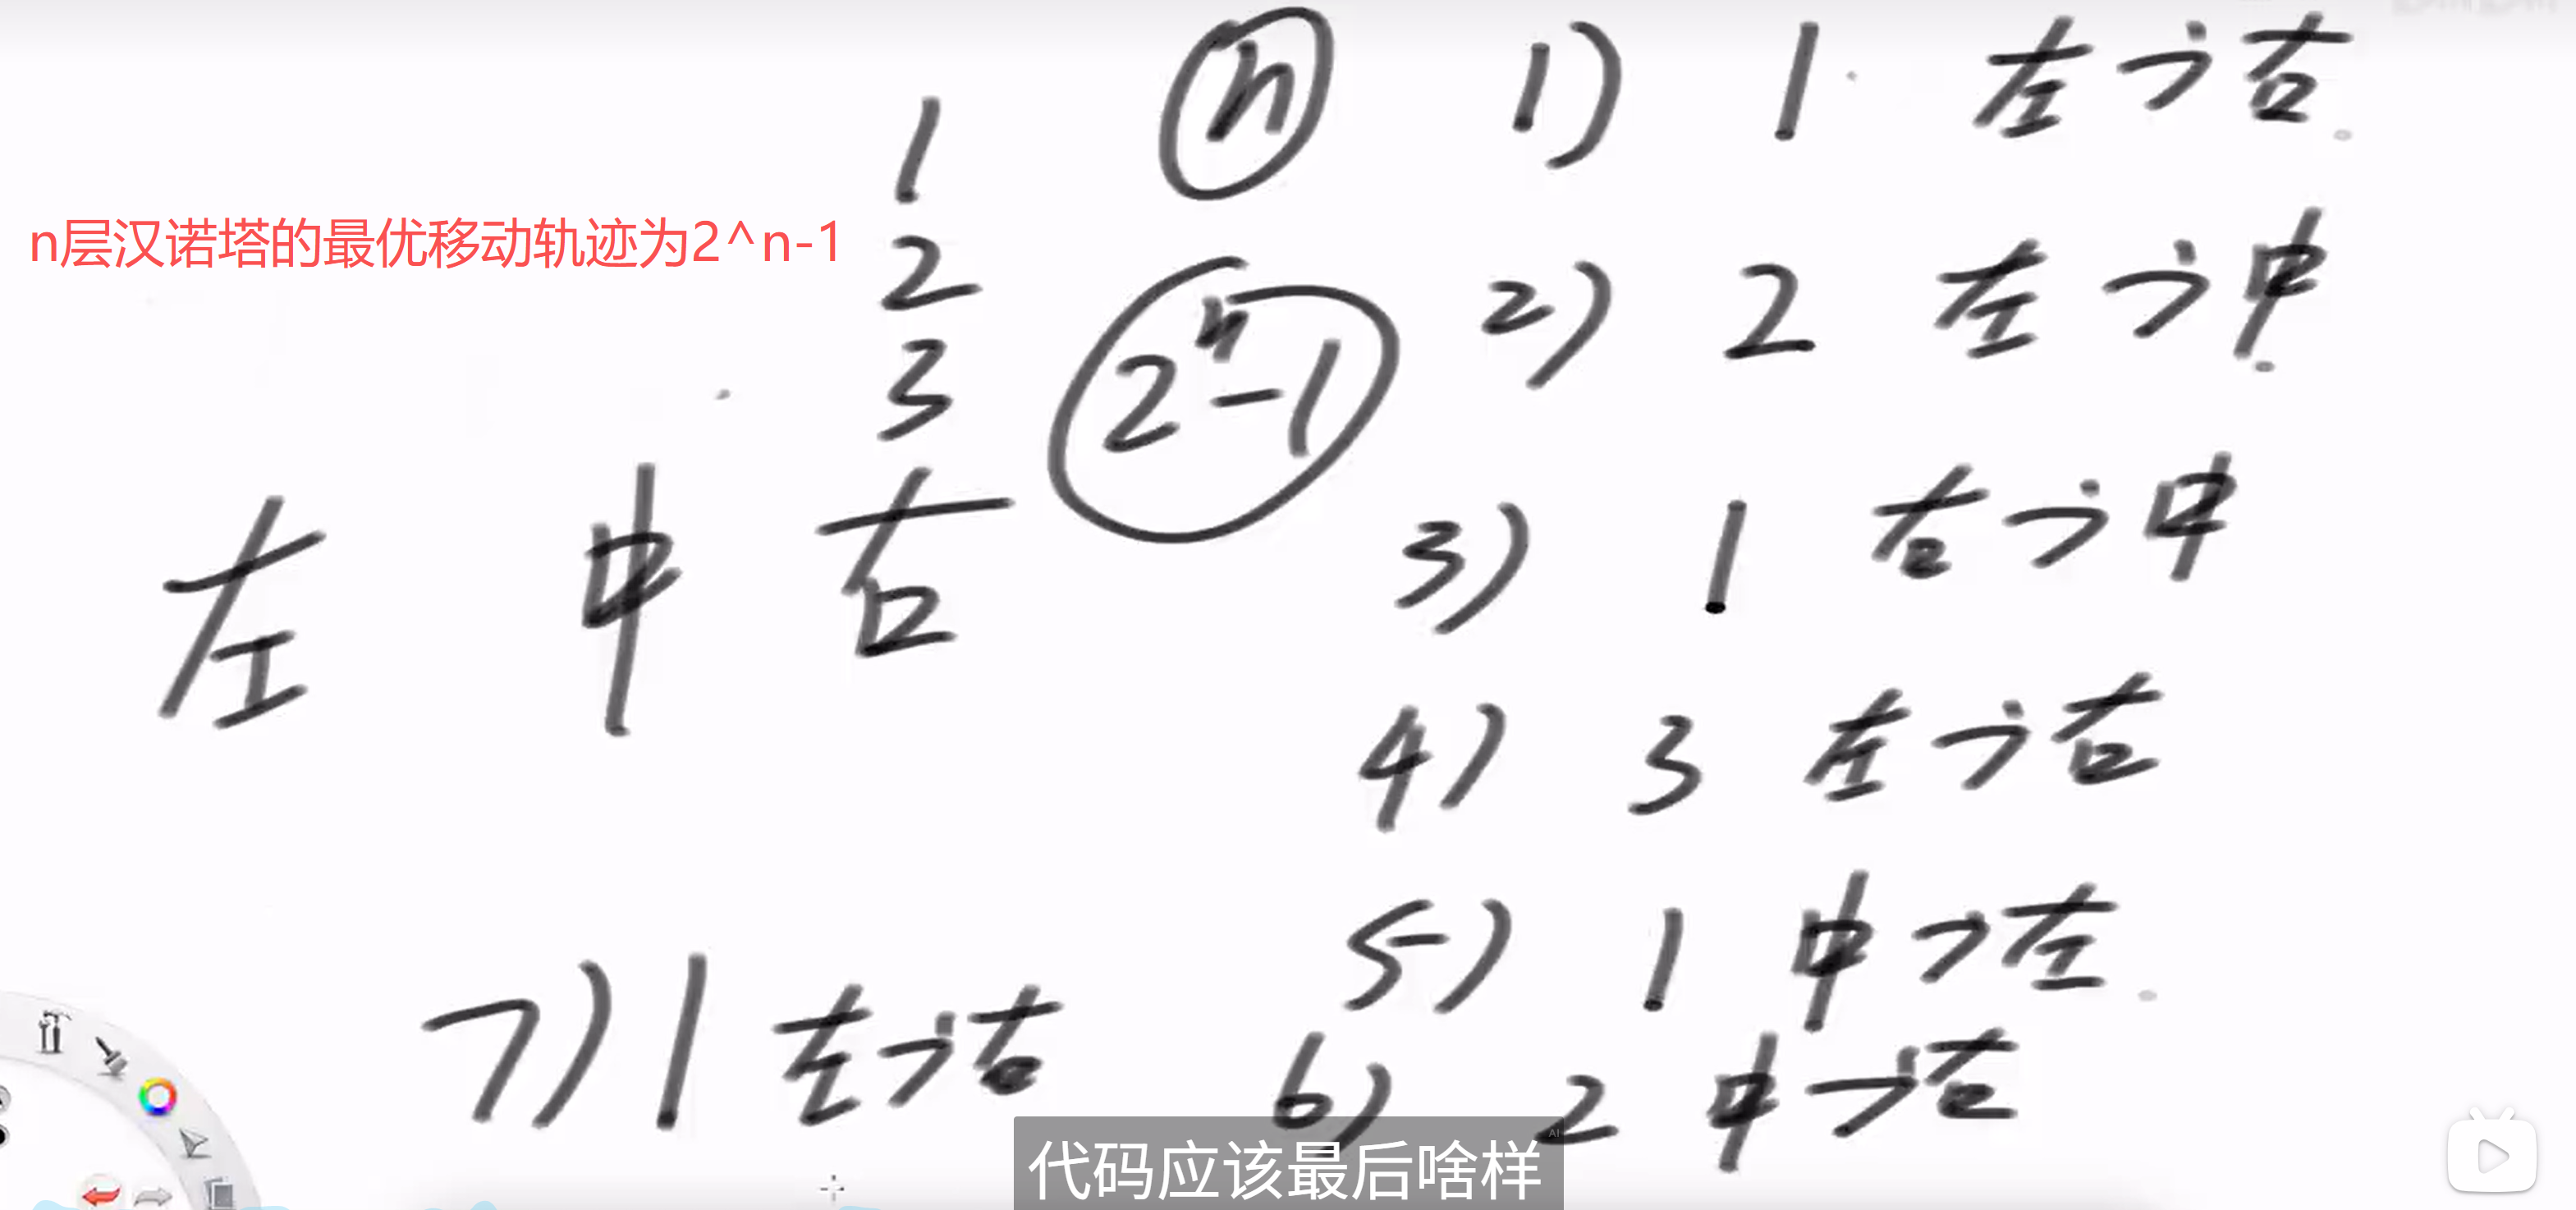
汉诺塔的最优移动轨迹
汉诺塔的抽象流程

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
class TowerOfHanoi:
def hanoi(self, n: int):
"""
汉诺塔问题主函数入口
"""
if n > 0:
self._f(n, "左", "右", "中")

def _f(self, i: int, start: str, end: str, other: str):
"""
递归函数,解决将 i 个圆盘从 start 移动到 end 的问题
"""
# base case:如果只有一个圆盘,直接移动
if i == 1:
print(f"移动圆盘 1 从 {start} 到 {end}")
else:
# 步骤1: 将 i-1 个圆盘从 start 移动到 other
self._f(i - 1, start, other, end)
# 步骤2: 移动第 i 个圆盘从 start 到 end
print(f"移动圆盘 {i} 从 {start} 到 {end}")
# 步骤3: 将 i-1 个圆盘从 other 移动到 end
self._f(i - 1, other, end, start)

执行过程示例(n=3)

1
2
3
4
5
6
7
8
解决 3 层汉诺塔问题的步骤:
移动圆盘 1 从 左 到 右
移动圆盘 2 从 左 到 中
移动圆盘 1 从 右 到 中
移动圆盘 3 从 左 到 右
移动圆盘 1 从 中 到 左
移动圆盘 2 从 中 到 右
移动圆盘 1 从 左 到 右

算法分析

  • 时间复杂度:O(2^n)
  • 空间复杂度:O(n) (递归栈空间)
  • 核心技巧:递归分治

递归技巧总结

1. 递归模板

1
2
3
4
5
6
7
8
9
10
11
12
def recursive_function(parameters):
# base case: 递归终止条件
if base_condition:
return base_result

# 递归调用:分解问题
result = recursive_function(modified_parameters)

# 处理当前层的逻辑
current_result = process(result)

return current_result

2. 回溯模板

1
2
3
4
5
6
7
8
9
10
11
12
def backtrack(path, choices):
# base case
if satisfied:
result.append(path[:]) # 收集结果
return

for choice in choices:
# 做选择
path.append(choice)
backtrack(path, remaining_choices)
# 撤销选择
path.pop()

3. 常见递归模式

选择模式

1
2
3
4
5
6
7
8
9
10
11
12
13
# 对每个元素有选择:要 or 不要
def choose(i, path):
if i == len(arr):
process(path)
return

# 要当前元素
path.append(arr[i])
choose(i + 1, path)
path.pop()

# 不要当前元素
choose(i + 1, path)

交换模式

1
2
3
4
5
6
7
8
9
10
# 全排列问题
def permute(arr, i):
if i == len(arr):
process(arr)
return

for j in range(i, len(arr)):
swap(arr, i, j)
permute(arr, i + 1)
swap(arr, i, j) # 回溯

复杂度分析总结

题目 时间复杂度 空间复杂度 核心技巧
字符串子序列 O(2^n × n) O(2^n × n) 选择模式 + set去重
数组组合 O(2^n × n) O(2^n × n) 排序 + 剪枝去重
无重复全排列 O(n! × n) O(n!) 交换模式 + 回溯
有重复全排列 O(n! × n) O(n!) 交换模式 + 集合去重
递归逆序栈 O(n²) O(n) 双递归函数
递归排序栈 O(n²) O(n) 多递归函数
汉诺塔 O(2^n) O(n) 递归分治

学习建议

  1. 理解递归本质:递归就是函数调用自己,关键在于找到递归关系和base case

  2. 掌握常见模式:

    • 选择模式(子集、组合问题)
    • 交换模式(排列问题)
    • 分治模式(汉诺塔、归并排序等)
  3. 注意回溯时机:

    • 何时需要回溯(恢复现场)
    • 何时不需要回溯(使用额外空间)
  4. 优化技巧:

    • 剪枝去重 vs set去重
    • 空间复用(固定长度数组 + size指针)
    • 预处理(排序、哈希表等)
  5. 递归栈深度:注意递归深度,避免栈溢出

  6. 实践建议:

    • 多画递归树理解执行过程
    • 从简单案例开始推导
    • 注意边界条件的处理

递归是解决很多复杂问题的有力工具,掌握好递归的思想和常见模式,可以大大提升解决问题的能力。

引言

参照的是左程云的课程:https://space.bilibili.com/8888480/lists/3509640?type=series

本笔记是class036→037的内容,总结了二叉树相关的9+7=16道高频算法题目。class36涵盖了二叉树的遍历、序列化、构造、验证等核心操作,但不包含树型动态规划的内容。class037算是036的补充,讲了二叉树相关的另外7道高频算法题目,包含了最近公共祖先(LCA)问题、路径搜索、平衡性验证、搜索二叉树相关操作。

前置知识

在学习二叉树高频题目之前,需要掌握以下基础知识:

  • 队列用数组实现(讲解013)
  • 二叉树入门内容(讲解017~018)

重要说明

  • 本期和下期视频会讲解二叉树高频题目,但不含树型dp的题目
  • 树型dp问题会放在【必备】课程的动态规划大章节部分讲述
  • 树型dp中的换根dp问题会放在【扩展】课程的动态规划大章节部分讲述
  • AVL树的实现、树的左旋右旋等内容也会在【扩展】课程里讲述
  • 问题1又叫LCA问题,非常重要!Tarjan算法解决LCA的批量查询、树链剖分算法解决LCA的在线查询会在【扩展】课程讲述
  • 数组的打家劫舍问题变形很多,会在【必备】课程的动态规划大章节部分讲述
  • 再次强调树型dp的整体讲解,会在【必备】课程的动态规划大章节部分讲述

036【必备】二叉树高频题目-上-不含树型dp

初始化的二叉树类

1
2
3
4
5
class TreeNode:
def __init__(self, val=0, left=None, right=None):
self.val = val
self.left = left
self.right = right

题目一:二叉树的层序遍历

问题描述

给你二叉树的根节点 root,返回其节点值的层序遍历。(即逐层地,从左到右访问所有节点)

测试链接:https://leetcode.cn/problems/binary-tree-level-order-traversal/

核心思想

使用广度优先搜索(BFS)进行层序遍历,有两种实现方式:

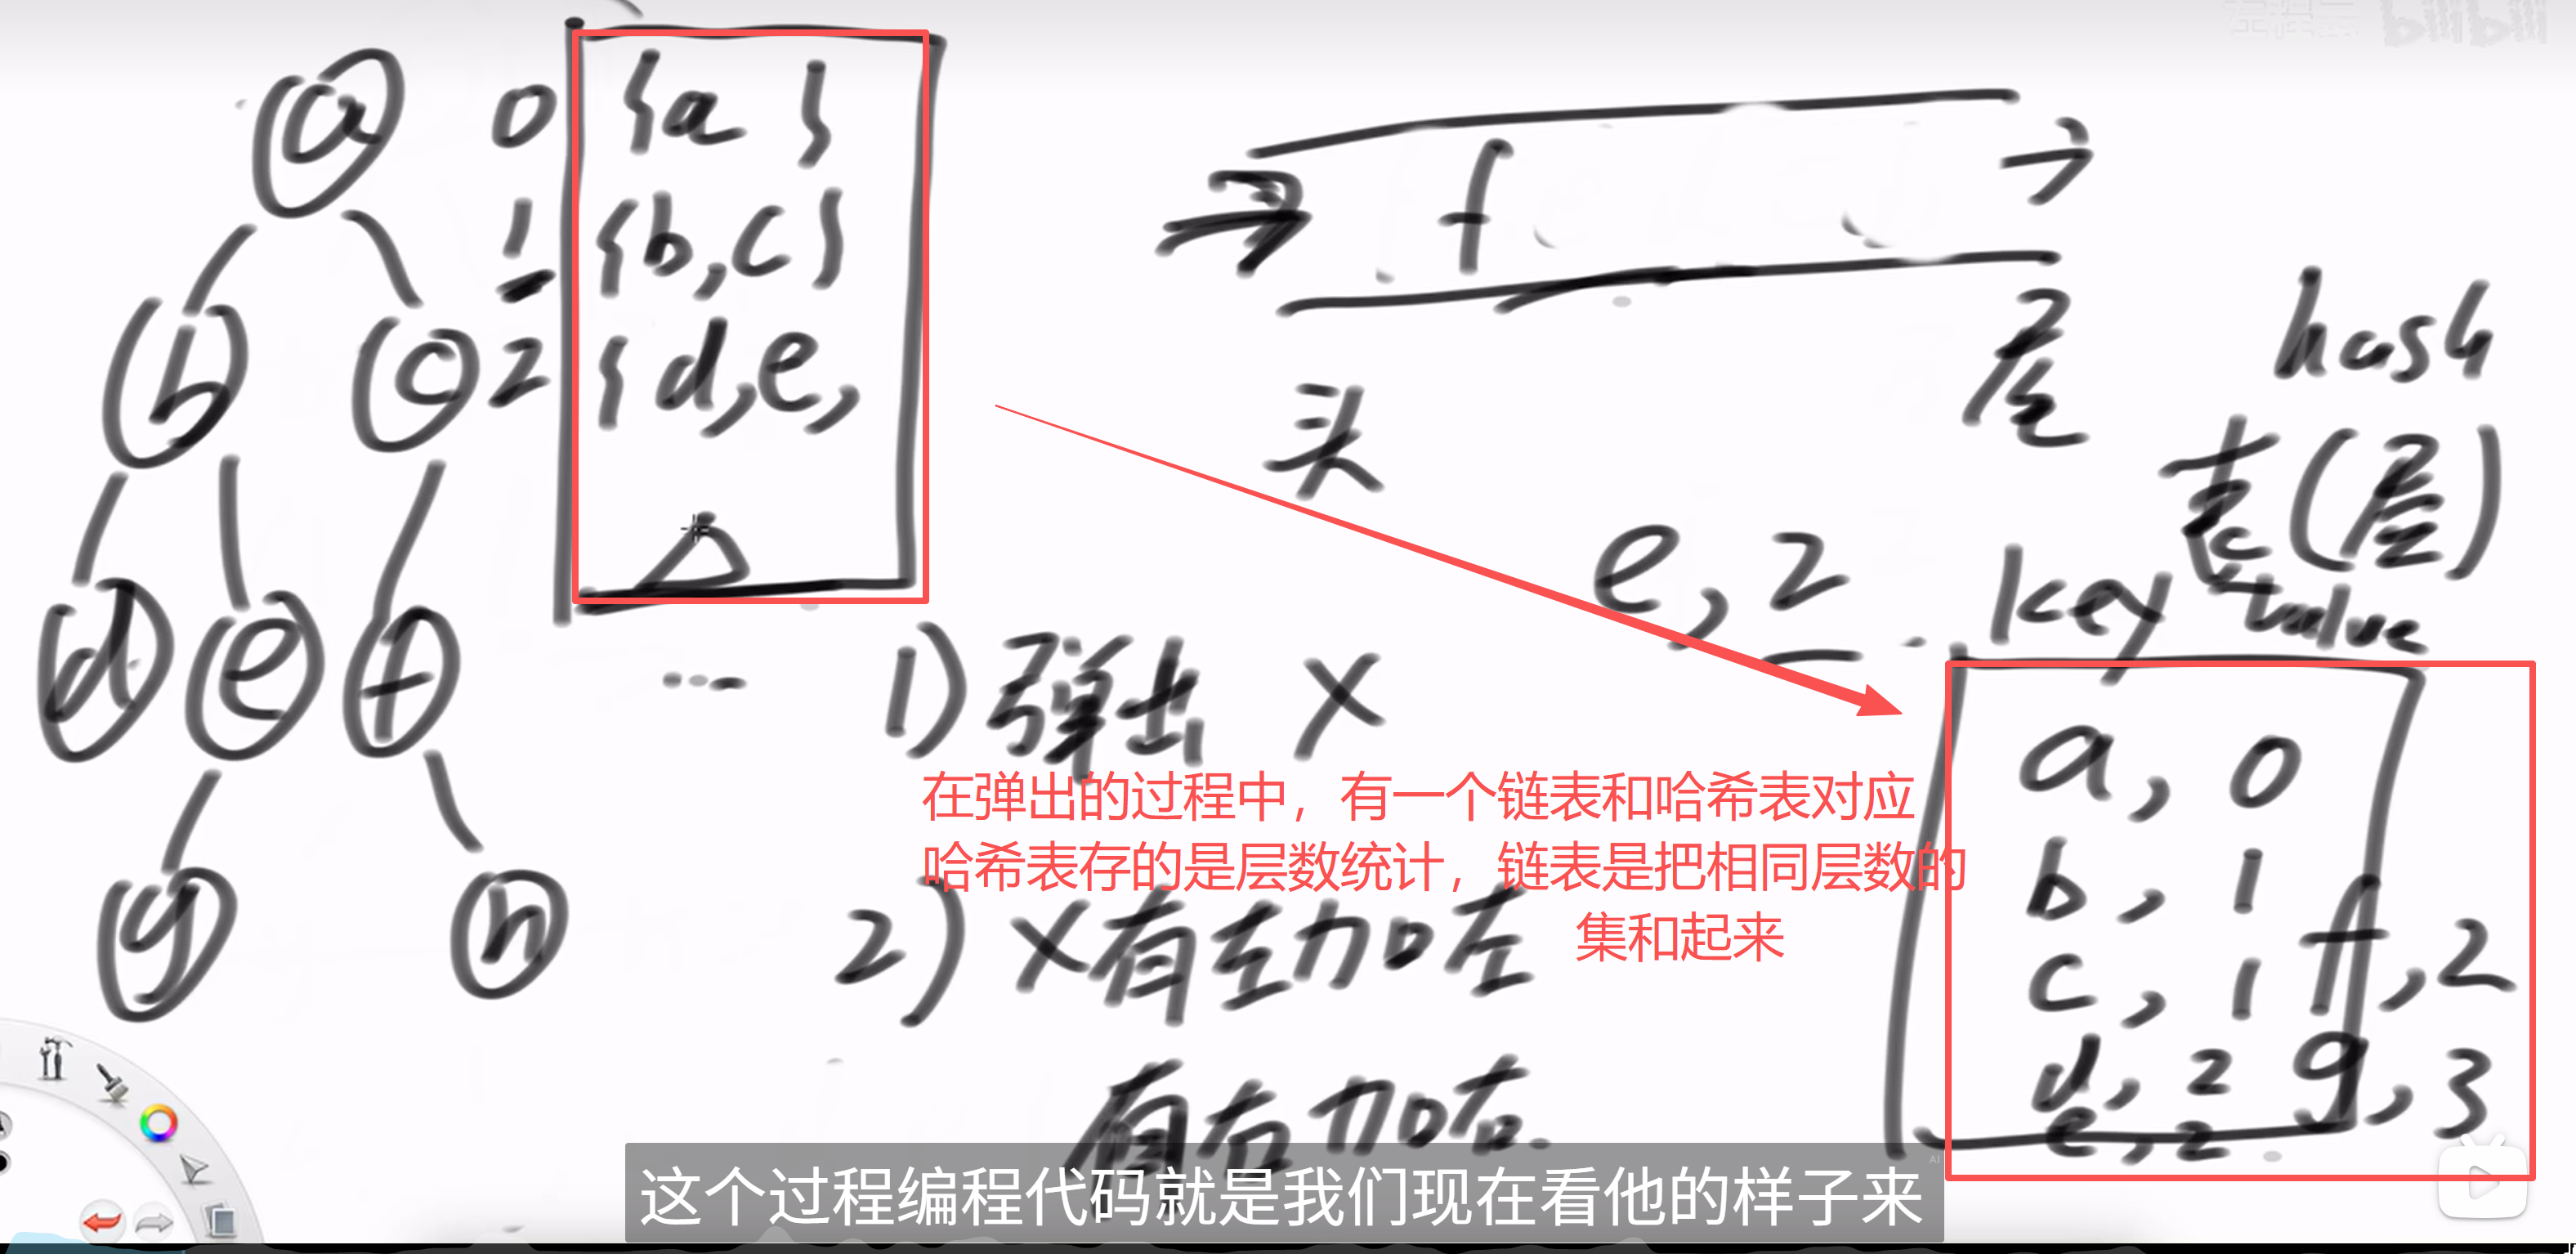
  1. 普通BFS:使用队列存储节点,用哈希表记录每个节点的层级
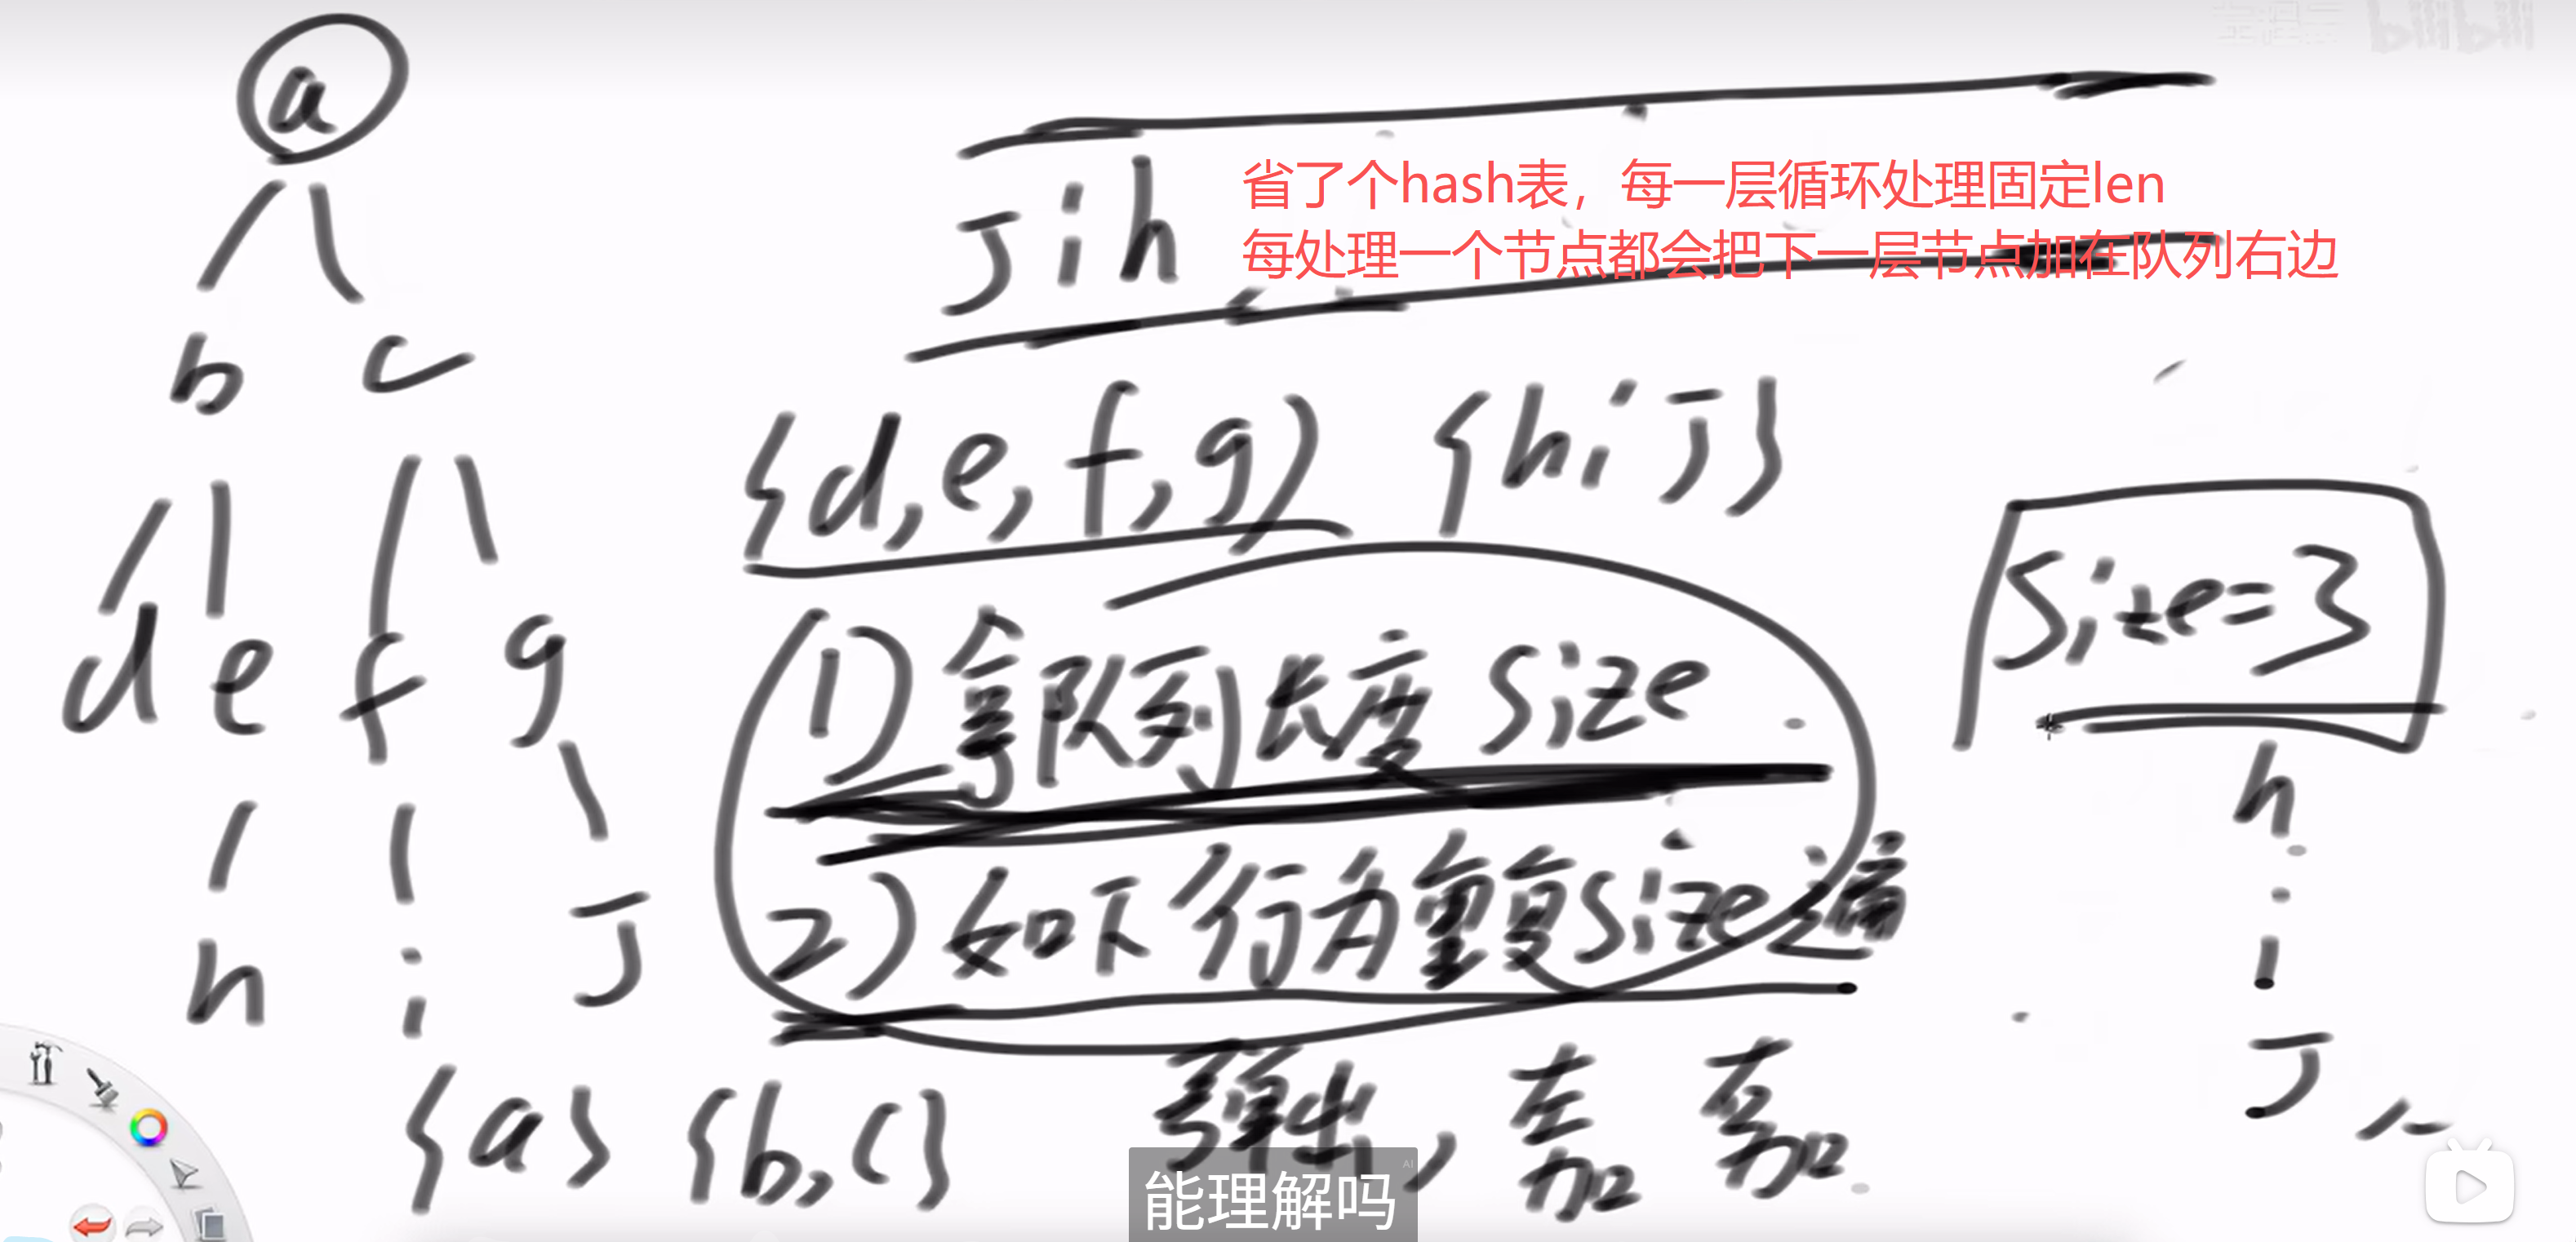
  2. 优化BFS:按层处理,每次处理完整一层的所有节点

层序遍历的实现
层序遍历的实现2

算法实现

方法一:普通BFS

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
from collections import deque
from typing import List, Optional

# 提交时把方法名改为levelOrder,此方法为普通bfs(宽度/广度优先搜索,叫宽度搜索的原因是层的最大节点数为宽度),此题不推荐
def levelOrder1(self, root: Optional[TreeNode]) -> List[List[int]]:
# 核心思想:标准的广度优先搜索(BFS)。
# 使用一个队列存储待访问节点,同时用一个哈希表(字典)来记录每个节点所在的层级。
ans = []
if root:#根节点有东西
# Python的deque是一个高效的双端队列,非常适合用于BFS
queue = deque([root])
# 字典用于存储 node -> level 的映射
levels = {root: 0}
while queue:# 队列不空的时候从队列中取出一个节点
cur = queue.popleft()
level = levels[cur]
# 如果当前层级是第一次遇到,就在ans中创建一个新列表
if len(ans) == level: #ans 列表的长度总是等于当前已经处理过的层级数量,包括第0层,说明当前节点的层级 level 正好等于已经创建的层级数量,味着这个层级还没有被处理过,需要创建新的列表
ans.append([])
# 将当前节点的值加入对应层级的列表
ans[level].append(cur.val)
# 将子节点加入队列,并记录它们的层级
if cur.left:
queue.append(cur.left)
levels[cur.left] = level + 1
if cur.right:
queue.append(cur.right)
levels[cur.right] = level + 1
return ans
# 核心思想:标准的广度优先搜索(BFS),使用一个队列存储待访问节点,
# 同时用一个哈希表(字典)来记录每个节点所在的层级。

方法二:优化BFS(推荐)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
def levelOrder2(self, root: Optional[TreeNode]) -> List[List[int]]:
# 核心思想:优化的广度优先搜索(BFS),按层处理。
# 外层while循环控制层级,内层for循环精确地处理当前层的所有节点。
# 这样就无需额外的哈希表来存储节点的层级信息。
ans = []
if root:
queue = deque([root])
while queue: # 当队列不为空,说明还有节点待处理
size = len(queue) # 当前层的节点数量
level_list = []
for _ in range(size): # 精确处理当前层的所有节点
cur = queue.popleft()
level_list.append(cur.val)
if cur.left: # 将下一层节点入队
queue.append(cur.left)
if cur.right:
queue.append(cur.right) # append是加在右边的
ans.append(level_list)
return ans

执行过程示例

以树结构 1->2,3; 2->4,5; 3->6 为例:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
初始状态:queue = [1], ans = []

处理第0层:
size = 1, level_list = []
取出节点1,level_list = [1]
将节点2,3入队,queue = [2, 3]
ans = [[1]]

处理第1层:
size = 2, level_list = []
取出节点2,level_list = [2],将4,5入队
取出节点3,level_list = [2, 3],将6入队
queue = [4, 5, 6]
ans = [[1], [2, 3]]

处理第2层:
size = 3, level_list = []
依次取出4,5,6,level_list = [4, 5, 6]
ans = [[1], [2, 3], [4, 5, 6]]

算法分析

  • 时间复杂度:O(N),N为节点数
  • 空间复杂度:O(N)
  • 核心技巧:按层BFS遍历

题目二:二叉树的锯齿形层序遍历

问题描述

给定一个二叉树,返回其节点值的锯齿形层序遍历。(即先从左往右,再从右往左进行下一层遍历,以此类推,层与层之间交替进行)

测试链接:https://leetcode.cn/problems/binary-tree-zigzag-level-order-traversal/

核心思想

在按层BFS的基础上,增加一个布尔标记 reverse。每一层遍历结束后,根据 reverse 的值决定是否要将当前层收集到的节点值列表进行反转。

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
# 提交以下的方法
# 用每次处理一层的优化bfs就非常容易实现
def zigzagLevelOrder(self, root: Optional[TreeNode]) -> List[List[int]]:
# 核心思想:在按层BFS的基础上,增加一个布尔标记 `reverse`。
# 每一层遍历结束后,根据 `reverse` 的值决定是否要将当前层收集到的节点值列表进行反转。
# 然后切换 `reverse` 的状态,供下一层使用。
ans = []
if root:
queue = deque([root])
# false 代表从左往右
# true 代表从右往左
reverse = False
while queue:
size = len(queue)
level_list = []

# 步骤1: 像常规的按层BFS一样,先收集当前层的所有节点值
for _ in range(size):
cur = queue.popleft()
level_list.append(cur.val)
if cur.left:
queue.append(cur.left)
if cur.right:
queue.append(cur.right)

# 步骤2: 根据reverse标记决定是否反转当前层的列表
if reverse:
level_list.reverse()

# 步骤3: 将处理好的层列表加入结果,并切换reverse标记
ans.append(level_list)
reverse = not reverse
return ans

算法分析

  • 时间复杂度:O(N)
  • 空间复杂度:O(N)
  • 核心技巧:层序遍历 + 交替反转

题目三:二叉树的最大特殊宽度

问题描述

给定一个二叉树,编写一个函数来获取这个树的最大宽度。树的宽度是所有层中的最大宽度。这个二叉树的宽度与满二叉树相同,但不一定是满的。

测试链接:https://leetcode.cn/problems/maximum-width-of-binary-tree/

核心思想

给每个节点进行编号,就像在一个完全二叉树中一样。根节点编号为1,其左子节点为 2i,右子节点为 2i + 1。每一层的宽度就等于该层最右边节点的编号减去最左边节点的编号,再加1。

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
def widthOfBinaryTree(self, root: Optional[TreeNode]) -> int:
# 核心思想:给每个节点进行编号,就像在一个完全二叉树中一样。
# 根节点编号为1,其左子节点为 2*i,右子节点为 2*i + 1。
# 每一层的宽度就等于该层最右边节点的编号减去最左边节点的编号,再加1。
# 我们使用按层BFS来遍历,同时在队列中存储 (节点, 编号) 对。
if not root:
return 0

ans = 1
# 队列中存储 (节点, 节点编号) 的元组
queue = deque([(root, 1)])

while queue:
size = len(queue)
# 记录当前层的起始编号
start_id = queue[0][1]

# 遍历当前层的所有节点
for i in range(size):
node, node_id = queue.popleft()

# 在遍历到当前层最后一个节点时,计算宽度,这个是额外的步骤
if i == size - 1:
ans = max(ans, node_id - start_id + 1)

# 将子节点及其新编号加入队列
if node.left:
queue.append((node.left, node_id * 2))
if node.right:
queue.append((node.right, node_id * 2 + 1))
return ans

算法分析

  • 时间复杂度:O(N)
  • 空间复杂度:O(N)
  • 核心技巧:完全二叉树编号规则

题目四:求二叉树的最大深度、最小深度

问题描述

  1. 求二叉树的最大深度
  2. 求二叉树的最小深度

测试链接:

核心思想

最大深度

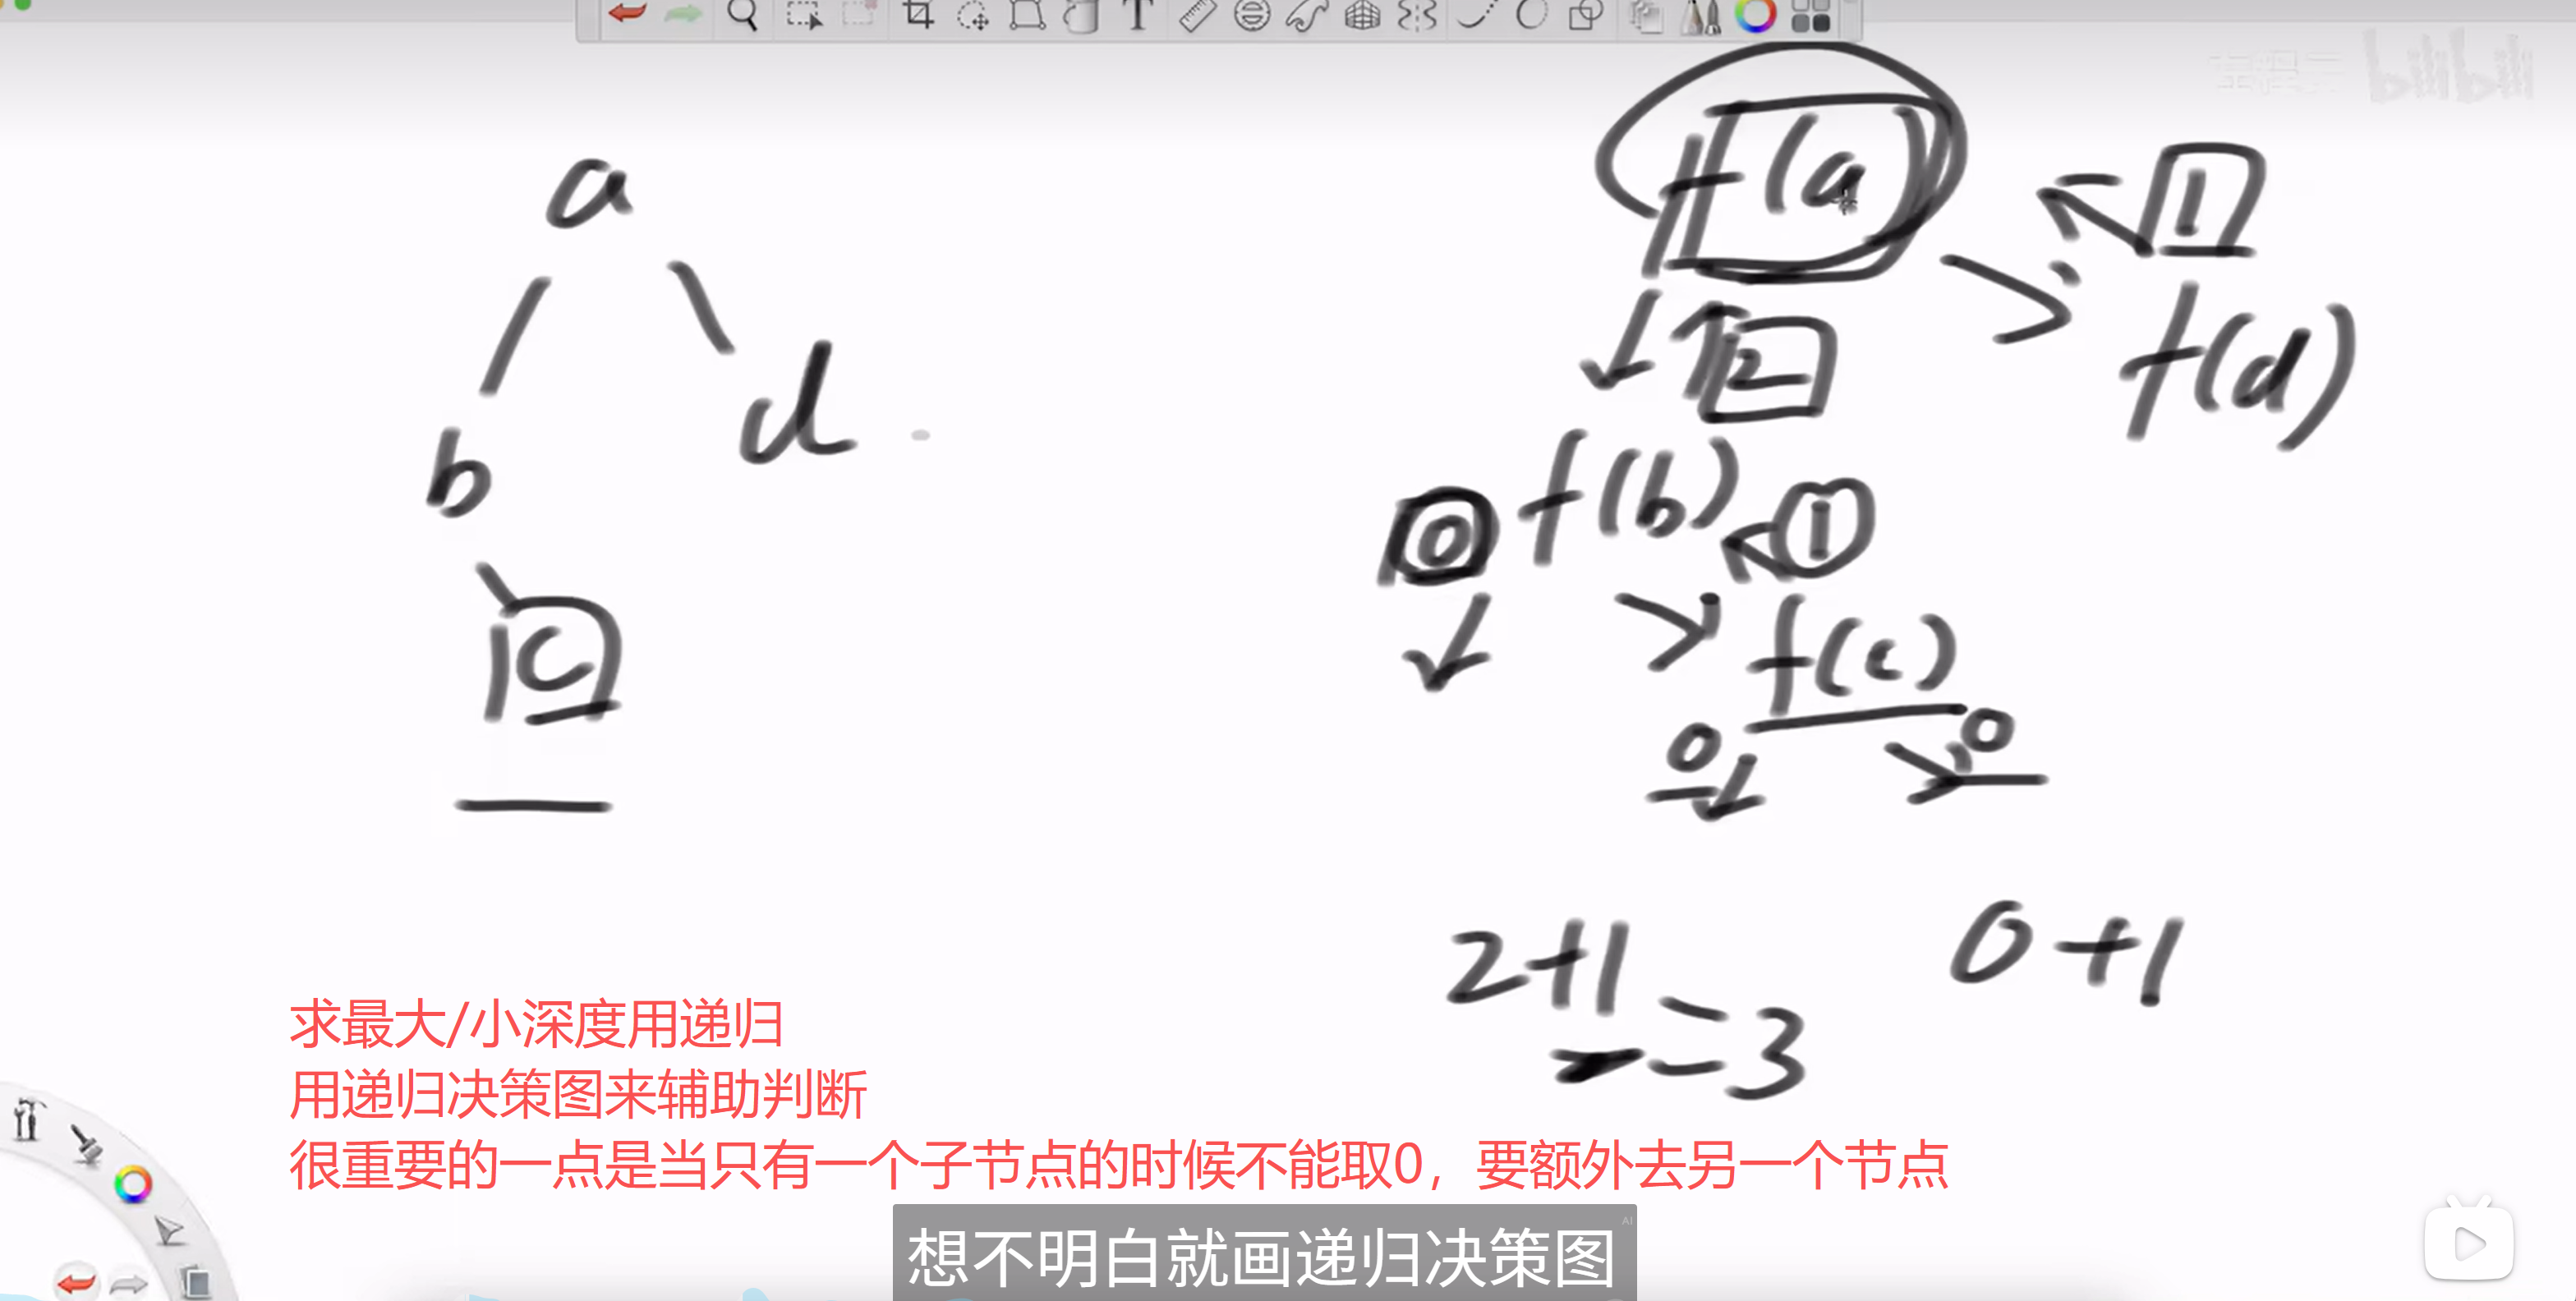
核心思想:递归。一棵树的最大深度等于其左、右子树最大深度中的较大者,再加1(根节点本身)。空树的深度为0,这是递归的基准情况,一定要到叶节点底部。

最小深度

递归,但需要特殊处理。最小深度是从根节点到最近的”叶子节点”的路径长度。如果一个节点只有一个子树,那么我们必须沿着这个非空的子树继续寻找叶子节点。

求子树最大or小深度

算法实现

最大深度

1
2
3
4
def maxDepth(self, root: Optional[TreeNode]) -> int:
if not root:
return 0
return max(self.maxDepth(root.left), self.maxDepth(root.right)) + 1

最小深度

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
def minDepth(self, root: Optional[TreeNode]) -> int:
if not root:
# 当前的树是空树
return 0

left_depth = self.minDepth(root.left)
right_depth = self.minDepth(root.right)

# case 1: 如果左子树或右子树为空,我们不能取它为最小值(因为那条路没有叶子)。
# 此时必须走另一条非空的路。`left_depth + right_depth + 1` 巧妙地处理了
# (左=0, 右=N) -> N+1 和 (左=N, 右=0) -> N+1 的情况。
if left_depth == 0 or right_depth == 0:
return left_depth + right_depth + 1

# case 2: 如果左右子树都不为空,那么最小深度就是两者中的较小值加1。
return min(left_depth, right_depth) + 1

算法分析

  • 时间复杂度:O(N)
  • 空间复杂度:O(H),H为树的高度
  • 核心技巧:递归分治

题目五:二叉树先序序列化和反序列化

问题描述

设计一个算法来序列化和反序列化二叉树。将树转换为字符串(序列化),再将字符串转换为树(反序列化)。

测试链接:https://leetcode.cn/problems/serialize-and-deserialize-binary-tree/

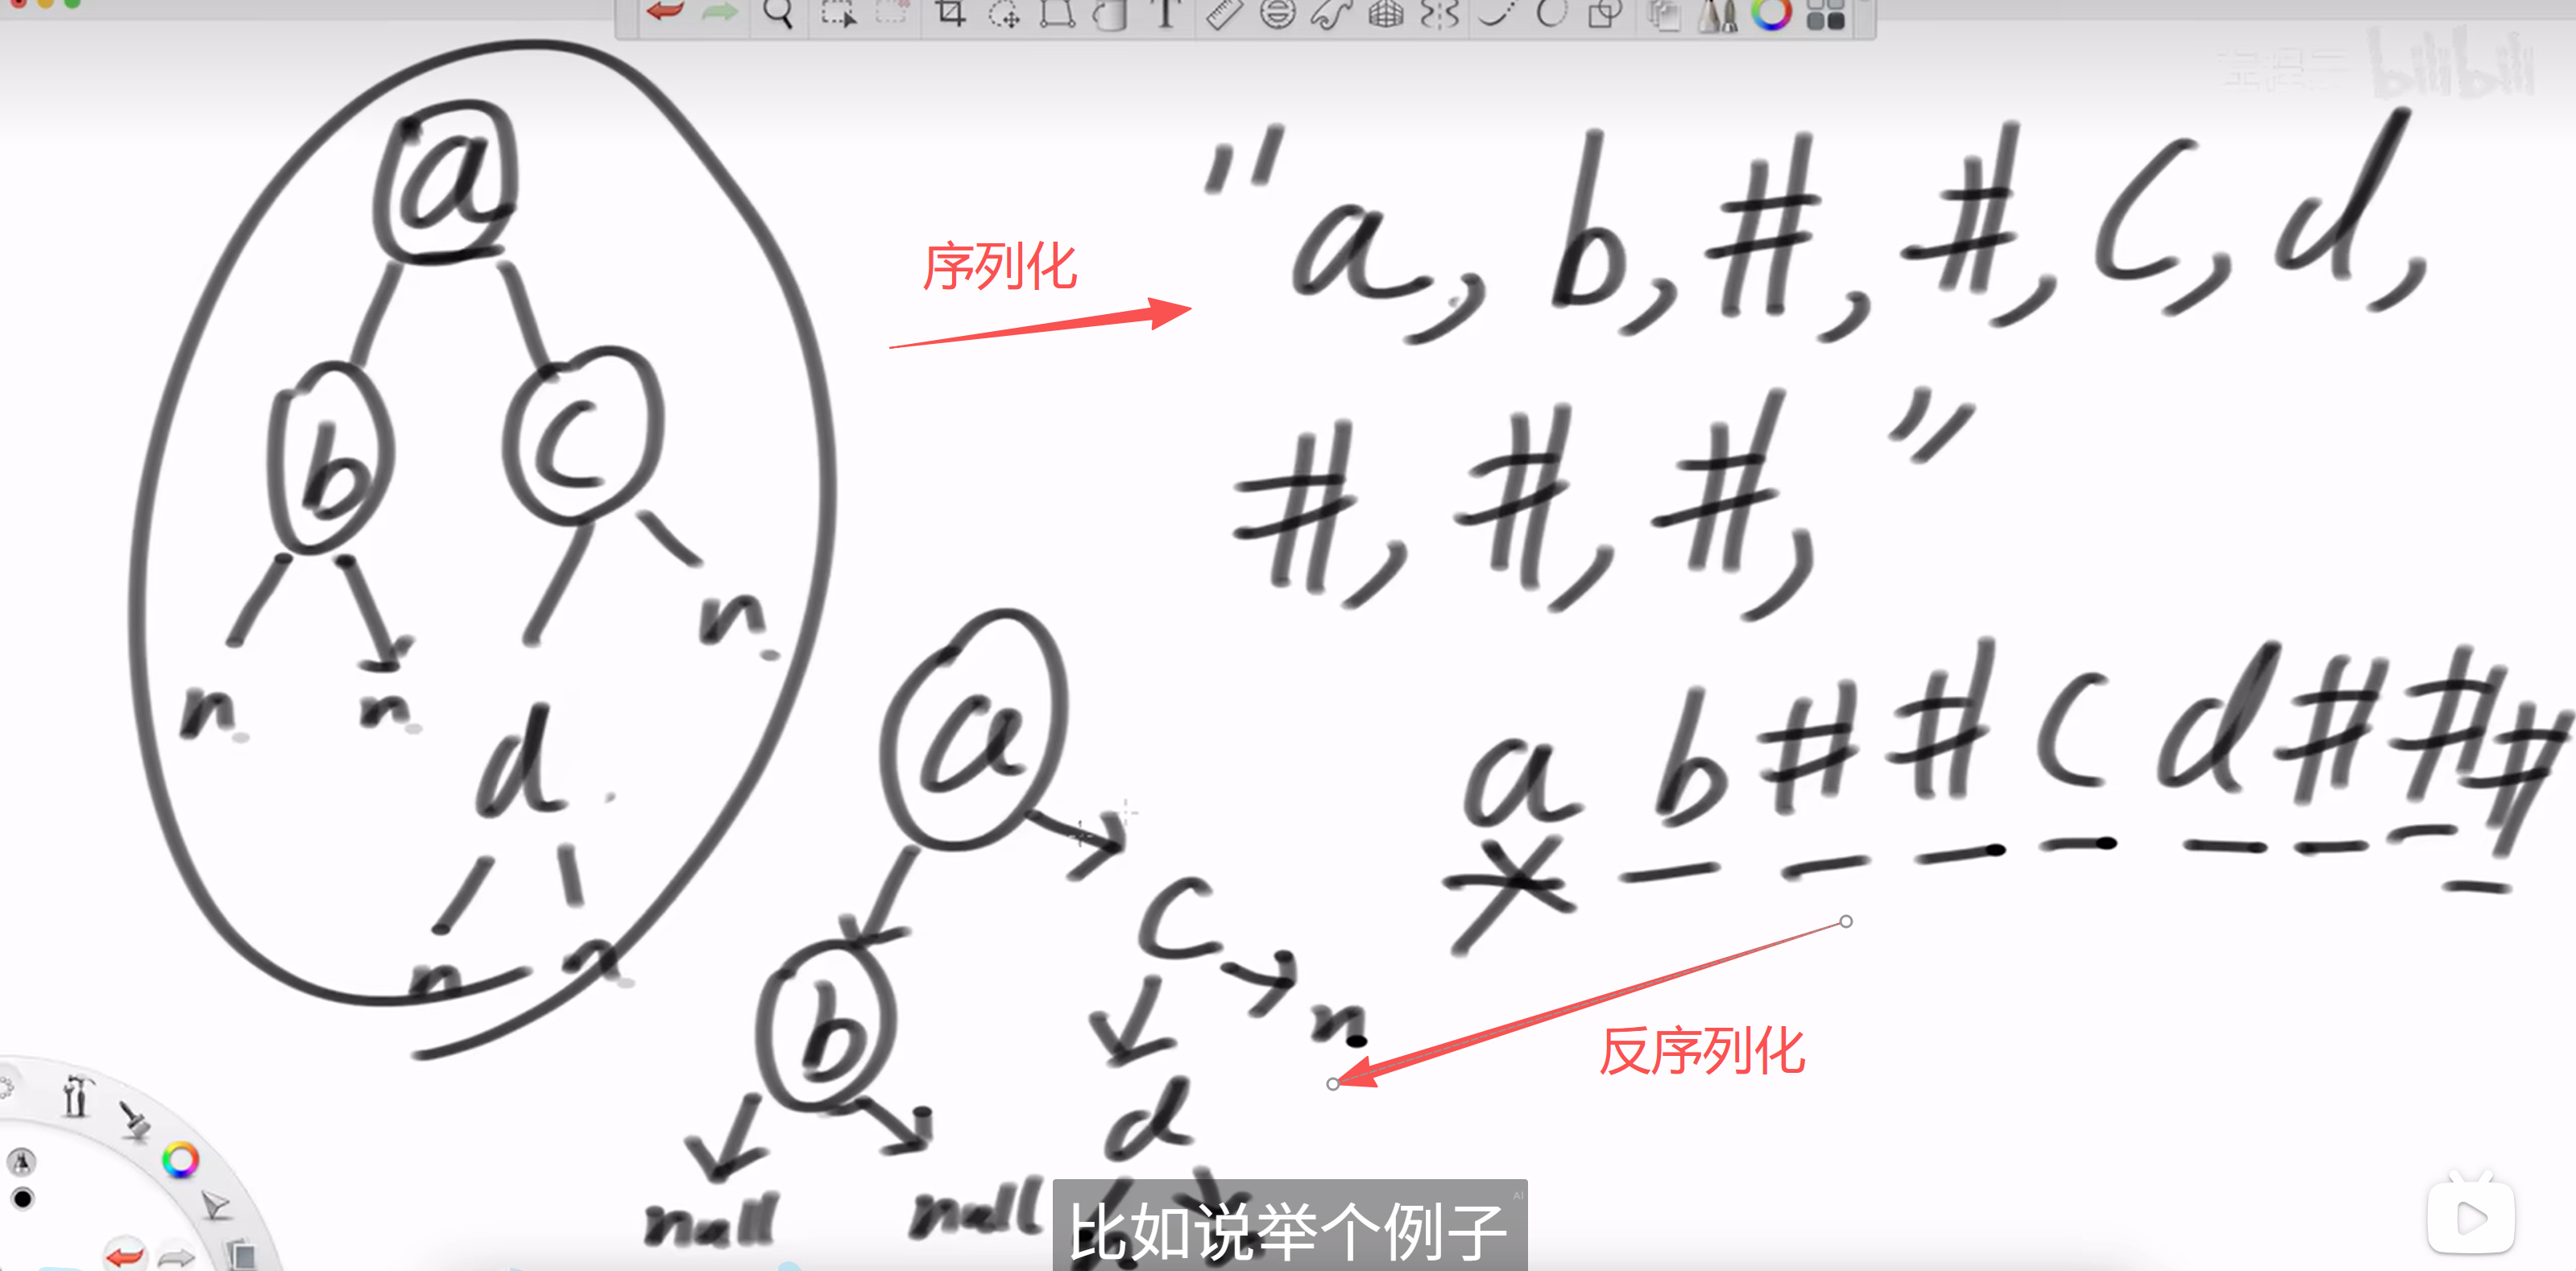
序列化与反序列化
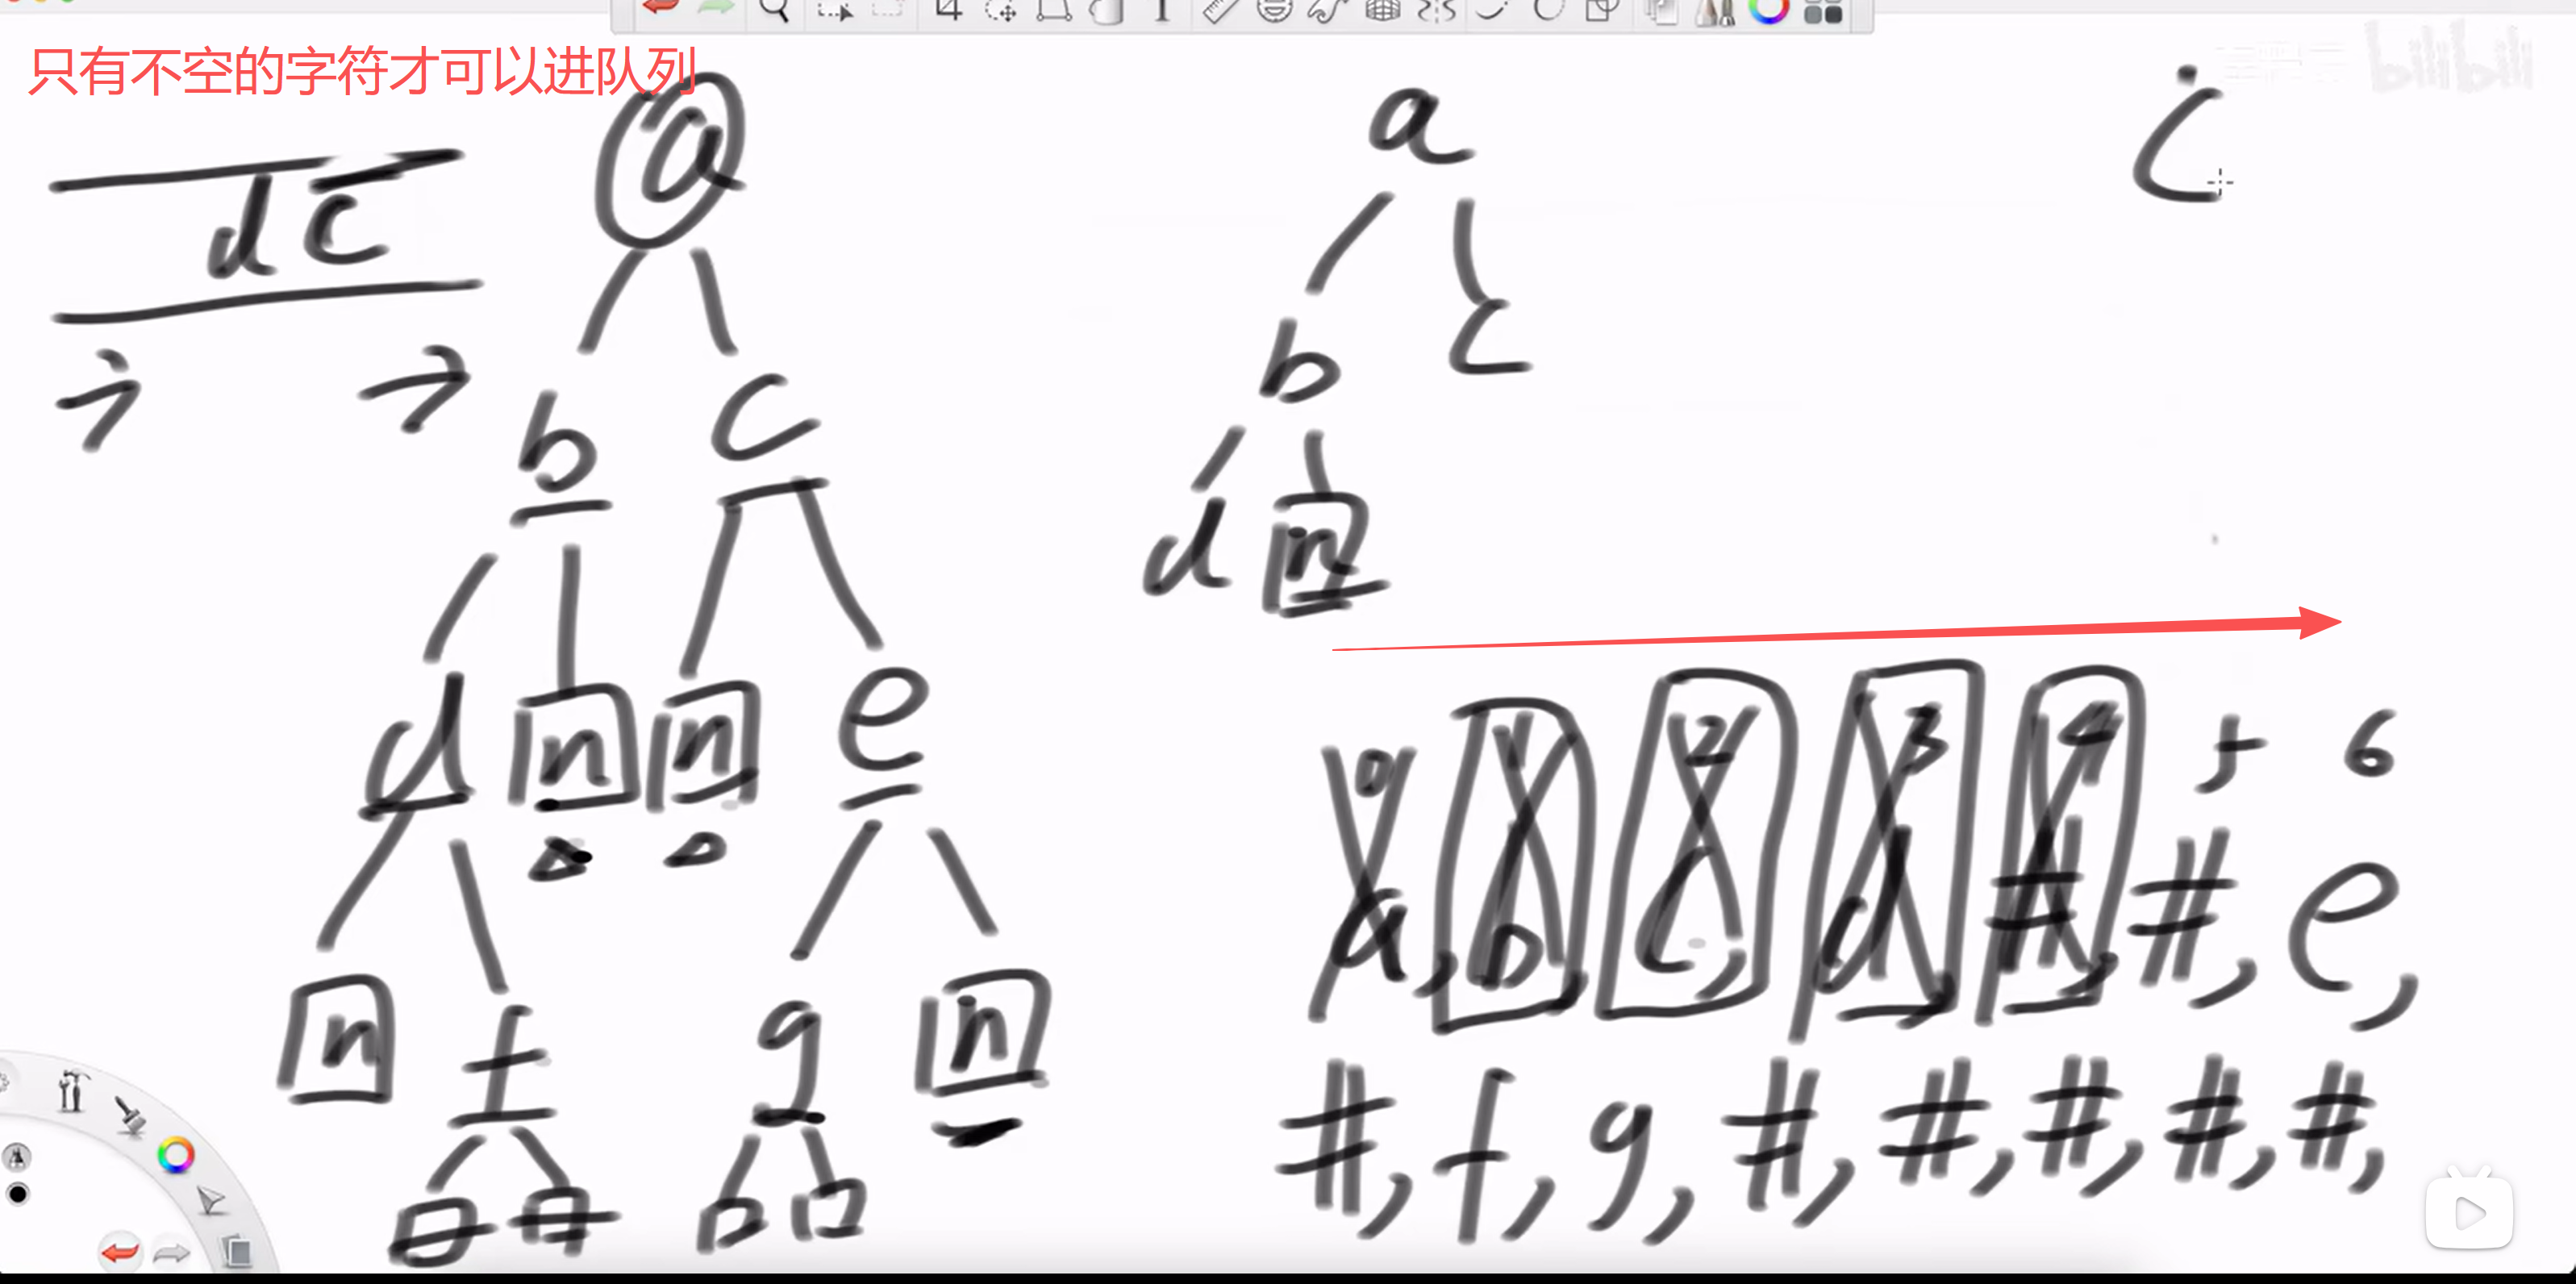
层序遍历反序列化

核心思想

序列化

使用先序遍历(根-左-右)将树递归地转换成字符串。空节点用特殊字符’#’表示,节点之间用’,’分隔。

反序列化

利用先序遍历的顺序,递归地重建树。字符串按’,’分割成列表,然后用一个迭代器顺序消费这些值来构建节点。

重要说明

二叉树可以通过先序、后序或者按层遍历的方式序列化和反序列化,但是无法通过中序遍历的方式实现序列化和反序列化,因为不同的两棵树可能得到同样的中序序列。

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
# 中序遍历的反面例子,比如如下两棵树
# __2
# /
# 1
# 和
# 1__
# \
# 2
# 补足空位置的中序遍历结果都是{ null, 1, null, 2, null}

# 提交这个类
class Codec:
def serialize(self, root):
# 核心思想:使用先序遍历(根-左-右)将树递归地转换成字符串。
# 空节点用特殊字符'#'表示,节点之间用','分隔。 #叫sharp
res = [] #res是结果列表result
self._f(root, res)
return ",".join(res)

def _f(self, root, res): # 递归函数求先序遍历
if not root:
res.append("#")
return
res.append(str(root.val))
self._f(root.left, res)
self._f(root.right, res)

def deserialize(self, data):
# 核心思想:利用先序遍历的顺序,递归地重建树。
# 字符串按','分割成列表,然后用一个迭代器顺序消费这些值来构建节点。
if not data:
return None
vals = iter(data.split(','))
return self._g(vals)

def _g(self, vals): # 递归函数求反序列化
val = next(vals) # 迭代器,next是取下一个值,val是理论上是字符串,next能逐个取值
if val == "#":
return None

# 先构建根节点,然后递归构建左子树,再递归构建右子树
head = Code05_PreorderSerializeAndDeserialize.TreeNode(int(val))
head.left = self._g(vals)
head.right = self._g(vals)
return head

算法分析

  • 时间复杂度:O(N)
  • 空间复杂度:O(N)
  • 核心技巧:先序遍历 + 迭代器

题目六:二叉树按层序列化和反序列化

问题描述

使用层序遍历的方式实现二叉树的序列化和反序列化。

测试链接:https://leetcode.cn/problems/serialize-and-deserialize-binary-tree/

核心思想

序列化

使用广度优先搜索(BFS)进行层序遍历。队列中的每个节点,都将其左右子节点(即使是None)的信息加入结果字符串。

反序列化

同样使用BFS和队列来重建树。先创建根节点并入队,然后依次出队父节点,并从字符串值列表中读出左右子节点的信息进行构建和连接。

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
# 提交这个类,补点思想即:把所有空节点也序列化/反序列化出来,不遗漏任何节点位置。
# 按层序列化
class Codec:
def serialize(self, root):
# 核心思想:使用广度优先搜索(BFS)进行层序遍历。
# 队列中的每个节点,都将其左右子节点(即使是None)的信息加入结果字符串。
if not root:
return "" # 空树直接返回空字符串
res = []
queue = deque([root])
while queue:
cur = queue.popleft()
if cur:
res.append(str(cur.val)) # 记录当前节点值
queue.append(cur.left) # 即使是None也加入队列,补点思想
queue.append(cur.right) # 即使是None也加入队列,补点思想
else:
res.append("#") # 用'#'表示空节点,补点思想
return ",".join(res) # 用逗号连接成字符串

def deserialize(self, data):
# 核心思想:同样使用BFS和队列来重建树。
# 先创建根节点并入队,然后依次出队父节点,并从字符串值列表中读出左右子节点的信息进行构建和连接。
if not data:
return None # 空字符串返回空树
nodes = data.split(',') # 字符串按逗号分割成列表
root = self.generate(nodes[0]) # 构建根节点
queue = deque([root])
index = 1 # 指向下一个要处理的节点值在nodes中的位置
while queue:
parent = queue.popleft() #这个循环是按层从顶到下遍历的,parent是父节点
if index < len(nodes):
# 生成父节点的左孩子,补点思想
parent.left = self.generate(nodes[index])
index += 1
if index < len(nodes):
# 生成父节点的右孩子,补点思想
parent.right = self.generate(nodes[index])
index += 1
# 只将非空子节点入队
if parent.left:
queue.append(parent.left)
if parent.right:
queue.append(parent.right)
return root

def generate(self, val):
if val == "#":
return None # 空点返回None,补点思想
return Code06_LevelorderSerializeAndDeserialize.TreeNode(int(val)) # 普通点返回节点对象

算法分析

  • 时间复杂度:O(N)
  • 空间复杂度:O(N)
  • 核心技巧:层序遍历 + 补点思想

题目七:利用先序与中序遍历序列构造二叉树

问题描述

根据一棵树的前序遍历与中序遍历构造二叉树。要求没有重复元素。

测试链接:https://leetcode.cn/problems/construct-binary-tree-from-preorder-and-inorder-traversal/

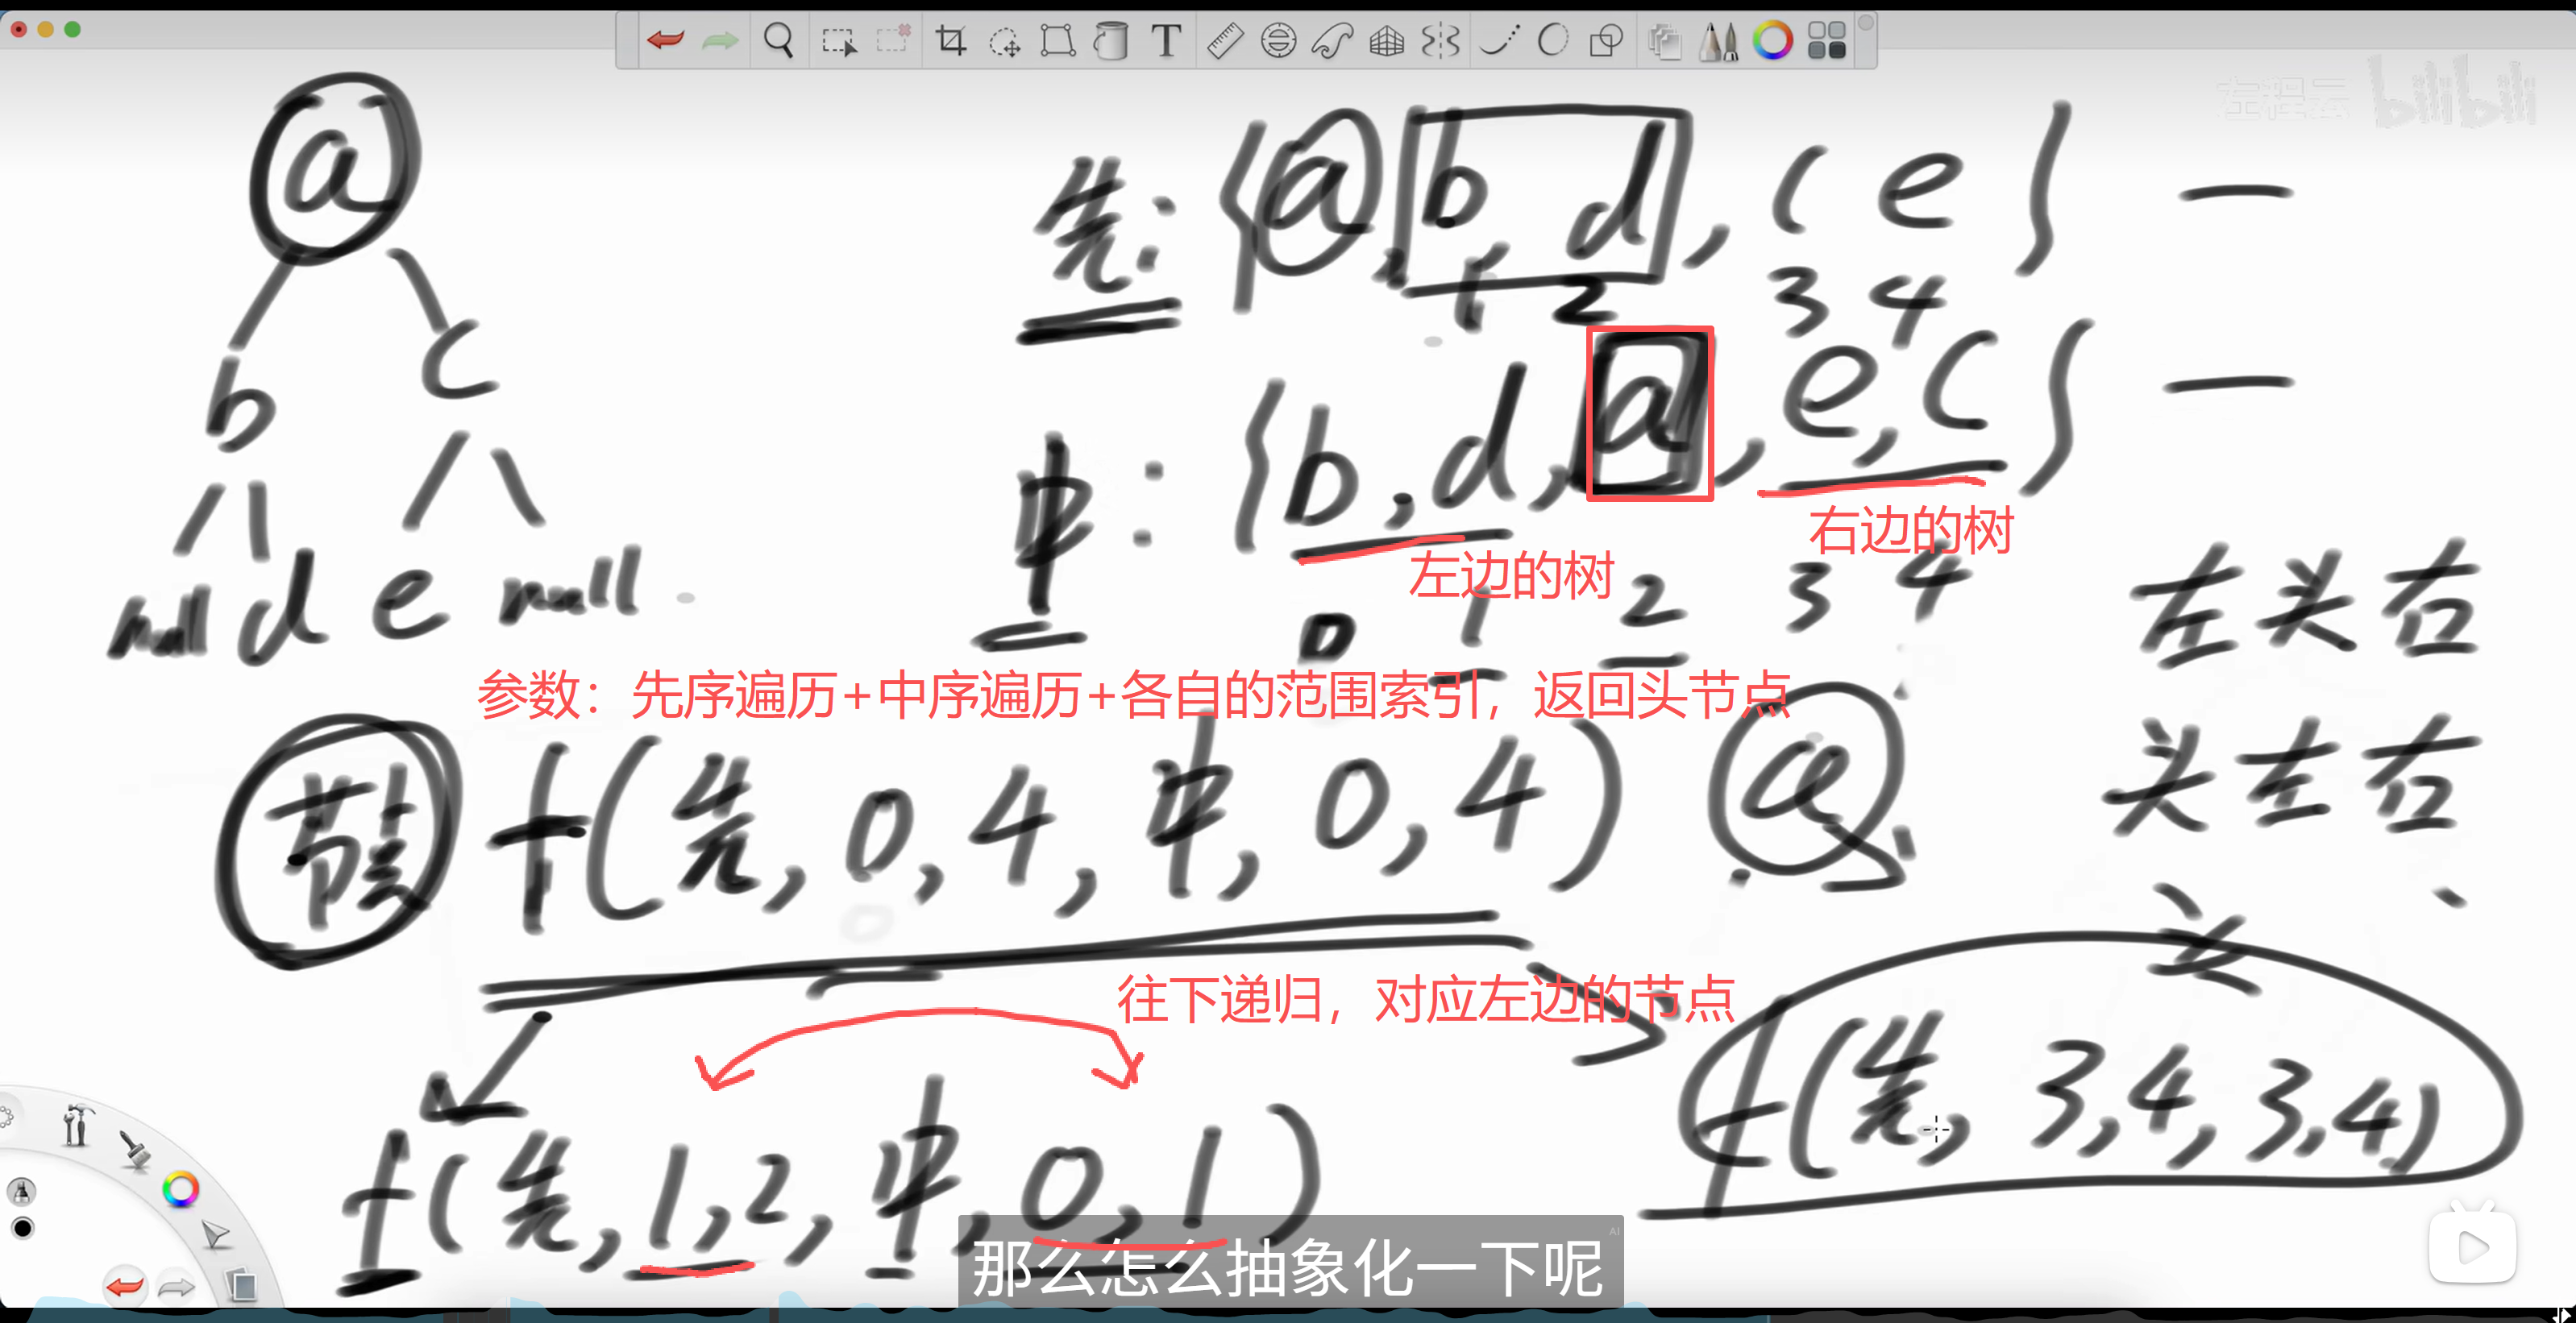
先序+中序重构树
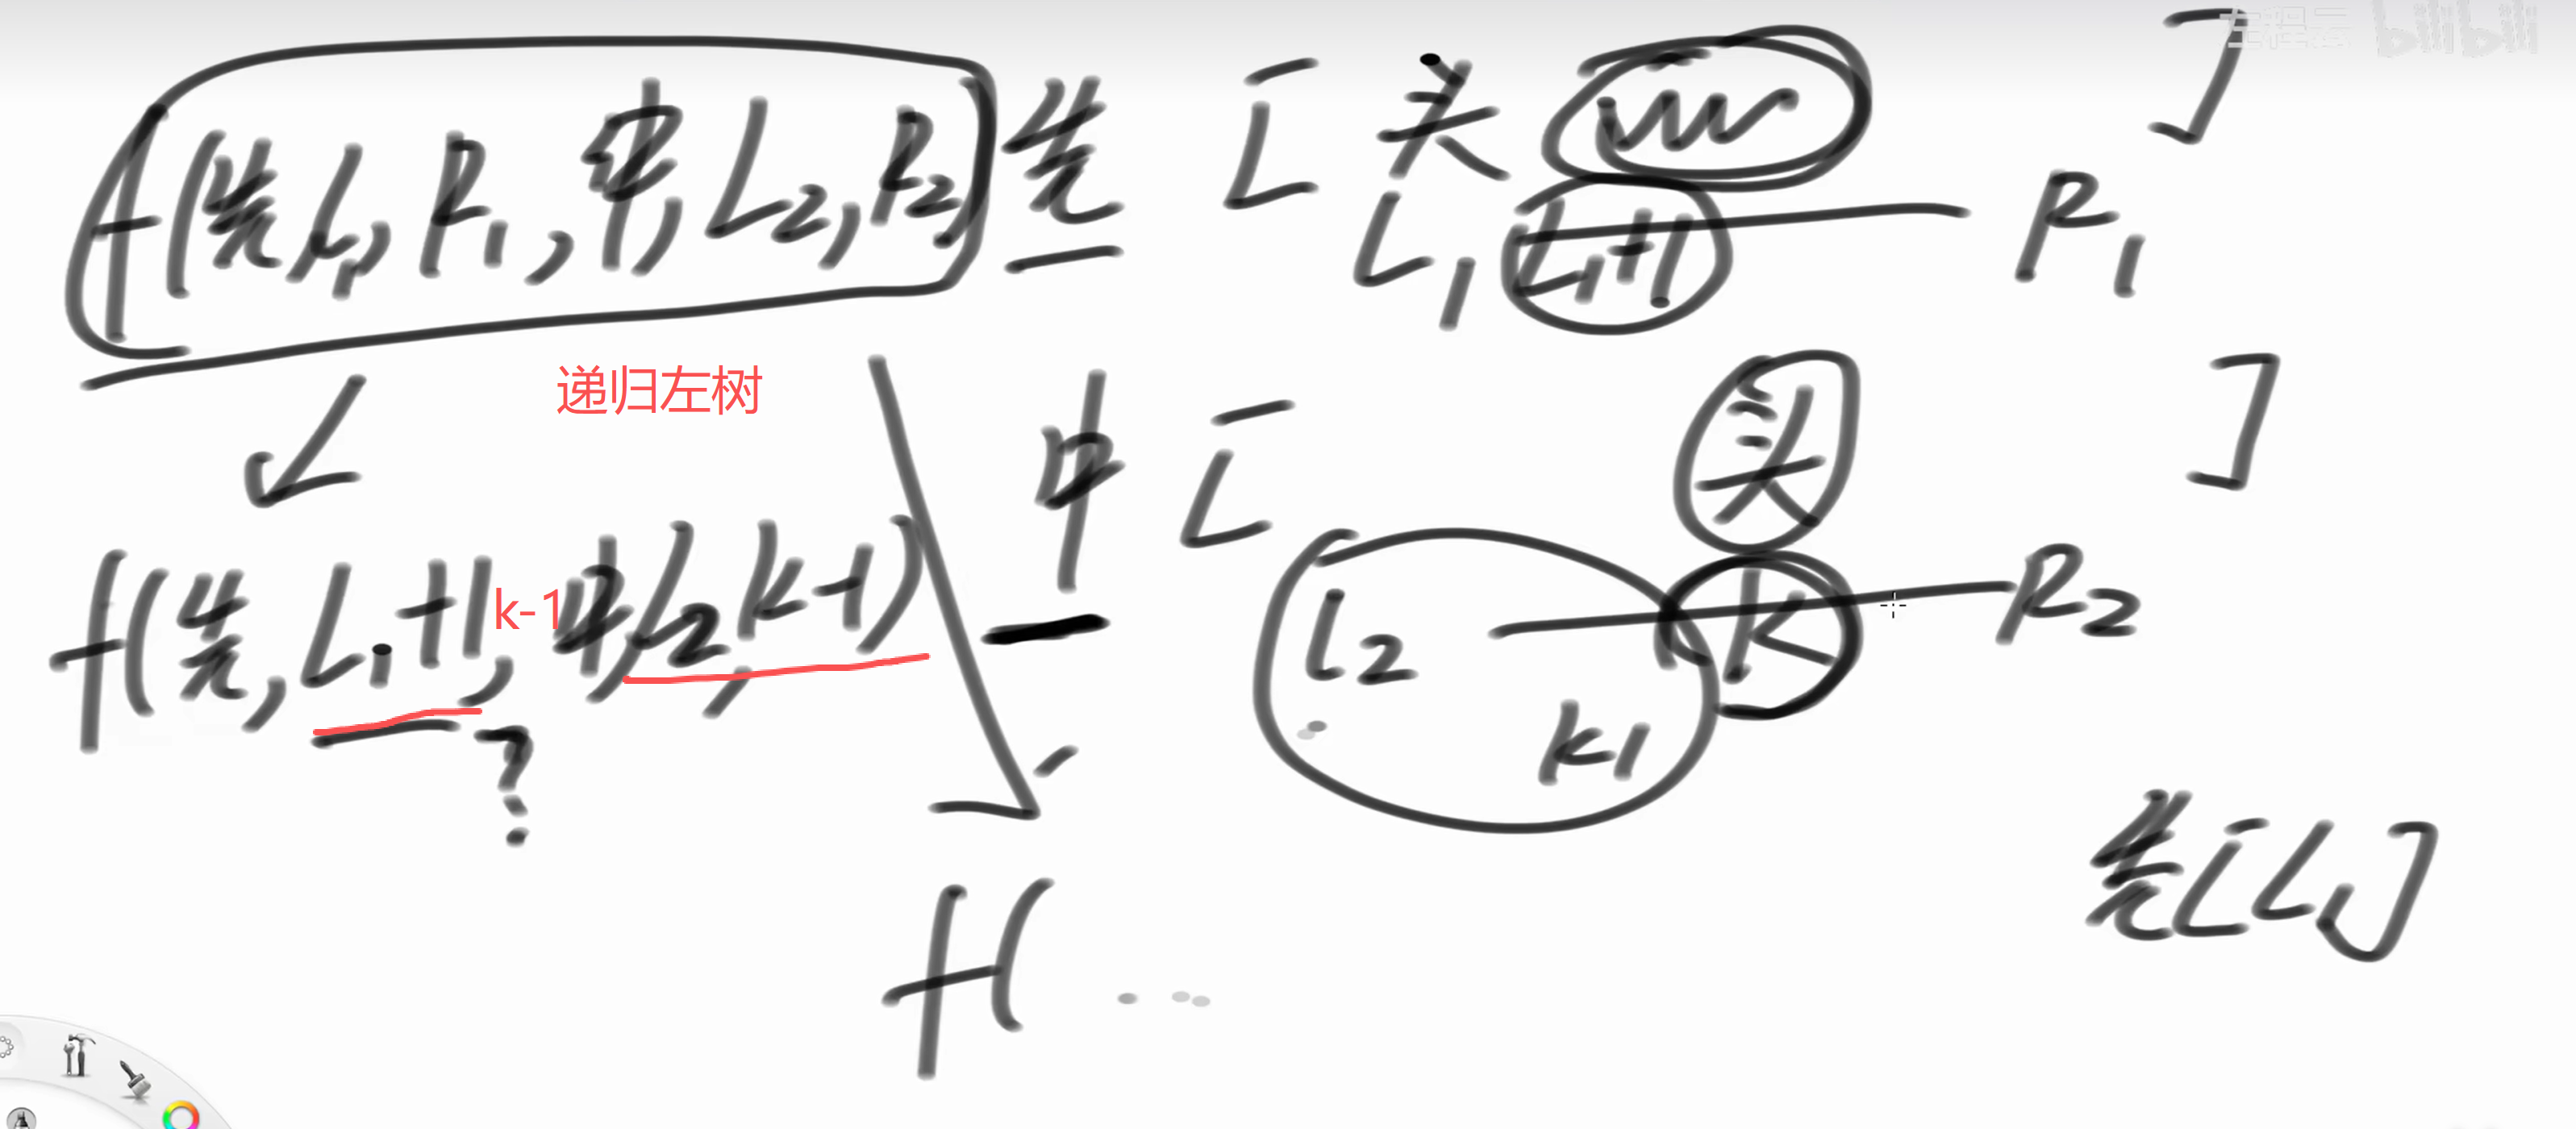
先序+中序重构树2

核心思想

递归分治。先序遍历的第一个元素是当前子树的根。在中序遍历中找到这个根,其左边的所有元素构成左子树,右边的所有元素构成右子树。根据左子树的元素数量,可以确定先序遍历中左右子树的范围,从而递归构建。

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
# 提交如下的方法
def buildTree(self, pre: List[int], tin: List[int]) -> Optional[TreeNode]:
if not pre or not tin or len(pre) != len(tin):
return None
# 为了快速查找根节点在中序遍历中的位置,预处理成哈希表
in_map = {val: i for i, val in enumerate(tin)}
return self._f(pre, 0, len(pre) - 1, tin, 0, len(tin) - 1, in_map) #初始化方法

def _f(self, pre, l1, r1, tin, l2, r2, in_map):
if l1 > r1:
return None
head = self.TreeNode(pre[l1])
if l1 == r1: # 如果l1和r1相等,说明只有一个节点,直接返回head
return head

# k是根节点在中序遍历中的位置
k = in_map[pre[l1]]
# 左子树的节点数量
left_size = k - l2

# 递归构建左子树和右子树
# pre : l1(........)[.......r1] -> l1是根, (l1+1...l1+left_size)是左子树, (...)是右子树
# in : (l2......)k[........r2] -> k是根, (l2...k-1)是左子树, [...]是右子树
head.left = self._f(pre, l1 + 1, l1 + left_size, tin, l2, k - 1, in_map)
head.right = self._f(pre, l1 + left_size + 1, r1, tin, k + 1, r2, in_map)
return head

算法分析

  • 时间复杂度:O(N)
  • 空间复杂度:O(N)
  • 核心技巧:递归分治 + 哈希表优化

题目八:验证完全二叉树

问题描述

给定一个二叉树,确定它是否是一个完全二叉树。在一棵完全二叉树中,除了最后一层外,所有层都被完全填满,并且最后一层中的所有节点都要靠左。

测试链接:https://leetcode.cn/problems/check-completeness-of-a-binary-tree/

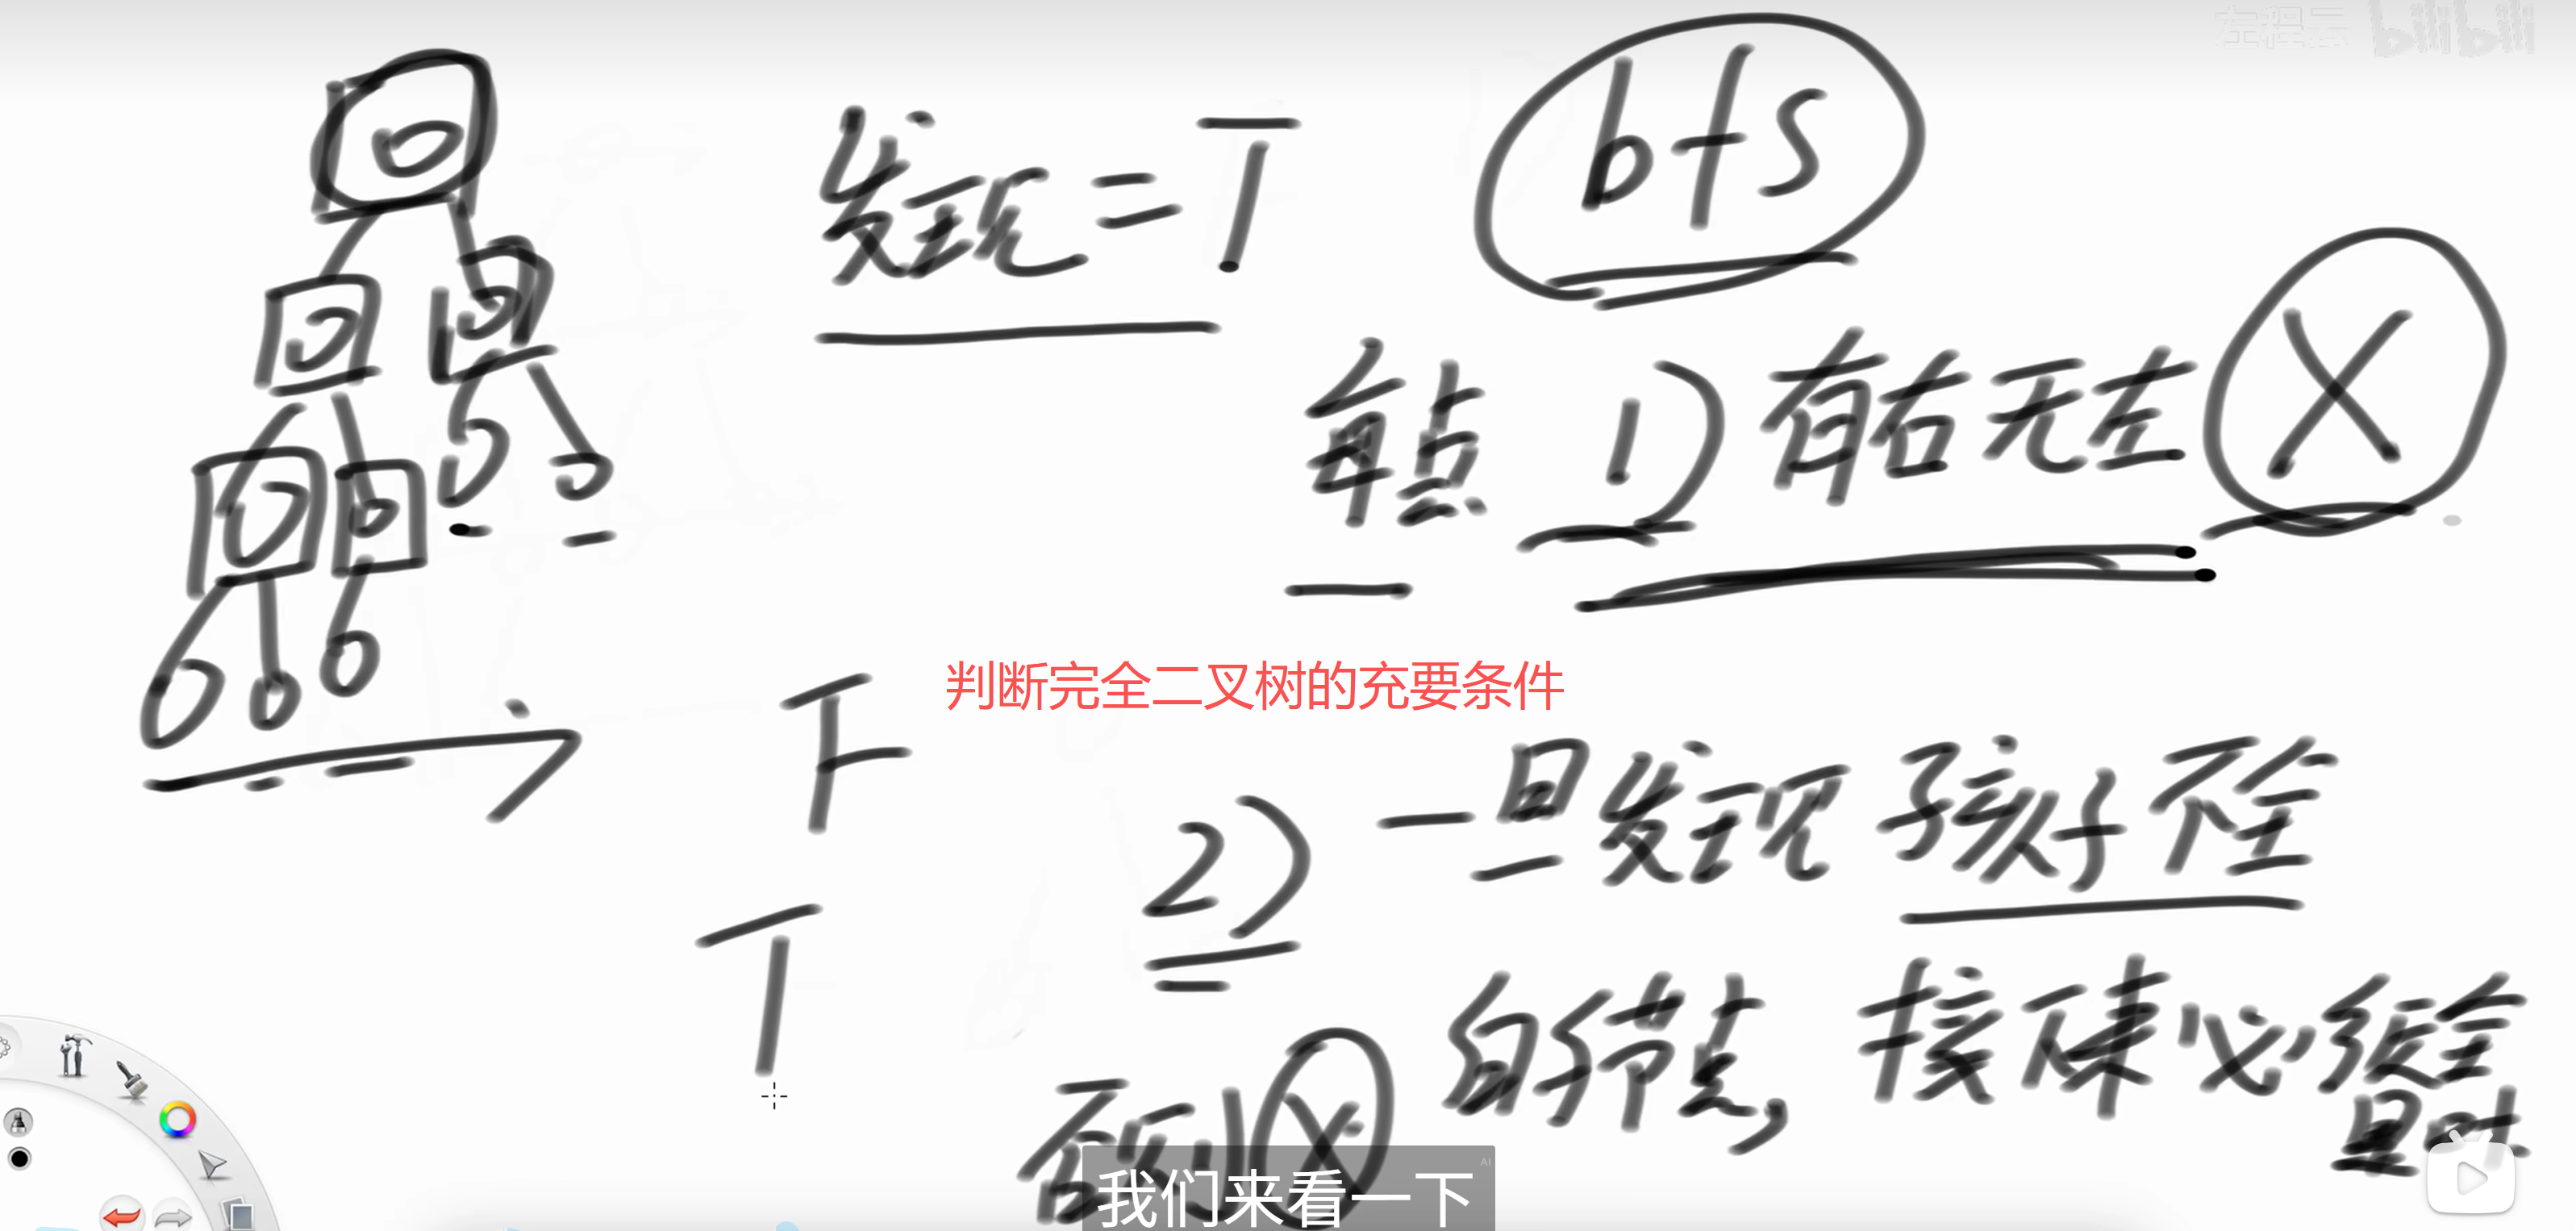
判断完全二叉树

核心思想

使用BFS进行层序遍历。一棵完全二叉树有两个特点:

  1. 任何节点不能只有右孩子没有左孩子
  2. 在层序遍历中,一旦遇到第一个孩子不双全的节点,之后遇到的所有节点都必须是叶子节点

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
# 提交以下的方法,实际上是一个又一个节点的bfs
def isCompleteTree(self, h: Optional[TreeNode]) -> bool:
if not h:
return True
queue = deque([h])
# 是否遇到过左右两个孩子不双全的节点
leaf_stage = False
while queue:
node = queue.popleft()
# case 1: 如果一个节点只有右孩子没有左孩子,必不是完全二叉树
# case 2: 如果已经遇到了不双全的节点(进入leaf_stage),后面又出现了孩子节点,也不是完全二叉树
if (not node.left and node.right) or \
(leaf_stage and (node.left or node.right)):
return False
if node.left:
queue.append(node.left)
if node.right:
queue.append(node.right)

# 一旦遇到孩子不双全的节点,就进入leaf_stage设为true,下一次循环中进行判断
if not node.left or not node.right:
leaf_stage = True
return True

算法分析

  • 时间复杂度:O(N)
  • 空间复杂度:O(N)
  • 核心技巧:BFS + 状态标记

题目九:求完全二叉树的节点个数

问题描述

给出一个完全二叉树,求出该树的节点个数。要求时间复杂度低于O(N)。

测试链接:https://leetcode.cn/problems/count-complete-tree-nodes/

统计完全二叉树节点
统计完全二叉树节点2

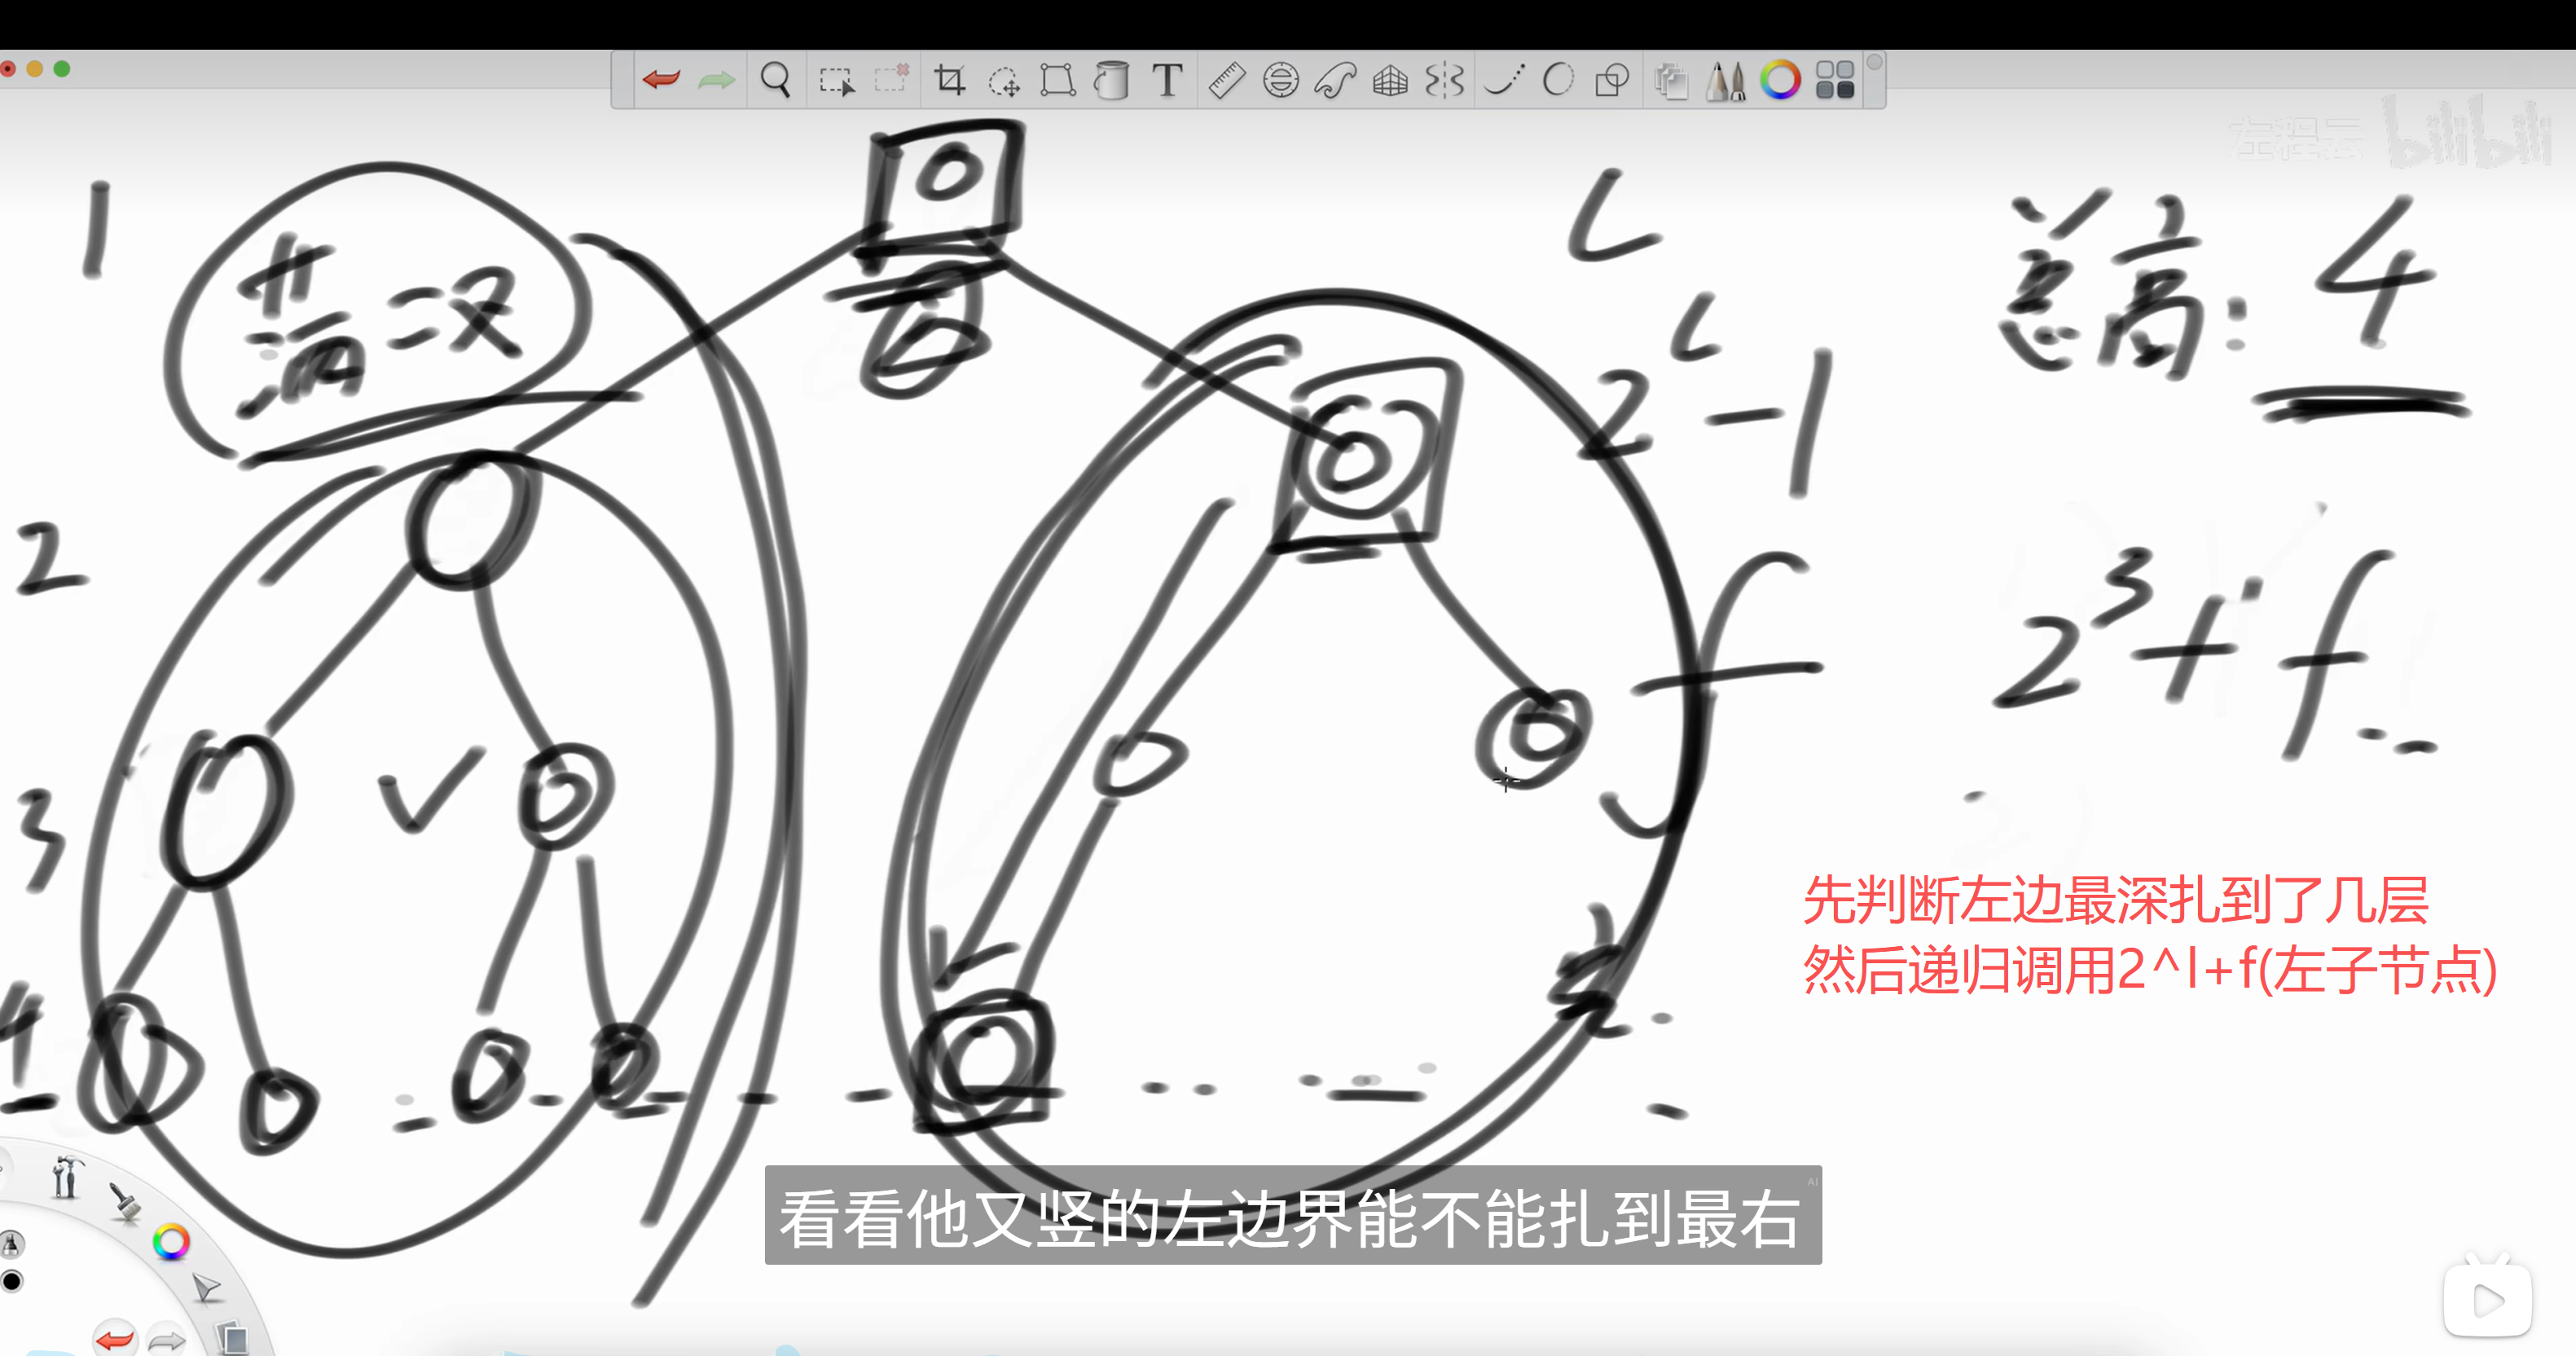
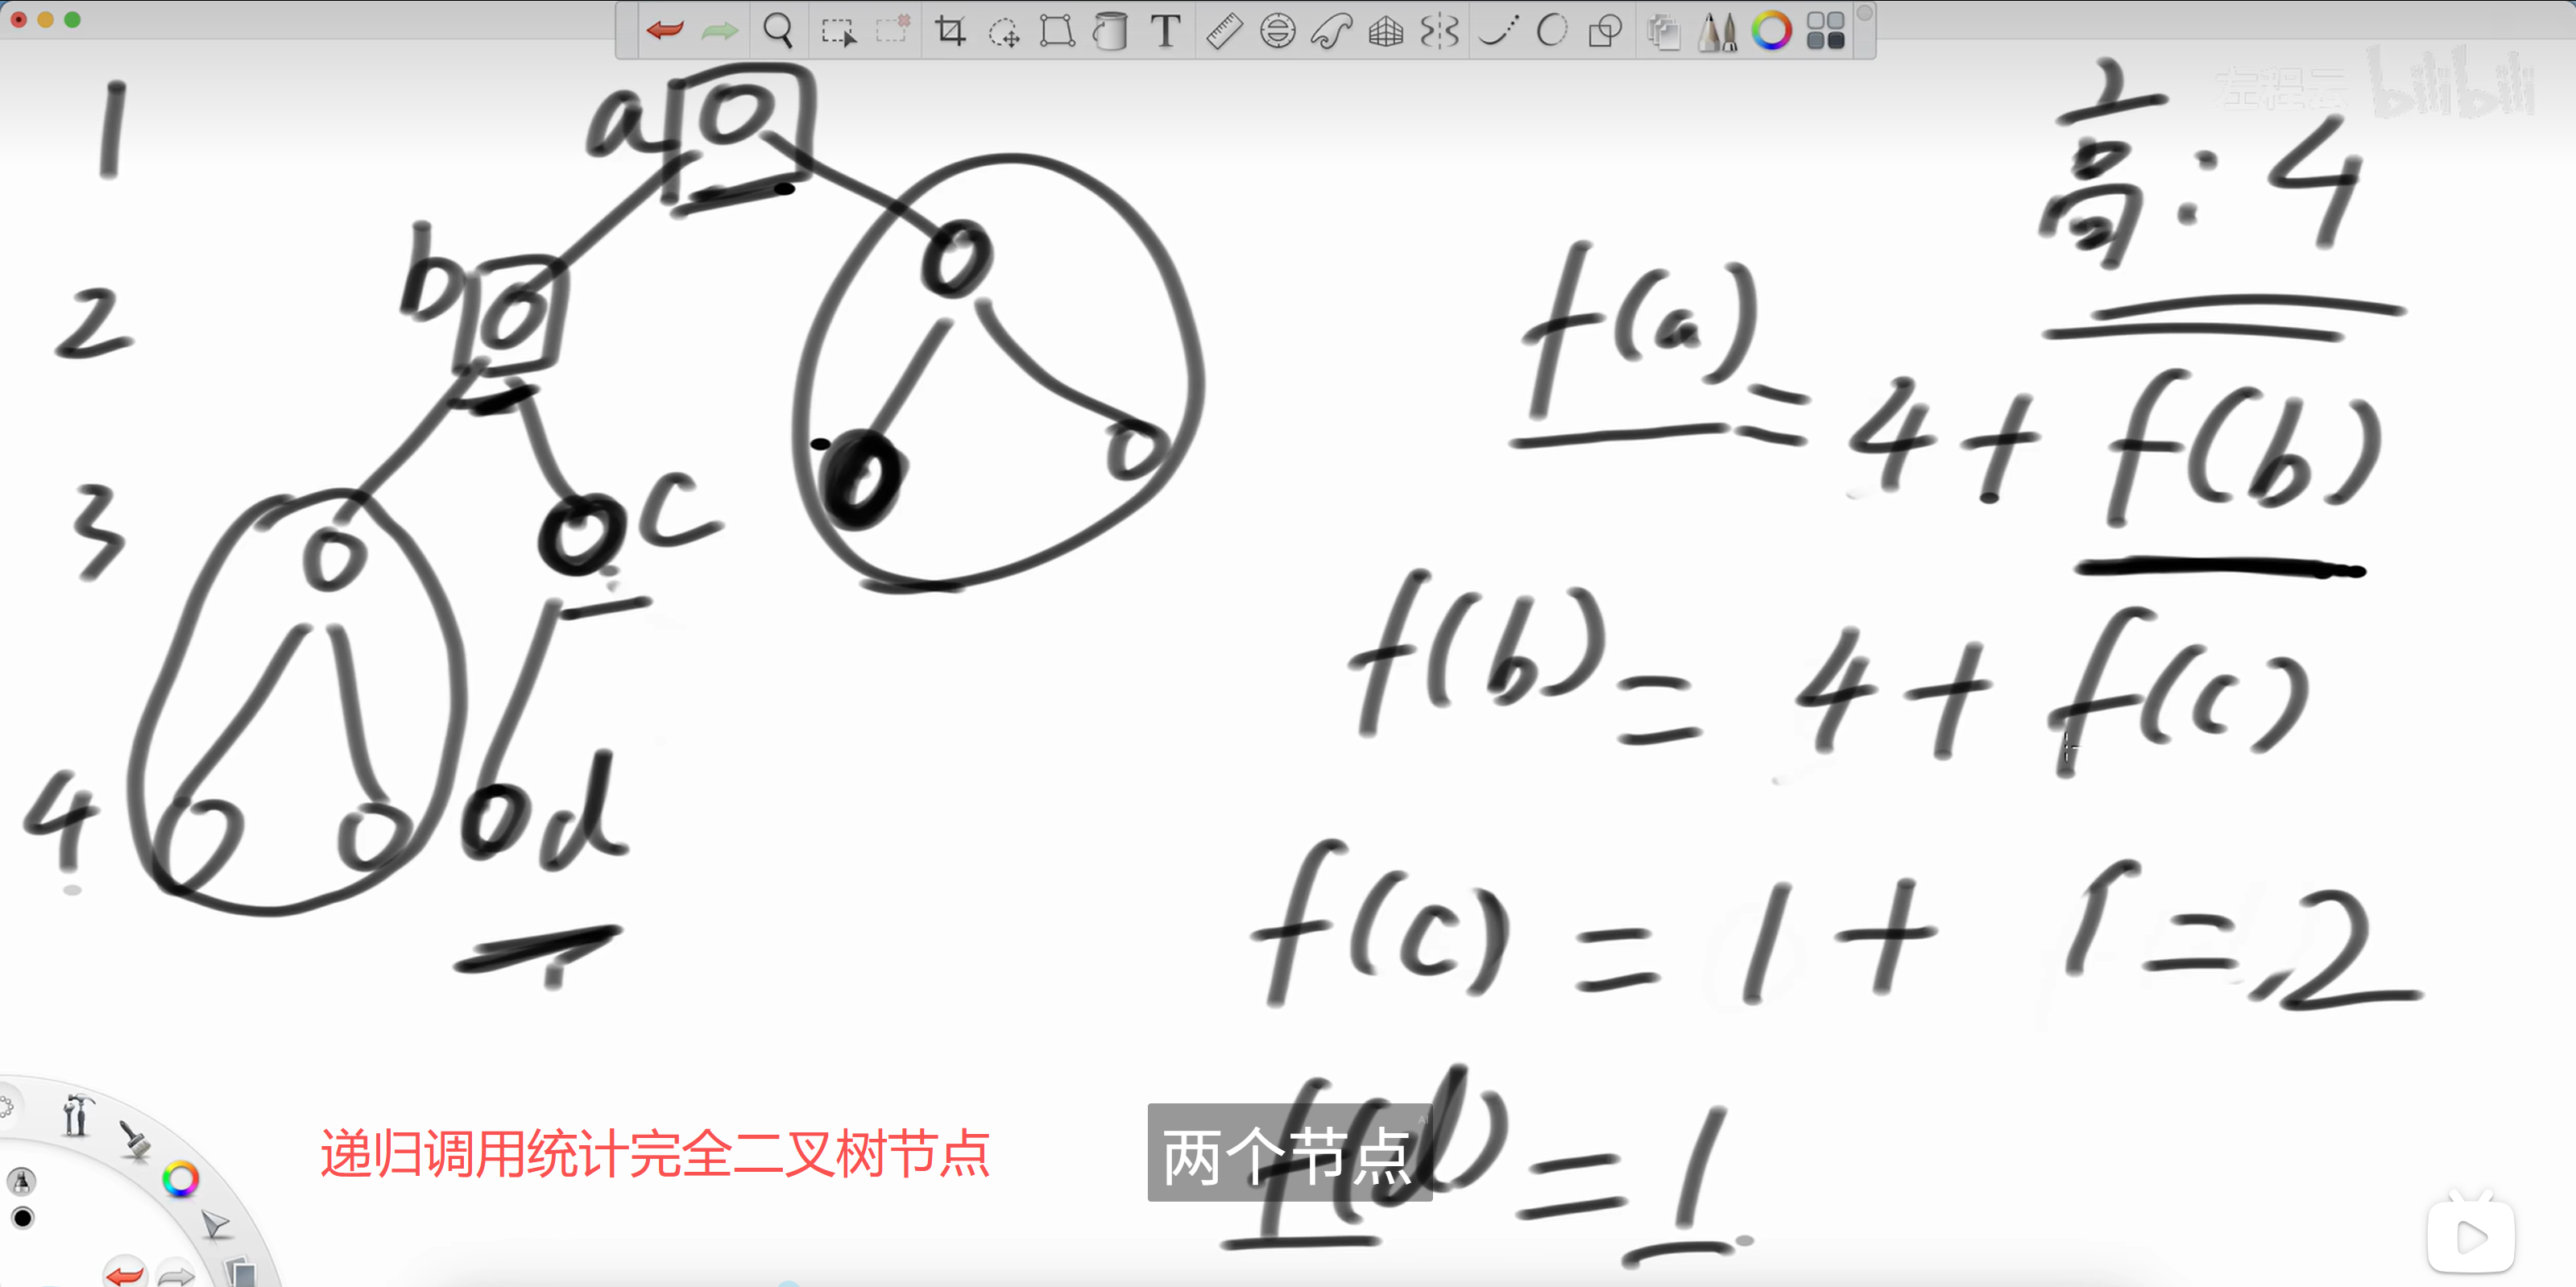
核心思想

利用完全二叉树的性质进行优化。对于任意节点,其左子树和右子树中,至少有一个是满二叉树。通过比较左右子树的高度,可以判断出哪个是满二叉树,从而用公式 (2^h - 1) 快速计算其节点数,然后只需递归计算另一半子树。每次递归都会下降一层,所以递归深度最多是 O(logN),每次调用 _mostLeft 的时间复杂度是 O(logN),这使得时间复杂度从O(N)降低到O((logN)^2)。

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
def countNodes(self, head: Optional[TreeNode]) -> int:
if not head:
return 0
h = self._mostLeft(head, 1) # 计算整棵树的高度
return self._f(head, 1, h)

def _f(self, cur, level, h):
"""
cur: 当前来到的节点
level: 当前cur来到的节点在第几层
h: 整棵树的高度
返回: cur这棵子树上有多少节点
"""
if level == h: # base case: 遍历到了最底层
return 1

# 如果右子树的最左路径能到达整棵树的最后一层
if self._mostLeft(cur.right, level + 1) == h:
# 说明cur的左子树是满二叉树,其节点数可以直接计算
# 节点总数 = 左子树节点数(2^(h-level)-1) + 根节点(1) + 递归求右子树节点数
# 合并后就是 (1 << (h - level)) + 递归求右子树
return (1 << (h - level)) + self._f(cur.right, level + 1, h) #1 << n 表示将数字1向左移动n位
else: #if else判断往左递归还是往右递归
# 否则,说明cur的右子树是比左子树少一层的满二叉树
# 节点总数 = 右子树节点数(2^(h-level-1)-1) + 根节点(1) + 递归求左子树节点数
# 合并后就是 (1 << (h - level - 1)) + 递归求左子树
return (1 << (h - level - 1)) + self._f(cur.left, level + 1, h)

def _mostLeft(self, cur, level):
"""
当前节点是cur,并且它在level层
返回从cur开始不停往左,能扎到几层
"""
while cur:
level += 1
cur = cur.left
return level - 1

算法分析

  • 时间复杂度:O((logN)²)
  • 空间复杂度:O(logN)
  • 核心技巧:完全二叉树性质 + 满二叉树公式

核心技巧总结

1. BFS层序遍历

1
2
3
4
5
6
7
8
9
10
11
# 标准BFS模板
queue = deque([root])
while queue:
size = len(queue) # 当前层节点数
for _ in range(size): # 处理当前层
node = queue.popleft()
# 处理当前节点
if node.left:
queue.append(node.left)
if node.right:
queue.append(node.right)

2. 树的递归

1
2
3
4
5
6
7
# 递归模板
def traverse(root):
if not root: # base case
return
# 处理当前节点
traverse(root.left) # 递归左子树
traverse(root.right) # 递归右子树

3. 完全二叉树编号

1
2
3
# 根节点编号为1
# 左子节点编号为 2*i
# 右子节点编号为 2*i + 1

4. 序列化技巧

1
2
3
# 先序序列化:根-左-右
# 层序序列化:逐层BFS + 补点
# 中序无法唯一确定树结构

复杂度分析总结

题目 时间复杂度 空间复杂度 核心算法
层序遍历 O(N) O(N) BFS
锯齿形遍历 O(N) O(N) BFS + 反转
最大宽度 O(N) O(N) BFS + 编号
最大/最小深度 O(N) O(H) 递归
先序序列化 O(N) O(N) 递归 + 迭代器
层序序列化 O(N) O(N) BFS + 补点
构造二叉树 O(N) O(N) 递归 + 哈希表
验证完全二叉树 O(N) O(N) BFS + 状态
完全二叉树节点数 O((logN)²) O(logN) 递归 + 性质

学习建议

  1. 掌握BFS和DFS:这是处理树问题的两大基本方法

  2. 理解递归本质:树的递归结构使得很多问题都可以用递归解决

  3. 灵活运用数据结构:

    • 队列(BFS)
    • 哈希表(快速查找)
    • 迭代器(序列化处理)
  4. 注意边界条件:

    • 空树处理
    • 叶子节点判断
    • 层级边界
  5. 理解树的性质:

    • 完全二叉树的特点
    • 满二叉树的节点公式
    • 不同遍历方式的特点
  6. 练习组合技巧:很多树的问题需要组合多种基础算法

通过掌握这些经典的二叉树算法,可以为后续学习更复杂的树型动态规划和高级树结构打下坚实的基础。

037【必备】二叉树高频题目-下-不含树型dp

初始化的二叉树类

1
2
3
4
5
class TreeNode:
def __init__(self, val=0, left=None, right=None):
self.val = val
self.left = left
self.right = right

题目一:普通二叉树上寻找两个节点的最近公共祖先

问题描述

给定一个二叉树, 找到该树中两个指定节点的最近公共祖先。

测试链接:https://leetcode.cn/problems/lowest-common-ancestor-of-a-binary-tree/

普通二叉树查找最近共同祖先

核心思想

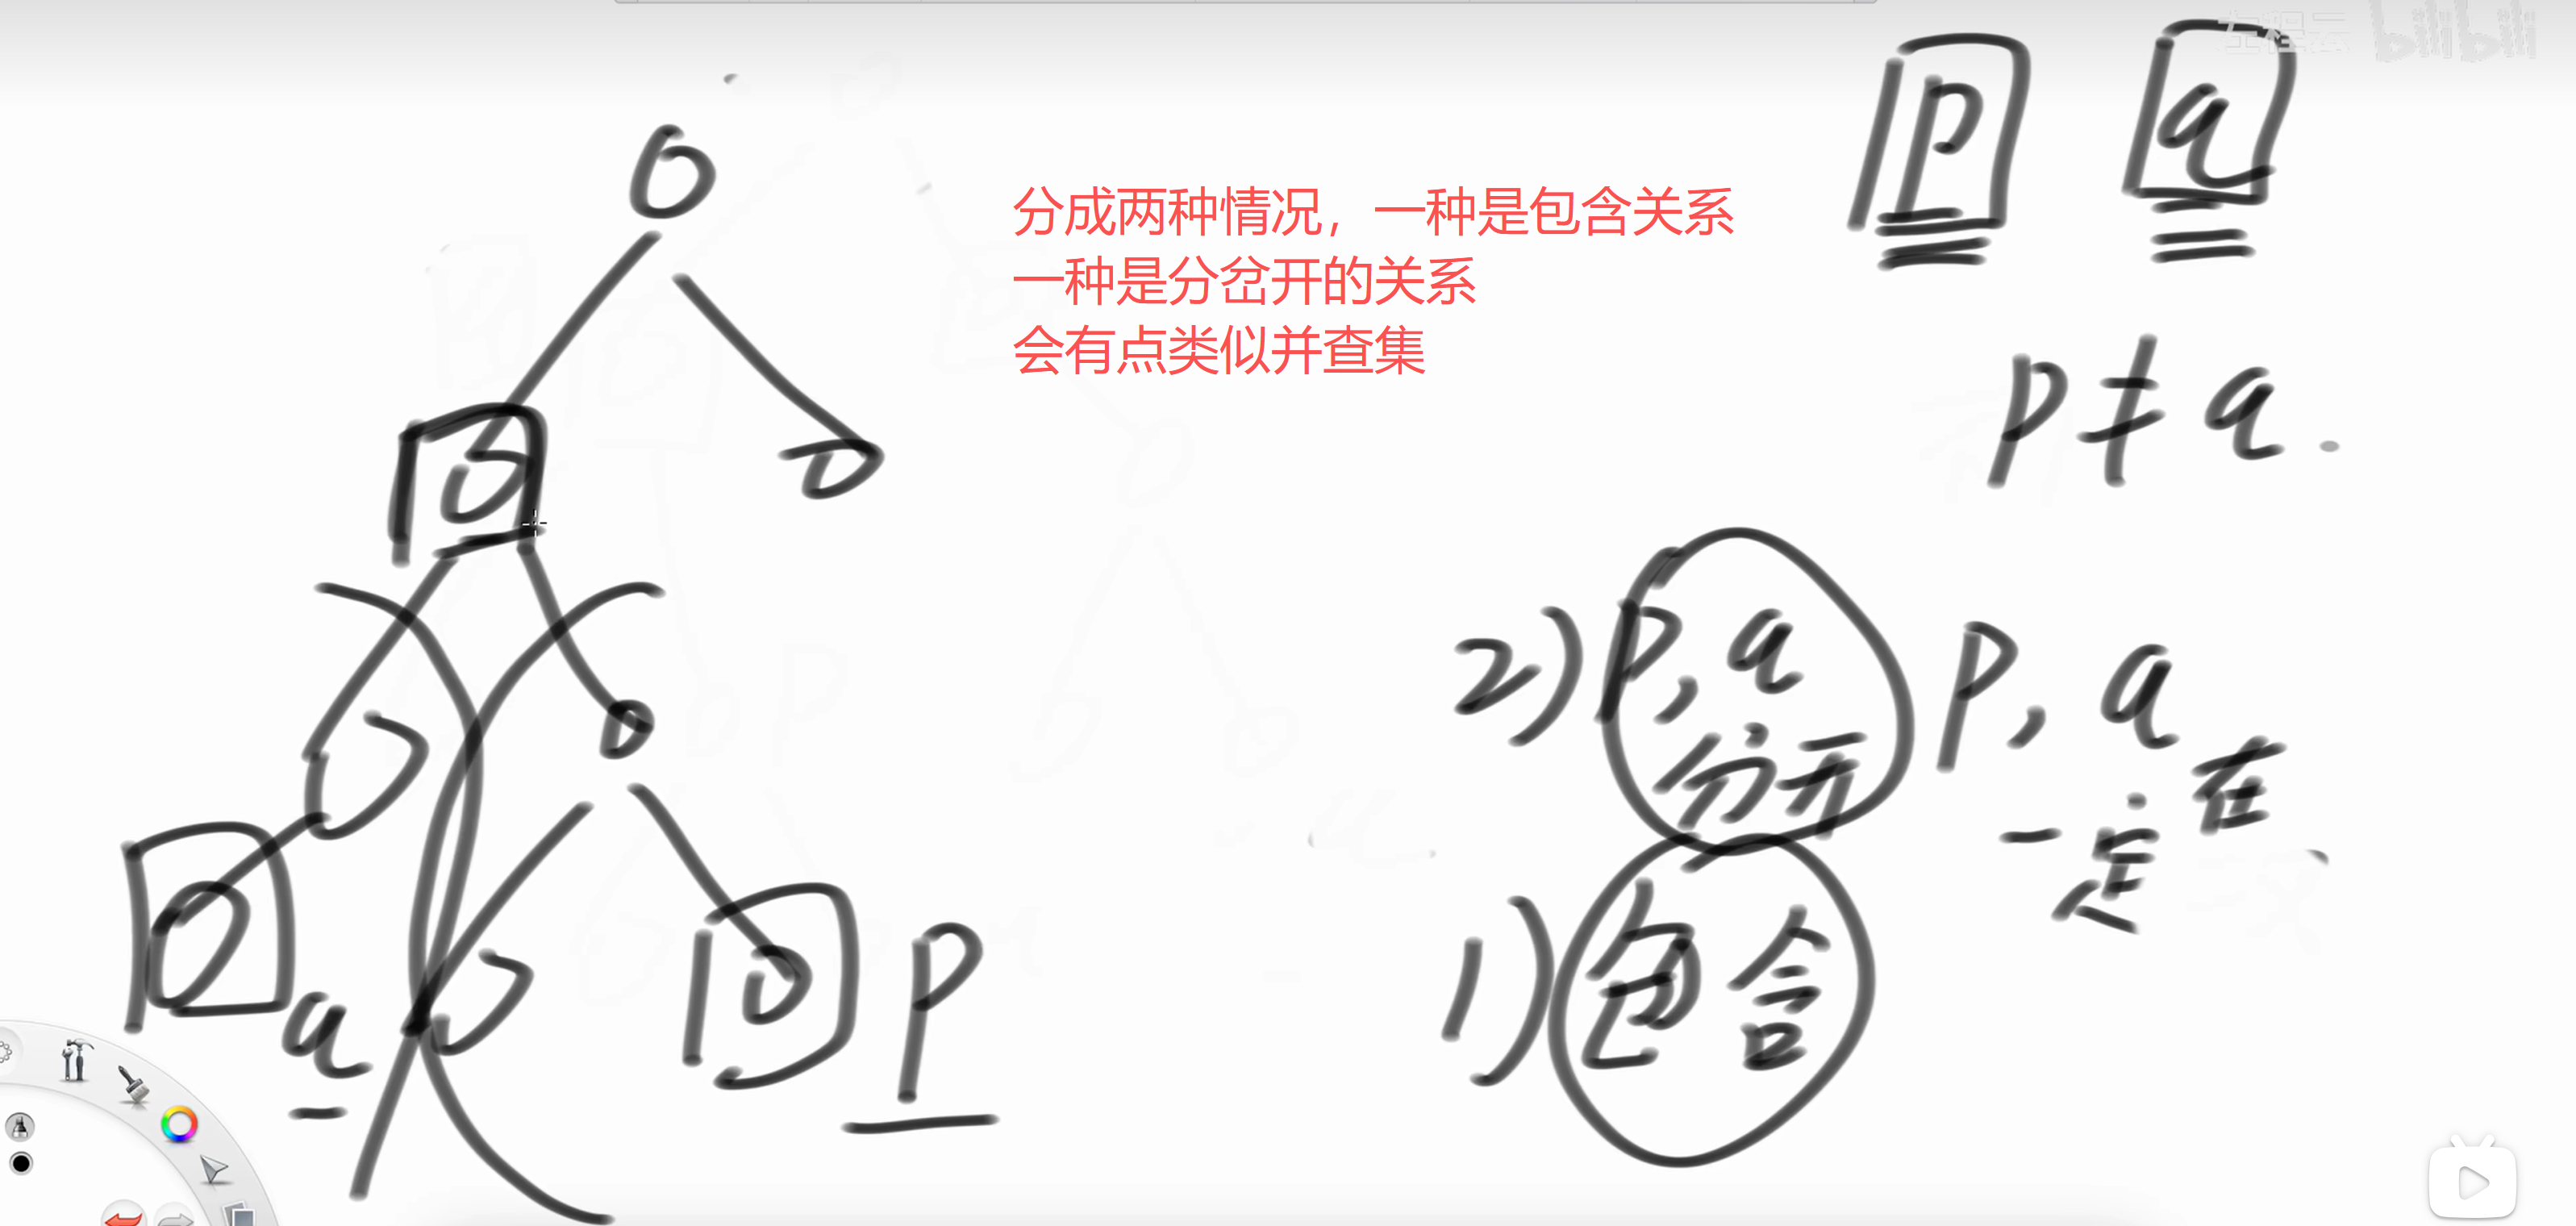
采用递归的方式深度优先搜索:

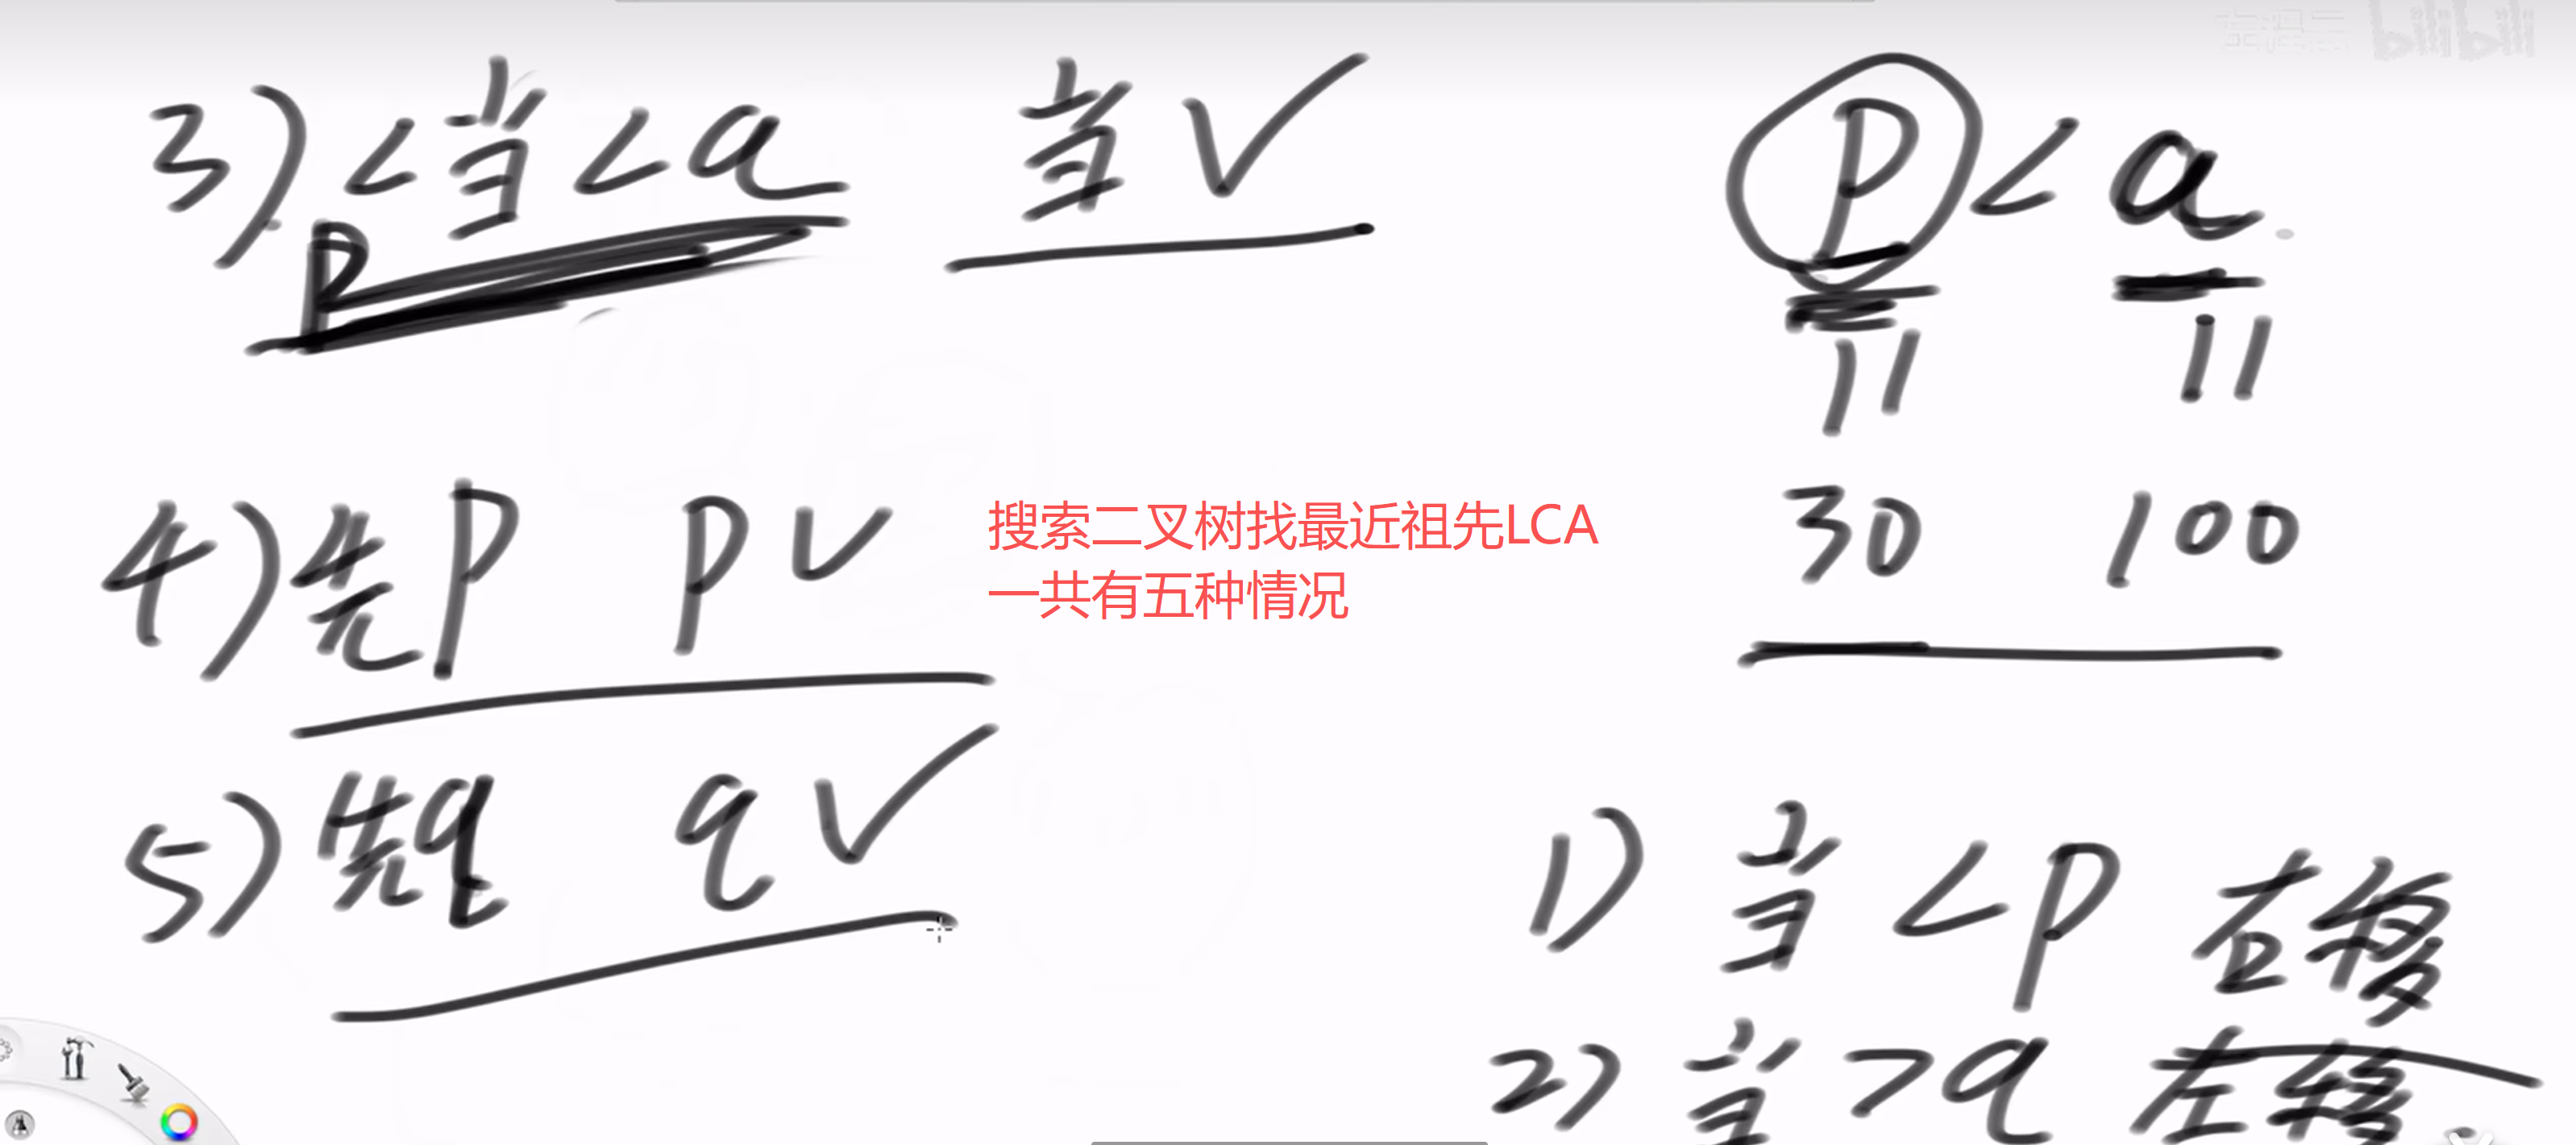
  1. 如果当前节点为空,或者等于p或q中的一个,那么它本身就是其子树中p或q的LCA
  2. 否则,递归地在左子树和右子树中寻找p和q
  3. 如果左右子树都返回了非空节点,说明p和q分别位于当前节点的两侧,当前节点就是LCA
  4. 如果只有一个子树返回了非空节点,说明p和q都在那个子树中,返回那个非空节点即可
  5. 如果左右子树都返回空,说明p和q都不在此子树中。

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
class TreeNode:
def __init__(self, val=0, left=None, right=None):
self.val = val
self.left = left
self.right = right

class Solution:
def lowestCommonAncestor(self, root: 'TreeNode', p: 'TreeNode', q: 'TreeNode') -> 'TreeNode':
"""
寻找最近公共祖先的核心函数
采用递归的方式深度优先搜索
"""

# 遇到空,或者p,或者q,直接返回
# 这是递归的基准情况 (base case)
if not root or root == p or root == q: # 如果root不空的话,这样从下往上会一直传p或者q
return root

# 在左子树和右子树中递归查找 p 和 q
l = self.lowestCommonAncestor(root.left, p, q)
r = self.lowestCommonAncestor(root.right, p, q)

# 左树也搜到,右树也搜到,返回root
# 这意味着p和q分别在root的左右两侧,root是它们的LCA
if l and r:
return root

# 如果左右子树的搜索结果都为空,说明p,q不在此子树
if not l and not r:
return None

# l和r一个为空,一个不为空
# 返回不空的那个,这个非空节点要么是p或q本身,要么已经是p和q的LCA
return l if l else r

算法分析

  • 时间复杂度:O(N),最坏情况下需要遍历所有节点
  • 空间复杂度:O(H),H为树的高度,递归栈的深度
  • 核心技巧:递归 + 分情况讨论

题目二:搜索二叉树上寻找两个节点的最近公共祖先

问题描述

给定一个二叉搜索树, 找到该树中两个指定节点的最近公共祖先。

测试链接:https://leetcode.cn/problems/lowest-common-ancestor-of-a-binary-search-tree/

搜索二叉树查找最近共同祖先

核心思想

利用BST的特性,可以高效地进行迭代查找:

  1. 从根节点开始遍历
  2. 如果p和q的值都小于当前节点的值,说明LCA必定在左子树,往左走
  3. 如果p和q的值都大于当前节点的值,说明LCA必定在右子树,往右走
  4. 如果当前节点的值在p和q的值之间(或者等于其中一个),那么当前节点就是第一个”分叉点”,即为LCA

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
class Solution:
def lowestCommonAncestor(self, root: 'TreeNode', p: 'TreeNode', q: 'TreeNode') -> 'TreeNode':
"""
在二叉搜索树(BST)中寻找最近公共祖先
利用BST的特性,可以高效地进行迭代查找
"""

# 确定p和q节点值的范围
min_val = min(p.val, q.val)
max_val = max(p.val, q.val)

# 循环遍历,直到找到LCA
while root:
# 如果当前节点的值大于p和q的最大值,说明LCA在左子树
if root.val > max_val:
root = root.left
# 如果当前节点的值小于p和q的最小值,说明LCA在右子树
elif root.val < min_val:
root = root.right
# 否则,当前节点的值在[min_val, max_val]之间,它就是LCA
else:
return root

return None # 理论上在有效输入下不会到达这里

算法分析

  • 时间复杂度:O(H),H为树的高度
  • 空间复杂度:O(1)
  • 核心技巧:利用BST性质 + 迭代

题目三:收集累加和等于aim的所有路径

问题描述

给你二叉树的根节点 root 和一个表示目标和的整数 targetSum ,返回所有从根节点到叶子节点路径总和等于给定目标和的路径。

测试链接:https://leetcode.cn/problems/path-sum-ii/

dfs回溯的概念
dfs回溯的概念2

核心思想

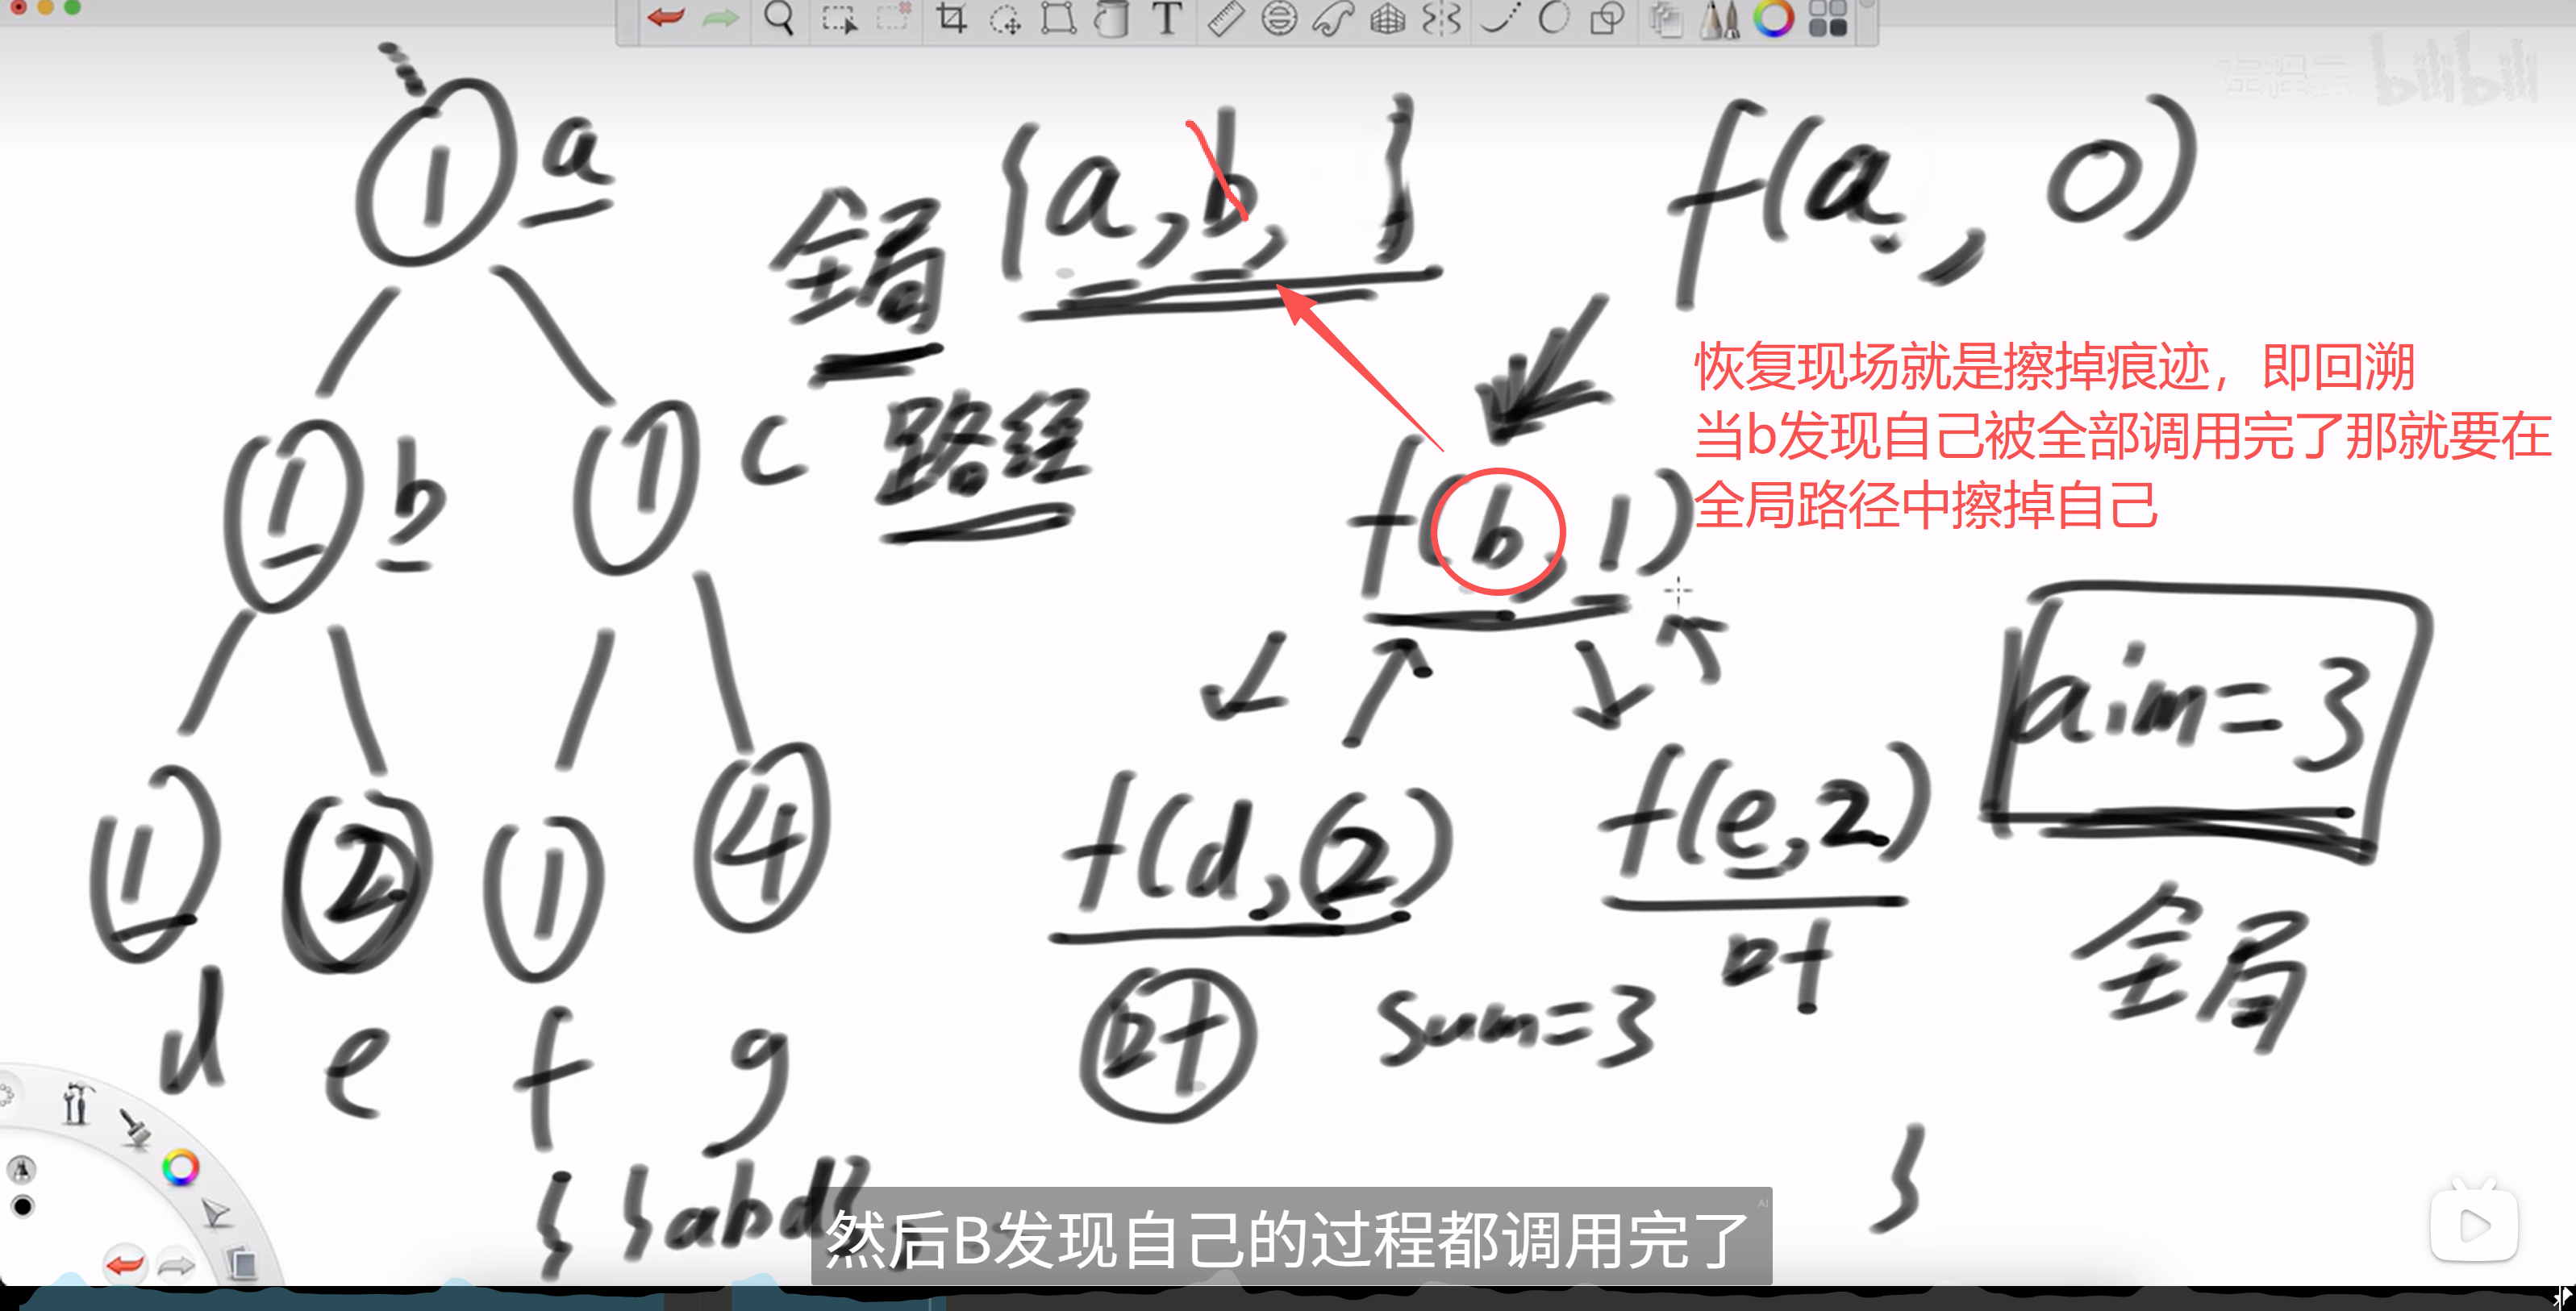
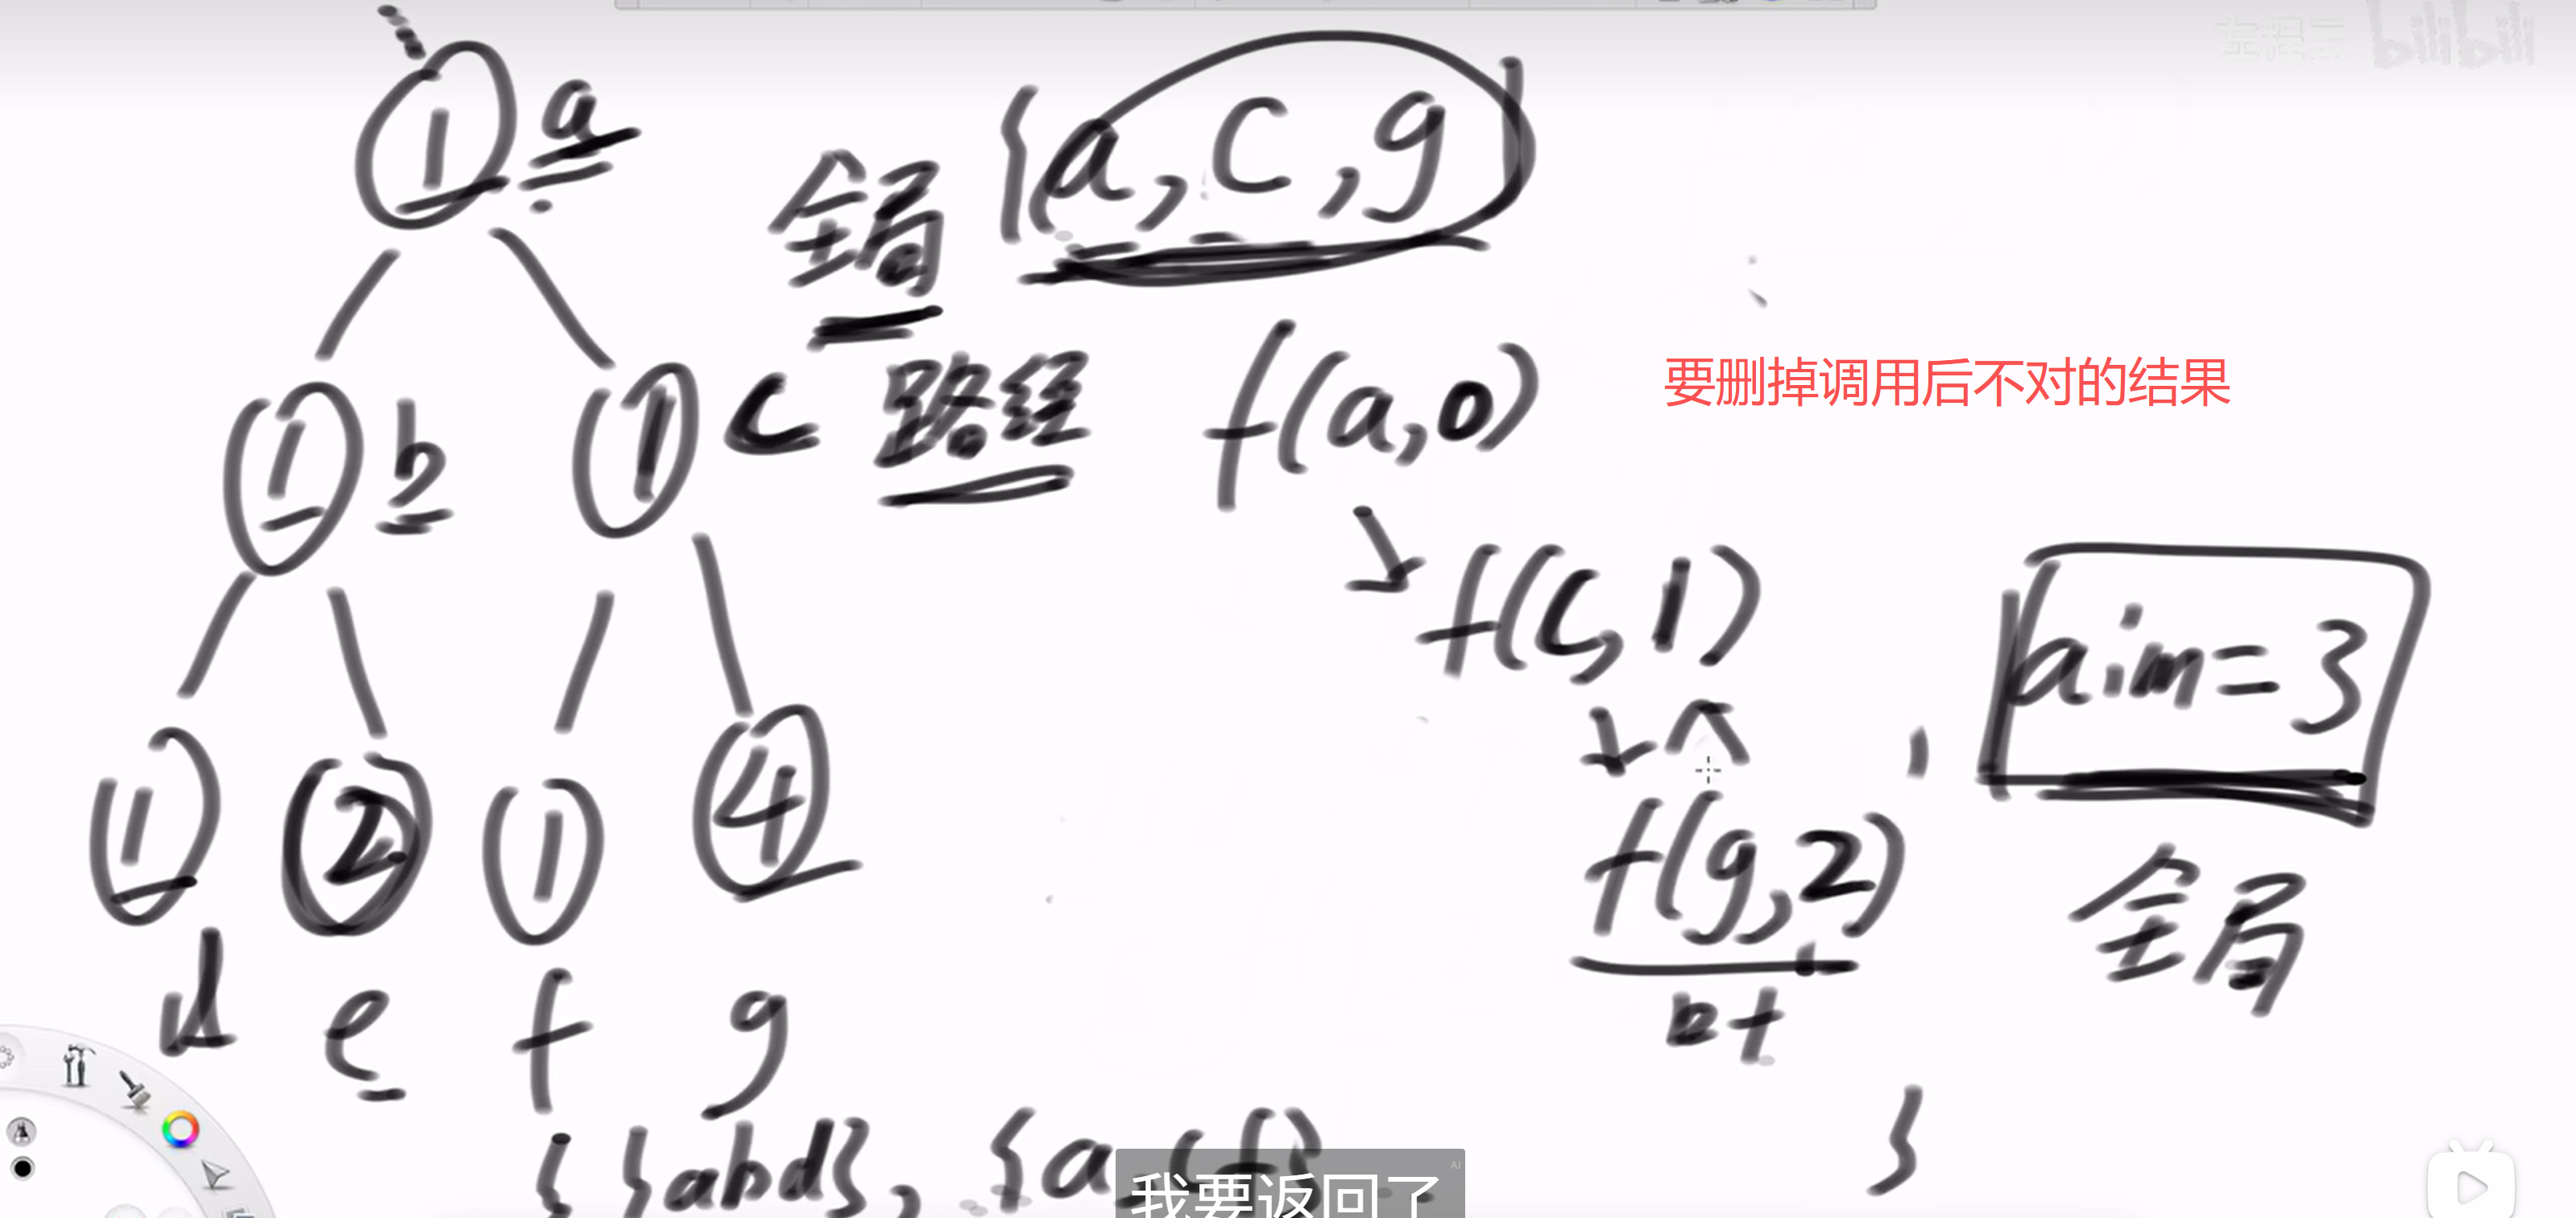
使用DFS + 回溯的方法:

  1. 维护一个当前路径 path 和当前路径和 current_sum
  2. 深入遍历树,每经过一个节点,就将其加入 path,并更新 current_sum
  3. 当到达一个叶子节点时,检查 current_sum + cur.val是否等于目标值,如果是,将当前路径(包括叶子节点)的一个副本添加到最终结果 ans 中
  4. 遍历完一个节点的所有子树后,需要回溯,即将该节点从 path 中移除,以便返回到父节点继续搜索其他分支

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
from typing import List, Optional

class Solution:
def pathSum(self, root: Optional[TreeNode], targetSum: int) -> List[List[int]]:
"""
主函数,初始化结果列表和路径列表,并启动递归搜索
"""
ans = []
if root:
path = []
# 调用递归辅助函数 f
self.f(root, targetSum, 0, path, ans) # 一开始sum=0,ans也是空列表,path也是空列表
return ans

def f(self, cur: TreeNode, aim: int, current_sum: int, path: List[int], ans: List[List[int]]):
"""
递归辅助函数,用于深度优先搜索所有路径
"""

# 将当前节点值加入路径
path.append(cur.val)

# 判断是否为叶节点
is_leaf = cur.left is None and cur.right is None

if is_leaf:
# 叶节点
# 如果当前路径和加上叶节点的值等于目标值,则找到一个有效路径
if current_sum + cur.val == aim:
# 将路径的副本添加到结果中
# 必须是副本(path[:]),否则后续的回溯操作会影响已存入的结果
ans.append(path[:])
else:
# 不是叶节点
# 递归探索左子树
if cur.left:
self.f(cur.left, aim, current_sum + cur.val, path, ans)
# 递归探索右子树
if cur.right:
self.f(cur.right, aim, current_sum + cur.val, path, ans)

# 回溯步骤:当一个节点的左右子树都探索完毕后,
# 将该节点从当前路径中移除,返回到其父节点的递归调用中。
path.pop() # 用 path.pop() 把刚才加入的那个节点移除,恢复到进入递归前的状态

回溯不会死循环的原因

  1. 控制流是”递归调用”不是”循环依赖”:每次调用只会递归左子树、右子树各最多一次
  2. for/if 的次数是固定的:子树递归只发生在固定的分支中,不会因为pop重复触发
  3. pop 只是在撤销路径,不改变遍历指针:pop 修改的是 path 内容,用于恢复现场;并不改变 cur、cur.left、cur.right 的结构或递归栈帧。可以把它看作:DFS 到底(或到叶/路尽)后,撤销上一步选择,然后走兄弟分支;兄弟分支走完,再撤销并上返……直到根。整个过程单调“回退”栈帧,不可能形成死循环。这个调用栈帧的所有工作(检查/递归左右)都完成了,撤销现场后,自然结束返回到父调用。

算法分析

  • 时间复杂度:O(N²),最坏情况下每条路径都需要复制
  • 空间复杂度:O(H),H为树的高度
  • 核心技巧:DFS + 回溯 + 路径复制

题目四:验证平衡二叉树

问题描述

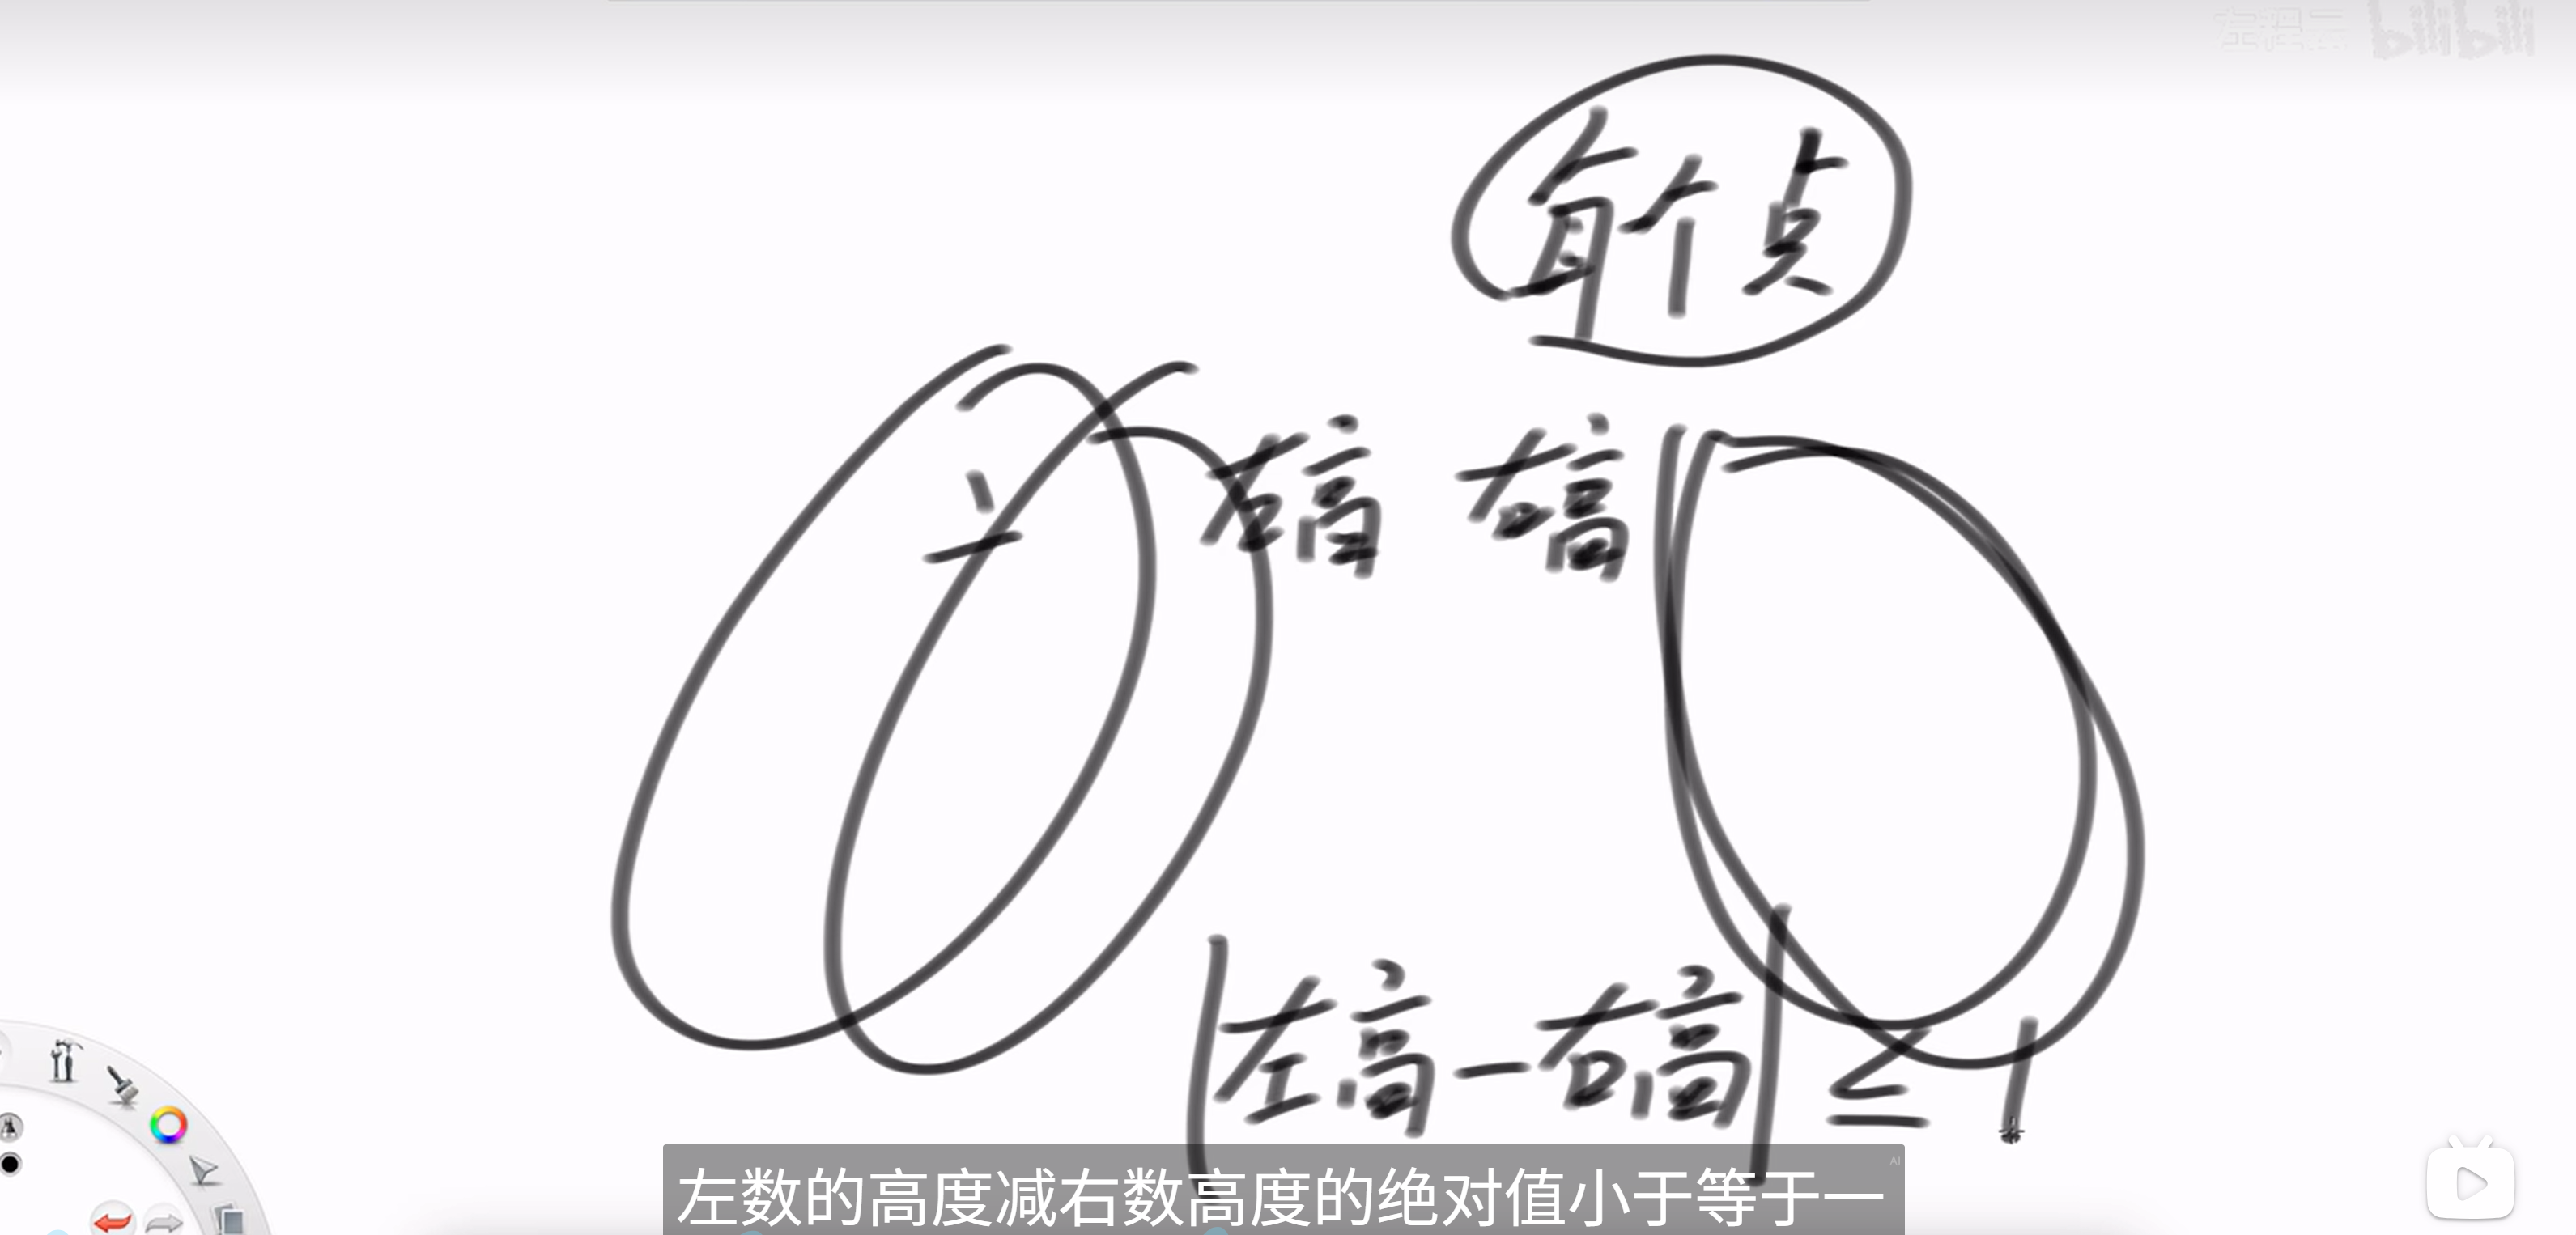
给定一个二叉树,判断它是否是高度平衡的二叉树。一个高度平衡二叉树定义为:一个二叉树每个节点的左右两个子树的高度差的绝对值不超过1。

测试链接:https://leetcode.cn/problems/balanced-binary-tree/

平衡二叉树概念

核心思想

使用后序遍历的思想:

  1. 要判断当前节点是否平衡,需要先知道其左右子树的高度
  2. 这天然地符合后序遍历的顺序(先左、再右、后根)
  3. 递归地计算左子树和右子树的高度
  4. 在计算完左右子树高度后,检查它们的高度差
  5. 使用一个实例变量来记录是否已发现不平衡,一旦发现不平衡,就将此标志设为False,后续的递归调用可以提前终止。

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
from typing import Optional

class Solution:
def __init__(self):
# balance是实例变量,用于在递归调用中共享状态,所以能够实现全局变量的效果
# 每次判断开始时,在主函数中将其重置为true
self.balance = True

def isBalanced(self, root: Optional[TreeNode]) -> bool:
"""
主函数,用于启动平衡性检查
"""
# 重置平衡标志
self.balance = True
# 调用递归函数计算高度并检查平衡性
self.height(root)
return self.balance

def height(self, cur: Optional[TreeNode]) -> int:
"""
递归计算节点高度,并在此过程中检查平衡性
"""
# 核心思想(后序遍历):
# 1. 要判断当前节点是否平衡,需要先知道其左右子树的高度。
# 2. 这天然地符合后序遍历的顺序(先左、再右、后根)。
# 3. 递归地计算左子树和右子树的高度。
# 4. 在计算完左右子树高度后,检查它们的高度差。如果差值大于1,说明树不平衡。
# 5. 使用一个全局或实例变量 `self.balance` 来记录是否已发现不平衡。
# 一旦发现不平衡,就将此标志设为False,后续的递归调用可以提前终止。

# 一旦发现不平衡,或者当前节点为空,返回0,后续计算已无意义或到达递归边界
if not self.balance or cur is None:
return 0

# 递归计算左子树的高度
lh = self.height(cur.left)
# 递归计算右子树的高度
rh = self.height(cur.right)

# 检查左右子树的高度差
if abs(lh - rh) > 1:
# 如果高度差大于1,则标记为不平衡
self.balance = False

# 返回当前节点的高度,即左右子树中较高者的高度加1
# 叶子节点的高度为 1,因为它的左右子树高度都是 0,返回 max(0, 0) + 1 = 1
return max(lh, rh) + 1

算法分析

  • 时间复杂度:O(N),每个节点访问一次
  • 空间复杂度:O(H),H为树的高度
  • 核心技巧:后序遍历 + 全局状态

题目五:验证搜索二叉树

问题描述

给定一个二叉树,判断其是否是一个有效的二叉搜索树。

测试链接:https://leetcode.cn/problems/validate-binary-search-tree/

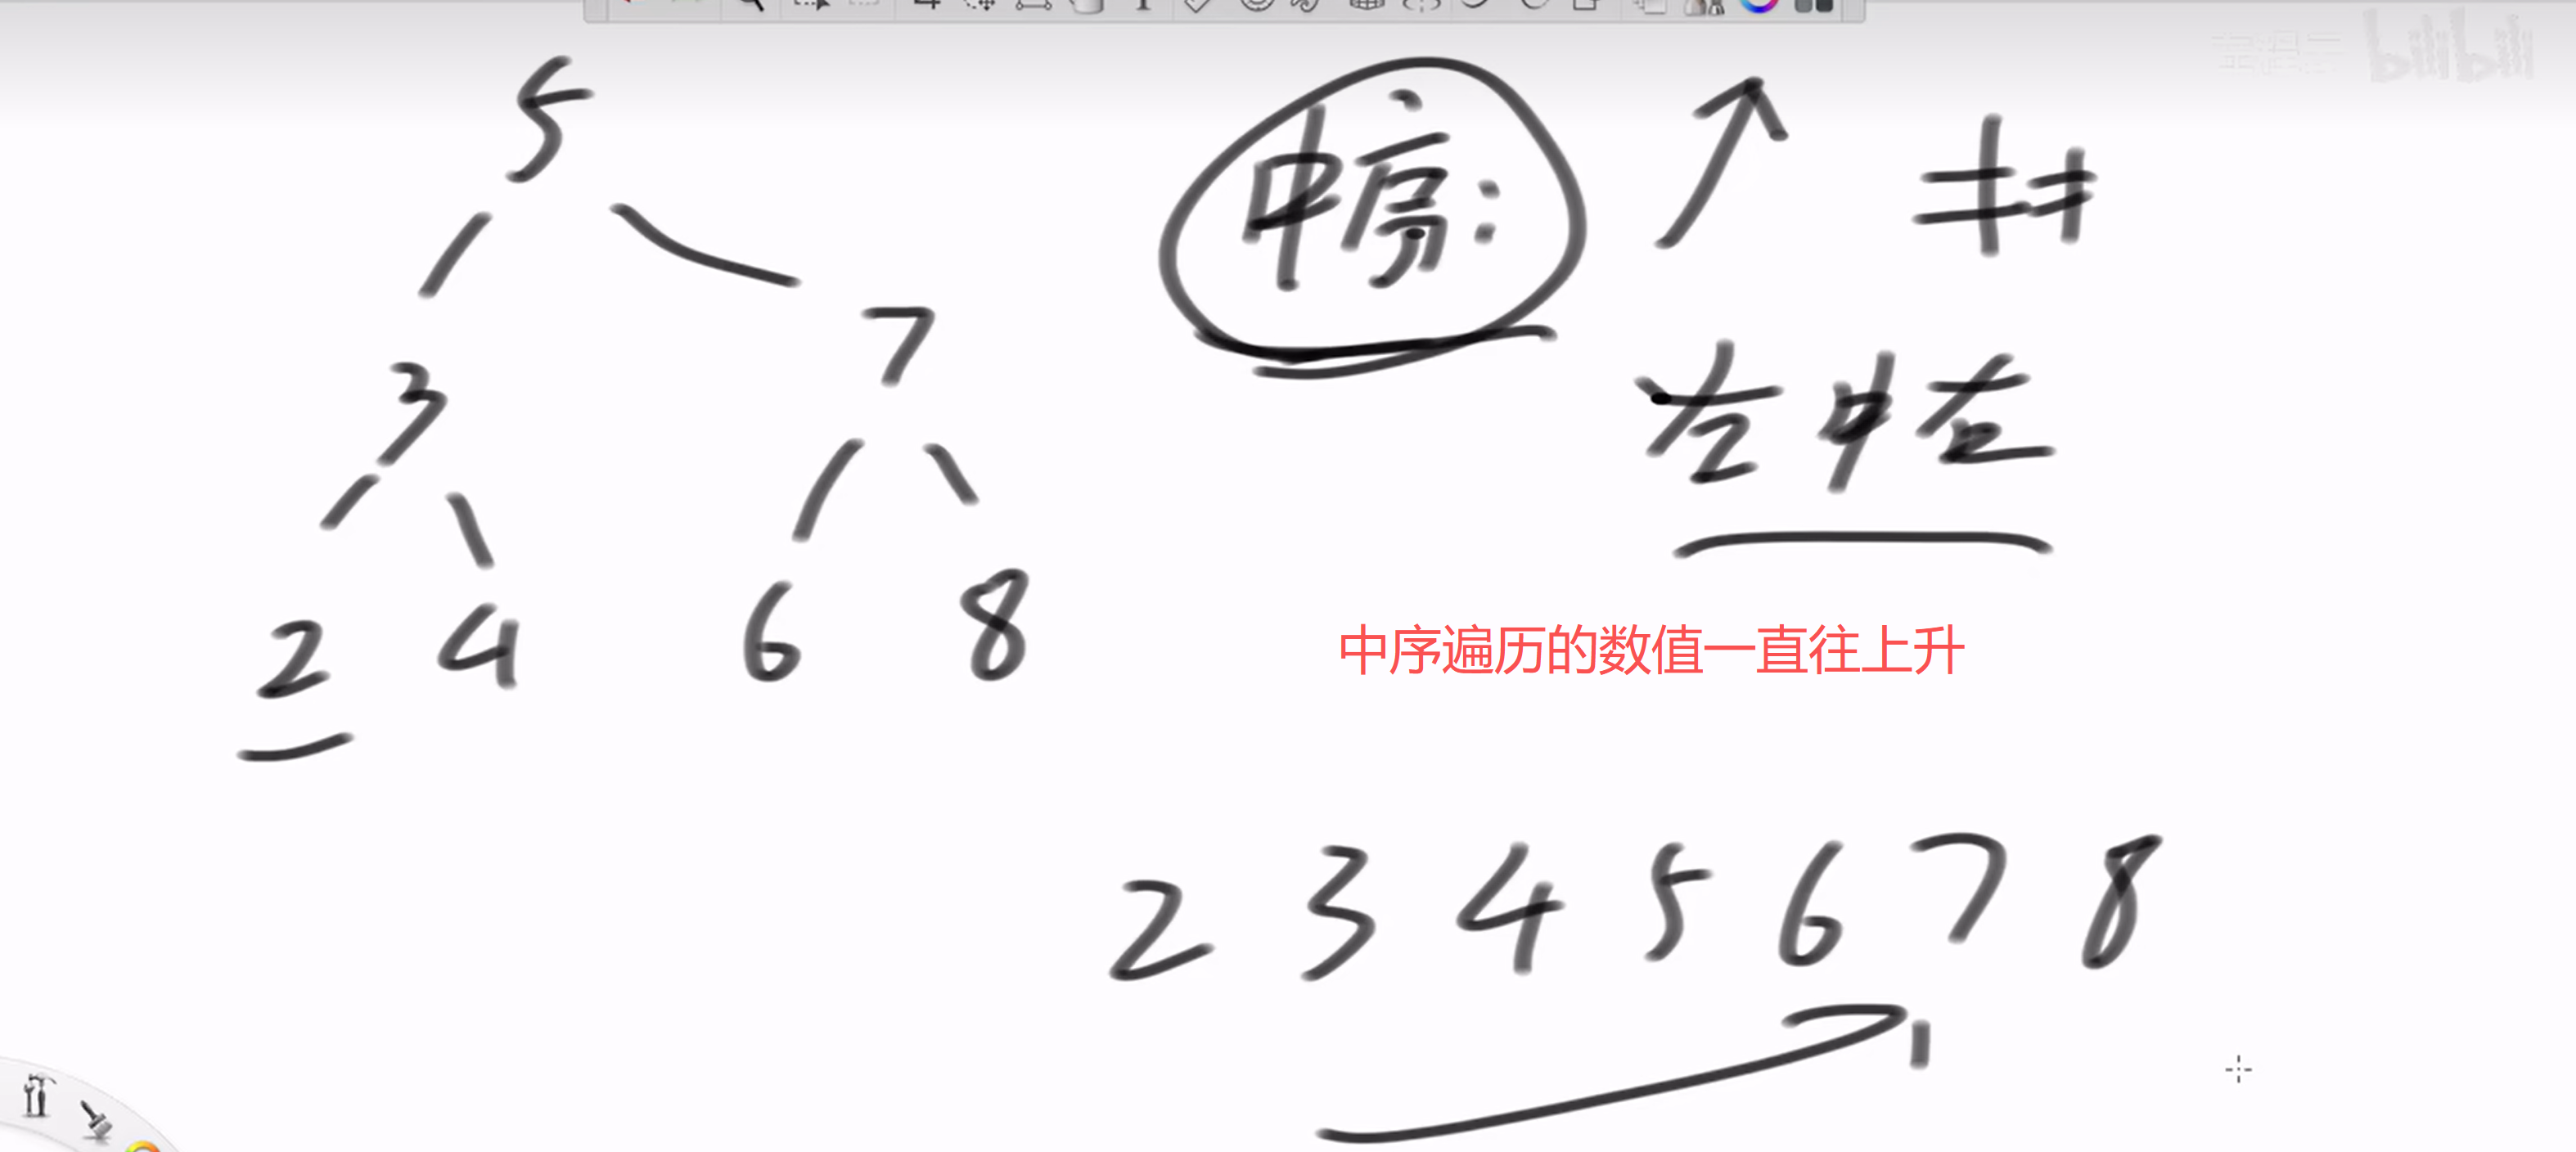
判断搜索二叉树方法1
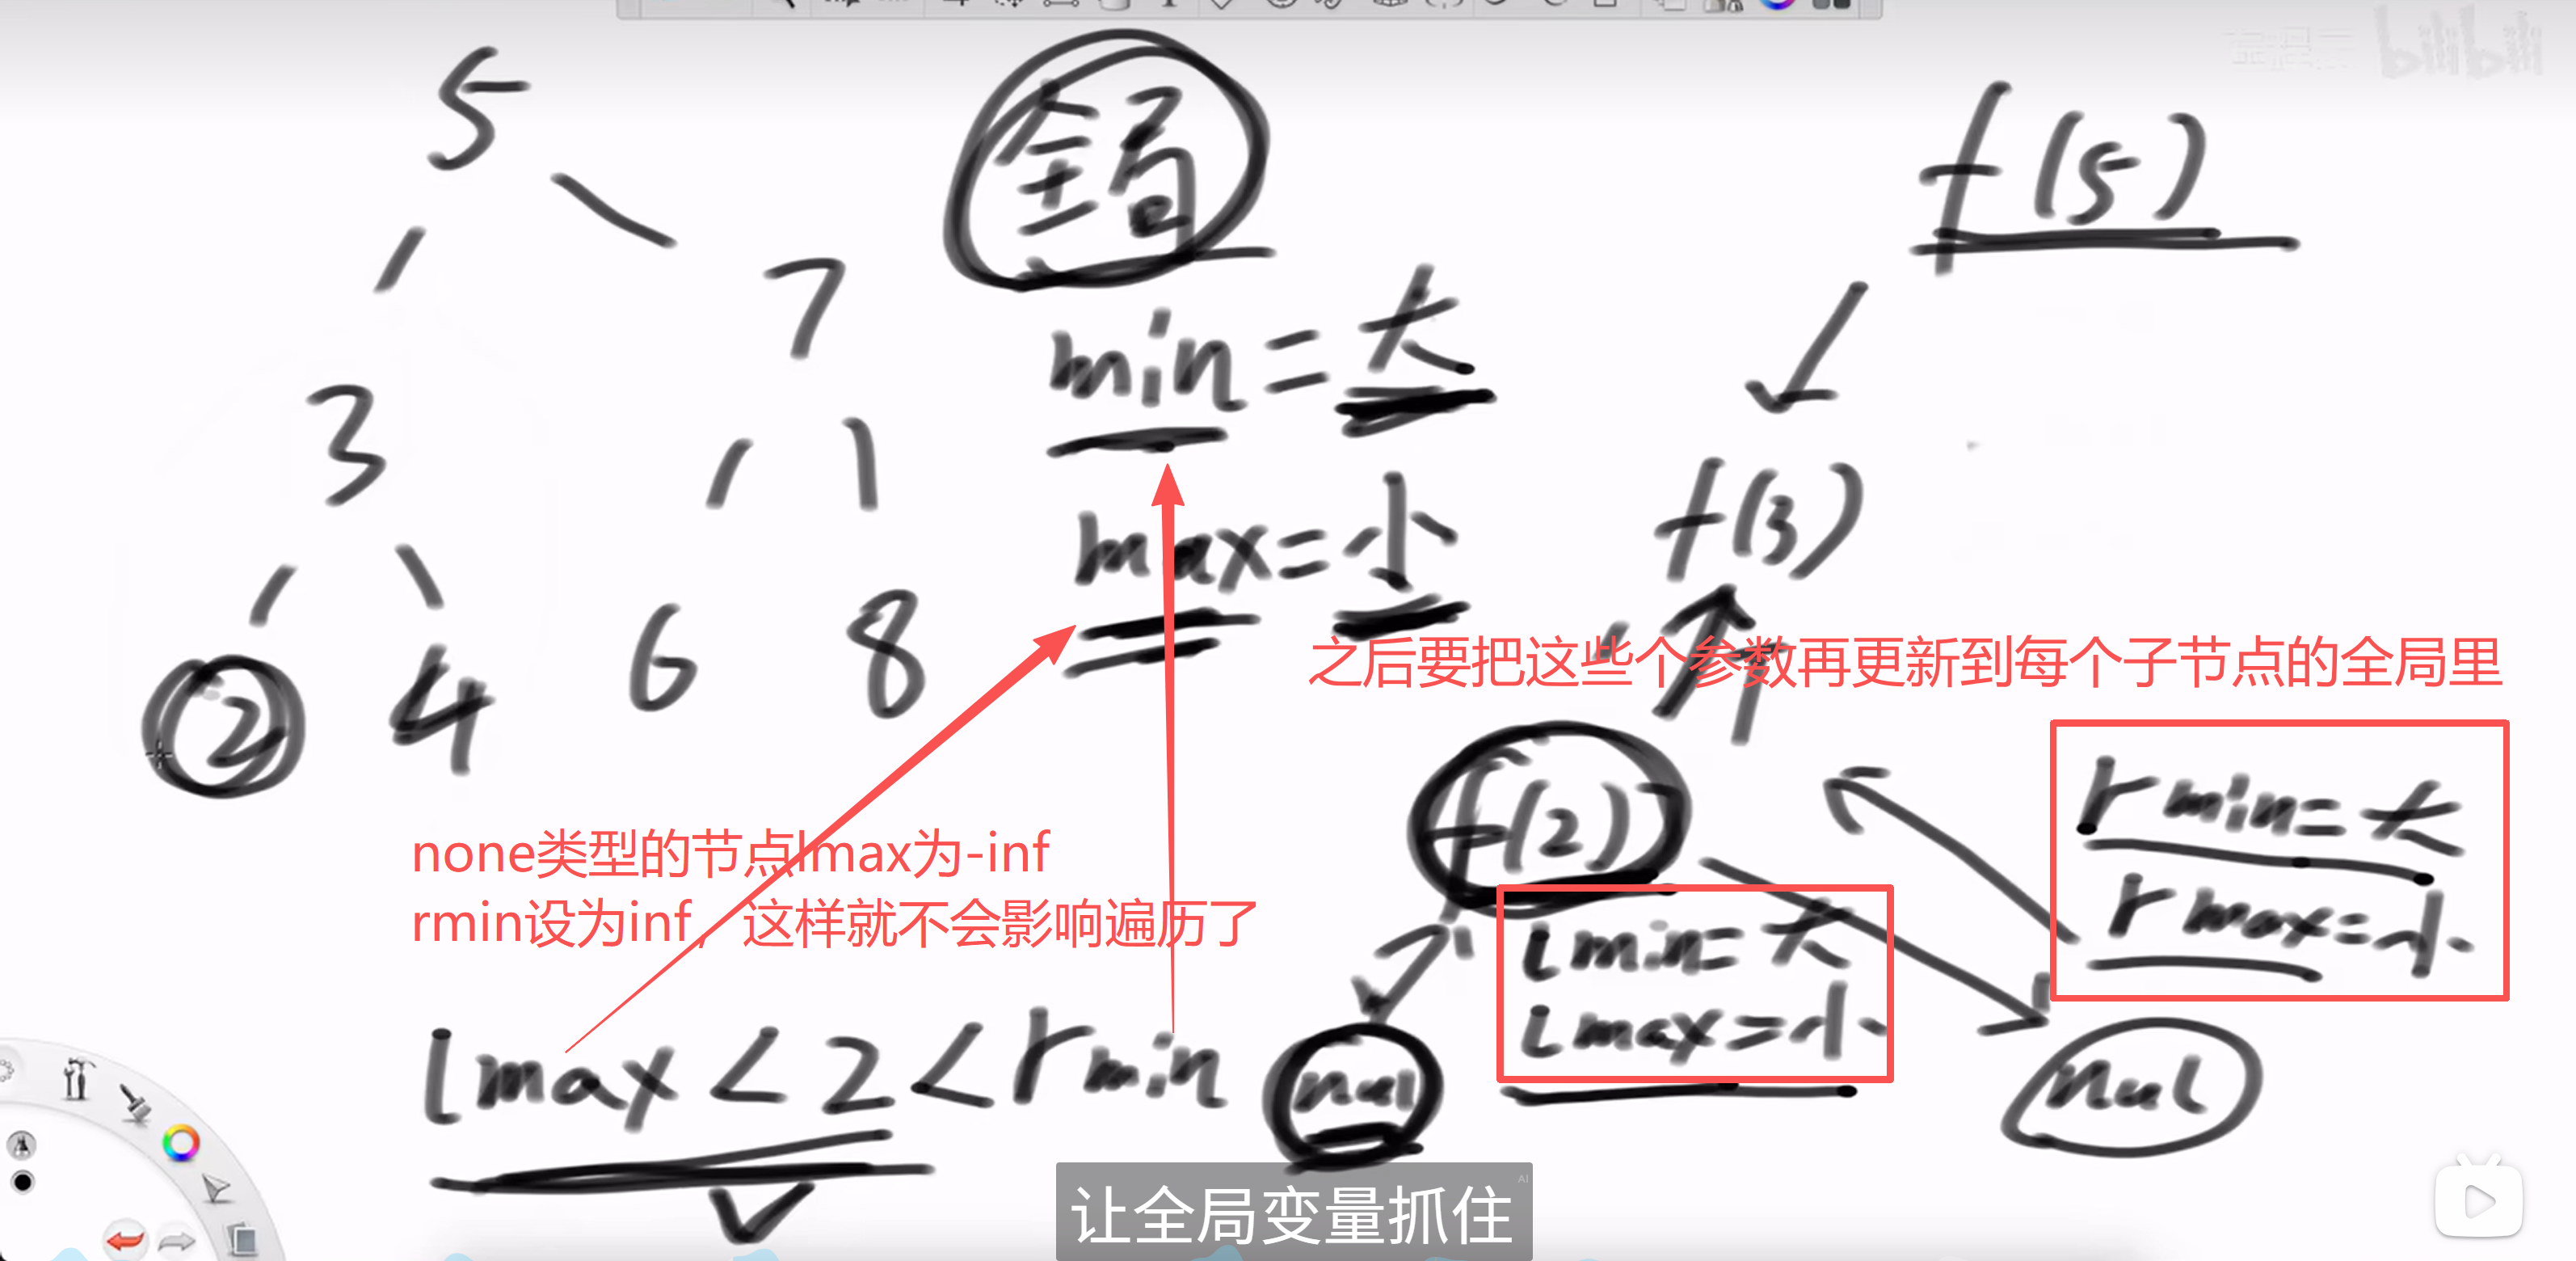
判断搜索二叉树方法2

核心思想

有两种实现方法:

方法一:中序遍历

一个有效的BST,其中序遍历的结果必然是一个严格递增的序列。

方法二:递归验证

对任意一个节点,它必须满足:

  1. 它的左子树是BST,且左子树所有节点的值都小于它自身的值
  2. 它的右子树是BST,且右子树所有节点的值都大于它自身的值

算法实现

方法一:迭代实现的中序遍历

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
def isValidBST1(self, head: Optional[TreeNode]) -> bool:
"""
通过迭代方式进行中序遍历来验证BST。
核心思想:
一个有效的BST,其中序遍历的结果必然是一个严格递增的序列。
因此,我们可以在遍历过程中,持续比较当前节点的值和前一个节点的值。
如果发现当前节点值小于或等于前一个节点值,那么它就不是一个BST。
"""
if not head:
return True

stack = []
pre_node = None

# 使用cur指针和栈来模拟递归的中序遍历
cur = head
while stack or cur:
if cur:
# 一直向左,将路径上的节点入栈
stack.append(cur)
cur = cur.left
else:
# 左边到头了,从栈中弹出一个节点,这个就是中序遍历的当前节点
cur = stack.pop()

# 检查中序遍历的有序性,pre_node是当前节点的前一个节点
if pre_node is not None and pre_node.val >= cur.val:
return False

# 更新前一个节点,然后转向右子树
pre_node = cur
cur = cur.right

return True

方法二:递归实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
def __init__(self):
# 实例变量,用于在递归调用中传递子树的最小值和最大值
self.min_val = float('inf')
self.max_val = float('-inf')

def isValidBST2(self, head: Optional[TreeNode]) -> bool:
"""
通过递归方式验证BST。
核心思想:
对任意一个节点,它必须满足:
1. 它的左子树是BST,且左子树所有节点的值都小于它自身的值。
2. 它的右子树是BST,且右子树所有节点的值都大于它自身的值。
这个过程可以通过后序遍历,在返回时收集子树的信息(是否为BST,最大值,最小值)来完成。
"""
# Base case是 head is None,即空树的情况,
if head is None:
# 基准情况:空树是有效的BST
# 初始化min和max,确保不影响上层计算
self.min_val = float('inf')
self.max_val = float('-inf')
return True

# 递归检查左子树是不是有效的BST
is_left_ok = self.isValidBST2(head.left)
l_min = self.min_val # 保存左子树的最小值
l_max = self.max_val # 保存左子树的最大值

# 递归检查右子树是不是有效的BST
is_right_ok = self.isValidBST2(head.right)
r_min = self.min_val
r_max = self.max_val

# 更新当前树的min和max值
self.min_val = min(l_min, r_min, head.val)
self.max_val = max(l_max, r_max, head.val)

# 综合判断当前节点是否满足BST的条件
# 1. 左右子树本身都是BST (is_left_ok and is_right_ok)
# 2. 左子树的最大值必须小于当前节点值 (l_max < head.val)
# 3. 右子树的最小值必须大于当前节点值 (head.val < r_min)
return is_left_ok and is_right_ok and l_max < head.val and head.val < r_min

算法分析

  • 时间复杂度:O(N),每个节点访问一次
  • 空间复杂度:O(H),H为树的高度
  • 核心技巧:中序遍历有序性 / 递归验证BST性质

题目六:修剪搜索二叉树

问题描述

给你二叉搜索树的根节点 root ,同时给定最小边界 low 和最大边界 high。通过修剪二叉搜索树,使得所有节点的值在 [low, high] 中。

测试链接:https://leetcode.cn/problems/trim-a-binary-search-tree/

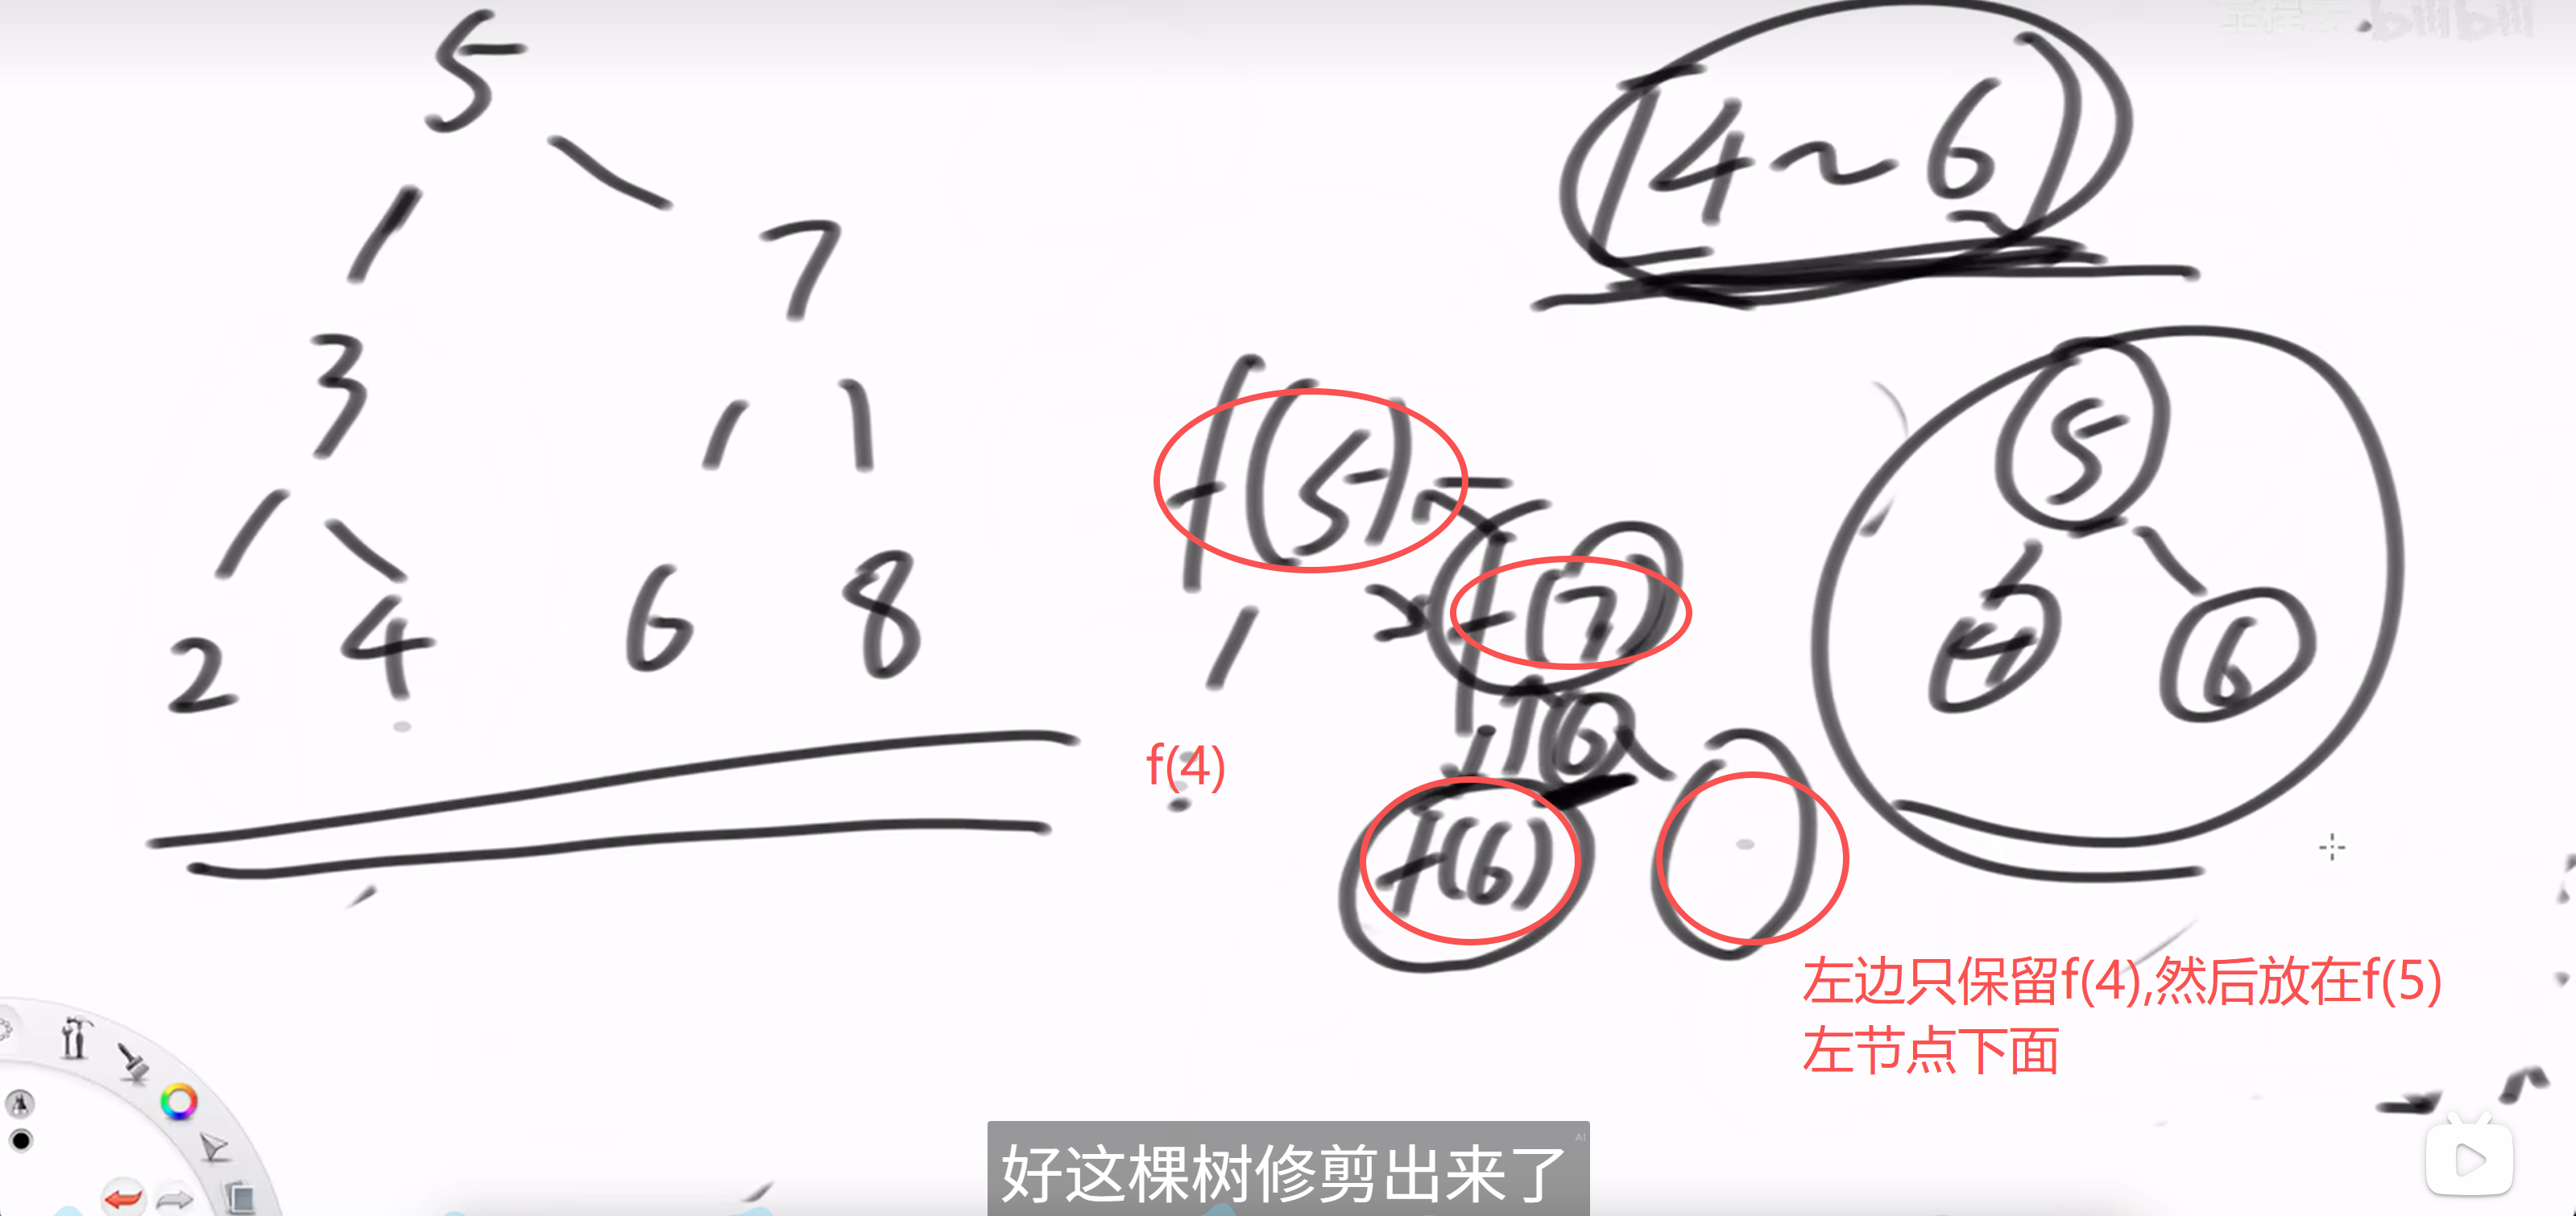
修剪搜索二叉树

核心思想

利用BST的性质进行递归:

  1. 如果 cur.val < low,那么 cur 和它的整个左子树都应该被删除,修剪后的树必定在右子树中
  2. 如果 cur.val > high,那么 cur 和它的整个右子树都应该被删除,修剪后的树必定在左子树中
  3. 如果 low <= cur.val <= high,那么当前节点应该被保留,继续递归地修剪左右子树

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
from typing import Optional

class Solution:
def trimBST(self, cur: Optional[TreeNode], low: int, high: int) -> Optional[TreeNode]:
"""
递归地修剪二叉搜索树。
核心思想:
利用BST的性质进行递归。对于当前节点 `cur`:
1. 如果 `cur.val < low`,那么 `cur` 和它的整个左子树都应该被删除。
修剪后的树必定在 `cur` 的右子树中,因此我们返回对右子树的修剪结果。
2. 如果 `cur.val > high`,那么 `cur` 和它的整个右子树都应该被删除。
修剪后的树必定在 `cur` 的左子树中,因此我们返回对左子树的修剪结果。
3. 如果 `low <= cur.val <= high`,那么 `cur` 节点应该被保留。
我们继续递归地修剪它的左子树和右子树,并将返回的结果作为 `cur` 新的左、右孩子。
最后返回 `cur` 本身。
"""
# base case是 cur is None,即空树的情况,返回None
if cur is None:
return None

# 当前节点值太小,应该在右子树中寻找有效部分
if cur.val < low:
return self.trimBST(cur.right, low, high)

# 当前节点值太大,应该在左子树中寻找有效部分
if cur.val > high:
return self.trimBST(cur.left, low, high)

# 当前节点在 [low, high] 范围内,保留该节点
# 然后递归地处理它的左子树和右子树
cur.left = self.trimBST(cur.left, low, high)
cur.right = self.trimBST(cur.right, low, high)

# 返回处理后的当前节点
return cur

算法分析

  • 时间复杂度:O(N),最坏情况下访问所有节点
  • 空间复杂度:O(H),H为树的高度
  • 核心技巧:利用BST性质 + 递归修剪

题目七:二叉树打家劫舍问题

问题描述

在上次打劫完一条街道之后和一圈房屋后,小偷又发现了一个新的可行窃的地区。这个地区只有一个入口,我们称之为”根”。除了”根”之外,每栋房子有且只有一个”父”房子与之相连。一番侦察之后,聪明的小偷意识到”这个地方的所有房屋的排列类似于一棵二叉树”。如果两个直接相连的房子在同一天晚上被打劫,房屋将自动报警。计算在不触动警报的前提下,小偷一晚能够盗取的最高金额。

测试链接:https://leetcode.cn/problems/house-robber-iii/

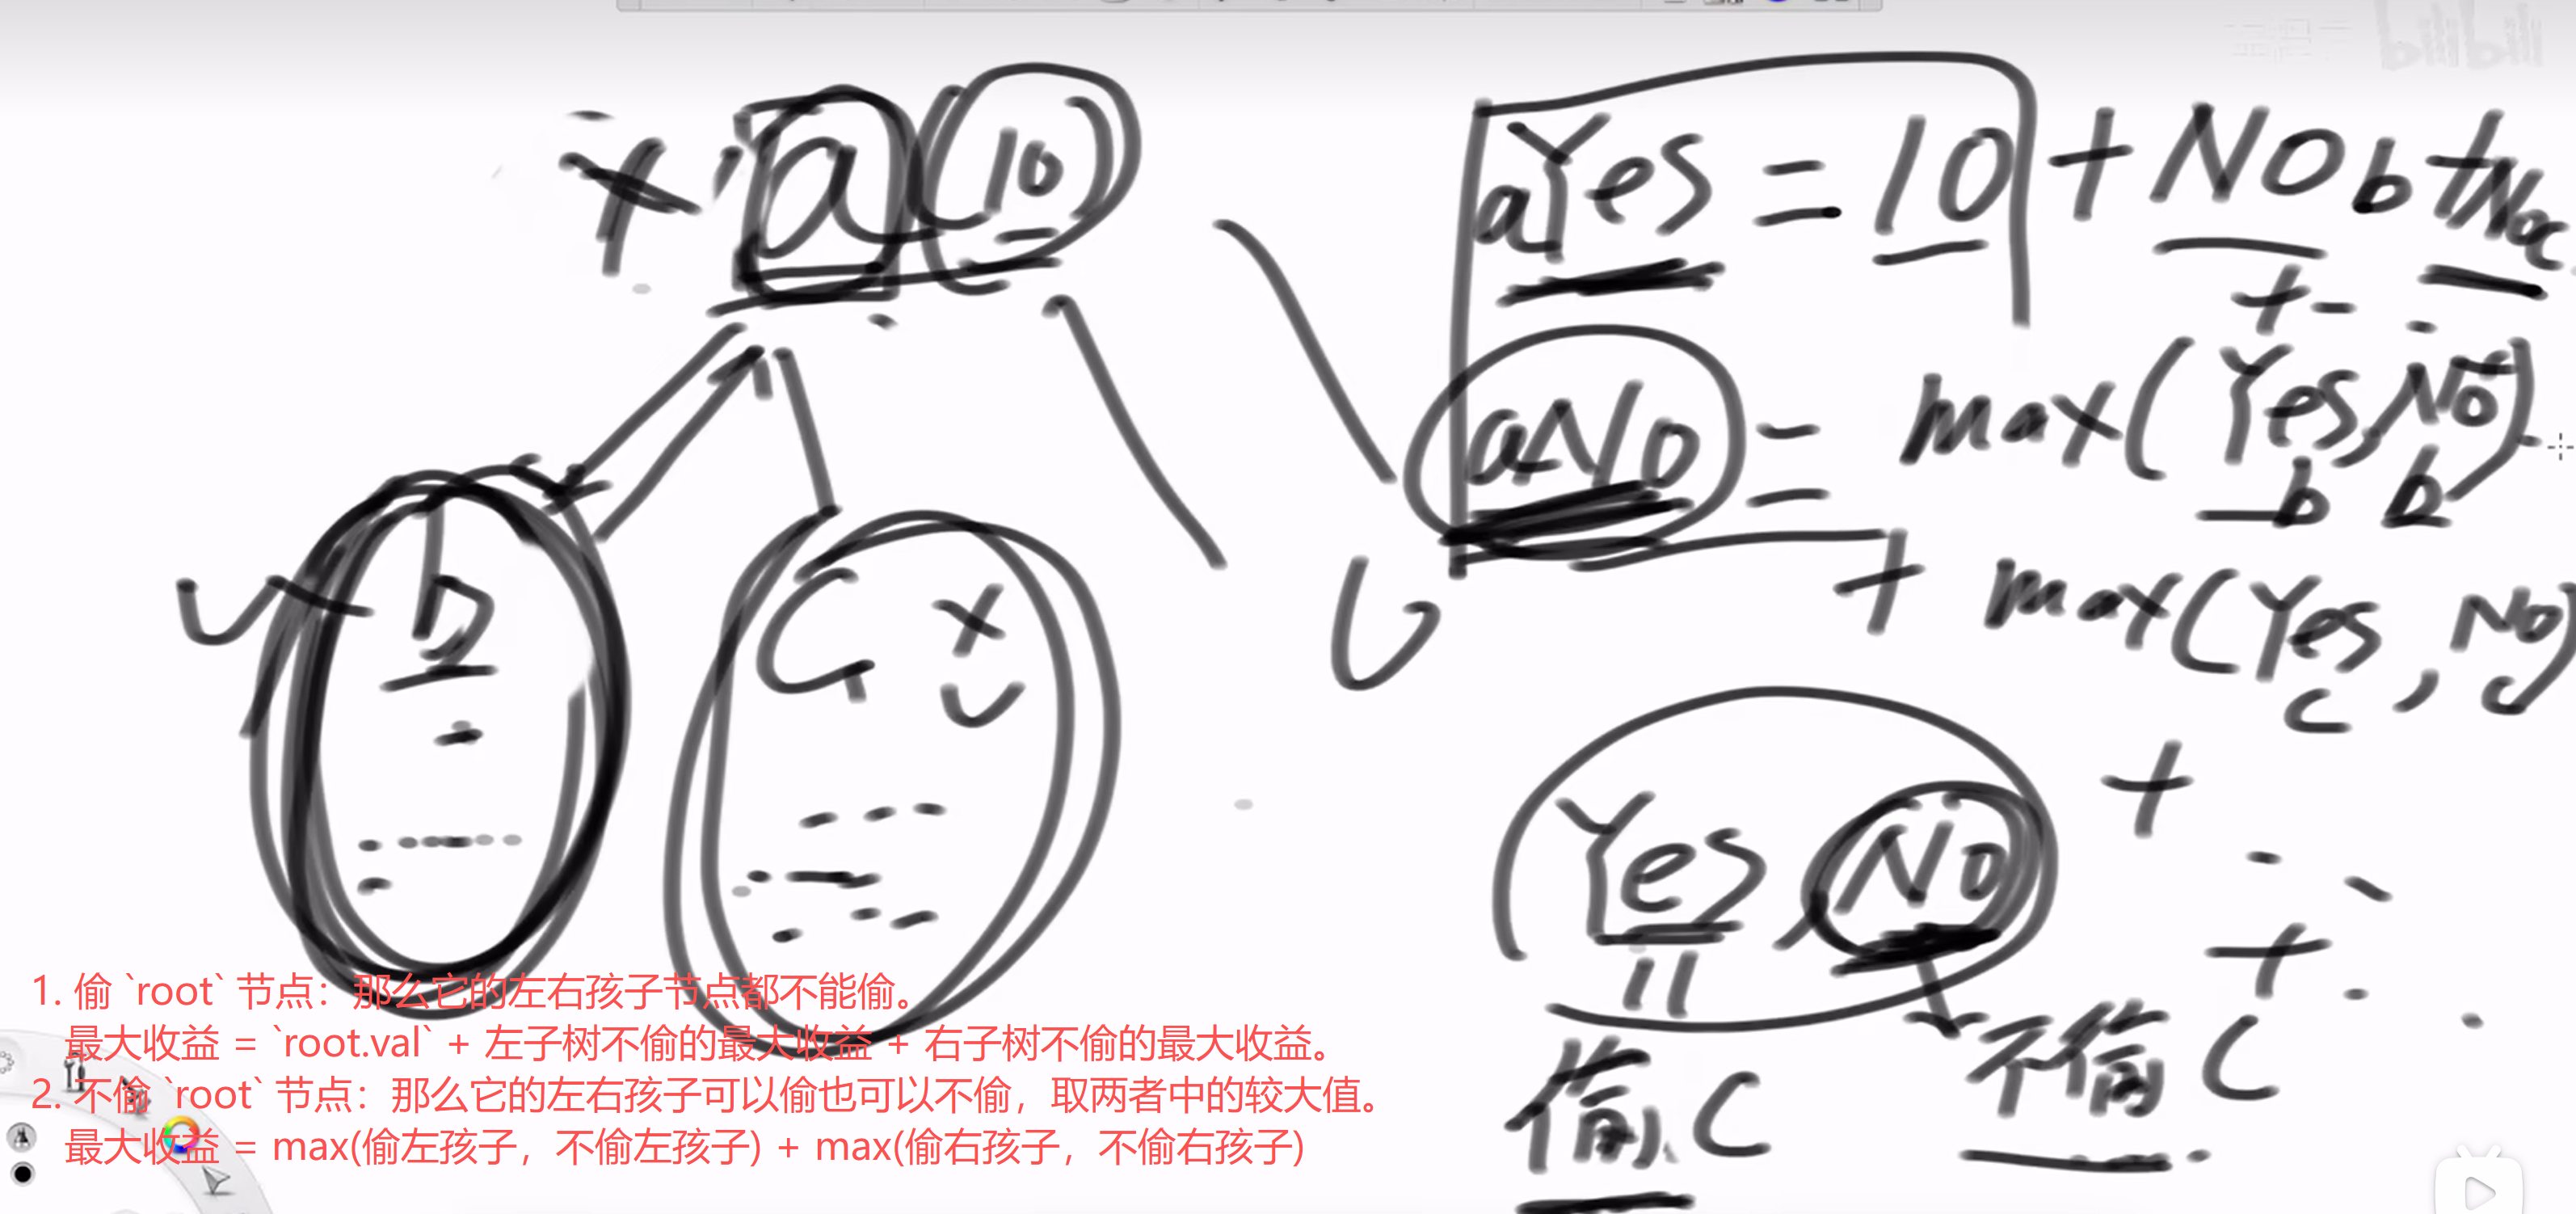
打家劫舍问题

核心思想

树形DP问题。对于任意一个节点,我们考虑两种情况:

  1. 偷当前节点:那么它的左右孩子节点都不能偷
  2. 不偷当前节点:那么它的左右孩子可以偷也可以不偷,取两者中的较大值

通过后序遍历,我们可以先计算出左右子树的结果,再用来推导当前节点的结果。

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
from typing import Optional

class Solution:
def __init__(self):
# 实例变量,用于在递归中保存子问题的解
# yes: 表示在X子树中,偷头节点的情况下能获得的最大收益
# no: 表示在X子树中,不偷头节点的情况下能获得的最大收益
self.yes = 0
self.no = 0

def rob(self, root: Optional[TreeNode]) -> int:
"""
主函数,启动递归计算
"""
self.f(root)
return max(self.yes, self.no)

def f(self, root: Optional[TreeNode]):
"""
递归函数,采用后序遍历计算以root为根的子树的打劫收益
核心思想 (树形DP):
对于任意一个节点 `root`,我们考虑两种情况:
1. 偷 `root` 节点:那么它的左右孩子节点都不能偷。
最大收益 = `root.val` + 左子树不偷的最大收益 + 右子树不偷的最大收益。
2. 不偷 `root` 节点:那么它的左右孩子可以偷也可以不偷,取两者中的较大值。
最大收益 = max(偷左孩子,不偷左孩子) + max(偷右孩子,不偷右孩子)。

通过后序遍历,我们可以先计算出左右子树的结果,再用来推导当前节点的结果。
"""
if root is None:
# 基准情况:空节点收益为0
self.yes = 0
self.no = 0
return

# 暂存当前节点的收益
current_yes = root.val
current_no = 0

# 先递归处理左子树,再处理右子树
self.f(root.left)
# 此时 self.yes 和 self.no 是左子树的结果

# 更新当前节点的收益:
# 如果偷当前节点,则不能偷左孩子,所以加上左子树不偷的收益 no
current_yes += self.no
# 如果不偷当前节点,则左孩子可偷可不偷,取最大值
current_no += max(self.yes, self.no)

# 递归处理右子树
self.f(root.right)
# 此时 self.yes 和 self.no 是右子树的结果

# 再次更新当前节点的收益:
# 加上右子树的贡献
current_yes += self.no
current_no += max(self.yes, self.no)

# 将最终计算出的当前节点的结果,存回实例变量,供上层调用使用
self.yes = current_yes
self.no = current_no

算法分析

  • 时间复杂度:O(N),每个节点访问一次
  • 空间复杂度:O(H),H为树的高度
  • 核心技巧:树形DP + 后序遍历

核心技巧总结

1. LCA问题模板

1
2
3
4
5
6
7
8
9
10
def lowestCommonAncestor(self, root, p, q):
if not root or root == p or root == q:
return root

left = self.lowestCommonAncestor(root.left, p, q)
right = self.lowestCommonAncestor(root.right, p, q)

if left and right:
return root
return left if left else right

2. 路径搜索 + 回溯模板

1
2
3
4
5
6
7
8
9
10
11
def dfs(node, path, target):
path.append(node.val) # 选择

if is_leaf(node):
if meets_condition():
result.append(path[:]) # 记录答案
else:
dfs(node.left, path, target) # 递归
dfs(node.right, path, target) # 递归

path.pop() # 撤销选择(回溯)

3. BST性质利用

1
2
3
# BST中序遍历是有序的
# BST搜索可以利用大小关系剪枝
# BST的LCA在分叉点

4. 树形DP模板

1
2
3
4
5
6
7
8
9
10
11
12
def tree_dp(node):
if not node:
return base_case

# 后序遍历:先处理子树
left_result = tree_dp(node.left)
right_result = tree_dp(node.right)

# 根据子树结果计算当前节点结果
current_result = combine(node.val, left_result, right_result)

return current_result

复杂度分析总结

题目 时间复杂度 空间复杂度 核心算法
普通二叉树LCA O(N) O(H) 递归DFS
BST的LCA O(H) O(1) 利用BST性质
路径和问题 O(N²) O(H) DFS + 回溯
验证平衡二叉树 O(N) O(H) 后序遍历
验证BST O(N) O(H) 中序遍历/递归
修剪BST O(N) O(H) 递归修剪
打家劫舍III O(N) O(H) 树形DP

学习建议

  1. 掌握LCA问题:这是树算法中的经典问题,有多种解法和应用

  2. 理解BST性质:

    • 中序遍历有序
    • 可以利用大小关系进行搜索优化
    • 左子树 < 根 < 右子树
  3. 掌握回溯模板:

    • 做选择 → 递归 → 撤销选择
    • 注意保存结果时要使用副本
  4. 理解树形DP:

    • 后序遍历获取子树信息
    • 根据子树状态计算当前状态
    • 状态定义要考虑所有可能情况
  5. 注意边界条件:

    • 空节点处理
    • 叶子节点判断
    • 单节点情况
  6. 练习状态管理:

    • 实例变量在递归中的使用
    • 多个状态的传递和更新

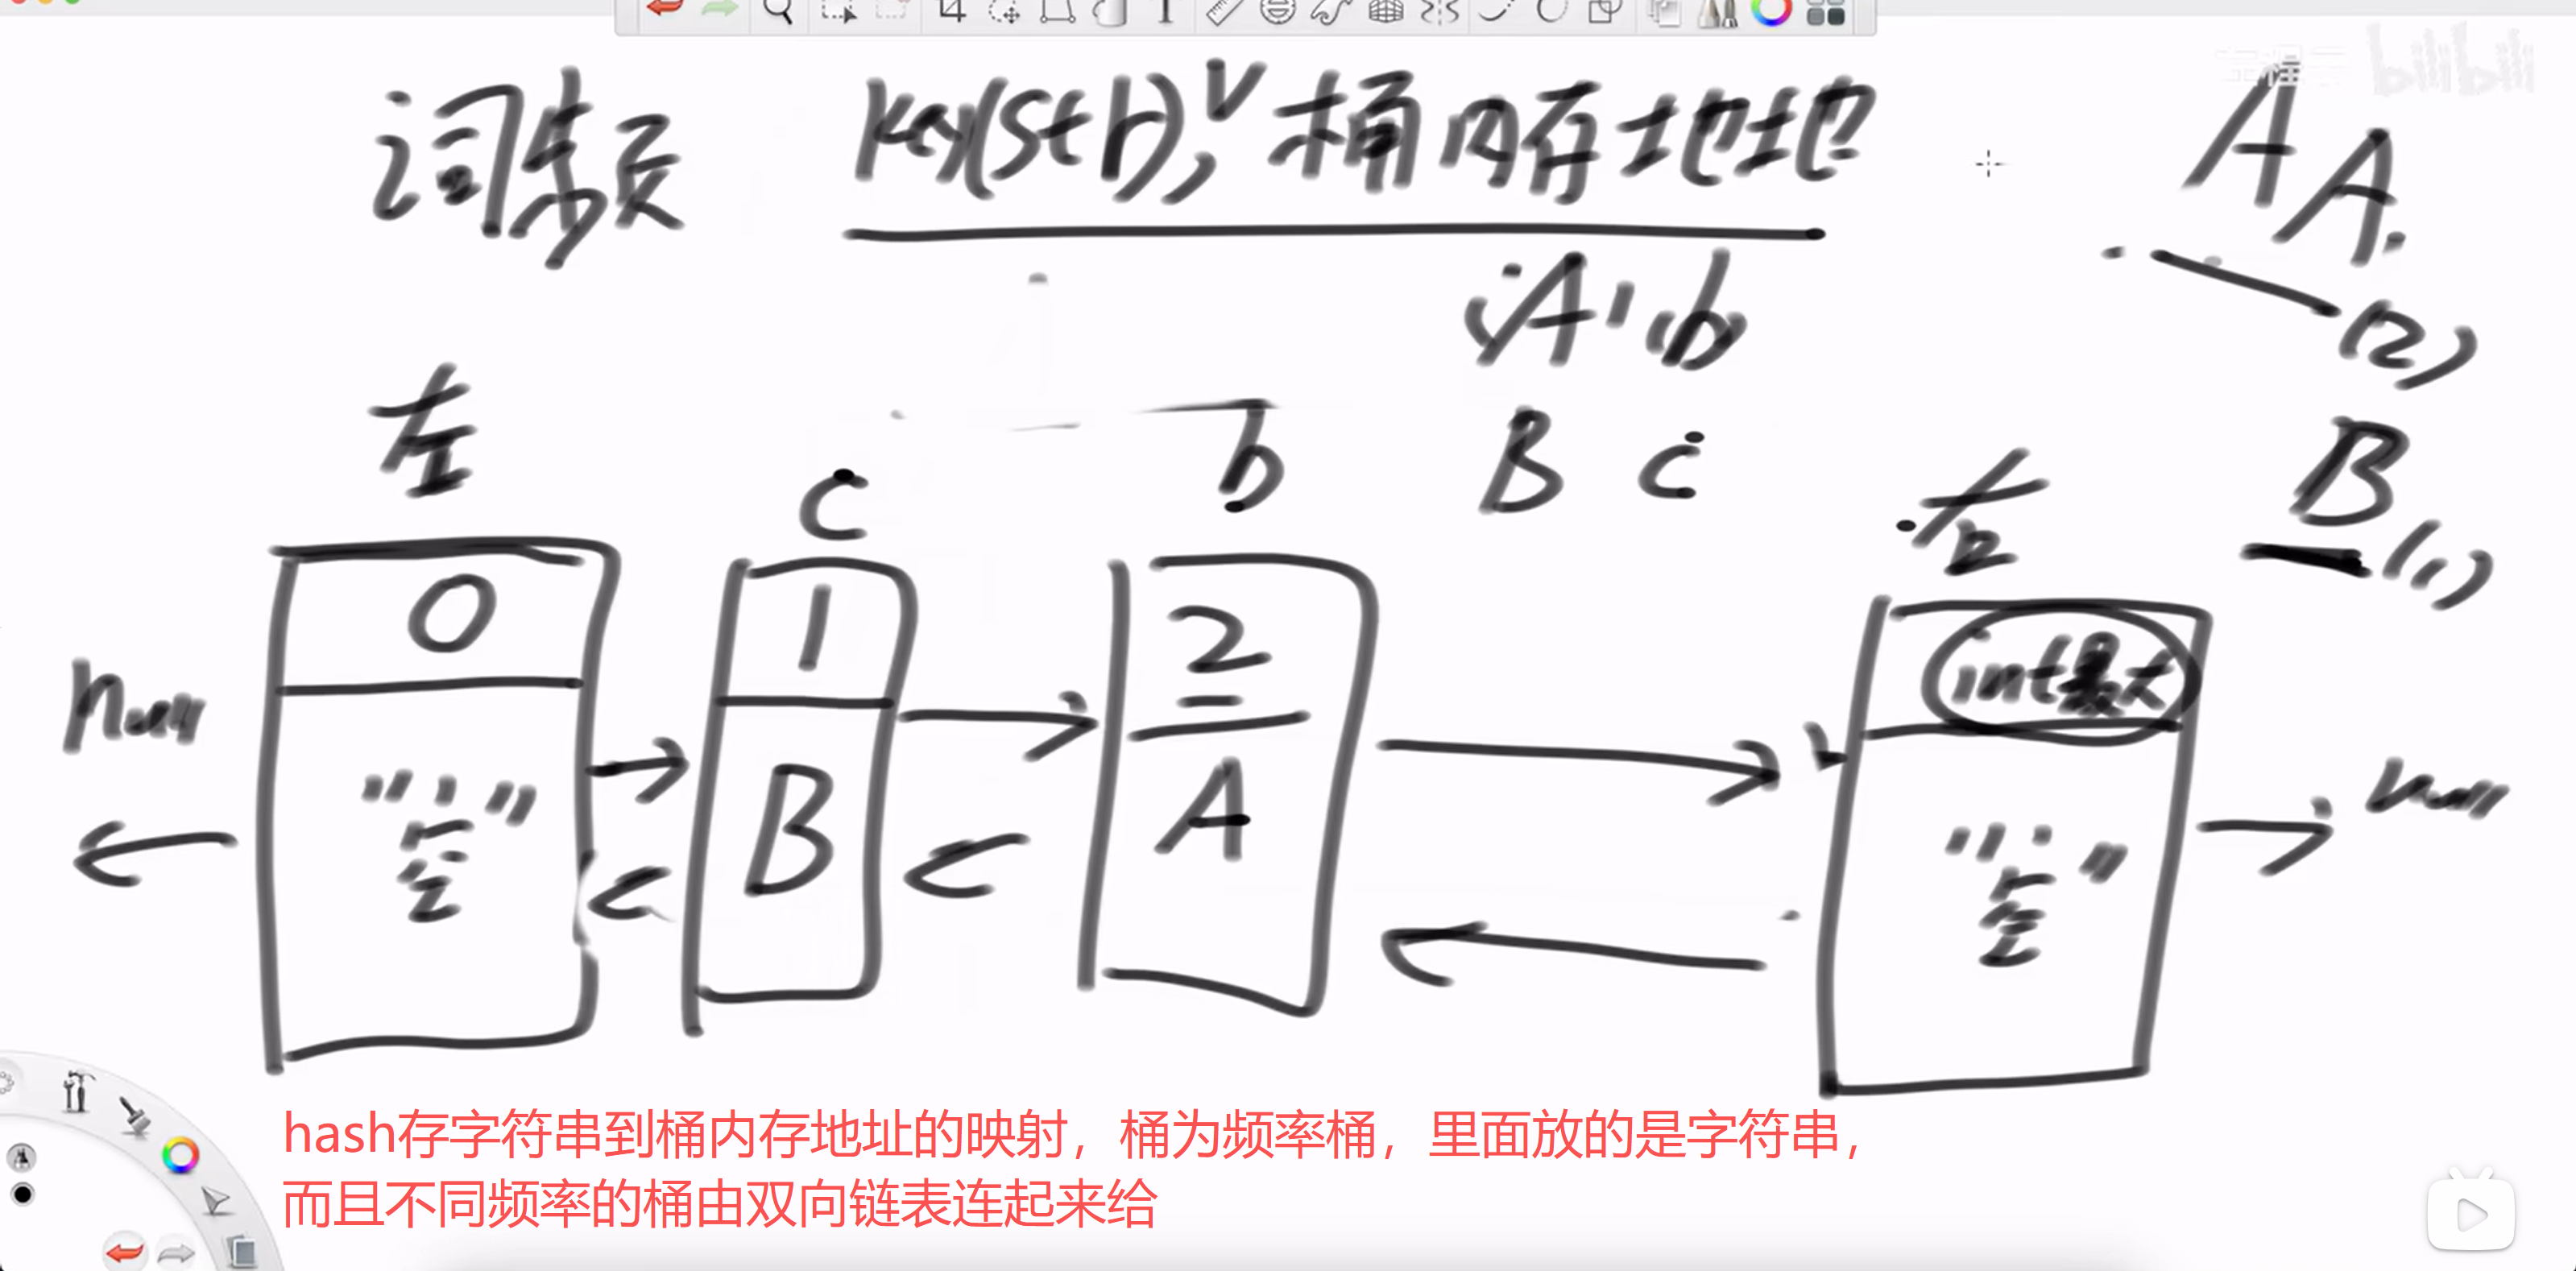
通过掌握这些经典的二叉树问题,可以深入理解树的递归性质,为学习更高级的树算法和动态规划打下基础。这些问题模式在实际编程中经常出现,是算法面试的重点内容。

引言

参照的是左程云的课程:https://space.bilibili.com/8888480/lists/3509640?type=series

本笔记是class035的内容,总结了数据结构设计类题目的高频考点,包含7道经典数据结构设计题目的详细解析。这些题目主要基于哈希表的O(1)操作时间复杂度特性。

前置知识

在学习数据结构设计高频题之前,需要掌握以下基础知识:

  • 动态数组和扩容分析(007讲)
  • 链表入门内容(009~012讲)
  • 堆结构(025讲)
  • 哈希表、有序表、比较器的使用(026讲)

重要说明

本节以数据结构设计高频题为主,并不涉及太难的数据结构设计题目,很多题的原理都是基于哈希表的O(1)时间复杂度。数据结构设计的更难题目,需要学习更多数据结构之后才能解决,如前缀树、并查集、线段树等。

035【必备】数据结构设计高频题

题目一:setAll功能的哈希表

问题描述

哈希表常见的三个操作是put、get和containsKey,而且这三个操作的时间复杂度为O(1)。现在想加一个setAll功能,就是把所有记录value都设成统一的值。请设计并实现这种有setAll功能的哈希表,并且put、get、containsKey和setAll四个操作的时间复杂度都为O(1)。

测试链接:https://www.nowcoder.com/practice/7c4559f138e74ceb9ba57d76fd169967

核心思想

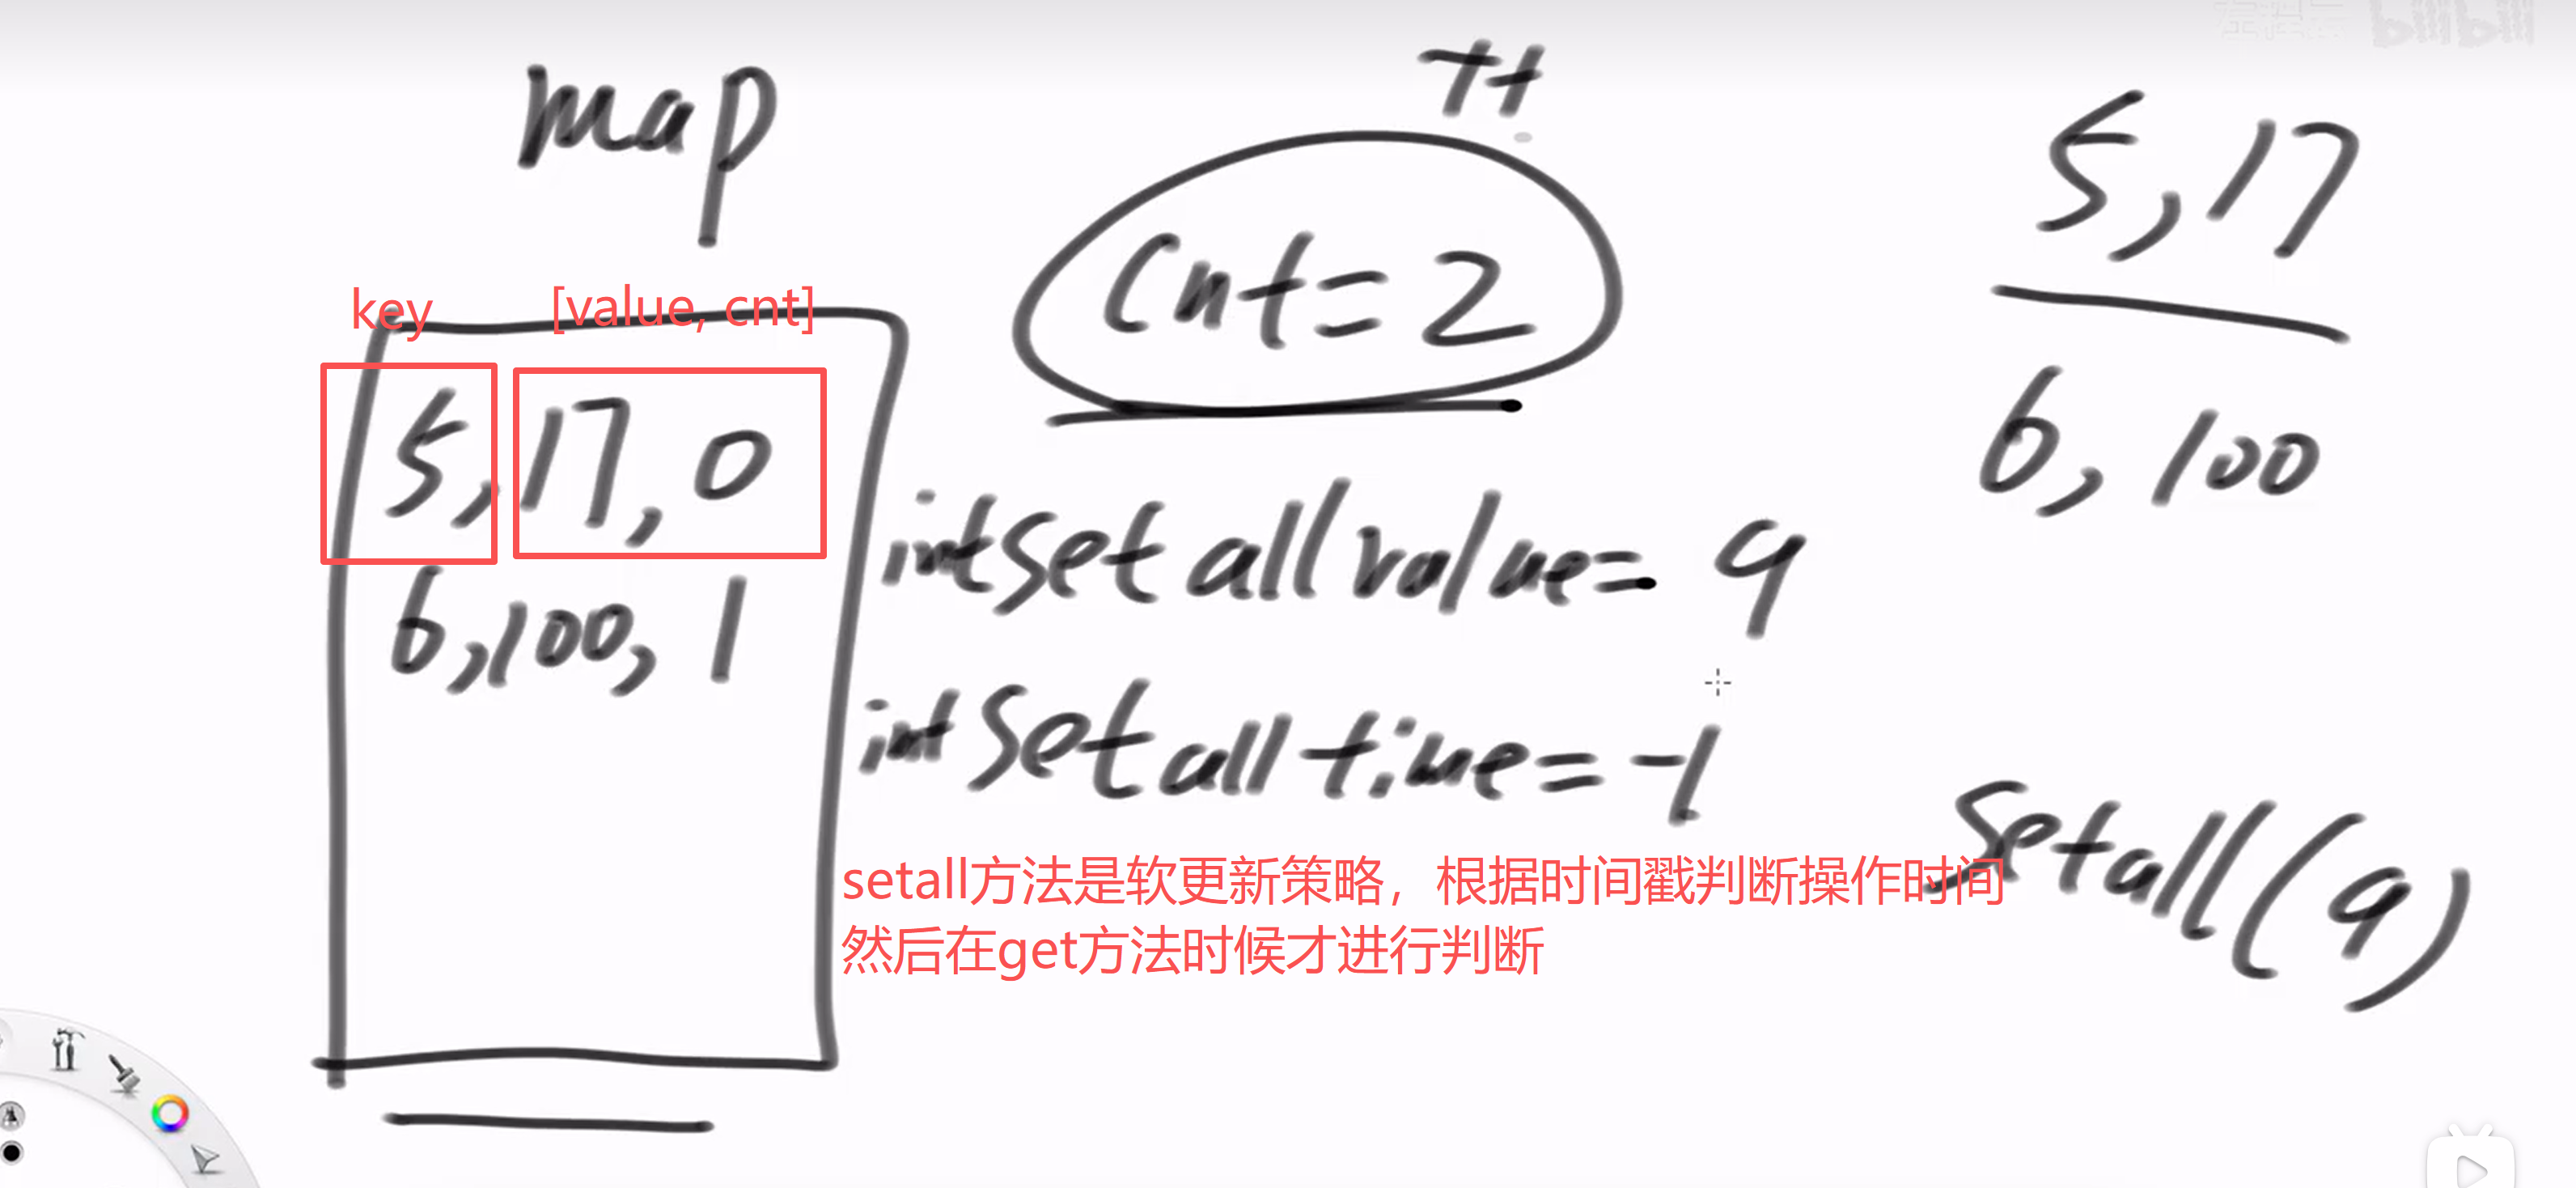
采用”懒更新”(Lazy Update)策略,setAll操作只记录一个全局值和当前时间戳,并不实际修改数据。当get一个键时,通过比较该键自身的时间戳和全局setAll的时间戳,来实时决定返回它自己的值还是全局的值。

为hash表设置setall方法

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
class SetAllHashMap:
def __init__(self):
# 核心数据结构,存储键和它对应的值与时间戳
# 格式为: { key: [value, time] }
self.map = {}
# setAll操作设定的统一值
self.set_all_value = 0
# setAll操作发生的时间戳
self.set_all_time = -1
# 全局时间戳,用于记录每次操作的顺序
self.cnt = 0

def put(self, k, v):
# 核心思想:为每个put操作记录一个独立的时间戳
if k in self.map:
# 如果键已存在,更新其值和时间戳
value = self.map[k]
value[0] = v
value[1] = self.cnt
self.cnt += 1
else:
# 如果键不存在,创建新的条目
self.map[k] = [v, self.cnt]
self.cnt += 1

def set_all(self, v):
# 核心思想:只记录setAll的值和时间戳,不实际遍历map
# 这是一个懒更新策略,只有在get的时候才根据时间戳判断
self.set_all_value = v
self.set_all_time = self.cnt
self.cnt += 1

def get(self, k):
# 核心思想:比较单个key的更新时间和全局setAll的更新时间
if k not in self.map:
return -1

value = self.map[k]
# 如果这个key的最后更新时间晚于setAll的时间,说明它的值是有效的
if value[1] > self.set_all_time:
return value[0]
# 否则,它的值已经被setAll覆盖了,应返回setAll的值
else:
return self.set_all_value

高效读写

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
def main():
# 创建一个SetAllHashMap对象,模拟带有setAll操作的哈希表,模拟牛客网的输入输出处理
solution = SetAllHashMap()
# 读取所有输入行(提高输入效率)
lines = sys.stdin.readlines()
i = 0
while i < len(lines): # 遍历所有行
line = lines[i].strip()
if not line:
# 跳过空行
i += 1
continue

# 读取本组操作数n
n = int(line)
# 每个测试用例开始前重置数据结构
solution.__init__()

# 连续读取n行操作
for j in range(n):
i += 1
# 解析当前操作的所有参数,map是把字符串转换成列表,int指明了列表的元素类型
parts = list(map(int, lines[i].strip().split()))
op = parts[0]
if op == 1:
# op=1,put操作,后面有两个参数a, b
a, b = parts[1], parts[2]
solution.put(a, b)
elif op == 2:
# op=2,get操作,后面一个参数a
a = parts[1]
print(solution.get(a))
else:
# op=3,setAll操作,后面一个参数a
a = parts[1]
solution.set_all(a)
# 处理完一组数据,i+1进入下一组或结束
i += 1

if __name__ == "__main__":
# 在提交时,类名需要改为 Main
main()

算法分析

  • 时间复杂度:所有操作都是O(1)
  • 空间复杂度:O(N),N为键的数量
  • 核心技巧:时间戳比较 + 懒更新策略

题目二:实现LRU结构

问题描述

实现 LRUCache 类:

  • LRUCache(int capacity) 以正整数作为容量capacity初始化LRU缓存
  • int get(int key) 如果关键字key存在于缓存中,则返回关键字的值,否则返回-1
  • void put(int key, int value) 如果关键字key已经存在,则变更其数据值value;如果不存在,则向缓存中插入该组key-value。如果插入操作导致关键字数量超过capacity,则应该逐出最久未使用的关键字

函数get和put必须以O(1)的平均时间复杂度运行。

测试链接:https://leetcode.cn/problems/lru-cache/

核心思想

结合了哈希表和双向链表:哈希表提供了对任意键的O(1)快速访问,而双向链表则负责维护数据的访问顺序,使其能在O(1)时间内将最新访问的节点移到队尾,并在容量满时淘汰队首的最久未使用节点。

lru结构的实现

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
class LRUCache:
# 内部类,定义双向链表节点
class DoubleNode:
def __init__(self, key=0, val=0):
self.key = key
self.val = val
self.last = None
self.next = None

# 内部类,实现双向链表,用于维护节点的访问顺序
class DoubleList:
def __init__(self):
# 哨兵节点,简化边界条件处理
self.head = self.DoubleNode() #头节点
self.tail = self.DoubleNode() #尾节点
self.head.next = self.tail #头节点的下一个节点是尾节点
self.tail.last = self.head #尾节点的上一个节点是头节点

# 将一个节点添加到链表尾部(表示最近使用)
def add_node_to_tail(self, node):
node.next = self.tail # 将新节点添加到尾节点的前一个位置
node.last = self.tail.last # 将新节点的上一个节点设置为尾节点的前一个节点
self.tail.last.next = node # 将尾节点的前一个节点的下一个节点设置为新节点
self.tail.last = node # 将尾节点的前一个节点设置为新节点
# 这样设置是为了把尾节点和前一个节点的两条指针变成四条指针

# 将指定节点移动到链表尾部
def move_node_to_tail(self, node):
# 先将节点从原位置断开
node.last.next = node.next
node.next.last = node.last
# 再将节点添加到尾部
self.add_node_to_tail(node)

# 移除链表头部节点(最久未使用的节点)并返回
def remove_head(self):
# 如果链表为空(只有哨兵节点),则无法移除
if self.head.next == self.tail:
return None
node_to_remove = self.head.next
# 从链表中移除
node_to_remove.last.next = node_to_remove.next
node_to_remove.next.last = node_to_remove.last
return node_to_remove

def __init__(self, capacity: int):
# 核心思想:使用哈希表实现O(1)查找,使用双向链表实现O(1)的节点移动(更新访问顺序)
# 哈希表,存储 key -> DoubleNode 的映射
self.key_node_map = {}
# 双向链表实例,维护节点的LRU顺序
self.node_list = self.DoubleList()
# 缓存的容量
self.capacity = capacity

def get(self, key: int) -> int:
# 如果key存在
if key in self.key_node_map:
# 获取节点
node = self.key_node_map[key]
# 将该节点移动到链表尾部,表示最近被访问
self.node_list.move_node_to_tail(node)
return node.val
# 如果key不存在,返回-1
return -1

def put(self, key: int, value: int) -> None:
# 如果key已存在
if key in self.key_node_map:
# 更新节点的值
node = self.key_node_map[key]
node.val = value
# 将该节点移动到链表尾部
self.node_list.move_node_to_tail(node)
else:
# 如果缓存已满
if len(self.key_node_map) == self.capacity:
# 移除链表头部的最久未使用节点,之后会再把新节点添加到尾部
removed_node = self.node_list.remove_head()
# 从哈希表中删除对应的key
del self.key_node_map[removed_node.key]

# 创建新节点
new_node = self.DoubleNode(key, value)
# 存入哈希表
self.key_node_map[key] = new_node
# 将新节点添加到链表尾部
self.node_list.add_node_to_tail(new_node)

算法分析

  • 时间复杂度:get和put操作都是O(1)
  • 空间复杂度:O(capacity)
  • 核心技巧:哈希表 + 双向链表

题目三:插入、删除和获取随机元素O(1)时间的结构

问题描述

设计一个支持在平均时间复杂度O(1)下,执行以下操作的数据结构:

  • insert(val):当元素val不存在时,向集合中插入该项
  • remove(val):元素val存在时,从集合中移除该项
  • getRandom():随机返回现有集合中的一项

测试链接:https://leetcode.cn/problems/insert-delete-getrandom-o1/

核心思想

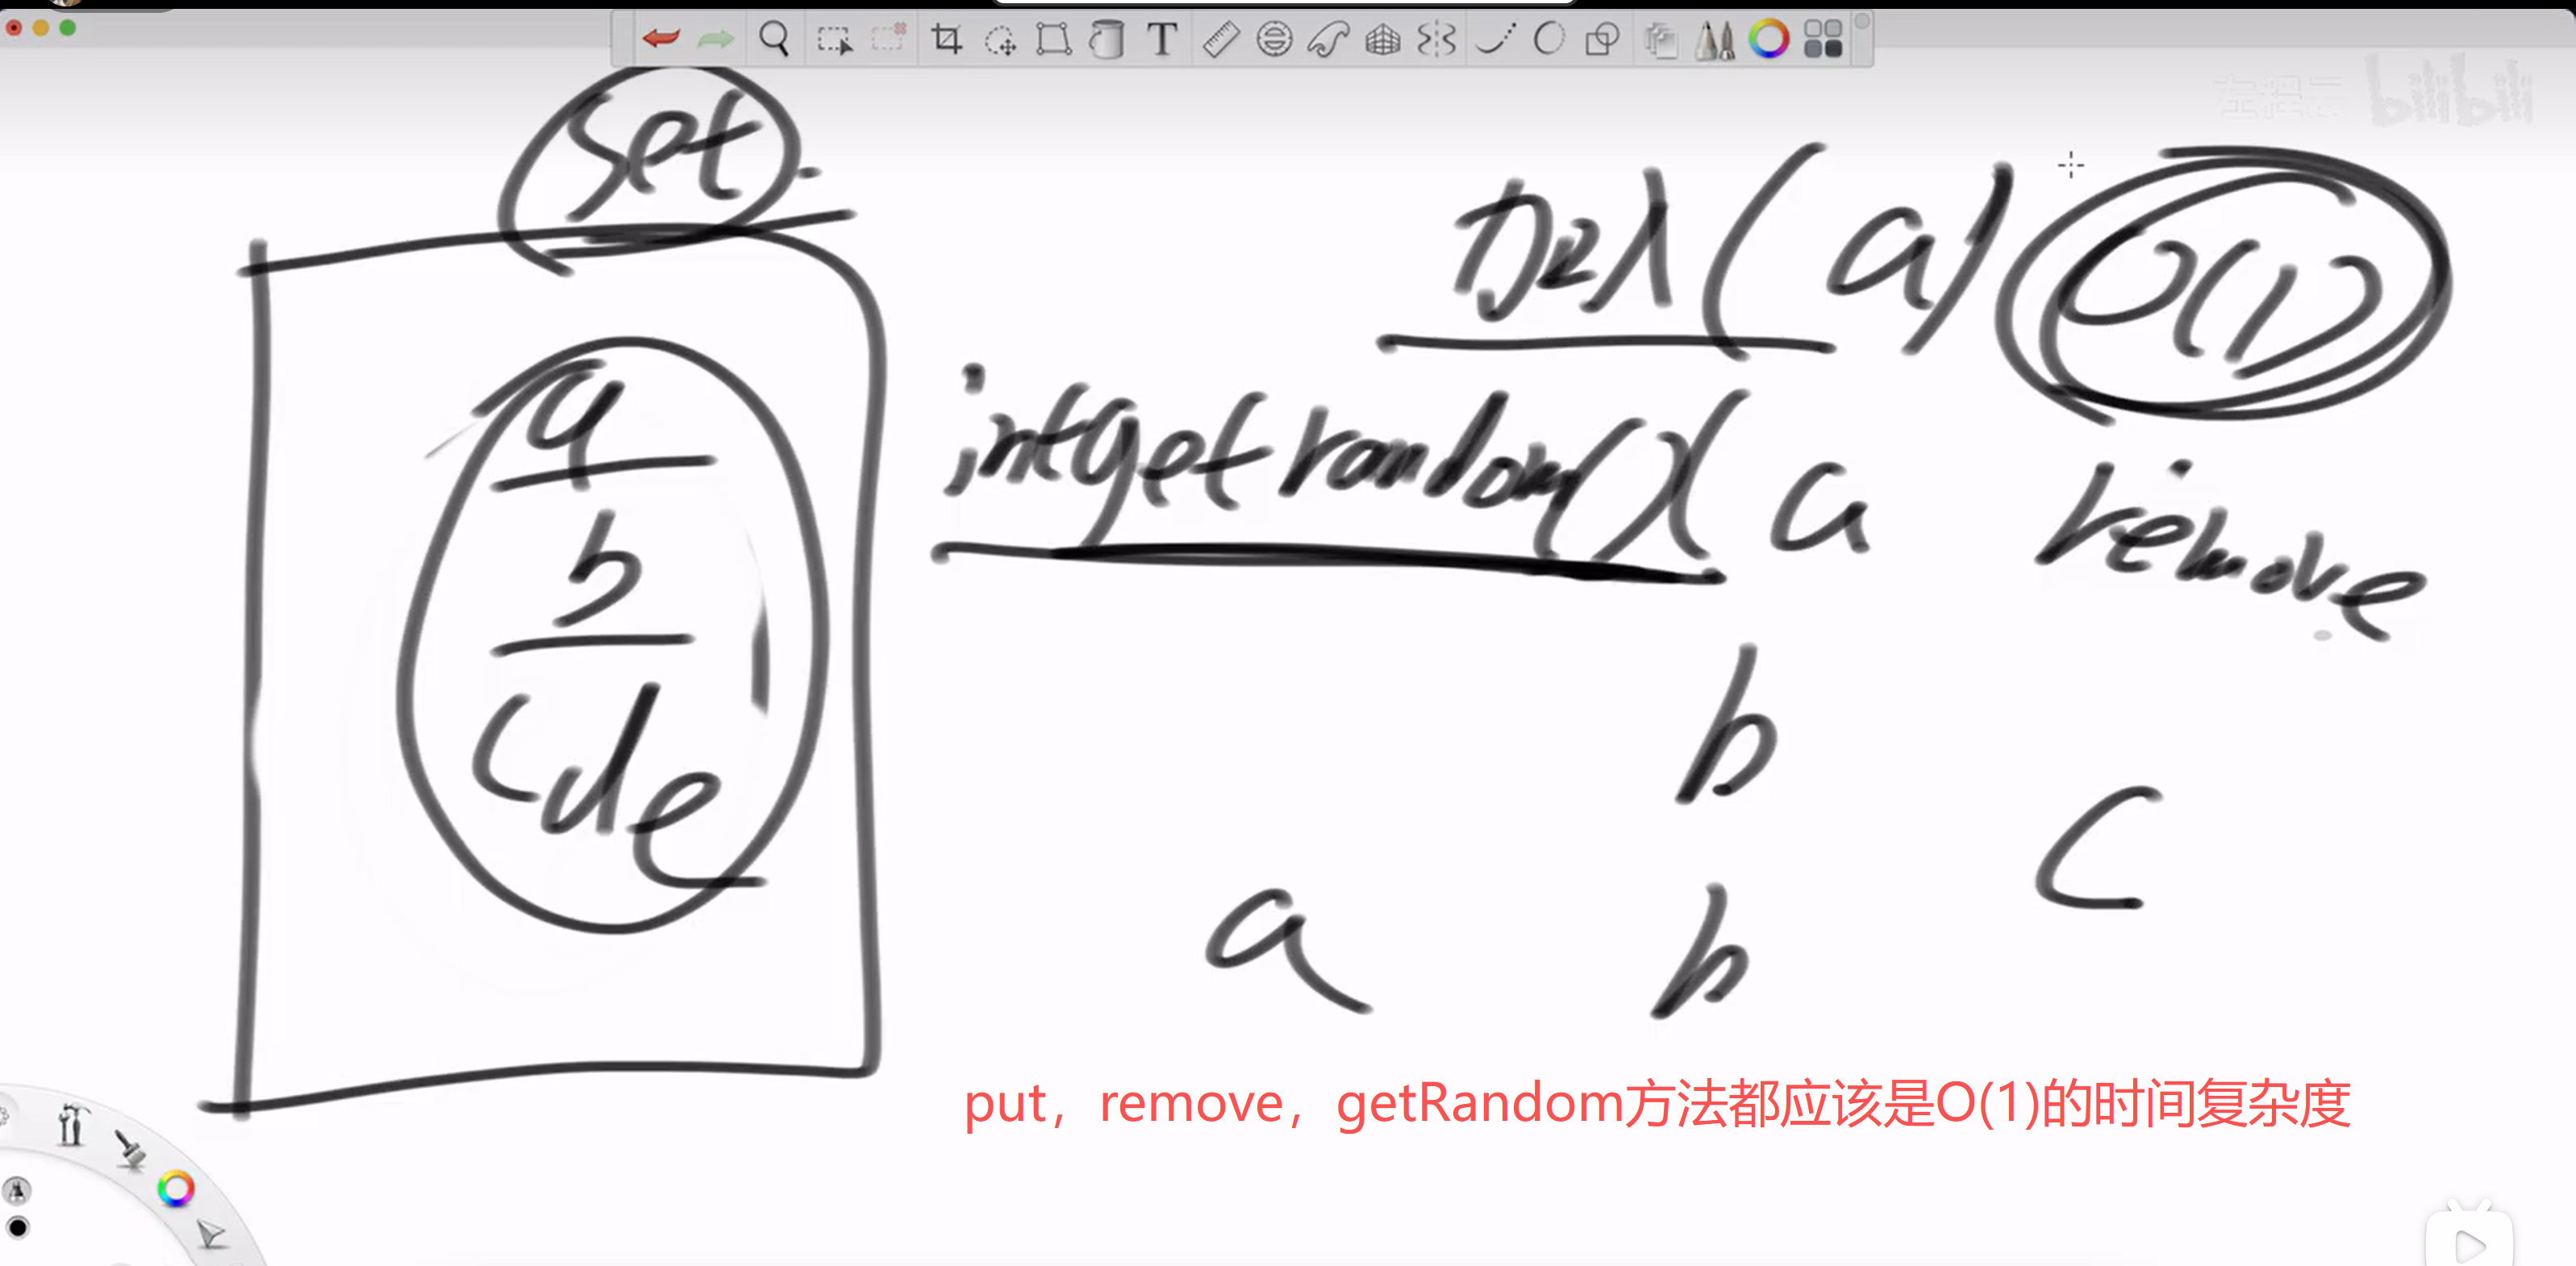
结合了动态数组与哈希表,数组负责存储元素以实现O(1)的随机获取,哈希表则存储”值到数组索引”的映射以实现O(1)的查找。其remove操作的精髓在于:将待删除元素与数组的最后一个元素交换,然后直接删除数组末尾。

hash表加入移除和得到随机索引

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
import random

class RandomizedSet:
def __init__(self):
# 核心思想:
# 1. 使用哈希表(字典)存储 值 -> 索引 的映射,实现O(1)的查找。
# 2. 使用动态数组(列表)存储值,实现O(1)的随机访问。
self.map = {}
self.arr = []

def insert(self, val: int) -> bool:
# 如果值已存在,直接返回False
if val in self.map:
return False
# 将值添加到数组末尾
self.arr.append(val)
# 在哈希表中记录新值及其索引,map[val]返回val在数组中的索引
self.map[val] = len(self.arr) - 1
return True

def remove(self, val: int) -> bool:
# 如果值不存在,直接返回False
if val not in self.map:
return False

# 核心步骤:为了实现O(1)删除,将被删除元素与数组末尾元素交换,然后删除末尾元素。
# 获取待删除元素的索引
val_index = self.map[val]
# 获取数组末尾的元素
end_value = self.arr[-1]

# 将末尾元素放到待删除元素的位置
self.arr[val_index] = end_value
# 更新哈希表中末尾元素的索引,只更新索引不更新值
self.map[end_value] = val_index

# 从哈希表中删除目标值
del self.map[val]
# 从数组中删除末尾元素,两者同步更新
self.arr.pop()

return True

def getRandom(self) -> int:
# 利用数组的特性,随机选择一个索引并返回对应的值
return random.choice(self.arr)

算法分析

  • 时间复杂度:所有操作都是O(1)
  • 空间复杂度:O(N)
  • 核心技巧:数组末尾交换删除

题目四:插入、删除和获取随机元素O(1)时间且允许重复数字的结构

问题描述

设计一个支持在平均时间复杂度O(1)下,执行以下操作的数据结构,且允许有重复数字:

  • insert(val):向集合中插入元素val
  • remove(val):从集合中移除元素val的一个实例
  • getRandom():随机返回现有集合中的一项

测试链接:https://leetcode.cn/problems/insert-delete-getrandom-o1-duplicates-allowed/

核心思想

与不允许重复的版本类似,但哈希表需要存储一个值所有出现位置的索引集合。

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
import random
from collections import defaultdict

class RandomizedCollection:
def __init__(self):
# 核心思想:与不允许重复的版本类似,但哈希表需要存储一个值所有出现位置的索引集合。
# 注意:字典中每个key指向的是不同的集合(set),而不是同一个数组
# 字典:存储 值 -> 索引集合 的映射
self.map = defaultdict(set)
# 列表:存储所有值
self.arr = []

def insert(self, val: int) -> bool:
# 判断是否是第一次插入该值
is_new = val not in self.map
# 将值添加到数组末尾
self.arr.append(val)
# 在哈希表中记录新值的索引
self.map[val].add(len(self.arr) - 1)
return is_new

def remove(self, val: int) -> bool:
# 如果值不存在,无法删除
if val not in self.map:
return False

# 核心步骤:同样是与末尾元素交换以实现O(1)删除
# 获取待删除值的一个索引
val_index = self.map[val].pop()
# 获取末尾元素的值和索引
end_value = self.arr[-1]
end_index = len(self.arr) - 1

# 如果待删除的元素恰好是末尾元素,则不需要交换
if val_index != end_index:
# 用末尾元素覆盖待删除元素的位置
self.arr[val_index] = end_value
# 更新末尾元素在哈希表中的索引记录
self.map[end_value].remove(end_index)
self.map[end_value].add(val_index)
#这里的 map 是一个存储集合的集合,所以需要通过 map[key] 先获取到集合,然后对集合调用 remove() 和 add() 方法。这是 Python 中嵌套数据结构的常见操作模式。
# 从数组中移除末尾元素
self.arr.pop()

# 如果移除后,某个值的索引集合为空,则从哈希表中彻底删除该值
if not self.map[val]:
del self.map[val]

return True

def getRandom(self) -> int:
# 随机获取一个元素
return random.choice(self.arr)

算法分析

  • 时间复杂度:所有操作都是O(1)
  • 空间复杂度:O(N)
  • 核心技巧:索引集合管理

题目五:快速获得数据流的中位数的结构

问题描述

中位数是有序列表中间的数。如果列表长度是偶数,中位数则是中间两个数的平均值。

例如,[2,3,4]的中位数是3,[2,3]的中位数是(2 + 3) / 2 = 2.5

设计一个支持以下两个操作的数据结构:

  • void addNum(int num) - 从数据流中添加一个整数到数据结构中
  • double findMedian() - 返回目前所有元素的中位数

测试链接:https://leetcode.cn/problems/find-median-from-data-stream/

核心思想

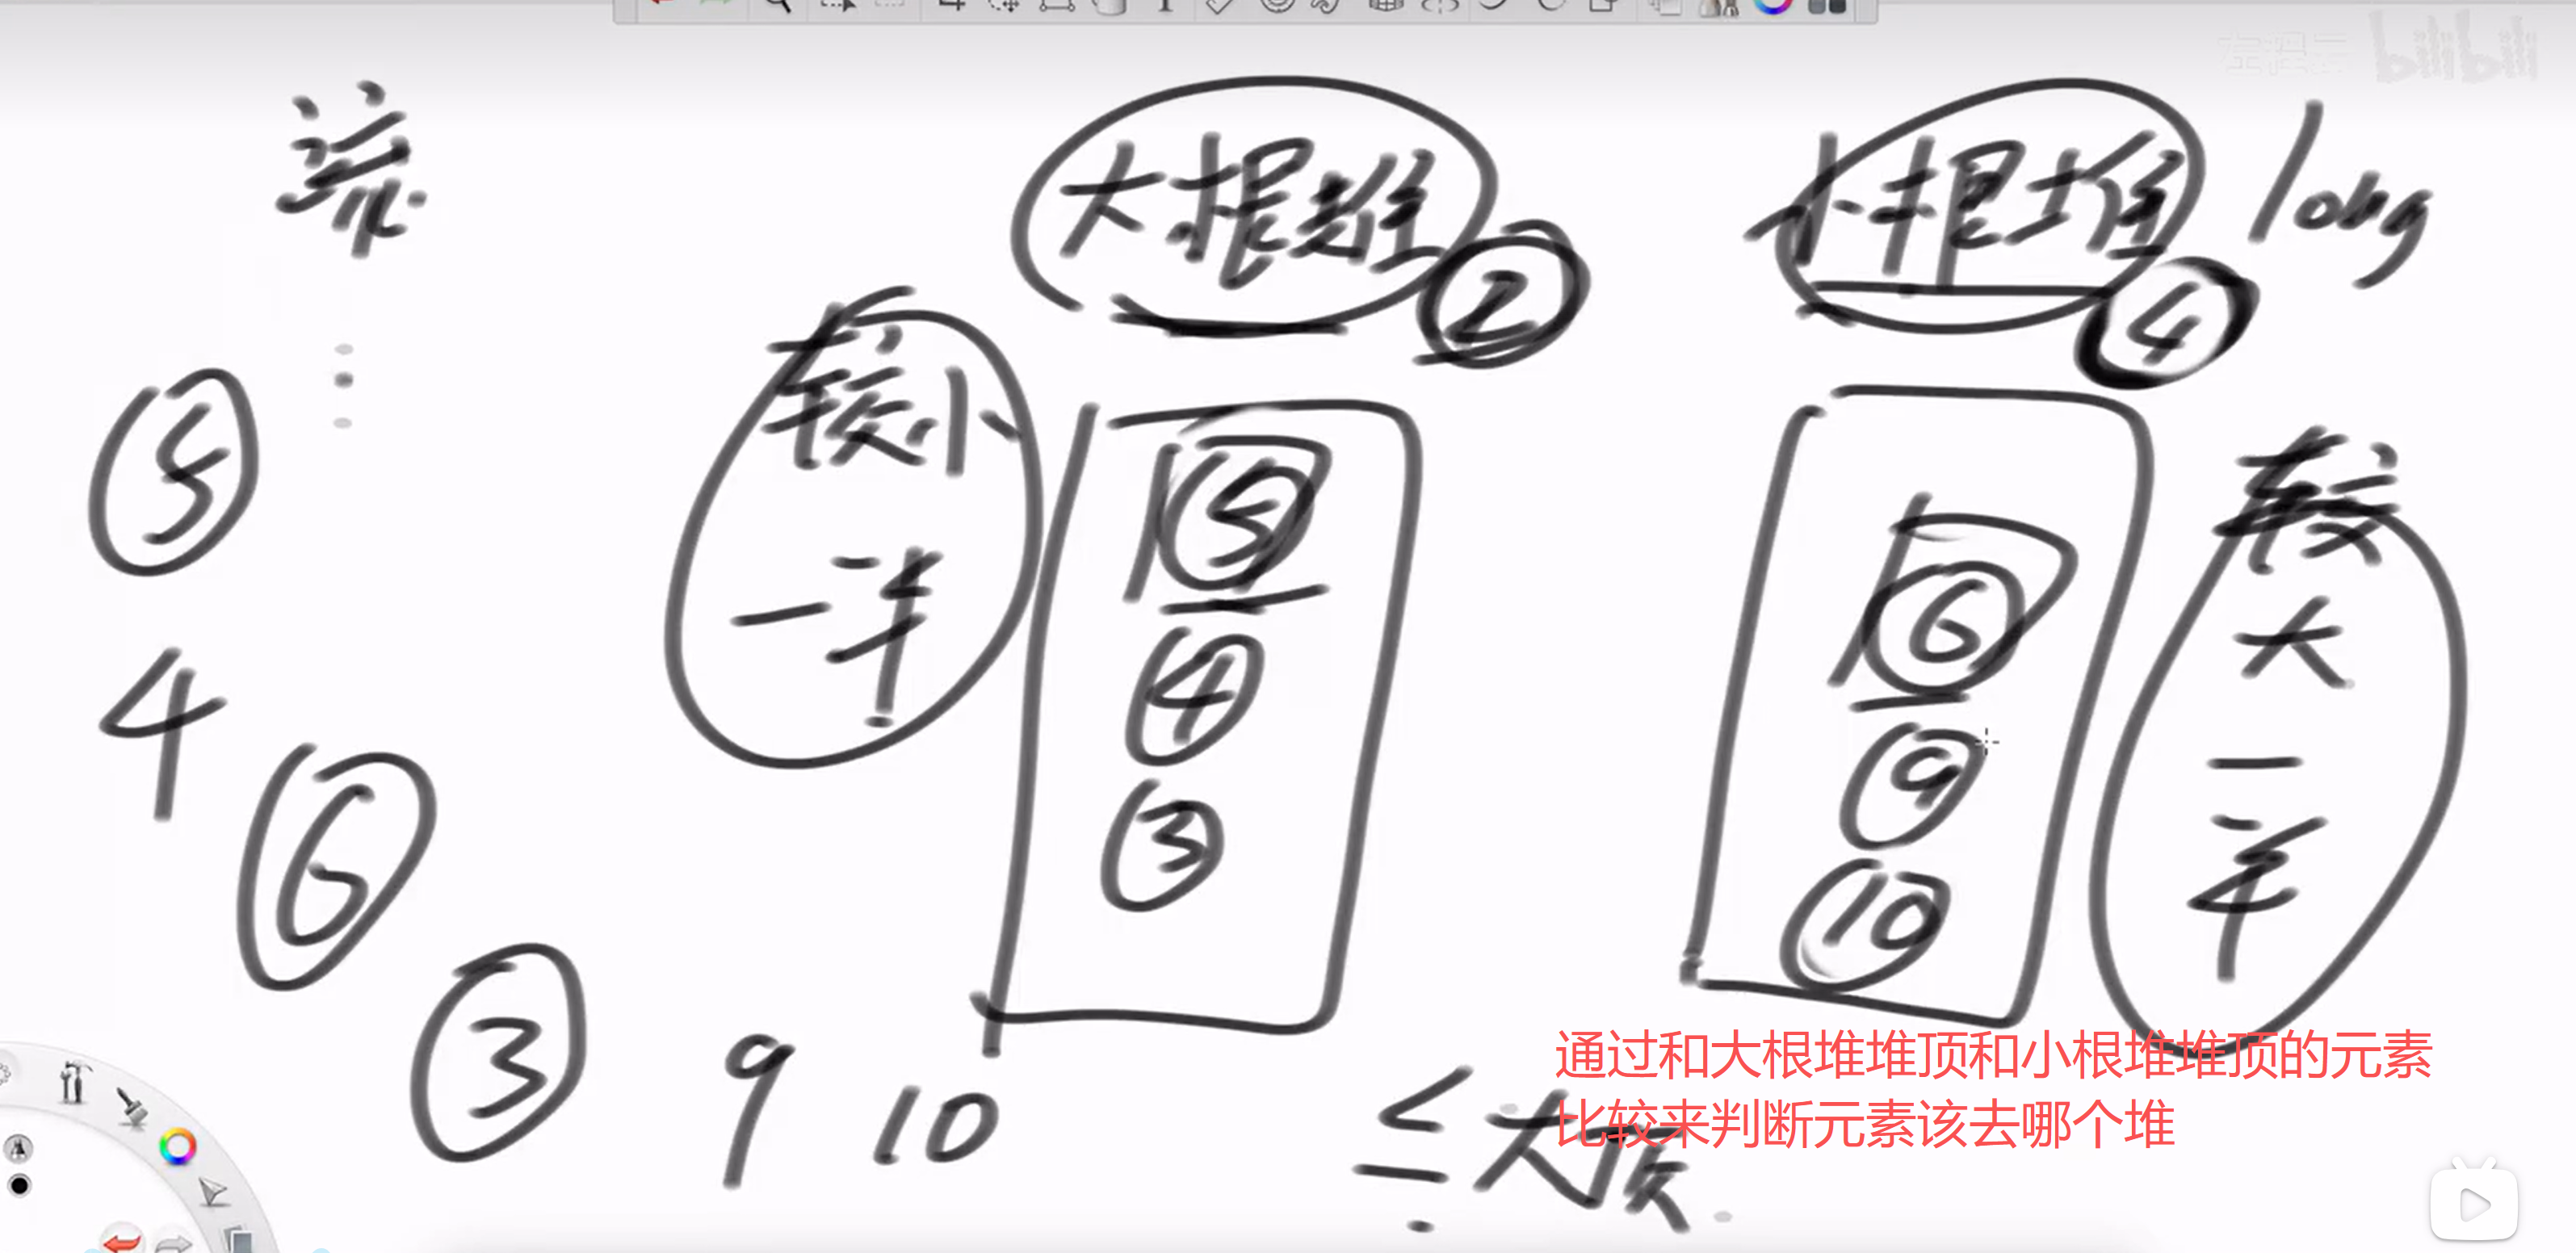
使用两个堆来维护数据流,一个大顶堆和一个小顶堆。大顶堆存储数据流中较小的一半数字,小顶堆存储数据流中较大的一半数字。这样,中位数总是可以通过两个堆的堆顶元素快速得到。

找中位数

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
import heapq

class MedianFinder:
def __init__(self):
# 核心思想:使用两个堆来维护数据流,一个大顶堆和一个小顶堆。
# 大顶堆 (max_heap) 存储数据流中较小的一半数字。
# 小顶堆 (min_heap) 存储数据流中较大的一半数字。
# 这样,中位数总是可以通过两个堆的堆顶元素快速得到。

# Python的heapq是小顶堆,为了实现大顶堆,我们存入元素的相反数。
self.max_heap = []
self.min_heap = []

def addNum(self, num: int) -> None:
# 步骤1: 决定将新元素添加到哪个堆。
# 如果大顶堆为空,或者新元素小于等于大顶堆的堆顶,则放入大顶堆。
# 否则,放入小顶堆。
if not self.max_heap or -self.max_heap[0] >= num:
heapq.heappush(self.max_heap, -num)
else:
heapq.heappush(self.min_heap, num)

# 步骤2: 平衡两个堆的大小,确保它们的size之差不超过1。
self._balance()

def findMedian(self) -> float:
# 根据两个堆的大小来计算中位数。
# 如果大小相等(总元素为偶数),中位数是两个堆顶的平均值。
if len(self.max_heap) == len(self.min_heap):
# 注意从大顶堆取值时要取反,恢复其原始值。
return (-self.max_heap[0] + self.min_heap[0]) / 2.0
# 如果大小不等(总元素为奇数),中位数就是那个size更大的堆的堆顶。
else:
return -self.max_heap[0] if len(self.max_heap) > len(self.min_heap) else self.min_heap[0]

# 私有辅助方法,用于平衡两个堆
def _balance(self) -> None:
# 当两个堆的大小差距为2时,需要从元素多的堆移动一个到元素少的堆。
if abs(len(self.max_heap) - len(self.min_heap)) == 2:
if len(self.max_heap) > len(self.min_heap):
heapq.heappush(self.min_heap, -heapq.heappop(self.max_heap))
else:
heapq.heappush(self.max_heap, -heapq.heappop(self.min_heap))

算法分析

  • 时间复杂度:addNum为O(logN),findMedian为O(1)
  • 空间复杂度:O(N)
  • 核心技巧:双堆平衡

题目六:最大频率栈

问题描述

设计一个类似堆栈的数据结构,将元素推入堆栈,并从堆栈中弹出出现频率最高的元素。

实现 FreqStack 类:

  • FreqStack() 构造一个空的堆栈
  • void push(int val) 将一个整数val压入栈顶
  • int pop() 删除并返回堆栈中出现频率最高的元素

测试链接:https://leetcode.cn/problems/maximum-frequency-stack/

核心思想

使用一个哈希表记录每个值出现的频率,使用另一个哈希表将频率映射到一个栈,这个栈存储了所有出现该频率的数字。使用一个变量实时追踪当前的最大频率。

最高频率栈

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
from collections import defaultdict

class FreqStack:
def __init__(self): #这个初始化的是hashmap
# 核心思想:
# 1. 使用一个哈希表 (value_times) 记录每个值出现的频率。
# 2. 使用另一个哈希表 (cnt_values) 将频率映射到一个栈(列表),这个栈存储了所有出现该频率的数字。
# 3. 使用一个变量 (top_times) 实时追踪当前的最大频率。
# pop操作总是从最大频率对应的栈中弹出元素,这保证了既是最高频也是最“新”的。

# 出现的最大次数
self.top_times = 0
# 每层节点 (每个频率有哪些数)
# defaultdict(list) 会在key不存在时自动创建一个空列表
self.cnt_values = defaultdict(list)
# 每一个数出现了几次
# defaultdict(int) 会在key不存在时自动创建一个0
self.value_times = defaultdict(int)
#实际上,cnt_values和value_times是两个哈希表,一个存储频率,一个存储频率对应的数

def push(self, val: int) -> None:
# 步骤1: 更新该值的频率
self.value_times[val] += 1
current_freq = self.value_times[val]

# 步骤2: 将该值压入其新频率对应的栈中
self.cnt_values[current_freq].append(val)

# 步骤3: 更新全局最大频率
self.top_times = max(self.top_times, current_freq)

def pop(self) -> int:
# 步骤1: 从最大频率对应的栈中弹出最近压入的元素
ans = self.cnt_values[self.top_times].pop()

# 步骤2: 如果弹出后,该频率的栈为空了,说明最大频率需要降低
if not self.cnt_values[self.top_times]:
self.top_times -= 1

# 步骤3: 更新被弹出元素自身的频率记录
self.value_times[ans] -= 1

return ans

算法分析

  • 时间复杂度:push和pop操作都是O(1)
  • 空间复杂度:O(N)
  • 核心技巧:频率分层存储

题目七:全O(1)的数据结构

问题描述

请你实现一个数据结构支持以下操作:

  • Inc(key) - 插入一个新的值为1的key,或者使一个存在的key增加一,保证key不为空字符串
  • Dec(key) - 如果这个key的值是1,那么把他从数据结构中移除掉。否则使一个存在的key值减一。如果这个key不存在,这个函数不做任何事情。key保证不为空字符串
  • GetMaxKey() - 返回key中值最大的任意一个。如果没有元素存在,返回一个空字符串””
  • GetMinKey() - 返回key中值最小的任意一个。如果没有元素存在,返回一个空字符串””

挑战:以O(1)的时间复杂度实现所有操作。

测试链接:https://leetcode.cn/problems/all-oone-data-structure/

核心思想

使用一个双向链表来组织桶(Bucket),链表按桶的计数值(cnt)升序排列。每个桶包含一个集合,存储所有计数值等于该桶cnt的key。使用一个哈希表来存储key -> Bucket的映射,实现O(1)的key定位。

all1类

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
class AllOne:
# 内部类,定义双向链表的节点,也叫“桶”
# 每个桶存储具有相同计数值的所有key
class Bucket:
def __init__(self, cnt):
self.cnt = cnt
self.keys = set()
self.last = None
self.next = None

def __init__(self):
# 核心思想:
# 1. 使用一个双向链表来组织桶(Bucket),链表按桶的计数值(cnt)升序排列。
# 2. 每个桶(Bucket)包含一个集合(set),存储所有计数值等于该桶cnt的key。
# 3. 使用一个哈希表(map)来存储 key -> Bucket 的映射,实现O(1)的key定位。
# inc/dec操作本质上是将key从一个桶移动到相邻的下一个/上一个桶。

# 创建头尾哨兵节点,简化边界处理
self.head = self.Bucket(0)
self.tail = self.Bucket(float('inf'))
# 将头节点的下一个指针指向尾节点,尾节点的上一个指针指向头节点,这样操作后,双向链表形成了一个初始的空结构:head <-> tail
self.head.next = self.tail
self.tail.last = self.head
# 存储 key 到其所在 Bucket 的映射
self.map = {}

# 辅助函数:在指定位置(prev_bucket)后插入一个新桶(new_bucket)
def _insert_after(self, prev_bucket, new_bucket):
new_bucket.next = prev_bucket.next
new_bucket.last = prev_bucket
prev_bucket.next.last = new_bucket
prev_bucket.next = new_bucket

# 辅助函数:从链表中移除一个桶,让前后的指针跳过当前桶
def _remove_bucket(self, bucket):
bucket.last.next = bucket.next
bucket.next.last = bucket.last

def inc(self, key: str) -> None:
# 核心步骤:将key从当前桶移动到cnt+1的桶
if key not in self.map:
# case 1: 新key,计数值为1
# 找到或创建cnt=1的桶
target_bucket = self.head.next #定位到第一个桶
if target_bucket.cnt != 1:
target_bucket = self.Bucket(1)
self._insert_after(self.head, target_bucket)
# 将key加入桶和map
target_bucket.keys.add(key)
self.map[key] = target_bucket
else:
# case 2: key已存在
current_bucket = self.map[key] #map是双向的
new_cnt = current_bucket.cnt + 1

# 找到或创建cnt=new_cnt的桶
target_bucket = current_bucket.next
if target_bucket.cnt != new_cnt:
target_bucket = self.Bucket(new_cnt)
self._insert_after(current_bucket, target_bucket)

# 移动key
target_bucket.keys.add(key)
self.map[key] = target_bucket
current_bucket.keys.remove(key)

# 如果原桶变空,则移除
if not current_bucket.keys:
self._remove_bucket(current_bucket)

def dec(self, key: str) -> None:
if key not in self.map:
return

# 核心步骤:将key从当前桶移动到cnt-1的桶
current_bucket = self.map[key]
current_bucket.keys.remove(key)

if current_bucket.cnt > 1:
new_cnt = current_bucket.cnt - 1
# 找到或创建cnt=new_cnt的桶
target_bucket = current_bucket.last
if target_bucket.cnt != new_cnt:
target_bucket = self.Bucket(new_cnt)
self._insert_after(current_bucket.last, target_bucket)
# 移动key
target_bucket.keys.add(key)
self.map[key] = target_bucket
else:
# 如果cnt为1,dec后直接从map中移除
del self.map[key]

# 如果原桶变空,则移除
if not current_bucket.keys:
self._remove_bucket(current_bucket)

def getMaxKey(self) -> str:
# 最大计数值的桶在tail哨兵节点的前面
if self.tail.last == self.head:
return ""
# 从桶的集合中任意取一个key即可
return next(iter(self.tail.last.keys))
# self.tail.last - 获取尾哨兵节点的前一个节点,也就是链表中最后一个实际的桶
# .keys - 这个桶中存储的键的集合(set)
# iter(...) - 将集合转换为迭代器
# next(...) - 从迭代器中获取第一个元

def getMinKey(self) -> str:
# 最小计数值的桶在head哨兵节点的后面
if self.head.next == self.tail:
return ""
# 从桶的集合中任意取一个key即可
return next(iter(self.head.next.keys))

算法分析

  • 时间复杂度:所有操作都是O(1)
  • 空间复杂度:O(N)
  • 核心技巧:双向链表 + 桶分组

数据结构设计核心技巧总结

1. 哈希表的O(1)特性

大部分设计题都基于哈希表的O(1)查找、插入、删除特性:

1
2
3
4
5
# 基本哈希表操作
hash_map = {}
hash_map[key] = value # O(1) 插入
val = hash_map[key] # O(1) 查找
del hash_map[key] # O(1) 删除

2. 时间戳技巧

用于实现懒更新策略:

1
2
3
4
5
# 时间戳比较
if operation_time > global_time:
return local_value
else:
return global_value

3. 双向链表维护顺序

适用于需要频繁移动元素位置的场景:

1
2
3
4
5
6
7
8
9
10
# 双向链表节点移动
def move_to_tail(node):
# 断开原连接
node.prev.next = node.next
node.next.prev = node.prev
# 插入到尾部
node.next = tail
node.prev = tail.prev
tail.prev.next = node
tail.prev = node

4. 数组末尾交换删除

实现O(1)删除的经典技巧:

1
2
3
4
# 将待删除元素与末尾元素交换
arr[del_index] = arr[-1]
map[arr[-1]] = del_index # 更新索引映射
arr.pop() # 删除末尾元素

5. 双堆维护极值

适用于动态维护中位数或其他统计量:

1
2
3
4
# 维护两个堆的平衡
if abs(len(max_heap) - len(min_heap)) > 1:
# 从大的堆移动元素到小的堆
balance_heaps()

复杂度分析总结

题目 时间复杂度 空间复杂度 核心数据结构
setAll哈希表 O(1) O(N) 哈希表+时间戳
LRU缓存 O(1) O(capacity) 哈希表+双向链表
随机数据结构 O(1) O(N) 哈希表+动态数组
随机数据结构(重复) O(1) O(N) 哈希表+集合+数组
中位数查找 O(logN)/O(1) O(N) 双堆
最大频率栈 O(1) O(N) 哈希表+栈数组
全O(1)数据结构 O(1) O(N) 哈希表+双向链表+桶

学习建议

  1. 理解O(1)的本质:大多数设计题的核心是利用哈希表的O(1)特性

  2. 掌握组合数据结构:

    • 哈希表 + 双向链表(LRU)
    • 哈希表 + 动态数组(随机访问)
    • 双堆(维护极值)
    • 时间戳(懒更新)
  3. 注意边界条件:

    • 空数据结构
    • 容量限制
    • 重复元素处理
  4. 理解权衡取舍:

    • 时间复杂度 vs 空间复杂度
    • 实现复杂度 vs 运行效率
  5. 多练习组合技巧:数据结构设计题往往需要组合多种基础数据结构

数据结构设计题考察的是对基础数据结构的深入理解和灵活运用能力。通过掌握这些经典模式和技巧,可以应对大多数设计类问题。

引言

参照的是左程云的课程:https://space.bilibili.com/8888480/lists/3509640?type=series

本笔记总结了链表类题目的高频考点和必备技巧,包含6道经典链表题目的详细解析。链表题目主要考察的是编程能力而非算法设计,是class034的内容。

前置知识

在学习链表高频题目之前,需要掌握以下基础知识:

  • 链表入门内容(009~012讲)
  • 归并排序(021讲)
  • 哈希表的使用(026讲)
  • 排序算法的稳定性(029讲)

链表定义

1
2
3
4
5
# 定义链表节点类
class ListNode:
def __init__(self, val=0, next=None):
self.val = val # 节点存储的值
self.next = next # 指向下一个节点的指针

034【必备】链表高频题目和必备技巧

链表题目解题要点

核心注意事项

  1. 空间复杂度的选择:

    • 如果笔试中空间要求不严格,直接使用容器来解决链表问题
    • 如果笔试中空间要求严格、或者在面试中面试官强调空间的优化,需要使用额外空间复杂度O(1)的方法
  2. 最常用的技巧:快慢指针

  3. 考察重点:链表类题目往往都是很简单的算法问题,核心考察点并不是算法设计,而是coding能力

  4. 练习建议:既然练的就是coding,那么不要采取空间上讨巧的方式来练习(容器方法),这些题难就难在要用有限几个变量来解决

题目一:返回两个无环链表相交的第一个节点

问题描述

给定两个单链表的头节点,判断两个链表是否相交,如果相交返回第一个交点,否则返回None。

测试链接:https://leetcode.cn/problems/intersection-of-two-linked-lists/

链表相交的概念

解题思路

容器解法(空间复杂度O(N)):

  1. 遍历链表1,将每个节点加入哈希表
  2. 遍历链表2,检查每个节点是否在哈希表中
  3. 如果找到第一个在哈希表中的节点,即为第一个交点

最优解法(空间复杂度O(1)):
核心思想是先判断两条链表是否相交,再找交点。

判断相交的关键:两条链表如果相交,最后一个节点一定是同一个节点(因为链表每个节点只有一个next指针)。

算法步骤

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
# 返回两个无环链表相交的第一个节点
def getIntersectionNode(self, h1: ListNode, h2: ListNode) -> ListNode:
if not h1 or not h2: # 任一链表为空,不可能相交
return None

a = h1 # a指针遍历链表1
b = h2 # b指针遍历链表2
diff = 0 # 记录两个链表的长度差

# 遍历链表1,计算其长度
while a.next:
a = a.next # a指针后移
diff += 1 # 长度差加1

# 遍历链表2,计算其长度
while b.next:
b = b.next # b指针后移
diff -= 1 # 长度差减1

if a != b: # 最后一个节点不同,说明不相交
return None

# 根据长度差的正负,确定哪个是长链表,哪个是短链表
# a指向长链表的头,b指向短链表的头
if diff >= 0:
a = h1 # a指向长链表
b = h2 # b指向短链表
else:
a = h2
b = h1

diff = abs(diff)

while diff != 0:
a = a.next
diff -= 1

# 同时移动直到相遇
while a != b:
a = a.next
b = b.next

return a # 返回交点

算法分析

  • 时间复杂度:O(M + N),M和N分别是两个链表的长度
  • 空间复杂度:O(1)
  • 核心技巧:长度差计算 + 双指针

题目二:每k个节点一组翻转链表

问题描述

给定一个链表,每k个节点一组进行翻转,如果最后剩余节点不够k个,则保持原样。

测试链接:https://leetcode.cn/problems/reverse-nodes-in-k-group/

解题思路

容器解法:把所有节点都放到数组里,然后每k个节点一组进行翻转,但空间复杂度为O(N)。

最优解法:使用有限变量完成分组翻转。

每k个节点一组反转链表

每k个节点一组反转链表-reverse过程

每k个节点一组反转链表-找lastteamend

算法步骤

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
# 按k个一组翻转链表
def reverseKGroup(self, head: ListNode, k: int) -> ListNode:
start = head # start指向当前组的开始节点
end = self.teamEnd(start, k) # 找到第一组的结束节点

if end is None: # 如果第一组的长度不足k,直接返回原链表头节点
return head

# 第一组很特殊因为牵扯到换头的问题
# 翻转后,第一组的末尾节点end会成为整个链表的新头节点
head = end
self.reverse(start, end) # 翻转第一组节点

# 翻转之后start变成了上一组的结尾节点
lastTeamEnd = start # lastTeamEnd记录上一组翻转后的尾节点

# 循环处理剩余的链表
while lastTeamEnd.next is not None:
start = lastTeamEnd.next # 下一组的开始节点
end = self.teamEnd(start, k) # 找到下一组的结束节点

if end is None: # 如果剩余部分的长度不足k,直接返回头节点,不进行翻转
return head

self.reverse(start, end) # 翻转当前组
lastTeamEnd.next = end # 将上一组的尾节点与当前组翻转后的头节点(即原来的end)连接起来
lastTeamEnd = start # 更新lastTeamEnd为当前组翻转后的尾节点(即原来的start)

return head # 返回新的头节点

# 当前组的开始节点是s,往下数k个找到当前组的结束节点返回
def teamEnd(self, s: ListNode, k: int) -> ListNode:
"""找到从s开始第k个节点"""
# 从s开始,向后移动k-1次
while k - 1 != 0 and s is not None:
s = s.next # s指针后移
k -= 1 # 计数器减1
return s # 返回第k个节点,如果不足k个则返回None

# s -> a -> b -> c -> e -> 下一组的开始节点
# 上面的链表通过如下的reverse方法调整成 : e -> c -> b -> a -> s -> 下一组的开始节点
# 翻转从s到e的这一段链表
def reverse(self, s: ListNode, e: ListNode):
"""翻转从s到e的链表段"""
e = e.next # e是当前组的结尾,e.next指向下一组的开头
pre = None # pre是前一个节点,初值为None
cur = s # cur是当前节点,初值为s
next_node = None # next是下一个节点

# 遍历当前组,直到cur到达下一组的开头
while cur != e:
next_node = cur.next # 保存当前节点的下一个节点
cur.next = pre # 将当前节点的next指针指向前一个节点
pre = cur # pre, cur向后移动
cur = next_node

s.next = e # 翻转后,原来的头节点s变成了尾节点,它的next应该指向下一组的开头

算法分析

  • 时间复杂度:O(N)
  • 空间复杂度:O(1)
  • 核心技巧:分组处理 + 局部翻转

题目三:复制带随机指针的链表

问题描述

复制一个带random指针的链表,random可以指向链表中的任意节点或者null。

测试链接:https://leetcode.cn/problems/copy-list-with-random-pointer/

解题思路

容器解法:使用哈希表记录原节点和新节点的对应关系,空间复杂度O(N)。

最优解法:在原链表上直接操作,分三步完成复制。

拷贝随机指针

算法步骤

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
def copyRandomList(self, head: 'Node') -> 'Node':
if head is None: # 如果头节点为空,直接返回None
return None

cur = head # cur指针用于遍历原链表
next_node = None # next指针用于暂存下一个节点

# 1 -> 2 -> 3 -> ...变成 : 1 -> 1' -> 2 -> 2' -> 3 -> 3' -> ...
# 第一步:复制每个节点并将其插入到原节点之后
while cur is not None:
next_node = cur.next # 保存原节点的下一个节点
cur.next = self.Node(cur.val) # 创建新节点,值为原节点的值
cur.next.next = next_node # 将新节点的next指向原节点的下一个节点
cur = next_node # 移动cur到下一个原节点

cur = head # cur指针重置回头节点,准备设置新节点的random指针
copy = None # copy指针用于指向复制的节点

# 第二步:为新节点设置random指针
while cur is not None:
next_node = cur.next.next # 保存下一个原节点的位置
copy = cur.next # 获取当前节点的复制节点
# 设置复制节点的random指针
# 如果原节点的random不为空,则其复制节点的random指向原节点random的下一个节点(即random指向节点的复制品)
copy.random = cur.random.next if cur.random is not None else None
cur = next_node # 移动cur到下一个原节点

ans = head.next # ans是新链表的头节点,即原头节点的下一个节点
cur = head # cur指针重置回头节点,准备分离新旧链表

# 第三步:分离原链表和新链表
while cur is not None:
next_node = cur.next.next # 保存下一个原节点的位置
copy = cur.next # 获取当前节点的复制节点
cur.next = next_node # 恢复原链表的next指针
# 设置复制节点的next指针
# 如果下一个原节点不为空,则复制节点的next指向下一个原节点的复制节点
copy.next = next_node.next if next_node is not None else None
cur = next_node # 移动cur到下一个原节点

return ans # 返回新链表的头节点

算法分析

  • 时间复杂度:O(N)
  • 空间复杂度:O(1)
  • 核心技巧:节点插入 + 关系复制 + 链表分离

题目四:判断链表是否是回文结构

问题描述

判断链表是否是回文结构,一个链表节点视为一个字符。

测试链接:https://leetcode.cn/problems/palindrome-linked-list/

解题思路

容器解法:使用栈存储所有节点,然后比较压栈过程和弹栈过程的数字是不是一致的,空间复杂度O(N)。

最优解法:使用快慢指针找中点,翻转后半部分,然后比较。

算法步骤

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
# 提交如下的方法
def isPalindrome(self, head: ListNode) -> bool:
if head is None or head.next is None: # 空链表或只有一个节点的链表是回文结构
return True

slow = head # slow指针每次走一步,fast指针每次走两步
fast = head

# 找中点,当fast到达链表末尾时,slow正好在中间位置
while fast.next is not None and fast.next.next is not None:
slow = slow.next # slow指针后移一步
fast = fast.next.next # fast指针后移两步

# 现在中点就是slow,从中点开始往后的节点逆序
pre = slow # pre是反转后的链表的头节点,初始是slow
cur = pre.next # cur是当前要处理的节点,初始是slow的下一个
next_node = None # next_node用于保存cur的下一个节点
pre.next = None # 断开前半部分和后半部分的连接

# 循环反转后半部分链表
while cur is not None:
next_node = cur.next # 保存下一个节点
cur.next = pre # 当前节点的next指向前一个节点(pre)
pre = cur # pre和cur指针后移
cur = next_node

# 上面的过程已经把链表调整成从左右两侧往中间指
# head -> ... -> slow <- ... <- pre
ans = True # ans默认为True,即假设是回文
left = head # left指针从头开始
right = pre # right指针从后半部分的头(即反转前的尾)开始

# left往右、right往左,每一步比对值是否一样,如果某一步不一样答案就是false
while left is not None and right is not None:
if left.val != right.val: # 如果左右两边的值不相等
ans = False # 那么不是回文
break # 退出循环
left = left.next # 移动指针
right = right.next

# 本着不坑的原则,把链表调整回原来的样子再返回判断结果
# 再次反转后半部分,恢复原链表结构
cur = pre.next # cur是当前要处理的节点,初始是pre的下一个
pre.next = None # 断开连接
next_node = None # next_node用于保存cur的下一个节点

# 循环将后半部分链表反转回来
while cur is not None:
next_node = cur.next # 保存下一个节点
cur.next = pre # 当前节点的next指向前一个节点(pre)
pre = cur # pre和cur指针后移
cur = next_node

return ans # 返回最终的判断结果

算法分析

  • 时间复杂度:O(N)
  • 空间复杂度:O(1)
  • 核心技巧:快慢指针找中点 + 链表翻转

题目五:返回链表的第一个入环节点

问题描述

判断链表是否有环,如果有环,返回入环节点,否则返回None。

测试链接:https://leetcode.cn/problems/linked-list-cycle-ii/

解题思路

容器解法:用哈希表记录每个节点,如果某个节点再次出现,则该节点就是入环节点。

最优解法:使用快慢指针,分两阶段找环。

快慢指针会在入环处相遇

数学原理

设链表头到入环点距离为a,入环点到相遇点距离为b,相遇点到入环点距离为c。

当快慢指针相遇时:

  • 慢指针走过距离:a + b
  • 快指针走过距离:a + b + c + b = a + 2b + c

由于快指针速度是慢指针的2倍:
2(a + b) = a + 2b + c
解得:a = c

算法步骤

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
def detectCycle(self, head: ListNode) -> ListNode:
if head is None or head.next is None or head.next.next is None:
return None

slow = head.next # 慢指针slow每次走一步
fast = head.next.next # 快指针fast每次走两步

# 第一阶段:快慢指针相遇
while slow != fast:
if fast.next is None or fast.next.next is None: # 如果快指针或其下一个节点为空,说明没有环
return None
slow = slow.next # 慢指针走一步
fast = fast.next.next # 快指针走两步

# 第二阶段:快指针回到头部,同步移动
fast = head # 当快慢指针相遇后,将快指针重置到链表头
# 此时,慢指针和快指针同时以每次一步的速度前进
while slow != fast:
slow = slow.next # 慢指针后移
fast = fast.next # 快指针后移

return slow # 相遇点即为入环点

算法分析

  • 时间复杂度:O(N)
  • 空间复杂度:O(1)
  • 核心技巧:快慢指针 + 数学推导

题目六:链表排序

问题描述

在链表上排序,要求时间复杂度O(n*logn),额外空间复杂度O(1),还要求排序有稳定性。

测试链接:https://leetcode.cn/problems/sort-list/

解题思路

链表由于有指针存在可以做到这个指标,但是数组排序不行。使用自底向上的归并排序,采用非递归方法避免O(logn)的递归空间。

算法步骤

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
def findEnd(self, s: ListNode, k: int) -> ListNode:
"""从s开始找第k个节点"""
while s and s.next and k - 1 > 0:
s = s.next
k -= 1
return s

# l1...r1 -> null : 有序的左部分 (在Python实现中r1,r2参数是不必要的)
# l2...r2 -> null : 有序的右部分
# 整体merge在一起,保证有序
# 并且返回整体的头和尾
def merge(self, l1: ListNode, l2: ListNode) -> (ListNode, ListNode):
"""合并两个有序链表,返回头和尾"""
dummy = self.ListNode(0) # dummy是哨兵节点,方便处理
pre = dummy # pre指针用于构建新链表

# 当两个链表都不为空时
while l1 and l2:
# 比较两个链表节点的值
if l1.val <= l2.val:
pre.next = l1 # 将较小的节点连接到新链表
l1 = l1.next # 移动l1指针
else:
pre.next = l2 # 将较小的节点连接到新链表
l2 = l2.next # 移动l2指针
pre = pre.next # 移动pre指针

# 如果l1还有剩余,直接连接
if l1:
pre.next = l1
elif l2: # 如果l2还有剩余,直接连接
pre.next = l2

# 找到合并后链表的尾部
while pre.next:
pre = pre.next

return dummy.next, pre # 返回新链表的头和尾

def sortList(self, head: ListNode) -> ListNode:
"""正式排序"""
if not head: # 如果链表为空,直接返回
return None

n = 0 # n用于存储链表长度
cur = head # cur用于遍历链表
# 计算链表长度
while cur:
n += 1
cur = cur.next

# l1...r1 每组的左部分
# l2...r2 每组的右部分
# next_group_head 下一组的开头
# last_team_end 上一组的结尾

step = 1 # step是每次合并的子链表长度,从1开始,每次翻倍
while step < n:
# 每一轮归并开始时,重新从头开始,dummy是一个哨兵节点,方便处理头节点
dummy = self.ListNode(0, head)
last_team_end = dummy # last_team_end指向上一次合并后的尾部
cur = dummy.next # cur指向当前处理的链表的头部

while cur:
l1 = cur # l1是第一部分的头
r1 = self.findEnd(l1, step) # r1是第一部分的尾
l2 = r1.next if r1 else None # l2是第二部分的头
if not l2: # 如果没有第二部分,就结束这一轮的合并
last_team_end.next = l1
break
r2 = self.findEnd(l2, step) # r2是第二部分的尾

next_group_head = r2.next if r2 else None # next_group_head是下一组的头

# 断开链表,准备合并
r1.next = None
r2.next = None

merged_head, merged_end = self.merge(l1, l2) # 合并l1和l2两个有序链表

last_team_end.next = merged_head # 将合并后的链表接在上一组的后面
last_team_end = merged_end # 更新last_team_end为当前合并后的尾部

cur = next_group_head # cur指向下一组的开头

head = dummy.next # 更新整个链表的头
step <<= 1 # 步长翻倍

return head


算法分析

  • 时间复杂度:O(N*logN)
  • 空间复杂度:O(1)
  • 稳定性:是
  • 核心技巧:自底向上归并 + 非递归实现

链表问题核心技巧总结

1. 快慢指针技巧

快慢指针是链表问题中最重要的技巧:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
# 找链表中点
slow = fast = head
while fast and fast.next:
slow = slow.next
fast = fast.next.next
# slow指向中点

# 判断链表是否有环
slow = fast = head
while fast and fast.next:
slow = slow.next
fast = fast.next.next
if slow == fast:
return True # 有环
return False

2. 虚拟头节点技巧

当需要修改头节点时,使用虚拟头节点简化操作:

1
2
3
4
dummy = ListNode(0)
dummy.next = head
# 对dummy.next进行操作
return dummy.next

3. 双指针技巧

用于处理需要同时操作两个位置的问题:

1
2
3
4
5
6
7
8
9
# 删除倒数第n个节点
dummy = ListNode(0, head)
first = second = dummy
for _ in range(n + 1):
first = first.next
while first:
first = first.next
second = second.next
second.next = second.next.next

4. 链表翻转技巧

翻转是链表的基础操作:

1
2
3
4
5
6
7
8
9
def reverse(head):
pre = None
cur = head
while cur:
next_node = cur.next
cur.next = pre
pre = cur
cur = next_node
return pre

复杂度分析总结

题目 时间复杂度 空间复杂度 核心技巧
链表相交 O(M+N) O(1) 长度差+双指针
K组翻转 O(N) O(1) 分组+局部翻转
复制随机链表 O(N) O(1) 节点插入+分离
回文判断 O(N) O(1) 快慢指针+翻转
环检测 O(N) O(1) 快慢指针+数学
链表排序 O(N*logN) O(1) 自底向上归并

学习建议

  1. 重视编程能力:链表题目主要考察coding能力,要多练习用有限变量解决问题

  2. 掌握核心技巧:

    • 快慢指针(最重要)
    • 虚拟头节点
    • 双指针
    • 链表翻转
  3. 避免容器方法:在练习时尽量使用O(1)空间的方法,提升编程能力

  4. 注意边界条件:

    • 空链表
    • 单节点链表
    • 链表长度不足的情况
  5. 保持链表结构:某些题目要求恢复原链表结构,要特别注意

链表问题虽然算法相对简单,但对编程能力要求较高。通过大量练习和对核心技巧的熟练掌握,可以有效提升解题能力。

引言

参照的是左程云的课程:https://space.bilibili.com/8888480/lists/3509640?type=series

本笔记包括了位图数据结构的原理、实现和应用,以及如何用位运算实现加减乘除(完全不依赖任何算术运算符)。涵盖了class032 and class033的内容

032【必备】位图

前置知识

在学习位图之前,需要掌握以下基础知识:

  • 二进制和位运算操作
  • 对数器的使用方法

Python特别提醒:在实现位运算题目时需要特别注意溢出和符号扩展问题,通常需要手动处理:

1
2
# Python中处理溢出的常见方法
result = (n << shift_amount) & 0xFFFFFFFF

位图的核心概念

什么是位图

位图(Bitset)是一种极其节省空间的数据结构,用于存储大量布尔值。相比传统哈希表,位图具有显著的空间优势:

  • 哈希表:每存储一个数字需要32个bit的空间
  • 位图:每存储一个数字只需要1个bit的空间

位图的基本原理

位图本质上是用bit组成的数组来存放值,使用bit的状态(1和0)来表示元素的存在性:

  • bit位为1:表示该数字存在于集合中
  • bit位为0:表示该数字不存在于集合中

基本思想:

1
2
用一个很长的二进制位数组,每一位(bit)对应一个整数的"有无"状态
第0位代表数字0,第1位代表数字1,第2位代表数字2,依此类推

位图的适用场景

优势:

  • 极大节省空间(1个数字仅占1个bit)
  • 查询和修改操作都是O(1)时间复杂度
  • 支持高效的批量操作

限制:

  • 必须是连续范围的整数
  • 范围不能过大(适合0到几百万,不适合到几十亿)
  • 只能表示元素的存在性,不能存储额外信息

适用场景:

  • 判断大量整数是否存在
  • 统计范围内数字的出现情况
  • 实现简单的集合操作

位图的实现

位图实现原理

类设计接口

1
2
3
4
5
6
class Bitset:
def __init__(self, n): # 初始化位图,支持0~n-1所有数字
def add(self, num): # 把num加入到位图
def remove(self, num): # 把num从位图中删除
def reverse(self, num): # 翻转num的状态(存在则删除,不存在则添加)
def contains(self, num): # 查询num是否在位图中

完整实现代码

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
class Bitset:
def __init__(self, n):
"""
初始化位图,支持0~n-1范围内的数字
n个数字需要 (n + 31) // 32 个32位整数来存储
"""
# 计算需要多少个32位整数
# 使用 (n + 31) // 32 实现向上取整
# 例如:32个数字需要1个整数,33个数字需要2个整数
self.set = [0] * ((n + 31) // 32)

def add(self, num):
"""
将num添加到位图中(将对应位设置为1)
"""
# num // 32:确定数字在第几个32位整数中
# num % 32:确定在该32位整数中的第几位
# 1 << (num % 32):创建掩码,将1左移到对应位置
# |=:按位或赋值,将对应位设置为1
self.set[num // 32] |= 1 << (num % 32)

def remove(self, num):
"""
将num从位图中删除(将对应位设置为0)
"""
# ~(1 << (num % 32)):创建掩码并取反,除了目标位其他位都是1
# &=:按位与赋值,将对应位清除为0
self.set[num // 32] &= ~(1 << (num % 32))

def reverse(self, num):
"""
翻转num在位图中的状态
如果存在则删除,如果不存在则添加
"""
# ^=:按位异或赋值
# 如果位是0,异或1后变成1
# 如果位是1,异或1后变成0
self.set[num // 32] ^= 1 << (num % 32)

def contains(self, num):
"""
判断num是否存在于位图中
"""
# >> (num % 32):将目标位移动到最低位
# & 1:提取最低位的值
# == 1:判断是否为1
return ((self.set[num // 32] >> (num % 32)) & 1) == 1

关键实现细节

1. 空间分配策略

1
2
3
4
5
6
7
# 向上取整的巧妙实现
# 对于n个数字,需要的32位整数个数
array_size = (n + 31) // 32

# 原理:
# - 如果n=32,则(32+31)//32 = 63//32 = 1(正好1个整数)
# - 如果n=33,则(33+31)//32 = 64//32 = 2(需要2个整数)

2. 位置计算

1
2
3
4
5
def get_position(num):
"""计算数字num在位图中的位置"""
array_index = num // 32 # 在第几个32位整数中
bit_index = num % 32 # 在该整数的第几位
return array_index, bit_index

3. 位运算技巧总结

操作 位运算实现 说明
设置位为1 x |= (1 << i) 按位或运算
清除位为0 x &= ~(1 << i) 按位与运算(掩码取反)
翻转位 x ^= (1 << i) 按位异或运算
检查位 (x >> i) & 1 右移后提取最低位

对数器测试

测试设计思路

使用Python内置的set作为参照标准,对位图的所有操作进行验证:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
def test_bitset():
"""使用对数器验证位图实现的正确性"""
n = 1000 # 位图大小
testTimes = 10000 # 测试次数

print("测试开始")
bitSet = Bitset(n) # 被测试的位图结构
hashSet = set() # 参照标准(Python内置set)

print("调用阶段开始")
for _ in range(testTimes):
decide = random.random() # 随机决定操作类型
number = int(random.random() * n) # 随机生成0~n-1的数字

if decide < 0.333: # 33%概率执行add操作
bitSet.add(number)
hashSet.add(number)
elif decide < 0.666: # 33%概率执行remove操作
bitSet.remove(number)
hashSet.discard(number) # 使用discard避免KeyError
else: # 34%概率执行reverse操作
bitSet.reverse(number)
if number in hashSet:
hashSet.remove(number)
else:
hashSet.add(number)

print("调用阶段结束")
print("验证阶段开始")

# 验证所有数字的存在性是否一致
for i in range(n):
if bitSet.contains(i) != (i in hashSet):
print("出错了!")
return False

print("验证阶段结束")
print("测试结束")
return True

测试覆盖的场景

  1. 随机操作序列:大量随机的增删改查操作
  2. 边界条件:0和n-1等边界值
  3. 重复操作:对同一个数字的重复操作
  4. 状态一致性:每次操作后验证状态的一致性

性能分析

时间复杂度

操作 时间复杂度 说明
初始化 O(n/32) 需要初始化数组
add O(1) 常数时间位运算
remove O(1) 常数时间位运算
reverse O(1) 常数时间位运算
contains O(1) 常数时间位运算

空间复杂度

  • 位图空间:O(n/32) = O(n)
  • 相比哈希表:空间节省约32倍

实际空间对比

1
2
3
4
5
6
7
8
9
10
11
# 存储1000万个数字的空间对比
numbers = 10_000_000

# 哈希表(假设每个数字32位)
hash_space = numbers * 32 # 320,000,000 bits

# 位图
bitset_space = numbers * 1 # 10,000,000 bits

# 空间节省比例
space_saving = hash_space / bitset_space # 32倍

应用场景与扩展

典型应用场景

  1. 大数据去重:判断海量数据中的重复元素
  2. 布隆过滤器基础:位图是布隆过滤器的核心组件
  3. 状态压缩:在动态规划中压缩状态空间
  4. 集合运算:高效实现并集、交集、差集运算

位图的集合运算

1
2
3
4
5
6
7
8
9
10
11
12
13
def bitset_union(bitset1, bitset2):
"""位图并集运算"""
result = Bitset(max(len(bitset1.set), len(bitset2.set)) * 32)
for i in range(min(len(bitset1.set), len(bitset2.set))):
result.set[i] = bitset1.set[i] | bitset2.set[i]
return result

def bitset_intersection(bitset1, bitset2):
"""位图交集运算"""
result = Bitset(max(len(bitset1.set), len(bitset2.set)) * 32)
for i in range(min(len(bitset1.set), len(bitset2.set))):
result.set[i] = bitset1.set[i] & bitset2.set[i]
return result

实际应用示例

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
def find_missing_numbers(arr, n):
"""找出0到n-1范围内缺失的所有数字"""
bitset = Bitset(n)

# 标记存在的数字
for num in arr:
if 0 <= num < n:
bitset.add(num)

# 找出缺失的数字
missing = []
for i in range(n):
if not bitset.contains(i):
missing.append(i)

return missing

# 示例使用
arr = [0, 1, 3, 6, 7, 9]
n = 10
missing = find_missing_numbers(arr, n)
print(f"缺失的数字: {missing}") # 输出: [2, 4, 5, 8]

总结

位图是一种非常实用的数据结构,特别适合处理大量整数的存在性判断问题。它的核心优势在于:

  1. 极致的空间效率:相比传统数据结构节省32倍空间
  2. 优秀的时间性能:所有基本操作都是O(1)时间复杂度
  3. 简单的实现逻辑:基于基础位运算,易于理解和实现

在大数据处理、系统设计等场景中,位图都是一个非常有价值的工具。

033【必备】位运算实现加减乘除

核心思想

位运算实现四则运算的核心在于模拟计算机底层的运算逻辑:

  • 加法:基于异或(无进位相加)和与运算(进位处理)
  • 减法:通过加法和取反实现
  • 乘法:基于移位和加法的重复运算
  • 除法:基于减法和移位的优化算法

Python中的特殊处理

在实现过程中,需要特别注意Python与Java的差异:

1
2
3
4
5
6
7
8
# Java中的整数范围限制
MIN = -2**31 # -2147483648
MAX = 2**31 - 1 # 2147483647

# Python中需要手动处理32位整数溢出
result &= 0xFFFFFFFF # 保持32位
if result > 0x7FFFFFFF:
result = ~(result ^ 0xFFFFFFFF) # 转换为有符号整数

1. 加法实现(核心基础)

算法原理

加法的位运算实现基于两个关键概念:

  1. 无进位相加:使用异或运算(XOR)
  2. 进位信息:使用与运算(AND)后左移
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
@staticmethod
def add(a, b):
"""位运算实现加法"""
#单次相加的结果为:无进位相加的结果+进位信息
ans = a
while b != 0: # 当b为0时,说明没有进位了,加法结束
# 单次进位只能把当前位的进位信息加到下一高位,但新一位的进位可能和更高位产生新的进位冲突,需要继续处理。
# 只有所有进位都为0,结果才是完整无误的。
# ans : a和b无进位相加的结果
ans = a ^ b
# b : a和b相加时的进位信息
b = (a & b) << 1
# Python中int无限大,为了模拟int32,需要对超出部分进行处理
# 下面两行确保ans和b都保持32位
ans &= 0xFFFFFFFF
b &= 0xFFFFFFFF
a = ans
# 处理负数转为补码
return ans if ans <= 0x7FFFFFFF else ~(ans ^ 0xFFFFFFFF) #结果超过最大值时,需要将无符号32位结果转换为有符号,当加法结果超过0x7FFFFFFF时,实际上表示的是负数,需要转换为对应的有符号表示
#将ans与全1进行异或,相当于按位取反,~(...):再次取反,相当于恢复原值

执行过程示例

以 5 + 3 为例:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
第1轮:a=5(101), b=3(011)
无进位:5^3 = 101^011 = 110 = 6
进位:(5&3)<<1 = (001)<<1 = 010 = 2

第2轮:a=6(110), b=2(010)
无进位:6^2 = 110^010 = 100 = 4
进位:(6&2)<<1 = (010)<<1 = 100 = 4

第3轮:a=4(100), b=4(100)
无进位:4^4 = 100^100 = 000 = 0
进位:(4&4)<<1 = (100)<<1 = 1000 = 8

第4轮:a=0(000), b=8(1000)
无进位:0^8 = 1000 = 8
进位:(0&8)<<1 = 0

结果:8

2. 取反运算

1
2
3
4
@staticmethod
def neg(n):
"""取相反数:~n + 1"""
return BitOperationAddMinusMultiplyDivide.add(~n, 1)

原理解释

基于补码的性质:一个数的相反数等于该数按位取反后加1。

  • 正数:直接按位取反加1
  • 负数:同样规则,利用补码特性

3. 减法实现

1
2
3
4
@staticmethod
def minus(a, b):
"""减法就是加上-b"""
return BitOperationAddMinusMultiplyDivide.add(a, BitOperationAddMinusMultiplyDivide.neg(b))

减法的实现非常简洁:a - b = a + (-b)

4. 乘法实现(龟速乘)

算法原理

基于二进制乘法的原理,将乘法转换为多次加法和移位运算:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
@staticmethod
def multiply(a, b):
"""位运算实现乘法"""
# 把乘法拆成若干次加法,用位运算(移位)和加法实现,不直接用乘号,适合大数和防溢出场合。
# 二进制的乘法也是像十进制一样,从右到左,一位一位的乘,然后错位相加
ans = 0
# 为了模拟int32,确保a, b, ans都在32位内
a &= 0xFFFFFFFF
b &= 0xFFFFFFFF
while b != 0: #说明乘数没有耗尽,继续乘
if (b & 1) != 0: #说明当前位是1,需要加到结果上
# 考察b当前最右的状态!
ans = BitOperationAddMinusMultiplyDivide.add(ans, a)
ans &= 0xFFFFFFFF # 保持32位
a = (a << 1) & 0xFFFFFFFF # 左移并保持32位
# Java中的 >>> 表示无符号右移,Python没有,需特殊处理
if b >= 0:
b >>= 1
else:
#在Java中,>>> 是无符号右移操作,无论原数是正数还是负数,右移时都在高位补0。但在Python中,>> 是有符号右移,对于负数会补1
#内存中:b + 0x100000000和b的位模式完全相同,这时候又该告诉python该改变语义理解了
b = (b + 0x100000000) >> 1 #0x100000000等于2^32
b &= 0xFFFFFFFF # 保持32位
# 处理负数转为补码
return ans if ans <= 0x7FFFFFFF else ~(ans ^ 0xFFFFFFFF) # 0xFFFFFFFF是全1,保证结果是32位,
# 如果结果超过0x7FFFFFFF,说明发生了溢出
# 使用~(ans ^ 0xFFFFFFFF)将结果"包装"到32位范围内
# 这样就能得到正确的有符号32位整数结果

执行过程示例

以 5 × 3 为例:

1
2
3
4
5
3的二进制:011
第1轮:b=011, b&1=1, ans += 5×2^0 = 5
第2轮:b=001, b&1=1, ans += 5×2^1 = 5+10 = 15
第3轮:b=000, 结束
结果:15

应用场景

这种”龟速乘”在以下场景特别有用:

  • 大数乘法防溢出
  • 模运算:(a × b) % m
  • 快速幂运算的基础

5. 除法实现(最复杂)

核心挑战

除法是四则运算中最复杂的,需要处理多种边界情况:

  1. 除数为0的情况
  2. 整数最小值的特殊处理
  3. 溢出预防
  4. 符号处理

主要函数结构

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
@staticmethod
def divide(a, b):
"""主除法函数,处理各种边界情况"""
# 处理 a 和 b 都为最小值的情况
if a == BitOperationAddMinusMultiplyDivide.MIN and b == BitOperationAddMinusMultiplyDivide.MIN:
# a和b都是整数最小
return 1
# 处理 a 和 b 都不是最小值的情况
if a != BitOperationAddMinusMultiplyDivide.MIN and b != BitOperationAddMinusMultiplyDivide.MIN:
# a和b都不是整数最小,那么正常去除
return BitOperationAddMinusMultiplyDivide.div(a, b)
# 处理 b 为最小值的情况
if b == BitOperationAddMinusMultiplyDivide.MIN:
# a不是整数最小,b是整数最小,整数最小值是负数,而且整数最小值无法转成相反数
return 0
# 处理 a 为最小值,b 为 -1 的情况(防止溢出)
# 第1个if不成立:a 和 b 不都是最小值;第2个if不成立:a 和 b 不都不是最小值;第3个if不成立:b 不是最小值,则排除完b,a就是最小值
if b == BitOperationAddMinusMultiplyDivide.neg(1):
# a是整数最小,b是-1,返回整数最大,因为题目里明确这么说了
return BitOperationAddMinusMultiplyDivide.MAX
# a是整数最小,b不是整数最小,b也不是-1
a = BitOperationAddMinusMultiplyDivide.add(a, b if b > 0 else BitOperationAddMinusMultiplyDivide.neg(b)) #让 a 不再是最小值,这样就可以安全地调用 div 函数了,如果 b > 0:a = a + b;如果 b < 0:a = a + (-b)
ans = BitOperationAddMinusMultiplyDivide.div(a, b) # 现在 a 不再是最小值,可以安全地调用 div 函数
offset = BitOperationAddMinusMultiplyDivide.neg(1) if b > 0 else 1 # 如果 b > 0,则 offset = -1;如果 b < 0,则 offset = 1
return BitOperationAddMinusMultiplyDivide.add(ans, offset) # 最后把 offset 加回去

核心除法算法

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
@staticmethod
def div(a, b): #向下取整,但是不返回余数
"""核心除法实现,要求a和b都不是整数最小值"""
x = BitOperationAddMinusMultiplyDivide.neg(a) if a < 0 else a # 取绝对值
y = BitOperationAddMinusMultiplyDivide.neg(b) if b < 0 else b # 取绝对值
ans = 0
i = 30
while i >= 0:
# (x >> i) >= y 时,说明y << i 还能减掉
if (x >> i) >= y: #判断x右移i位后是否大于等于y,若大于则记录1
ans |= (1 << i) # 记录这个位
x = BitOperationAddMinusMultiplyDivide.minus(x, y << i) # x 减去 y << i,即y*2^i
i = BitOperationAddMinusMultiplyDivide.minus(i, 1) # 相当于 i--
# 最后根据正负判断符号
return BitOperationAddMinusMultiplyDivide.neg(ans) if (a < 0) ^ (b < 0) else ans #当两个数的符号不同时,结果取负;当符号相同时,结果保持正。

算法原理解析

除法算法本质上是二分查找的变种:

  1. 从高位到低位:尝试每一位是否能为1
  2. 位移优化:y << i 相当于 y × 2^i
  3. 贪心策略:能减就减,记录对应的位

执行过程示例

以 10 ÷ 3 为例:

1
2
3
4
5
6
7
x=10, y=3
i=30: (10>>30)=0 < 3, 跳过
...
i=2: (10>>2)=2 < 3, 跳过
i=1: (10>>1)=5 >= 3, ans|=(1<<1), x=10-6=4
i=0: (4>>0)=4 >= 3, ans|=(1<<0), x=4-3=1
结果:ans = 11(二进制) = 3(十进制)

边界情况处理

整数最小值的特殊性

1
2
MIN = -2**31  # -2147483648
MAX = 2**31 - 1 # 2147483647

整数最小值的特殊性在于它没有对应的正数,因为:

  • 最小值的绝对值是 2^31
  • 最大正整数只有 2^31 - 1

处理策略

  1. 预处理:将最小值调整为非最小值
  2. 后处理:补偿调整造成的误差
  3. 特殊返回:MIN ÷ (-1) 返回 MAX

完整实现的使用示例

1
2
3
4
5
6
7
8
9
10
11
12
13
# 创建类实例
calc = BitOperationAddMinusMultiplyDivide()

# 测试各种运算
print(calc.add(15, 27)) # 42
print(calc.minus(50, 18)) # 32
print(calc.multiply(6, 7)) # 42
print(calc.divide(84, 2)) # 42

# 测试边界情况
print(calc.divide(-2**31, -1)) # 2**31-1 (MAX)
print(calc.divide(10, 3)) # 3
print(calc.divide(-10, 3)) # -3

时间复杂度分析

运算 时间复杂度 空间复杂度 说明
加法 O(1) O(1) 最多32次循环
减法 O(1) O(1) 调用加法和取反
乘法 O(1) O(1) 最多32次循环
除法 O(1) O(1) 固定31次循环

虽然有循环,但循环次数是固定的(最多32次),所以时间复杂度为常数。

实际应用场景

    1. 底层系统编程
      在某些嵌入式系统或底层驱动中,可能需要在没有算术运算单元的情况下实现运算。
    1. 大数运算
      在实现大整数库时,这些技巧是基础构建块。
    1. 密码学应用
      在某些密码学算法中,需要避免使用标准库的运算函数。
    1. 算法竞赛
      某些特殊题目可能限制算术运算的使用。
    1. 教学演示
      帮助理解计算机底层运算原理。

总结与思考

位运算实现四则运算展示了计算机底层运算的本质。虽然在实际开发中很少直接使用,但理解这些原理对于:

  1. 加深对计算机原理的理解
  2. 提升位运算技巧
  3. 应对特殊场景需求
  4. 算法思维的训练

都具有重要意义。特别是除法的实现,体现了二分思想和贪心策略的完美结合,是位运算技巧的集大成者。

引言

参照的是左程云的课程:https://space.bilibili.com/8888480/lists/3509640?type=series
本笔记包括了异或运算和位运算的高效技巧与应用,包括了class030 -> class031的内容

030【必备】异或运算的骚操作

异或运算的核心性质

前置知识

异或运算是计算机科学中一种重要的位运算,符号为^。在Python中实现位运算题目时需要特别注意溢出和符号扩展问题,通常需要手动处理:

1
2
# Python中处理溢出的常见方法
result = (n << shift_amount) & 0xFFFFFFFF

异或运算的四大核心性质

1. 异或运算就是无进位相加

这是理解异或运算最重要的性质,其他所有性质都可以由此推导得出。

1
2
3
4
5
示例:5 ^ 3
5: 101
3: 011
---
110 (结果为6)

异或预算取下标

2. 异或运算满足交换律和结合律

同一批数字,不管异或顺序如何,最终结果都相同:

  • a ^ b = b ^ a(交换律)
  • (a ^ b) ^ c = a ^ (b ^ c)(结合律)

3. 特殊值性质

1
2
3
4
5
# 任何数与0异或等于自己
0 ^ n = n

# 任何数与自己异或等于0
n ^ n = 0

n或n

4. 整体异或和性质

如果整体异或和为x,其中某部分异或和为y,那么剩余部分的异或和为x ^ y。

这个性质在很多题目中都有应用,特别是区间异或和相关的问题。

有趣的数学问题

让我们从一个有趣的概率问题开始:

问题:袋子里有a个白球,b个黑球。每次取2个球:

  • 取出2个白球或2个黑球 → 放回1个白球
  • 取出1白1黑 → 放回1个黑球

最终袋子里剩1个球,问这个球是黑球的概率?

答案:

  • 如果黑球数量为偶数,最终是黑球的概率为0%
  • 如果黑球数量为奇数,最终是黑球的概率为100%
  • 完全与白球数量无关!

黑白球结果

这个结果与异或运算的性质有关:黑球数量的奇偶性在整个过程中保持不变。

经典应用题目

题目1:用异或运算交换两数的值

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
def swap(arr, i, j):
# 注意:当i==j时会出错,实际开发中不推荐使用
if i != j: # 添加安全检查
arr[i] = arr[i] ^ arr[j] # 第一步
arr[j] = arr[i] ^ arr[j] # 第二步:arr[j]变成原arr[i]
arr[i] = arr[i] ^ arr[j] # 第三步:arr[i]变成原arr[j]

# 更简洁的变量交换
def swap_variables():
a, b = -2323, 10
a = a ^ b # a现在是原a^原b
b = a ^ b # b现在是原a^原b^原b = 原a
a = a ^ b # a现在是原a^原b^原a = 原b
return a, b
# 示例用法
if __name__ == "__main__":
a = -2323 # 定义a
b = 10 # 定义b 因为a^b=b^a ,这么操作的前提是a和b都有自己的内存空间
a = a ^ b # 第一步,a和b异或后的结果给a
b = a ^ b # 第二步,a和b再次异或的结果赋给b,b'=(a^b)^b
a = a ^ b # 第三步,a和b再次异或的结果赋给a,a''=a^b^((a^b)^b)=a^b^a^b^b=a^b^a,根据交换律,a^b^a=a^a^b=b
print(a) # 输出此时的a
print(b) # 输出此时的b

arr = [3, 5] # 定义一个数组
swap(arr, 0, 1) # 交换arr[0]和arr[1]
print(arr[0]) # 输出交换后的arr[0],输出3
print(arr[1]) # 输出交换后的arr[1],输出5
swap(arr, 0, 0) # 交换同一个元素(java会出错,需谨慎,但是python不会) Python的整数对象是不可变的,每次赋值都会创建新的整数对象。更重要的是,Python的异或运算对于相同值的结果是 0,这是数学上正确的,内存模型不同:Java:直接操作内存中的值Python:操作的是对象的引用,整数是不可变对象
print(arr[0]) # 输出arr[0],输出3
print(arr[1]) # 输出arr[1],输出5

原理分析:

  1. 第一步:a = a ^ b,a存储了原始a和b的异或结果
  2. 第二步:b = a ^ b ,则 b'=(a^b)^b
  3. 第三步:a = a ^ b ,则 a''=a^b^((a^b)^b)=a^b^a^b^b=a^b^a,根据交换律,a^b^a=a^a^b=b

题目2:不用判断语句返回两数最大值

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
# 测试链接 : https://www.nowcoder.com/practice/d2707eaf98124f1e8f1d9c18ad487f76
def flip(n):
"""翻转0和1"""
return n ^ 1 # 0变1,1变0

def sign(n):
"""非负数返回1,负数返回0"""
return flip((n >> 31) & 1)
#因为负数符号位为1,正数符号位为0,所以负数右移31位后符号位为1,正数右移31位后符号位为0
# 右移后得到的值,可能不是严格的0或1,尤其在Python里,负数右移得到的是全1(二进制全是1,对应十进制-1)。
# 所以为了保证只取最低1位(也就是现在的符号位),要 & 1。
# 如果结果是0,0 & 1 = 0。
# 如果结果是-1,-1 & 1 = 1(因为-1的二进制补码是全1)
def getMax1(a, b):
# 有溢出风险的实现,若c溢出了的话会出错
c = a - b # 计算差值
returnA = sign(c) # 差值非负则返回a
returnB = flip(returnA) # 差值负则返回b
return a * returnA + b * returnB # 保证互斥就行

def getMax2(a, b):
# 没有溢出风险的实现,增加了一个判断a、b符号的逻辑
c = a - b # 差值
sa = sign(a) # a的符号,非负返回1,负数返回0
sb = sign(b) # b的符号
sc = sign(c) # 差值的符号
diffAB = sa ^ sb # 判断a和b的符号是否一样,如果符号不同,则为1;符号一样,则为0
sameAB = flip(diffAB) # 符号相同,则为1
returnA = diffAB * sa + sameAB * sc # 决定返回哪个,diffAB和sameAB只有一个能为1,a和b的符号不同,且a非负,则返回1;a和b的符号相同,且c非负,则返回1,整合起来就是判断a
returnB = flip(returnA) # 另一个
return a * returnA + b * returnB # 返回最大值

#示例用法
if __name__ == "__main__":
a = -2**31 # Integer.MIN_VALUE
b = 2**31 - 1 # Integer.MAX_VALUE
# getMax1方法会错误,因为溢出
print(getMax1(a, b)) # 可能错误
# getMax2方法永远正确
print(getMax2(a, b)) # 永远正确

核心思想:

  • 通过位运算判断数字符号
  • 用乘法实现条件选择,避免if语句
  • 处理溢出情况,确保算法的鲁棒性

题目3:找到缺失的数字

题目:给定包含n个不同数字的数组,数字范围为[0,n],找出缺失的那个数字。

1
2
3
4
5
6
7
8
9
10
11
12
13
# 测试链接 : https://leetcode.cn/problems/missing-number/
def missingNumber(nums):
# eorAll用于异或0~n,0到10之间的数字缺了一个
# eorHas用于异或数组内所有数
eorAll = 0 # 初始化eorAll
eorHas = 0 # 初始化eorHas
for i in range(len(nums)): # 遍历数组
eorAll ^= i # 累计异或0~n-1,把下标0-n-1全都异或起来
eorHas ^= nums[i] # 累计异或数组元素,
eorAll ^= len(nums) # 最后再异或n
return eorAll ^ eorHas # 缺失的数即为两者异或结果,这是由于交换律,所有出现两次的数字会相互抵消,最后只剩下缺失的数字
# 示例用法
# print(missingNumber([3,0,1])) # 输出2

原理:

  • 完整序列:0,1,2,…,n
  • 给定数组:缺少一个数字
  • 两者异或后,相同数字抵消,剩下的就是缺失数字

题目4:找到出现奇数次的数字

题目:数组中只有一种数出现奇数次,其他数都出现偶数次,找到这个数。

1
2
3
4
5
6
7
8
# 测试链接 : https://leetcode.cn/problems/single-number/
def singleNumber(nums):
eor = 0 # 初始化eor
for num in nums: # 遍历数组
eor ^= num # 累计异或
return eor # 返回结果,原理同code03
# 示例用法
# print(singleNumber([2,2,1])) # 输出1

题目5:找到两个出现奇数次的数字

题目:数组中有2种数出现奇数次,其他数都出现偶数次,返回这2种数。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
# https://leetcode.cn/problems/single-number-iii/
def singleNumber(nums):
eor1 = 0
for num in nums:
# nums中有2种数a、b出现了奇数次,其他的数都出现了偶数次
eor1 ^= num # 累计异或所有数,得到a^b
# eor1 : a ^ b
# Brian Kernighan算法
# 提取出二进制里最右侧的1
rightOne = eor1 & -eor1 # &是与运算,返回1和1相与为1,0和0相与为0,1和0相与为0;
# n 的二进制表示中,最右边的 1 之前可能有若干个 0。
# -n 的二进制表示会反转所有位,然后加1,相当于把最右边的 1 及其右边的 0 都翻转了。
# 这样,n & -n 只会留下最右边的 1,其余位都变成0。
# 因为~n= n的取反+1,所以能够提取最右侧的1,所以就拿这个最右侧的1来分组
eor2 = 0
# 此外因为a^b不尽相同,则从左到右,a和b的二进制状态中,必然有一位不同(能找到一个位置上是1,假设是第k位),则可以利用这个不同进行分组
# 分成两组,一组是第k位为0的数,另一组是第k位为1的数,而q,b一定分别落在不同的组里
# 所以额外引入一个变量eor2来得到a或者b
for num in nums:
if (num & rightOne) == 0: # 分组,最后返回,
eor2 ^= num # 分组后累加异或,对分到“那一位为0”这一组的数进行异或。
# 这组里除了 a 或 b 以外,其他数都成对出现(偶数次),异或后消掉了,只剩下一个(假设是 a)。
return [eor2, eor1 ^ eor2] # 返回那两个数

# 示例用法
# print(singleNumber([1,2,1,3,2,5])) # 输出[3,5](顺序无关)

关键技巧:

  • n & -n:提取最右侧的1
  • 用这个位进行分组,将a和b分到不同组
  • 每组内除了a或b,其他数都成对出现

Brian Kernighan算法原理:

1
2
3
假设 eor1 = 6 (二进制: 110)
-eor1 = -6 (二进制: ...11111010) // 补码表示
eor1 & -eor1 = 110 & ...11111010 = 010 = 2

题目6:通用的k次方法

题目:数组中只有1种数出现次数少于m次,其他数都出现m次,找到这个数。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
# 测试链接 : https://leetcode.cn/problems/single-number-ii/
# 注意 : 测试题目只是通用方法的一个特例,课上讲了更通用的情况
def singleNumber(nums):
return find(nums, 3) # 调用更通用的方法,m=3

# 更通用的方法
# 已知数组中只有1种数出现次数少于m次,其他数都出现了m次
# 返回出现次数小于m次的那种数
def find(arr, m):
# 统计每个位有多少个1,如果一个位置的1的个数不是m的整数倍,说明该位属于出现次数小于m次的数
# cnts[0] : 0位上有多少个1
# cnts[i] : i位上有多少个1
# cnts[31] : 31位上有多少个1
cnts = [0] * 32
for num in arr:
for i in range(32):
cnts[i] += (num >> i) & 1 # 统计每个位有多少个1
ans = 0
for i in range(32):
if cnts[i] % m != 0: # 如果不是m的整数倍,说明该位属于少于m次的数
ans |= 1 << i # 把该位设置为1,|= 是“按位或赋值”运算符,相当于 ans = ans | (1 << i)
# 处理负数
if (ans & (1 << 31)) != 0: # 如果最高位是1,说明是负数
# 检查ans的第31位(最高位)是否为1。在32位整数里,第31位是符号位,1表示负数(补码)
ans -= 1 << 32 # 当检测到ans的第31位(最高位)为1时,把它转化为Python中的负数表示
#在32位二进制补码表示中,负数的真实值等于它的二进制表示减去2^32,而Python的int没有溢出,补码负数要手动转换
return ans

# 示例用法
# print(singleNumber([2,2,3,2])) # 输出3

算法思路:

  1. 统计每一位上1的个数
  2. 如果某位上1的个数不是m的整数倍,说明目标数字在该位为1
  3. 重新构造答案

时间复杂度分析

操作 时间复杂度 空间复杂度 说明度
交换两数 O(1) O(1) 常数时间操作
找最大值 O(1) O(1) 位运算替代条件判断
找缺失数字 O(n) O(1) 遍历数组一次
找一个奇数次数字 O(n) O(1) 异或运算线性时间
找两个奇数次数字 O(n) O(1) 两次遍历,分组处理
通用k次方法 O(n) O(1) 虽然有32层循环但32是常数

核心技巧总结

1. 位运算技巧

1
2
3
4
5
6
7
8
9
10
11
# 提取最右侧的1
rightOne = n & -n

# 判断数字符号
sign = (n >> 31) & 1

# 翻转0和1
flip = n ^ 1

# 设置某位为1
ans |= 1 << i

2. 异或运算应用模式

  1. 消除配对:相同数字异或为0,利用这个性质找到不配对的数字
  2. 分组策略:根据某一位的不同将数组分成两组
  3. 位统计:统计每一位上1的个数,重构答案

3. Python特有注意事项

1
2
3
4
5
6
# 处理负数
if (ans & (1 << 31)) != 0:
ans -= 1 << 32

# 处理溢出
result = (n << shift_amount) & 0xFFFFFFFF

异或运算虽然看起来简单,但在算法设计中有着广泛而巧妙的应用。掌握这些核心性质和应用模式,能够帮助我们解决很多看似困难的问题。特别是在处理数组中的配对、查找问题时,异或运算往往能提供O(1)空间复杂度的优雅解法。

031【必备】位运算的骚操作

前言

位运算有很多奇技淫巧,位运算的速度非常快,仅次于赋值操作,常数时间极好!
属于是大佬骚解,左神讲解,苯人copy就对了。

特别提醒:Python实现位运算的题目需要特别注意,需要自己去手动处理溢出和符号扩展等问题。

1
2
# Python中处理溢出的常见方法
result = (n << shift_amount) & 0xFFFFFFFF

核心算法:Brian Kernighan算法

Brian Kernighan算法是位运算中的经典算法,用于提取二进制数中最右侧的1。

算法原理

1
2
# 提取最右侧的1
rightOne = n & -n

工作原理:

  1. n的二进制表示中,最右边的1右边可能有若干个0
  2. -n是n的补码表示(所有位取反后加1),所以可以进位到最右边的1,这个1左边的和n 的左边也都是完全相反的
  3. n & -n只会保留最右边的1,其余位都变成0

示例演示:

1
2
3
假设 n = 12 (二进制: 1100)
-n = -12 (二进制: ...11110100) // 补码表示
n & -n = 1100 & ...11110100 = 0100 = 4

这个算法在很多高级位运算技巧中都有应用,是理解后续算法的基础。

经典应用题目

题目1:判断一个整数是不是2的幂

问题描述:给定一个整数n,判断它是否为2的幂次方。

1
2
3
4
5
6
7
8
9
10
11
# 测试链接: https://leetcode.cn/problems/power-of-two/
def isPowerOfTwo(n):
# n > 0 确保正数
# n & -n 提取最右侧的1,如果n是2的幂,只会有一个1
# n == (n & -n) 则说明n只有一个1
return n > 0 and n == (n & -n)

# 示例用法
print(isPowerOfTwo(4)) # True (4 = 2^2)
print(isPowerOfTwo(6)) # False (6的二进制是110,有两个1)
print(isPowerOfTwo(16)) # True (16 = 2^4)

算法原理:

  • 2的幂的特点:二进制表示中只有一个1
  • 例如:1(1), 2(10), 4(100), 8(1000), 16(10000)
  • 利用Brian Kernighan算法提取最右侧的1
  • 如果提取的结果等于原数,说明只有一个1

时间复杂度:O(1)
空间复杂度:O(1)

题目2:判断一个整数是不是3的幂

问题描述:给定一个整数n,判断它是否为3的幂次方。

1
2
3
4
5
6
7
8
9
10
11
12
13
# 测试链接: https://leetcode.cn/problems/power-of-three/
def isPowerOfThree(n):
# 如果一个数字是3的某次幂,那么这个数一定只含有3这个质数因子
# 1162261467是int型范围内,最大的3的幂,它是3的19次方
# 这个1162261467只含有3这个质数因子,如果n也是只含有3这个质数因子,那么
# 1162261467 % n == 0
# 反之如果1162261467 % n != 0 说明n一定含有其他因子
return n > 0 and 1162261467 % n == 0

# 示例用法
print(isPowerOfThree(27)) # True (27 = 3^3)
print(isPowerOfThree(45)) # False (45 = 3^2 * 5)
print(isPowerOfThree(81)) # True (81 = 3^4)

算法原理:

  • 利用数论知识:如果n是3的幂,那么n只含有质数因子3
  • 1162261467 = 3^19,是32位整数范围内最大的3的幂
  • 如果n也只含有质数因子3,那么1162261467一定能被n整除
  • 这种方法引入了额外的先验知识,是一种巧妙的数学技巧

关键洞察:

  • 3^19 = 1162261467 (32位int范围内最大的3的幂)
  • 如果n是3的幂,则n只有质数因子3
  • 因此最大的3的幂能被所有较小的3的幂整除

时间复杂度:O(1)
空间复杂度:O(1)

题目3:返回大于等于n的最小的2的幂

问题描述:给定一个非负整数n,返回大于等于n的最小的2的幂次方。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
def near2power(n):
if n <= 0:
return 1 # 非正数直接返回1
n -= 1 # 先减1,保证等于2的幂时不变,这样处理可以保证:如果 n 本身就是 2 的幂,返回的还是 n 本身。
# 例如 n = 8,n-1 = 7 (0111),后面填充后再加1,结果还是 8
n |= n >> 1 #这个是或逻辑,右移1位再取或可以保证用1填充右边
n |= n >> 2
n |= n >> 4
n |= n >> 8
n |= n >> 16 # 这一坨代码的作用是把左边第一个1开始,往右的1都变成1
n += 1 # 再加1得到最小2的幂
# Python没有int溢出,可以直接返回
if n > 0x7fffffff:
return -0x80000000 # 超过int范围,返回整数最小值
return n

# 示例用法
print(near2power(100)) # 128 (2^7)
print(near2power(16)) # 16 (本身就是2的幂)
print(near2power(33)) # 64 (2^6)

算法原理详解:

让我们以n = 100为例,详细演示算法过程:

Step 1:n = 100,先减1得到n = 99

1
99 的二进制:01100011

Step 2:逐步填充最高位右边的所有位

1
2
3
4
5
6
7
8
9
10
11
n = 99        : 01100011
n >> 1 : 00110001
n |= n >> 1 : 01110011 (把最高位向右扩展1位)

n >> 2 : 00011100
n |= n >> 2 : 01111111 (继续向右扩展2位)

n >> 4 : 00000111
n |= n >> 4 : 01111111 (继续向右扩展4位)

... (8位和16位移动不会改变结果,因为数字较小)

Step 3:n + 1 = 01111111 + 1 = 10000000 = 128

核心思想:

  1. 先减1:确保如果n本身是2的幂,结果仍然是n
  2. 逐步填充:将最高位1右边的所有位都填充为1
  3. 加1:得到下一个2的幂

为什么先减1?

  • 如果n=16(10000),我们希望结果是16而不是32
  • 减1后:15(01111)
  • 填充后:15(01111)
  • 加1后:16(10000) ✓

位运算技巧解析:

1
2
3
4
5
6
# 通过连续的右移和或运算,将最高位的1向右"传播"
n |= n >> 1 # 传播1位
n |= n >> 2 # 传播2位
n |= n >> 4 # 传播4位
n |= n >> 8 # 传播8位
n |= n >> 16 # 传播16位(覆盖32位整数的所有位)

时间复杂度:O(1) - 固定数量的位运算
空间复杂度:O(1) - 只使用常数额外空间

题目4:区间[left, right]内所有数字按位与的结果

问题描述:给定两个整数left和right,返回区间[left, right]内所有数字按位与的结果。

1
2
3
4
5
6
7
8
# 测试链接: https://leetcode.cn/problems/bitwise-and-of-numbers-range/
def rangeBitwiseAnd(left, right):
while left < right:
right -= right & -right # 每次消掉right最右边的1
return right #当 left == right 时,区间内只有1个数,直接返回即可;若left>right, 也照样返回right

# 示例用法
print(rangeBitwiseAnd(5, 7)) # 输出4

算法原理:

按位与的关键特性:

  • 如果区间[left, right]内某一位在这段区间内经历了从0到1的变化,那么最终结果这一位一定为0
  • 只有left和right的公共前缀部分才可能保留为1

消去变化的位:

  • right & -right取出right的最右侧的1(最低位的1)
  • 每次把right的最右边的1消掉,right变小,靠近left
  • 只要left < right,说明区间还有变化,继续消掉最低位的1

详细示例分析:

1
2
3
4
5
6
7
8
9
10
11
区间[5, 7]的按位与:
5: 101
6: 110
7: 111
-----
结果: 100 = 4

分析过程:
- 最低位:5(1), 6(0), 7(1) → 有0有1 → 结果为0
- 第2位:5(0), 6(1), 7(1) → 有0有1 → 结果为0
- 第3位:5(1), 6(1), 7(1) → 全为1 → 结果为1

算法执行过程:

1
2
3
4
5
6
7
8
left=5(101), right=7(111)
第1次:right & -right = 111 & 001 = 001
right = 111 - 001 = 110
left=5, right=6,继续
第2次:right & -right = 110 & 010 = 010
right = 110 - 010 = 100
left=5, right=4,left > right,结束
返回right=4

时间复杂度:O(log n) - 最多执行log(right)次循环
空间复杂度:O(1)

看题目5和题目6前的提醒

  • 题目5和题目6代码看着跟脑子有大病一样,承认很强但似乎有点太嘚瑟了,是这样吗?
  • 不是的,条件判断相比于赋值、位运算、算术运算是稍慢的,所以其实有现实意义
  • 但是不需要追求在练算法过程中尽量少写条件判断,
  • 那样会带来很多不必要的困扰,还是要写尽量直白、尤其是自己能理解的代码最好
  • 大牛的实现欣赏完理解就好,下次当模版直接用
  • 还是那句话:属于是大佬骚解,左神讲解,苯人copy就对了

题目5:反转二进制位(超自然版)

问题描述:将一个32位无符号整数的二进制位完全反转。

1
2
3
4
5
6
7
8
9
10
11
12
# 测试链接: https://leetcode.cn/problems/reverse-bits/
def reverseBits(n):
# 逆序二进制的状态,分治思想:1v1 → 2v2 → 4v4 → 8v8 → 16v16
n = ((n & 0xaaaaaaaa) >> 1) | ((n & 0x55555555) << 1) # 交换奇偶位
n = ((n & 0xcccccccc) >> 2) | ((n & 0x33333333) << 2) # 交换每两位
n = ((n & 0xf0f0f0f0) >> 4) | ((n & 0x0f0f0f0f) << 4) # 交换每四位
n = ((n & 0xff00ff00) >> 8) | ((n & 0x00ff00ff) << 8) # 交换每八位
n = (n >> 16) | ((n & 0xffff) << 16) # 交换高低16位
return n & 0xffffffff # 保证结果32位

# 示例用法
print(reverseBits(43261596)) # 输出964176192

算法原理深度解析:

这是著名的位分组逆序法(Bitwise reversal by mask),采用分治思想:

第1步:交换奇偶位

1
2
3
4
5
6
7
8
# 0xaaaaaaaa = 10101010...10101010 (偶数位为1)
# 0x55555555 = 01010101...01010101 (奇数位为1)

例如:n = 11010110
奇数位(从右数第1,3,5,7位): 1_1_1_1_ = 1111
偶数位(从右数第2,4,6,8位): _1_0_0_0 = 1000

交换后:01101101

第2步:交换每两位

1
2
3
4
5
6
# 0xcccccccc = 11001100...11001100 (每两位的高位)
# 0x33333333 = 00110011...00110011 (每两位的低位)

例如:n = 01101101
分组:01|10|11|01
交换:10|01|11|10 = 10011110

第3步-5步:类似地交换4位、8位、16位

完整示例演示:

1
2
3
4
5
6
7
原数:11010110 (从左到右)
目标:01101011 (反转后)

Step1(交换奇偶位):01101101
Step2(交换每2位): 10011110
Step3(交换每4位): 11101001
Step4(交换每8位): 01101011 ✓

为什么效率极高?

  • 没有任何条件判断和循环
  • 全部是位操作:按位与、或、移位
  • 5次操作完成32位反转,而传统方法需要32次循环

时间复杂度:O(1) - 固定5次位运算
空间复杂度:O(1)

题目6:统计二进制中1的个数(超自然版)

问题描述:计算两个整数的汉明距离(二进制位不同的位置数目)。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
# 测试链接: https://leetcode.cn/problems/hamming-distance/
def hammingDistance(x, y):
return cntOnes(x ^ y) # 先异或,统计不同位数

def cntOnes(n):
# 分组统计法:每次合并相邻组的1的个数
n = (n & 0x55555555) + ((n >> 1) & 0x55555555) # 每两位一组
n = (n & 0x33333333) + ((n >> 2) & 0x33333333) # 每四位一组
n = (n & 0x0f0f0f0f) + ((n >> 4) & 0x0f0f0f0f) # 每八位一组
n = (n & 0x00ff00ff) + ((n >> 8) & 0x00ff00ff) # 每十六位一组
n = (n & 0x0000ffff) + ((n >> 16) & 0x0000ffff) # 全部加起来
return n

# 示例用法
print(hammingDistance(1, 4)) # 输出2 (1:001, 4:100, 异或:101, 有2个1)
print(cntOnes(13)) # 输出3 (13:1101, 有3个1)

算法原理深度解析:

这是分组统计法,核心思想是逐步合并局部的1的个数:

详细示例(n = 13 = 1101):

初始状态:

1
n = 1101 (二进制)

第1步:每两位统计1的个数

1
2
3
4
5
# 0x55555555 = 01010101...01010101
n & 0x55555555 = 1101 & 0101 = 0101 # 保留奇数位
(n >> 1) & 0x55555555 = 0110 & 0101 = 0100 # 保留偶数位(右移后)

相加:0101 + 0100 = 1001

此时n的每2位表示该2位内1的个数:

  • 10(二进制)= 2(十进制):前2位有2个1
  • 01(二进制)= 1(十进制):后2位有1个1

第2步:每四位统计1的个数

1
2
3
4
5
# 0x33333333 = 00110011...00110011  
n & 0x33333333 = 1001 & 0011 = 0001
(n >> 2) & 0x33333333 = 0010 & 0011 = 0010

相加:0001 + 0010 = 0011

此时n=0011,表示整个4位中有3个1。

后续步骤类似,最终得到总的1的个数,更高位依此类推,每一步后,n的每2^k位表示这2^k位内1的总个数,最终全加到最低位

状态变化图解:

1
2
3
4
5
6
原始:  1101 (每位表示原始位值)
Step1: 1001 (每2位表示该2位内1的个数)
Step2: 0011 (每4位表示该4位内1的个数)
Step3: 0011 (8位内1的个数,但只有4位所以不变)
...
最终: 3 (总共3个1)

为什么叫”分组统计”?

  1. 不是独立统计每组,而是累加合并
  2. 每步都使用上一步的统计结果
  3. 最终所有1的个数聚合到最低位

核心技巧总结:

  • 利用掩码分离不同位置的位
  • 用加法累积局部统计结果
  • 分治思想:部分→整体

时间复杂度:O(1) - 固定5次位运算
空间复杂度:O(1)

算法性能对比与应用场景

性能对比表

算法 时间复杂度 空间复杂度 核心技巧 适用场景
判断2的幂 O(1) O(1) Brian Kernighan算法 内存分配、哈希表大小
判断3的幂 O(1) O(1) 数论+预计算 数学问题、特殊判断
最小2的幂 O(1) O(1) 位填充技术 内存对齐、缓存优化
区间按位与 O(log n) O(1) 公共前缀 区间查询、数据结构
反转二进制 O(1) O(1) 分治+掩码 图像处理、编码转换
统计1的个数 O(1) O(1) 分组统计 数据压缩、校验算法

实际应用场景

1. 系统编程中的应用

1
2
3
4
5
6
7
# 内存对齐检查
def isAligned(address, alignment):
return isPowerOfTwo(alignment) and (address & (alignment - 1)) == 0

# 快速向上对齐到2的幂
def alignUp(size, alignment):
return (size + alignment - 1) & ~(alignment - 1)

2. 数据结构优化

1
2
3
4
5
6
7
8
# 哈希表大小优化
class HashTable:
def __init__(self, initial_size):
self.size = near2power(initial_size) # 确保是2的幂
self.table = [None] * self.size

def hash(self, key):
return hash(key) & (self.size - 1) # 快速取模

3. 图像处理应用

1
2
3
4
5
6
7
# 图像位操作
def mirrorImage(pixel_data):
return [reverseBits(pixel) for pixel in pixel_data]

# 图像特征提取
def hammingDistance(img1, img2):
return sum(cntOnes(p1 ^ p2) for p1, p2 in zip(img1, img2))

核心技巧模板总结

1. Brian Kernighan系列

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
# 基础:提取最右侧的1
rightOne = n & -n

# 应用1:判断2的幂
isPowerOfTwo = n > 0 and n == (n & -n)

# 应用2:清除最右侧的1
n = n & (n - 1)

# 应用3:计算1的个数(朴素版)
def countOnes(n):
count = 0
while n:
n = n & (n - 1) # 每次清除最右侧的1
count += 1
return count

2. 位填充技术模板

1
2
3
4
5
6
7
8
9
10
11
12
# 标准位填充(用于找下一个2的幂)
def fillBits(n):
n |= n >> 1
n |= n >> 2
n |= n >> 4
n |= n >> 8
n |= n >> 16
return n

def nextPowerOfTwo(n):
if n <= 1: return 1
return fillBits(n - 1) + 1

3. 分治+掩码模板

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
# 反转二进制位模板
def reverseBits(n, bits=32):
if bits == 32:
n = ((n & 0xaaaaaaaa) >> 1) | ((n & 0x55555555) << 1)
n = ((n & 0xcccccccc) >> 2) | ((n & 0x33333333) << 2)
n = ((n & 0xf0f0f0f0) >> 4) | ((n & 0x0f0f0f0f) << 4)
n = ((n & 0xff00ff00) >> 8) | ((n & 0x00ff00ff) << 8)
n = (n >> 16) | ((n & 0xffff) << 16)
return n

# 分组统计模板
def countOnes(n):
n = (n & 0x55555555) + ((n >> 1) & 0x55555555)
n = (n & 0x33333333) + ((n >> 2) & 0x33333333)
n = (n & 0x0f0f0f0f) + ((n >> 4) & 0x0f0f0f0f)
n = (n & 0x00ff00ff) + ((n >> 8) & 0x00ff00ff)
n = (n & 0x0000ffff) + ((n >> 16) & 0x0000ffff)
return n

4. Python位运算注意事项

1
2
3
4
5
6
7
8
9
10
11
12
13
# 符号处理
def handleSign(n):
if (n & (1 << 31)) != 0: # 检查符号位
n -= 1 << 32 # 转换为Python负数
return n

# 溢出检查
def checkOverflow(n):
return -0x80000000 <= n <= 0x7fffffff

# 掩码应用
def mask32bit(n):
return n & 0xffffffff

扩展思考

1. 为什么位运算如此高效?

  • CPU层面:位运算是最接近硬件的操作,执行速度极快
  • 并行性:现代CPU可以并行处理多个位
  • 无条件判断:避免了分支预测失误的性能损失

2. 什么时候不应该使用这些技巧?

  • 代码可读性:团队协作时,清晰比技巧更重要
  • 过度优化:在非性能关键路径上使用可能得不偿失
  • 平台差异:某些技巧在不同架构上表现可能不同

3. 如何掌握位运算?

  1. 理解原理:每个技巧背后的数学/逻辑基础
  2. 动手实践:在纸上画出二进制变化过程
  3. 模板化:将常用技巧整理成模板
  4. 适度应用:在合适的场景使用,不要炫技

位运算虽然看起来神秘,但其本质是对二进制数据的高效操作。掌握了这些核心技巧后,不仅能解决特定的算法问题,更能在系统编程、性能优化等场景中发挥重要作用。关键是要在”技巧性”和”可读性”之间找到平衡,让代码既高效又易维护。

参照的是左程云的课程:https://space.bilibili.com/8888480/lists/3509640?type=series
本笔记包括了基数排序的原理与实现,以及重要排序算法的性能总结与选择策略,包括了class028 -> class029的内容

028【必备】基数排序

基数排序概述

基数排序是一种非基于比较的排序算法,它通过对数字的每一位进行排序来实现整体排序。与其他基于比较的排序算法不同,基数排序对数据类型有特定要求。

测试链接:https://www.luogu.com.cn/problem/P1177

基数排序例子

基于比较 vs 非基于比较的排序

基于比较的排序:

  • 只需要定义好两个对象之间怎么比较即可
  • 对象的数据特征并不关心,很通用
  • 例如:快速排序、归并排序、堆排序等

非基于比较的排序:

  • 和比较无关的排序,对于对象的数据特征有要求
  • 并不通用,但在特定条件下效率极高
  • 例如:计数排序、桶排序、基数排序

从计数排序到基数排序

计数排序

计数排序是最简单的非比较排序算法:

  • 用一个数组或哈希表来记录每个数字出现的次数
  • 遍历数组统计,然后按顺序输出
  • 限制:数值范围比较大时就不实用了

桶排序

桶排序是计数排序的升级版:

  • 将数据分到有限数量的桶里,然后对每个桶再分别排序,最后合并
  • 计数排序可以看成每个桶只存储相同元素
  • 桶排序每个桶存储一定范围的元素
  • 需要确定两个信息:桶的数量和每个桶的区间范围

桶排序例子

基数排序

基数排序进一步优化了桶的使用:

  • 按位进行排序,比如先按个位数字放进桶里再倒出,再按十位数字放进桶里再倒出
  • 这样就得到一个有序的序列

基数排序的核心思想

基数排序采用**LSD(Least Significant Digit)**策略,从最低位开始排序:

  1. 从个位开始:按个位数字进行计数排序
  2. 依次向高位:按十位、百位、千位…依次排序
  3. 保持稳定性:每次排序都要保持之前排序的相对顺序

关键点:

  • 前缀数量分区的技巧
  • 数字提取某一位的技巧
  • 时间复杂度O(n),额外空间复杂度O(m)

基数排序实现详解

核心代码结构

1
2
3
4
5
6
7
8
# 可以设置进制,不一定10进制
BASE = 10 # 基数,当前设置为10进制

MAXN = 100001 # 最大数据量
arr = [0] * MAXN # 存储待排序数组
help_arr = [0] * MAXN # 辅助数组
cnts = [0] * BASE # 计数数组
n = 0 # 元素数量

处理负数的技巧

由于基数排序要求非负整数,需要特殊处理负数:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
def sort():
# 找到数组中的最小值
min_val = arr[0]
for i in range(1, n):
min_val = min(min_val, arr[i])

max_val = 0
for i in range(n):
arr[i] -= min_val # 全部减去最小值,转为非负数
max_val = max(max_val, arr[i])

# 根据最大值在BASE进制下的位数,决定基数排序做多少轮
radixSort(bits(max_val))

# 数组中所有数都减去了最小值,所以最后不要忘了还原
for i in range(n):
arr[i] += min_val

进位得到数字

计算位数

1
2
3
4
5
6
7
def bits(number):
"""返回number在BASE进制下有几位"""
ans = 0
while number > 0:
ans += 1
number //= BASE
return ans

基数排序核心算法

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
def radixSort(bits_):
"""
基数排序核心代码
arr内要保证没有负数
bits_是arr中最大值在BASE进制下有几位
"""
offset = 1 # 当前位权重

for _ in range(bits_):
# 每一轮针对某一位排序

# 1. 计数数组清零
for i in range(BASE):
cnts[i] = 0

# 2. 统计该位各数字出现次数
for i in range(n):
cnts[(arr[i] // offset) % BASE] += 1

# 3. 转换为前缀和(确定位置)
for i in range(1, BASE):
cnts[i] += cnts[i - 1]

# 4. 从后往前放入辅助数组(保证稳定性)
for i in range(n - 1, -1, -1):
idx = (arr[i] // offset) % BASE # 该位的值
cnts[idx] -= 1
help_arr[cnts[idx]] = arr[i]

# 5. 拷回原数组
for i in range(n):
arr[i] = help_arr[i]

offset *= BASE # 下一位

算法详细步骤演示

以数组 [170, 45, 75, 90, 2, 802, 24, 66] 为例:

初始数组:[170, 45, 75, 90, 2, 802, 24, 66]

第一轮(个位排序)

Step 1 - 统计个位数字:

1
2
个位: [0, 5, 5, 0, 2, 2, 4, 6]
cnts: [2, 0, 2, 0, 1, 2, 1, 0, 0, 0]

Step 2 - 计算前缀和:

1
cnts: [2, 2, 4, 4, 5, 7, 8, 8, 8, 8]

Step 3 - 从后往前放置:

1
结果: [170, 90, 2, 802, 24, 45, 75, 66]

第二轮(十位排序)

Step 1 - 统计十位数字:

1
2
十位: [7, 9, 0, 0, 2, 4, 7, 6]
cnts: [2, 0, 1, 0, 1, 0, 1, 2, 0, 1]

Step 2 - 计算前缀和并放置:

1
结果: [2, 802, 24, 45, 66, 170, 75, 90]

第三轮(百位排序)

最终结果:[2, 24, 45, 66, 75, 90, 170, 802]

稳定性保证

基数排序的稳定性通过以下方式保证:

  1. 从后往前处理:在放入辅助数组时从后往前遍历原数组
  2. 前缀和技巧:使用前缀和确定每个元素在结果数组中的准确位置
  3. 逐位处理:每一位的排序都保持前一位排序的相对顺序
1
2
3
4
5
# 关键:从后往前,确保稳定性
for i in range(n - 1, -1, -1):
idx = (arr[i] // offset) % BASE
cnts[idx] -= 1
help_arr[cnts[idx]] = arr[i]

复杂度分析

时间复杂度:O(n)

  • 设最大数有d位,需要进行d轮排序
  • 每轮排序需要O(n + k)时间,其中k是基数(通常k=10)
  • 总时间复杂度:O(d × (n + k)) ≈ O(n)

空间复杂度:O(m)

  • m为基数大小,需要辅助空间做类似桶的作用
  • 包括辅助数组help_arr和计数数组cnts

应用限制

一般来讲,基数排序要求:

  • 样本是10进制的非负整数
  • 如果不是就需要转化(如代码中处理负数的方式)
  • 可以设置任何进制来进行排序

局限性:

  • 一旦比较的对象不再是常规数字,改写代价显著增加
  • 不基于比较的排序并不通用

029【必备】重要排序算法的总结

排序算法稳定性

稳定性定义

排序算法的稳定性是指:同样大小的样本在排序之后不会改变原始的相对次序。

重要性:

  • 稳定性对基础类型对象来说毫无意义
  • 稳定性对非基础类型对象有意义,可以保留之前的相对次序

主要排序算法性能总结

排序算法 时间复杂度 空间复杂度 稳定性 备注
SelectionSort
选择排序
O(N²) O(1) ❌ 因为是随机的交换
BubbleSort
冒泡排序
O(N²) O(1) ✅ 数学归纳法可以保证
InsertionSort
插入排序
O(N²) O(1) ✅ 相等会直接停,能够保证稳定性
MergeSort
归并排序
O(N log N) O(N) ✅ 左右两边的区域满足偏序性
QuickSort
快速排序
O(N log N) O(log N) ❌ 普通的是固定选择,随机的随机选择
HeapSort
堆排序
O(N log N) O(1) ❌ 建堆的过程根本不在乎稳不稳定
CountSort
计数排序
O(N) O(M) ✅ 入桶和出桶的过程是按次序的
RadixSort
基数排序
O(N) O(M) ✅ 同计数排序

关键说明

随机快速排序的复杂度:

  • 一定要按照概率上的期望指标来估计
  • 用最差的复杂度估计无意义
  • 随机快排的详细说明在之前的视频中已有详细解释

重要结论:

基于比较的排序,时间复杂度O(n log n),空间复杂度低于O(n),还具有稳定性的排序算法目前没有找到

TimSort说明:

  • TimSort也不行,虽然在实际应用中通常不需要这么多的额外空间
  • 但空间复杂度指标就是O(n)
  • 在算法面试、笔试、比赛中都很少用到

希尔排序(ShellSort):

  • 也不常用,就是加入步长调整的插入排序
  • 有兴趣的同学可以研究一下

排序算法选择策略

排序算法的选择完全取决于你在排序过程中在乎什么:

1. 数据量非常小的情况

推荐:插入排序

  • 可以做到非常迅速
  • 实现简单,常数项小
  • 很多高级排序算法在小数据量时会切换到插入排序

2. 性能优异 + 实现简单 + 不在乎稳定性

推荐:随机快速排序

  • 性能优异,期望时间复杂度O(n log n)
  • 实现简单且利于改进
  • 面对不同业务可以选择不同划分策略
  • 空间复杂度较小O(log n)

3. 性能优异 + 需要稳定性 + 不在乎额外空间

推荐:归并排序

  • 性能优异,稳定的O(n log n)时间复杂度
  • 具有稳定性
  • 适合外部排序(大数据量)
  • 空间复杂度O(n)

4. 性能优异 + 额外空间要求O(1) + 不在乎稳定性

推荐:堆排序

  • 性能优异,稳定的O(n log n)时间复杂度
  • 额外空间占用O(1)
  • 最坏情况下性能依然稳定
  • 不具有稳定性

5. 特定数据特征 + 追求极致性能

推荐:基数排序/计数排序

  • 在特定条件下可以达到O(n)时间复杂度
  • 对数据类型有严格要求
  • 适用于整数排序且范围有限的场景

实际应用建议

编程竞赛/面试

  1. 快速排序:最常考查,需要熟练掌握
  2. 归并排序:稳定性要求时的首选
  3. 堆排序:空间复杂度有严格限制时

工程实践

  1. 小数组:插入排序
  2. 大数组:快速排序(随机化)
  3. 需要稳定性:归并排序
  4. 内存敏感:堆排序
  5. 特殊数据:计数排序/基数排序

语言内置排序

大多数编程语言的内置排序算法都是混合算法:

  • Python:Timsort(归并+插入的混合)
  • Java:双轴快排(小数组时用插入排序)
  • C++:通常是内省排序(快排+堆排序+插入排序的混合)

总结

理解各种排序算法的特点和适用场景比单纯记忆算法更重要。在实际应用中,需要根据具体需求(数据规模、稳定性要求、空间限制等)来选择合适的排序算法。基数排序作为非比较排序的代表,在特定场景下能够突破O(n log n)的理论下界,达到线性时间复杂度。

前言

参照的是左程云的课程:https://space.bilibili.com/8888480/lists/3509640?type=series

本笔记涵盖了堆的基本概念与堆排序、哈希表的实现以及堆结构的一些相关习题,包括了class025→027的内容。

025【必备】堆结构和堆排序

堆的基本概念

什么是堆

堆是一种特殊的完全二叉树结构,通常用数组来实现存储。堆有以下特性:

  1. 结构性质:堆是完全二叉树,即除了最后一层,其他层都是满的,最后一层从左到右连续填充
  2. 堆序性质:
    • 大根堆:任何一个子树内部的最大值一定在顶部(父节点 ≥ 子节点)
    • 小根堆:任何一个子树内部的最小值一定在顶部(父节点 ≤ 子节点)

堆的数组表示

堆使用数组实现,通过下标关系来表示父子关系:

1
2
3
4
5
6
7
8
# 对于下标为 i 的节点:
parent = (i - 1) // 2 # 父节点下标
left_child = i * 2 + 1 # 左孩子下标
right_child = i * 2 + 2 # 右孩子下标

# 判断是否有孩子节点:
# 如果 left_child >= size,则没有左孩子
# 如果 right_child >= size,则没有右孩子

堆结构→完全二叉树

堆的核心操作

堆有两个核心调整操作,时间复杂度都是 O(log n):

  1. heapInsert(向上调整):新元素插入后向上调整维持堆性质
  2. heapify(向下调整):删除堆顶后向下调整维持堆性质

堆的核心算法实现

heapInsert - 向上调整

当在堆的末尾插入新元素时,需要向上调整以维持堆的性质:

1
2
3
4
5
6
7
8
def heapInsert(i):
"""
i位置的数,向上调整大根堆
时间复杂度:O(logn)
"""
while arr[i] > arr[(i - 1) // 2]: # 当前节点大于父节点时
swap(i, (i - 1) // 2) # 与父节点交换
i = (i - 1) // 2 # 更新当前位置为父节点位置

算法流程:

  1. 比较当前节点与其父节点的值
  2. 如果当前节点更大(大根堆),则交换
  3. 向上移动到父节点位置,重复过程
  4. 直到满足堆性质或到达根节点

测试链接:https://www.luogu.com.cn/problem/P1177

大根堆的堆插入

heapify - 向下调整

当删除堆顶元素后,需要向下调整以维持堆的性质:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
def heapify(i, size):
"""
i位置的数,向下调整大根堆
当前堆的大小为size
时间复杂度:O(logn)
"""
l = i * 2 + 1 # 左孩子
while l < size: # 如果左孩子存在
# 选出左右孩子中更大的那个
best = l + 1 if (l + 1 < size and arr[l + 1] > arr[l]) else l
# 当前节点和最强孩子之间,选出最强的
best = best if arr[best] > arr[i] else i
if best == i: # 如果当前节点最大,调整完成
break
swap(best, i) # 交换
i = best # 移动到交换后的位置
l = i * 2 + 1 # 更新左孩子
# 1.找到更大的子节点:比较左右子节点,选出值更大的那个
# 2.与父节点比较:将较大的子节点与当前父节点比较
# 3.决定是否交换:如果子节点更大就交换,否则停止调整
# 4.继续向下:交换后继续对新位置进行同样的操作

算法流程:

  1. 找到更大的子节点:比较左右子节点,选出值更大的那个
  2. 与父节点比较:将较大的子节点与当前父节点比较
  3. 决定是否交换:如果子节点更大就交换,否则停止调整
  4. 继续向下:交换后继续对新位置进行同样的操作

堆排序的两种实现

方法一:从顶到底建堆(经典版本)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
def heapSort1():
"""
完全二叉树的节点为N的话,高度是log_2(N)的水平
从顶到底建立大根堆,从顶到底建立大根堆,O(n * logn),每次排好一个数,排n个数要n次,每排一个数时间复杂度是logn,排n个数当然是nlogn
依次弹出堆内最大值并排好序,O(n * logn)
整体时间复杂度O(n * logn)
"""
# 建堆阶段:从第一个元素开始,依次插入
for i in range(n):
heapInsert(i) # 每个元素向上调整

# 排序阶段:不断取出最大值
size = n
while size > 1:
swap(0, size - 1) # 将最大值(堆顶)放到数组末尾
size -= 1 # 减少堆的大小
heapify(0, size) # 对新的堆顶进行向下调整

时间复杂度分析:

  • 建堆阶段:log₁ + log₂ + log₃ + ... + logₙ =(收敛于) O(n logn)
  • 排序阶段:每次调整 O(log n),共 n-1 次,总计 O(n logn)
  • 总时间复杂度:O(n logn)

从底部到顶部的堆排序
从底部到顶部的堆排序-复杂度分析

方法二:从底到顶建堆(优化版本)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
def heapSort2():
"""
从底到顶建立大根堆,O(n)
依次弹出堆内最大值并排好序,O(n * logn)
整体时间复杂度O(n * logn)
"""
# 建堆阶段:从最后一个非叶子节点开始,向前调整
for i in range(n - 1, -1, -1):
heapify(i, n)

# 排序阶段:与方法一相同
size = n
while size > 1:
swap(0, size - 1)
size -= 1
heapify(0, size)
# 这种方法更像修理一栋破房子,从最下面的楼层开始修。建堆阶段只需要O(n)时间,具体是从最后一个非叶子节点开始逐个向前调整,每个节点只需要"向下看"把不合格的子节点换上来,由于采用从底向上的策略效率更高。
# 排序阶段的做法与方法1相同,先取堆顶元素放到合适位置,然后重新调整剩余元素成堆并重复进行。整体而言方法2更优,因为它的建堆过程比方法1快了一个数量级,从O(n logn)优化到了O(n)

两种排序方法对比
为什么从底到顶建堆更快?

从底到顶建堆的时间复杂度是 O(n),这是因为:

  1. 叶子节点无需调整:完全二叉树中约有 n/2 个叶子节点,它们天然满足堆性质
  2. 调整距离递减:越靠近叶子的节点,需要向下调整的最大距离越小
  3. 数学分析:可以证明总的调整代价是一个等比数列,收敛到 O(n)

两种方法的对比:

建堆方法 建堆复杂度 排序复杂度 总复杂度 特点
从顶到底 O(n logn) O(n logn) O(n logn) 逐个插入元素”爬楼梯”
从底到顶 O(n) O(n logn) O(n logn) 从下往上”修房子”

完整代码实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
import sys
import random

MAXN = 100001
arr = [0] * MAXN
n = 0

def main():
global n
data = sys.stdin.read().split()
n = int(data[0])
for i in range(n):
arr[i] = int(data[i + 1])

heapSort2() # 使用优化版本

# 高效输出
sys.stdout.write(' '.join(str(arr[i]) for i in range(n - 1)))
sys.stdout.write(' ' + str(arr[n - 1]) + '\n')

def heapInsert(i):
while arr[i] > arr[(i - 1) // 2]:
swap(i, (i - 1) // 2)
i = (i - 1) // 2

def heapify(i, size):
l = i * 2 + 1
while l < size:
best = l + 1 if (l + 1 < size and arr[l + 1] > arr[l]) else l
best = best if arr[best] > arr[i] else i
if best == i:
break
swap(best, i)
i = best
l = i * 2 + 1

def swap(i, j):
arr[i], arr[j] = arr[j], arr[i]

def heapSort1():
for i in range(n):
heapInsert(i)
size = n
while size > 1:
swap(0, size - 1)
size -= 1
heapify(0, size)

def heapSort2():
for i in range(n - 1, -1, -1):
heapify(i, n)
size = n
while size > 1:
swap(0, size - 1)
size -= 1
heapify(0, size)

if __name__ == "__main__":
main()

堆排序的特点总结

优点

  1. 时间复杂度稳定:无论什么数据,时间复杂度都是 O(n logn)
  2. 原地排序:额外空间复杂度 O(1),直接在原数组上建堆
  3. 不稳定但可预测:虽然不是稳定排序,但性能可预测

缺点

  1. 不稳定:相同元素的相对位置可能改变
  2. 常数因子较大:虽然渐进复杂度优秀,但实际运行时常数因子比快排大
  3. 缓存友好性差:堆调整过程中的访问模式对CPU缓存不太友好

应用场景

  1. 优先队列:堆是实现优先队列的最佳数据结构
  2. Top-K 问题:找出最大或最小的K个元素
  3. 实时数据流:需要实时维护最值的场景
  4. 任务调度:按优先级处理任务

重要提示

堆结构比堆排序有用得多,尤其是和比较器结合之后。堆排序只是堆数据结构的一个应用,堆在实际开发中更多用于实现优先队列、解决Top-K问题等场景。

026【必备】哈希表、有序表和比较器的用法

哈希表(Hash Table)的基本概念

什么是哈希表?

哈希表是一种数据结构,它通过键(key)来直接访问存储在值(value)中的数据,实现快速查找、插入和删除操作。

大概约等于python中的字典啦

核心思想

  1. 将数据存储在数组中
  2. 通过哈希函数将key转换为数组索引
  3. 理想情况下,查找、插入、删除的时间复杂度都是O(1)

工作原理

1
Key → 哈希函数 → 数组索引 → 存储位置

哈希表的特点

  • 时间复杂度:增、删、改、查时间为O(1),但是大常数
  • 空间换时间:用额外的空间来换取时间效率
  • 两种形式:
    • HashSet:只存储键,用于判断元素是否存在
    • HashMap:存储键值对,根据键快速找到对应的值

Python中的哈希表实现

字符串的比较机制

Python中字符串有特殊的驻留机制,需要注意is和==的区别:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
# 字符串比较
str1 = str("Hello")
str2 = str("Hello") # 不同内存地址,但是内容都是Hello

# 比较对象身份(内存地址)
print(str1 is str2) # 可能是True(驻留机制)

# 比较值(内容)
print(str1 == str2) # True,内容一样

# 动态生成的字符串
s3 = ''.join(['a', 'b', 'c'])
print(s1 == s3) # True
print(s1 is s3) # False,复杂或动态生成的字符串,is一般是False

重要概念:

  • 字符串驻留:Python对于短小、常用的字符串可能会优化,放到同一个内存地址
  • 内容比较 vs 身份比较:==比较内容,is比较内存地址

set操作(HashSet)

1
2
3
4
5
6
7
8
9
10
11
12
13
# set判断元素是否相等靠内容,不看对象id
str1 = str("Hello")
str2 = str("Hello") # 不同内存地址,但是内容都是Hello

s = set()
s.add(str1)
print("Hello" in s) # True
print(str2 in s) # True
s.add(str2)
print(len(s)) # 1,因为set里不会存储重复元素
s.discard(str1) # 删除等价元素(内容相等的字符串都会被删掉)
s.clear() # 清空所有元素
print(len(s) == 0) # True

dict操作(HashMap)

1
2
3
4
5
6
7
8
9
10
11
12
# dict操作
map1 = dict()
map1[str1] = "World" # str1是key,"World"是value
print("Hello" in map1) # True
print(str2 in map1) # True
print(map1.get(str2)) # World
print(map1.get("你好") is None) # True
if "Hello" in map1:
del map1["Hello"]
print(len(map1)) # 0
map1.clear()
print(len(map1) == 0) # True

哈希表的优化策略

数组替代哈希表

当key的范围是固定的、可控的情况下,可以用数组结构替代哈希表结构:

1
2
3
4
5
6
7
8
9
10
11
12
13
# 哈希表实现
map2 = dict()
map2[56] = 7285
map2[34] = 3671263
map2[17] = 716311
map2[24] = 1263161

# 数组替代实现(速度更快)
arr = [0] * 100
arr[56] = 7285
arr[34] = 3671263
arr[17] = 716311
arr[24] = 1263161

优势:

  • 速度更快:直接数组访问,无需哈希计算
  • 空间可控:预知范围,精确分配空间
  • 无哈希冲突:避免了哈希表的冲突处理

自定义对象作为Key

1
2
3
4
5
6
7
8
9
10
11
12
13
class Student:
def __init__(self, age, name):
self.age = age
self.name = name

s1 = Student(17, "张三")
s2 = Student(17, "张三")
map3 = dict()
map3[s1] = "这是张三"
print(s1 in map3) # True
print(s2 in map3) # False,Python默认不同对象hash不同
map3[s2] = "这是另一个张三"
print(len(map3)) # 2,s1和s2是不同的对象,字典中有两个键值对

重要提示:Python自定义对象没有实现__eq__和__hash__时,默认按对象id判定。

有序表(TreeMap/TreeSet)

Python中的有序表模拟

Python没有内置的TreeMap,需要用其他方式模拟:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
import heapq

# 用dict+排序模拟TreeMap
tree_map = dict()
tree_map[5] = "这是5"
tree_map[7] = "这是7"
tree_map[1] = "这是1"
tree_map[2] = "这是2"
tree_map[3] = "这是3"
tree_map[4] = "这是4"
tree_map[8] = "这是8"

print(1 in tree_map) # True
print(10 in tree_map) # False
print(tree_map.get(4)) # 这是4
tree_map[4] = "张三是4"
print(tree_map.get(4)) # 张三是4

tree_map.pop(4, None) # 删除key为4的键值对
print(tree_map.get(4) is None) # True

有序表的特殊操作

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
# firstKey 和 lastKey 需要排序
keys = sorted(tree_map.keys())
print(keys[0]) # firstKey: 1
print(keys[-1]) # lastKey: 8

# floorKey: 所有的key,<= 4且最近的key是什么
def floor_key(k):
return max([x for x in tree_map if x <= k], default=None)

# ceilingKey: 所有的key,>= 4且最近的key是什么
def ceiling_key(k):
return min([x for x in tree_map if x >= k], default=None)

print(floor_key(4)) # 3
print(ceiling_key(4)) # 5

操作解释:

  • 删除前:1, 2, 3, [4], 5, 7, 8
  • 删除后:1, 2, 3, 5, 7, 8
  • floor_key(4):找到 ≤ 4 的最大值,可选值:[1, 2, 3],最大值:3
  • ceiling_key(4):找到 ≥ 4 的最小值,可选值:[5, 7, 8],最小值:5

TreeSet模拟

1
2
3
4
5
6
7
8
9
10
11
# TreeSet模拟:用set+排序(去重且有序)
s = set()
s.add(3)
s.add(3)
s.add(4)
s.add(4)
print("有序表大小:", len(s)) # 2,因为set里不会存储重复元素

# 以有序弹出
for item in sorted(s):
print(item) # 3 4

优先队列(堆)

小根堆

1
2
3
4
5
6
7
8
9
# 小根堆
heap1 = []
heapq.heappush(heap1, 3)
heapq.heappush(heap1, 4)
print("堆大小:", len(heap1)) # 4
while heap1:
print(heapq.heappop(heap1)) # 3 3 4 4

大根堆实现技巧

1
2
3
4
5
6
7
# 大根堆trick:使用负数
heap2 = []
for x in [3, 3, 4, 4]:
heapq.heappush(heap2, -x)
print("堆大小:", len(heap2)) # 4
while heap2:
print(-heapq.heappop(heap2)) # 4 4 3 3

核心技巧:Python的heapq只提供小根堆,要实现大根堆可以将所有元素取负数。

比较器的使用

基本比较器概念

任何比较器都有统一的规则:

  • 返回负数:认为第一个对象优先级更高
  • 返回正数:认为第二个对象优先级更高
  • 返回0:两个对象优先级相等

员工类的排序示例

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
from functools import cmp_to_key

class Employee:
def __init__(self, company, age):
self.company = company
self.age = age

def __repr__(self):
return f"Employee({self.company}, {self.age})"

# 员工比较器,按年龄升序
def employee_comparator(o1, o2):
return o1.age - o2.age

# 创建员工对象
s1 = Employee(2, 27)
s2 = Employee(1, 60)
s3 = Employee(4, 19)
s4 = Employee(3, 23)
s5 = Employee(1, 35)
s6 = Employee(3, 55)
arr = [s1, s2, s3, s4, s5, s6]

# 按年龄升序排序
arr.sort(key=cmp_to_key(employee_comparator))
for e in arr:
print(f"{e.company}, {e.age}")

多种排序方式

1
2
3
4
5
6
7
8
9
# 按年龄降序排序(lambda表达式)
arr.sort(key=lambda x: -x.age)
for e in arr:
print(f"{e.company}, {e.age}")

# 多级排序:先按公司编号,再按年龄
arr.sort(key=lambda x: (x.company, x.age))
for e in arr:
print(f"{e.company}, {e.age}")

自定义对象的去重策略

按年龄去重

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
class EmployeeByAge(Employee):
def __eq__(self, other):
return self.age == other.age # 只看年龄

def __hash__(self):
return hash(self.age)

treeSet1 = set()
for e in arr:
treeSet1.add(EmployeeByAge(e.company, e.age))
print(len(treeSet1)) # 6

# 会去重,因为age一样的员工被认为是同一个
treeSet1.add(EmployeeByAge(2, 27))
print(len(treeSet1)) # 6

按多个属性去重

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
class EmployeeByAll(Employee):
def __eq__(self, other):
if not isinstance(other, EmployeeByAll):
return False
return (self.company == other.company and
self.age == other.age and
repr(self) == repr(other))

def __hash__(self):
return hash((self.company, self.age, repr(self)))

treeSet2 = set()
for e in arr:
treeSet2.add(EmployeeByAll(e.company, e.age))
print(len(treeSet2)) # 6

# 不会去重,因为repr不同(内存地址不同)
treeSet2.add(EmployeeByAll(2, 27))
print(len(treeSet2)) # 7

重要概念:

  • __eq__方法:定义对象间的相等性比较,当使用==操作符时调用
  • __hash__方法:定义对象的哈希值,用于在集合和字典中作为键

字符串的字典序比较

1
2
3
4
5
6
7
8
9
# 字典序比较
str1 = "abcde"
str2 = "ks"
print(str1.__lt__(str2) - str1.__gt__(str2)) # -1
print(str2.__lt__(str1) - str2.__gt__(str1)) # 1

# 或者直接用比较运算符
print((str1 > str2) - (str1 < str2)) # -1
print((str2 > str1) - (str2 < str1)) # 1

字典序规则:按字符的ASCII码逐位比较,先遇到不同字符的位置决定大小关系。

数据结构选择指南

性能对比表

数据结构 查找 插入 删除 有序性 去重 适用场景
set O(1) O(1) O(1) ❌ ✅ 快速查重、集合运算
dict O(1) O(1) O(1) ❌ ✅ 键值映射、缓存
数组 O(1) O(1) O(1) ❌ ❌ key范围可控时替代哈希表
排序列表 O(log n) O(n) O(n) ✅ ❌ 需要有序且查找频繁
heapq O(1) O(log n) O(log n) 部分 ❌ 优先队列、Top-K问题

使用建议

  1. 快速查找、去重:使用set
  2. 键值映射:使用dict
  3. key范围固定:考虑数组替代哈希表
  4. 需要有序:使用排序+二分查找或第三方库
  5. 优先队列:使用heapq
  6. 自定义排序:实现比较器或使用key参数

实际应用场景

场景1:统计词频

1
2
3
4
5
6
# 使用dict统计
text = "hello world hello python"
word_count = {}
for word in text.split():
word_count[word] = word_count.get(word, 0) + 1
print(word_count) # {'hello': 2, 'world': 1, 'python': 1}

场景2:去重并保持顺序

1
2
3
4
5
6
7
8
9
10
11
12
# 使用dict保持插入顺序的去重
def dedupe_keep_order(items):
seen = {}
result = []
for item in items:
if item not in seen:
seen[item] = True
result.append(item)
return result

items = [1, 2, 3, 2, 4, 1, 5]
print(dedupe_keep_order(items)) # [1, 2, 3, 4, 5]

场景3:Top-K问题

1
2
3
4
5
6
7
8
9
10
11
12
13
14
import heapq

def find_top_k(nums, k):
# 使用小根堆,维护k个最大元素
heap = []
for num in nums:
if len(heap) < k:
heapq.heappush(heap, num)
elif num > heap[0]:
heapq.heapreplace(heap, num)
return sorted(heap, reverse=True)

nums = [3, 1, 4, 1, 5, 9, 2, 6, 5, 3, 5]
print(find_top_k(nums, 3)) # [9, 6, 5]

总结

  1. 哈希表:提供O(1)的查找、插入、删除,但有较大常数因子
  2. 有序表:在Python中需要模拟实现,适合需要有序性的场景
  3. 比较器:统一的优先级比较规则,负数表示第一个对象优先级更高
  4. 优化策略:key范围可控时用数组替代哈希表,性能更好
  5. 实际应用:根据具体需求选择合适的数据结构,考虑时间复杂度和空间复杂度的权衡

027【必备】堆结构常见题

Python heapq 模块详解

heapq 基本概念

heapq 是 Python 标准库提供的”二叉堆”实现工具,基于列表实现的最小堆(min-heap)。它能在 O(log n) 时间内插入与弹出最小元素,heap[0] 永远是当前最小值。

常用 API

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
import heapq

# 基本操作
heapq.heappush(heap, item) # 压入元素,O(log n)
heapq.heappop(heap) # 弹出最小元素,O(log n)
heapq.heapify(lst) # 原地把列表转成堆,O(n)

# 高效组合操作
heapq.heappushpop(heap, item) # 先推入再弹出(更高效的一步)
heapq.heapreplace(heap, item) # 先弹出最小再推入

# 实用函数
heapq.nsmallest(n, iterable) # 返回n个最小元素
heapq.nlargest(n, iterable) # 返回n个最大元素
heapq.merge(*iterables) # 合并多个已排序可迭代对象(惰性生成)

大根堆实现技巧

由于 Python 的 heapq 只提供小根堆,实现大根堆需要使用负数技巧:

1
2
3
4
5
6
# 大根堆实现
heap = []
for x in [3, 1, 4, 1, 5]:
heapq.heappush(heap, -x) # 插入负数

max_val = -heapq.heappop(heap) # 弹出并转回正数

问题一:合并K个有序链表

测试链接:https://www.nowcoder.com/practice/65cfde9e5b9b4cf2b6bafa5f3ef33fa6

问题描述

给定K个有序链表,将它们合并成一个有序链表。

算法思路

使用小根堆维护所有链表的当前头节点,每次取出值最小的节点:

  1. 初始化:将所有链表的头节点放入堆中
  2. 合并过程:
    • 弹出堆顶最小节点,连接到结果链表
    • 如果该节点有下一个节点,将下一个节点入堆
    • 重复直到堆为空

合并k个有序链表-小根堆版

核心实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
import heapq
from typing import List, Optional

class ListNode:
def __init__(self, val=0, next=None):
self.val = val
self.next = next

def mergeKLists(arr: List[Optional[ListNode]]) -> Optional[ListNode]:
# 小根堆,存储节点及其值,用堆结构的话时间复杂度会比O(NlogN)更小
# Optional[T] 等价于 Union[T, None]
# 表示这个值可能是 T 类型,也可能是 None
heap = []

# 将所有链表头节点入堆
for h in arr:
if h is not None:
# Python的heapq不能直接比较对象,需包装
heapq.heappush(heap, (h.val, id(h), h))
# heapq 比较规则:它按元组字典序比较。你放入 (val, something, node) 时,先比 val,相等就比第二个元素;如果第二个也相等,就会去比第三个元素(即 ListNode 实例)。
# 问题:ListNode 没有定义大小比较,直接比较会抛出 TypeError: '<' not supported...
# 加入 id(node):id 是对象在该进程生命周期内的唯一“身份值”(可比较),作为“决胜键”保证元组能比较出大小,从而避免直接比较 ListNode。
if not heap:
return None

# 弹出一个节点作为总头部
_, _, h = heapq.heappop(heap)
pre = h

# 将该节点的下一个节点入堆
if pre.next is not None:
heapq.heappush(heap, (pre.next.val, id(pre.next), pre.next))

# 继续合并过程
while heap:
_, _, cur = heapq.heappop(heap)
pre.next = cur # 连接链表
pre = cur # pre后移
if cur.next is not None:
heapq.heappush(heap, (cur.next.val, id(cur.next), cur.next))

return h
# 对 heapq 来说,一个 item 就是一个可比较的对象。这里把一个三元组 (pre.next.val, id(pre.next), pre.next) 当作 item 放入堆。
# 比较顺序(字典序):
# 先比第 1 位 pre.next.val(值越小,优先级越高)
# 若相等,再比第 2 位 id(pre.next)(保证能比较出大小,避免去比较 ListNode 本身)
# 只在前两位都相等时,才会看第 3 位 pre.next(但通常不会用到,因为 id 已经唯一)

关键技术点

元组比较机制:

  • heapq 按元组字典序比较:(val, something, node)
  • 先比较 val,相等时比较第二个元素
  • 加入 id(node) 作为”决胜键”,避免直接比较 ListNode 对象

为什么需要 id(node):

  • ListNode 没有定义大小比较,直接比较会抛出 TypeError
  • id() 返回对象的唯一标识符,可以进行比较
  • 保证元组能比较出大小,避免直接比较 ListNode

复杂度分析

  • 时间复杂度:O(N log K),其中 N 是所有节点总数,K 是链表个数
  • 空间复杂度:O(K),堆中最多存储 K 个节点
    合并k个有序链表-复杂度分析

问题二:最多线段重合问题

测试链接:

问题描述

给定n条线段,每条线段有起点和终点,求最多同时重合的线段数量。

算法思路

使用扫描线算法 + 小根堆:

  1. 排序:将所有线段按起点排序
  2. 扫描:从左到右处理每条线段
  3. 维护堆:堆中存储当前重合线段的结束时间
  4. 清理:移除已结束的线段(结束点 ≤ 当前起点)
  5. 更新:添加当前线段,更新最大重合数

最大重合线段数

核心实现

  • 想象每条线段根据开始和结束位置,放在x轴上,然后有一根竖线,从左到右划过x轴,竖线压中的线段上的点,就需要把当前点放入到某个组里。

  • 请问,从左到右划的过程,你最多需要准备几个组?最多重合几条线段,就需要几个组。这些组不断复用空间,放入不同的点。但是最大重合了多少,你就需要准备几个组。

  • 重要:我之前一直在纠结为什么不要考虑后面重复合并, 但是我们这个代码已经考虑了后面重复合并,因为我们是把结束点加入到堆里,而不是把线段加入到堆里。因此即便这条线段的结束点和后面的线段的开始点重合,我们也会把这条线段的结束点加入到堆里,则以这个为标准对数轴进行扫描,又因为小根堆是根据开始点进行从小大排序的,所以能够保证后面的线段初始点严格小于当前线段的初始点,不会忽略到后面的线段重合,这个是个离散的逐点扫描的过程。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
import heapq

def compute():
"""
# 时间复杂度:O(NlogN) ,n条线段,平均比较次数是logN,所以是O(NlogN)
# 空间复杂度:O(N),因为需要存储每条线段的结束点"""
global size
size = 0 # 堆的清空

# 所有线段根据开始位置排序
sorted_lines = sorted(line[:n], key=lambda x: x[0])

ans = 0 # 最大重合数
for i in range(n):
# 步骤1:清理已结束的线段
while size > 0 and heap[0] <= sorted_lines[i][0]:
# 堆顶是最早结束的线段
# 如果它的结束点 ≤ 当前线段的起点,说明已经不重合了
pop() # 移除这个已结束的线段

# 步骤2:加入当前线段
add(sorted_lines[i][1]) # 把当前线段的结束点加入堆

# 步骤3:更新答案
ans = max(ans, size) # 当前堆的大小 = 当前重合的线段数

return ans

算法可视化

想象一根竖线从左到右扫过数轴:

1
2
3
4
5
6
7
8
9
10
线段1: |-------|
线段2: |-----|
线段3: |---|
线段4: |-----|

扫描过程:
时刻1: | 重合数 = 1
时刻2: | 重合数 = 2
时刻3: | 重合数 = 3 (最大值)
时刻4: | 重合数 = 2

手写堆实现

为了提高效率,使用数组实现小根堆:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
MAXN = 10001
heap = [0] * MAXN # 存储结束点
size = 0

def add(x):
global size
heap[size] = x
i = size
size += 1
# 上浮调整
while i > 0 and heap[i] < heap[(i - 1) // 2]:
swap(i, (i - 1) // 2)
i = (i - 1) // 2

def pop():
global size
swap(0, size - 1)
size -= 1
i = 0
l = 1
# 下沉调整
while l < size:
best = l + 1 if l + 1 < size and heap[l + 1] < heap[l] else l
best = best if heap[best] < heap[i] else i
if best == i:
break
swap(i, best)
i = best
l = i * 2 + 1

def swap(i, j):
heap[i], heap[j] = heap[j], heap[i]

变种问题

会议室问题

1
2
3
4
5
6
7
8
9
10
11
12
13
def minMeetingRooms(meeting):
n = len(meeting)
meeting.sort(key=lambda x: x[0]) # 按起始时间排序
heap = [] # 小根堆,会议的结束时间
ans = 0

for i in range(n):
while heap and heap[0] <= meeting[i][0]: # 堆顶会议已结束
heapq.heappop(heap)
heapq.heappush(heap, meeting[i][1]) # 当前会议结束时间入堆
ans = max(ans, len(heap)) # 记录最大会议室数量

return ans

分组问题

1
2
3
4
5
6
7
8
9
10
11
12
13
def minGroups(meeting):
n = len(meeting)
meeting.sort(key=lambda x: x[0])
heap = []
ans = 0

for i in range(n):
while heap and heap[0] < meeting[i][0]: # 注意此处是 <,题意不同
heapq.heappop(heap)
heapq.heappush(heap, meeting[i][1])
ans = max(ans, len(heap))

return ans

关键区别:会议室问题用 <=(会议可以无缝衔接),分组问题用 <(需要间隔)。

复杂度分析

  • 时间复杂度:O(N log N),排序 + 每个元素平均 log N 次堆操作
  • 空间复杂度:O(N),存储线段结束点的堆

问题三:将数组和减半的最少操作次数

测试链接:https://leetcode.cn/problems/minimum-operations-to-halve-array-sum/

问题描述

给定一个数组,每次操作可以将任意一个元素减半,求使数组总和减少到原来一半所需的最少操作次数。

算法思路

使用贪心策略 + 大根堆:

  1. 贪心原理:每次选择当前最大的元素进行减半,减少量最大
  2. 堆维护:用大根堆维护当前所有元素
  3. 操作过程:不断取出最大元素减半,直到总减少量达到目标

方法一:基于 heapq

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
import heapq

def halveArray1(nums):
# 大根堆(用负数模拟)
heap = []
sum_val = 0

for num in nums:
heapq.heappush(heap, -float(num)) # 负数模拟大根堆
sum_val += num

sum_val /= 2 # 要减少到总和一半
ans = 0 # 操作次数
minus = 0 # 已减少的和

while minus < sum_val:
cur = -heapq.heappop(heap) / 2 # 取出最大数、减半
heapq.heappush(heap, -cur) # 新值放回堆
minus += cur # 记录减少量
ans += 1 # 操作次数加1

return ans

方法二:手写堆 + 精度优化

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
MAXN = 100001
heap_arr = [0] * MAXN
size = 0

def halveArray2(nums):
global size
size = len(nums)
sum_val = 0

# 初始化大根堆,左移20位保证精度
for i in range(size - 1, -1, -1):
heap_arr[i] = int(nums[i]) << 20 # 左移20位放大
sum_val += heap_arr[i]
heapify(i) # 调整堆

sum_val //= 2 # 目标减少量
ans = 0
minus = 0

while minus < sum_val:
heap_arr[0] //= 2 # 堆顶减半
minus += heap_arr[0]
heapify(0)
ans += 1

return ans

def heapify(i):
global size
l = i * 2 + 1
while l < size:
best = l + 1 if l + 1 < size and heap_arr[l + 1] > heap_arr[l] else l
best = best if heap_arr[best] > heap_arr[i] else i
if best == i:
break
swap(best, i)
i = best
l = i * 2 + 1

def swap(i, j):
heap_arr[i], heap_arr[j] = heap_arr[j], heap_arr[i]

综合减少一半最少操作-优化方法

关键优化技术

精度处理

问题:浮点数运算有精度损失,可能导致结果错误

解决方案:

  • 将所有数左移20位(乘以 2²⁰)
  • 用整数运算模拟浮点数运算
  • int(32位) × 2²⁰ < long(64位),不会溢出

性能优化

手写堆 vs heapq:

  • heapq 基于 Python 列表,有额外开销
  • 手写数组堆效率更高,常数因子更小

算法正确性证明

贪心策略的正确性:

  • 每次选择最大元素减半,获得的减少量最大
  • 假设最优解不是每次选最大元素,可以证明交换操作不会使结果变差
  • 因此贪心策略能得到最优解

复杂度分析

  • 时间复杂度:O(N log N),每个元素最多被操作 log(max_value) 次。若傻傻地每个元素都缩1/2,一定能达成目标;显然操作的元素个数一定小于n
  • 空间复杂度:O(N),存储堆的空间

堆结构应用总结

适用场景

问题类型 堆类型 核心思想 典型例题
合并有序序列 小根堆 维护多个序列的当前最小值 合并K个有序链表
区间重合问题 小根堆 扫描线 + 维护结束时间 最多线段重合
贪心选择 大根堆 每次选择当前最值进行操作 数组和减半
Top-K问题 小根堆 维护K个最大值 第K大元素
任务调度 小根堆 按优先级处理任务 CPU任务调度

实现选择

情况 推荐实现 原因
原型开发 heapq 简单易用,标准库
性能要求高 手写堆 效率更高,常数因子小
需要大根堆 负数技巧 Python只有小根堆
精度要求高 整数模拟 避免浮点数误差

常见陷阱

  1. 对象比较问题:自定义对象作为堆元素时,需要实现比较方法或使用包装
  2. 精度问题:浮点数运算可能有误差,关键场合使用整数
  3. 堆类型混淆:Python默认小根堆,大根堆需要取负数
  4. 边界条件:空堆操作、单元素情况需要特殊处理

性能优化技巧

  1. 预分配空间:手写堆时预分配数组空间
  2. 避免频繁内存操作:使用数组而非动态列表
  3. 批量操作:heapify 比逐个插入效率高
  4. 精度与性能平衡:根据需求选择合适的数据类型

堆结构是解决很多算法问题的重要工具,在实际使用中,要根据具体问题选择合适的实现方式和优化策略。

参照的是左程云的课程:https://space.bilibili.com/8888480/lists/3509640?type=series
本笔记包括了随机快速排序和随机选择算法的原理与实现,涵盖了荷兰国旗问题优化、时间复杂度分析等内容,包括了class023 -> class024的内容

023【必备】随机快速排序

快速排序的基本思想

快速排序是一种高效的分治排序算法,其核心思想是:

  1. 选择基准元素(pivot):从数组中选择一个元素作为基准值pivot
  2. 数组划分:将数组重新排列,使得所有小于基准值的元素放在基准值前面,所有大于基准值的元素放在基准值后面
  3. 递归排序:对基准值两侧的子数组递归地应用快速排序

随机化的重要性

为什么需要随机化?

  • 普通快速排序:固定选择位置(如最右元素)作为基准,最坏情况时间复杂度为O(n²)
  • 随机快速排序:随机选择基准元素,期望时间复杂度为O(n log n)
1
2
# 随机选择基准元素是关键
x = arr[random.randint(l, r)] # 在[l,r]范围内随机选择

测试链接 :https://www.luogu.com.cn/problem/P1177

经典快速排序实现(不推荐)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
def quickSort1(l, r):
# l == r,只有一个数
# l > r,范围不存在,不用管
if l >= r:
return
# 随机这一下,常数时间比较大
# 但只有这一下随机,才能在概率上把快速排序的时间复杂度收敛到O(n * logn)
# l......r 随机选一个位置,x这个值,做划分
x = arr[random.randint(l, r)]
mid = partition1(l, r, x) #会返回x的下标即index
quickSort1(l, mid - 1)
quickSort1(mid + 1, r)

# 已知arr[l....r]范围上一定有x这个值
# 划分数组 <=x放左边,>x放右边
# 并且确保划分完成后<=x区域的最后一个数字是x
def partition1(l, r, x):
# a : arr[l....a-1]范围是<=x的区域
# xi : 记录在<=x的区域上任何一个x的位置,哪一个都可以
a = l # 初始化指针a,表示<=x区域的右边界,初值为l
xi = 0 # 初始化xi,用于记录<=x区域内某一个x的位置(后面需要与a-1交换)
for i in range(l, r + 1): # 从l遍历到r,依次考察每个元素,每一步都会i++(重要,所以这里的代码没有显式写i++)
if arr[i] <= x: # 如果当前元素小于等于x
swap(a, i) # 把当前元素交换到a位置(即<=x区的后面)
if arr[a] == x: # 如果新放到a位置的元素等于x
xi = a # 记录下这个位置为xi
a += 1 # <=x区往右扩展一位
swap(xi, a - 1) # 把<=x区域里某个x与区域最后一个元素交换,保证x落在最后
return a - 1 # 返回<=x区域的最后一个下标(即x最终所在的位置)

def swap(i, j):
tmp = arr[i] # 先把arr[i]暂存到tmp
arr[i] = arr[j] # arr[i]赋值为arr[j]
arr[j] = tmp # arr[j]赋值为tmp,实现arr[i]和arr[j]交换

经典版本的问题:

  • 经典快排每次只排掉一个等于pivot的元素,重复元素多时递归深度大,容易爆栈突变为,pivot 只确定了它自己的最终位置,如果有很多元素等于 pivot,只有一个会归位,剩下的还在“乱序”的子区间里。

partition函数理解-经典快速排序
partition函数理解-改进快速排序

荷兰国旗问题优化版(推荐)

荷兰国旗问题是快速排序的重要优化,将数组分为三个区域:

1
[小于x的区域] [等于x的区域] [大于x的区域]

能够一次处理所有等于pivot的元素,递归层数大大降低,所以不会爆栈,每次把所有等于pivot的数都一次性放到中间,只对小于和大于pivot的区间递归

核心优势

  1. 一次性处理所有相等元素:将所有等于pivot的元素都放到正确位置
  2. 减少递归层数:只需要对小于和大于pivot的区域递归
  3. 避免栈溢出:特别适合处理有大量重复元素的数组

实现代码

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
def quickSort2(l, r):
if l >= r:
return
# 随机这一下,常数时间比较大
# 但只有这一下随机,才能在概率上把快速排序的时间复杂度收敛到O(n * logn)
x = arr[random.randint(l, r)]
partition2(l, r, x)
# 为了防止底层的递归过程覆盖全局变量
# 这里用临时变量记录first、last
left = first[0]
right = last[0]
quickSort2(l, left - 1)
quickSort2(right + 1, r)

# 荷兰国旗问题
first = [0] # 用list模拟全局变量
last = [0]

# 已知arr[l....r]范围上一定有x这个值
# 划分数组 <x放左边,==x放中间,>x放右边
# 把全局变量first, last,更新成==x区域的左右边界
def partition2(l, r, x):
first[0] = l
last[0] = r
i = l
while i <= last[0]:
if arr[i] == x:
i += 1
elif arr[i] < x:
swap(first[0], i)
first[0] += 1
i += 1
else:
swap(i, last[0])
last[0] -= 1 #i不变的原因是交换后 i 位置上的新元素还没考察过
#前两种情况i++的原因是x作为基准,在i位置上,顶着左边区域向右推进,此外快速排序算法不需要随机元素的index

荷兰国旗问题详细演示

以数组 [7, 2, 6, 3, 1, 5, 4],pivot=3 为例:

初始状态:

1
2
arr = [7, 2, 6, 3, 1, 5, 4]
first = 0, last = 6, i = 0

Step 1:arr[0] = 7 > 3

  • 与 arr[6] 交换:[4, 2, 6, 3, 1, 5, 7]
  • last = 5,i 不变

Step 2:arr[0] = 4 > 3

  • 与 arr[5] 交换:[5, 2, 6, 3, 1, 4, 7]
  • last = 4,i 不变

Step 3:arr[0] = 5 > 3

  • 与 arr[4] 交换:[1, 2, 6, 3, 5, 4, 7]
  • last = 3,i 不变

Step 4:arr[0] = 1 < 3

  • 与 arr[0] 交换(自己):不变
  • first = 1,i = 1

Step 5:arr[1] = 2 < 3

  • 与 arr[1] 交换(自己):不变
  • first = 2,i = 2

Step 6:arr[2] = 6 > 3

  • 与 arr[3] 交换:[1, 2, 3, 6, 5, 4, 7]
  • last = 2,i 不变

Step 7:arr[2] = 3 == 3

  • i = 3,此时 i > last,循环结束

最终结果:

1
2
3
4
arr = [1, 2, 3, 6, 5, 4, 7]
[0, 1]: 小于3的区域 [1, 2]
[2, 2]: 等于3的区域 [3]
[3, 6]: 大于3的区域 [6, 5, 4, 7]

时间复杂度分析

随机快速排序的复杂度

时间复杂度:O(n log n) (期望)

  • 每层的划分操作需要O(n)时间
  • 随机选择使得平均递归深度为O(log n)
  • 总时间复杂度:O(n) × O(log n) = O(n log n)

空间复杂度:O(log n) (期望)

  • 来自递归调用栈的深度
  • 最好情况:每次平分,深度为O(log n)
  • 最坏情况:退化为链式递归,深度为O(n)

与普通快速排序对比

普通快速排序

  • 普通快速排序的时间复杂度O(n^2):固定流程考虑最坏情况(极端不平衡,每次都选到最小或最大元素为主元),每次只能划分出一个元素,剩下的 n-1 继续递归;额外空间复杂度O(n)取得是最坏情况递归的栈的深度。
  • 最好情况:T(n) = 2 * T(n/2) + O(n) = O(n * logn),空间是O(logn)取得是递归的栈的深度。
  • 因为固定流程的话,可以构造出特定的数据,导致每次固定取最右最左的元素都是最差情况。

随机快速排序

  • 随机快速排序,时间复杂度O(n * logn)随机取得是期望理论上每次能比较均匀划分为两半,递归深度约为 log𝑛,每一层的划分操作需要 O(n) 时间。额外空间复杂度O(logn)取得是递归的栈的深度,运气好每次都是区间二分,参考中序二叉树
  • 取期望,每个位置取1/N的权重,最后能证明期望时间复杂度是O(n * logn),额外空间复杂度O(logn)
  • 关于复杂度的分析,进行定性的说明,定量证明略,因为证明较为复杂,算法导论-7.4.2有详细证明
算法类型 时间复杂度(平均) 时间复杂度(最坏) 空间复杂度(平均) 空间复杂度(最坏)
普通快排 O(n log n) O(n²) O(log n) O(n)
随机快排 O(n log n) O(n log n)* O(log n) O(log n)*

*期望意义下

024【必备】随机选择算法

问题描述

无序数组中第K大的元素问题:

  • 给定整数数组 nums 和整数 k
  • 返回数组中第 k 个最大的元素
  • 要求时间复杂度为 O(n)

关键转换:第K大 = 第(len-k)小(python中)。事实上,若下标从0开始时,第K大等于第(len-k)小(即下标为len-k的元素);如果下标从1开始,则用len+1-k

随机选择算法原理

随机选择算法是快速排序的变种,核心思想:

  1. 只关心目标位置:不需要完全排序,只需要找到第K大的元素
  2. 单侧递归:每次只需要在包含目标位置的一侧继续查找
  3. 随机化优化:通过随机选择pivot避免最坏情况

测试链接 :https://leetcode.cn/problems/kth-largest-element-in-an-array/

实现代码

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
class RandomizedSelect:
first = 0 # 等于区域的左边界
last = 0 # 等于区域的右边界

@staticmethod
def findKthLargest(nums, k):
"""找第K大元素"""
# 转换为找第(len-k)小的元素
return RandomizedSelect.randomizedSelect(nums, len(nums) - k)

@staticmethod
def randomizedSelect(arr, i):
"""
连递归都没用,所以时间复杂度是O(n)左右的量级
在数组中找到如果排序后在位置i的元素
时间复杂度:O(n)
"""
ans = 0
l = 0
r = len(arr) - 1

while l <= r:#不断二分的过程中,l和r上是仍然有范围的,直到没有范围才终止
# 随机这一下,常数时间比较大
# 但只有这一下随机,才能在概率上把时间复杂度收敛到O(n)
pivot = arr[l + int(random.random() * (r - l + 1))]

# 使用荷兰国旗问题进行划分
RandomizedSelect.partition(arr, l, r, pivot)

# 因为左右两侧只需要走一侧
# 所以不需要临时变量记录全局的first、last,直接用即可
# 等于的区域即first,last包住的位置,i小于first则去左侧,i大于last则去右侧
if i < RandomizedSelect.first:
r = RandomizedSelect.first - 1 # 目标在左侧,pivot左边变成r
elif i > RandomizedSelect.last:
l = RandomizedSelect.last + 1 # 目标在右侧,pivot右边变成l
else:
ans = arr[i] # 找到目标
break

return ans

@staticmethod
def partition(arr, l, r, x):
"""荷兰国旗问题划分"""
RandomizedSelect.first = l
RandomizedSelect.last = r
i = l

while i <= RandomizedSelect.last:
if arr[i] == x:
i += 1
elif arr[i] < x:
RandomizedSelect.swap(arr, RandomizedSelect.first, i)
RandomizedSelect.first += 1
i += 1
else:
RandomizedSelect.swap(arr, i, RandomizedSelect.last)
RandomizedSelect.last -= 1

@staticmethod
def swap(arr, i, j):
"""交换数组元素"""
arr[i], arr[j] = arr[j], arr[i]
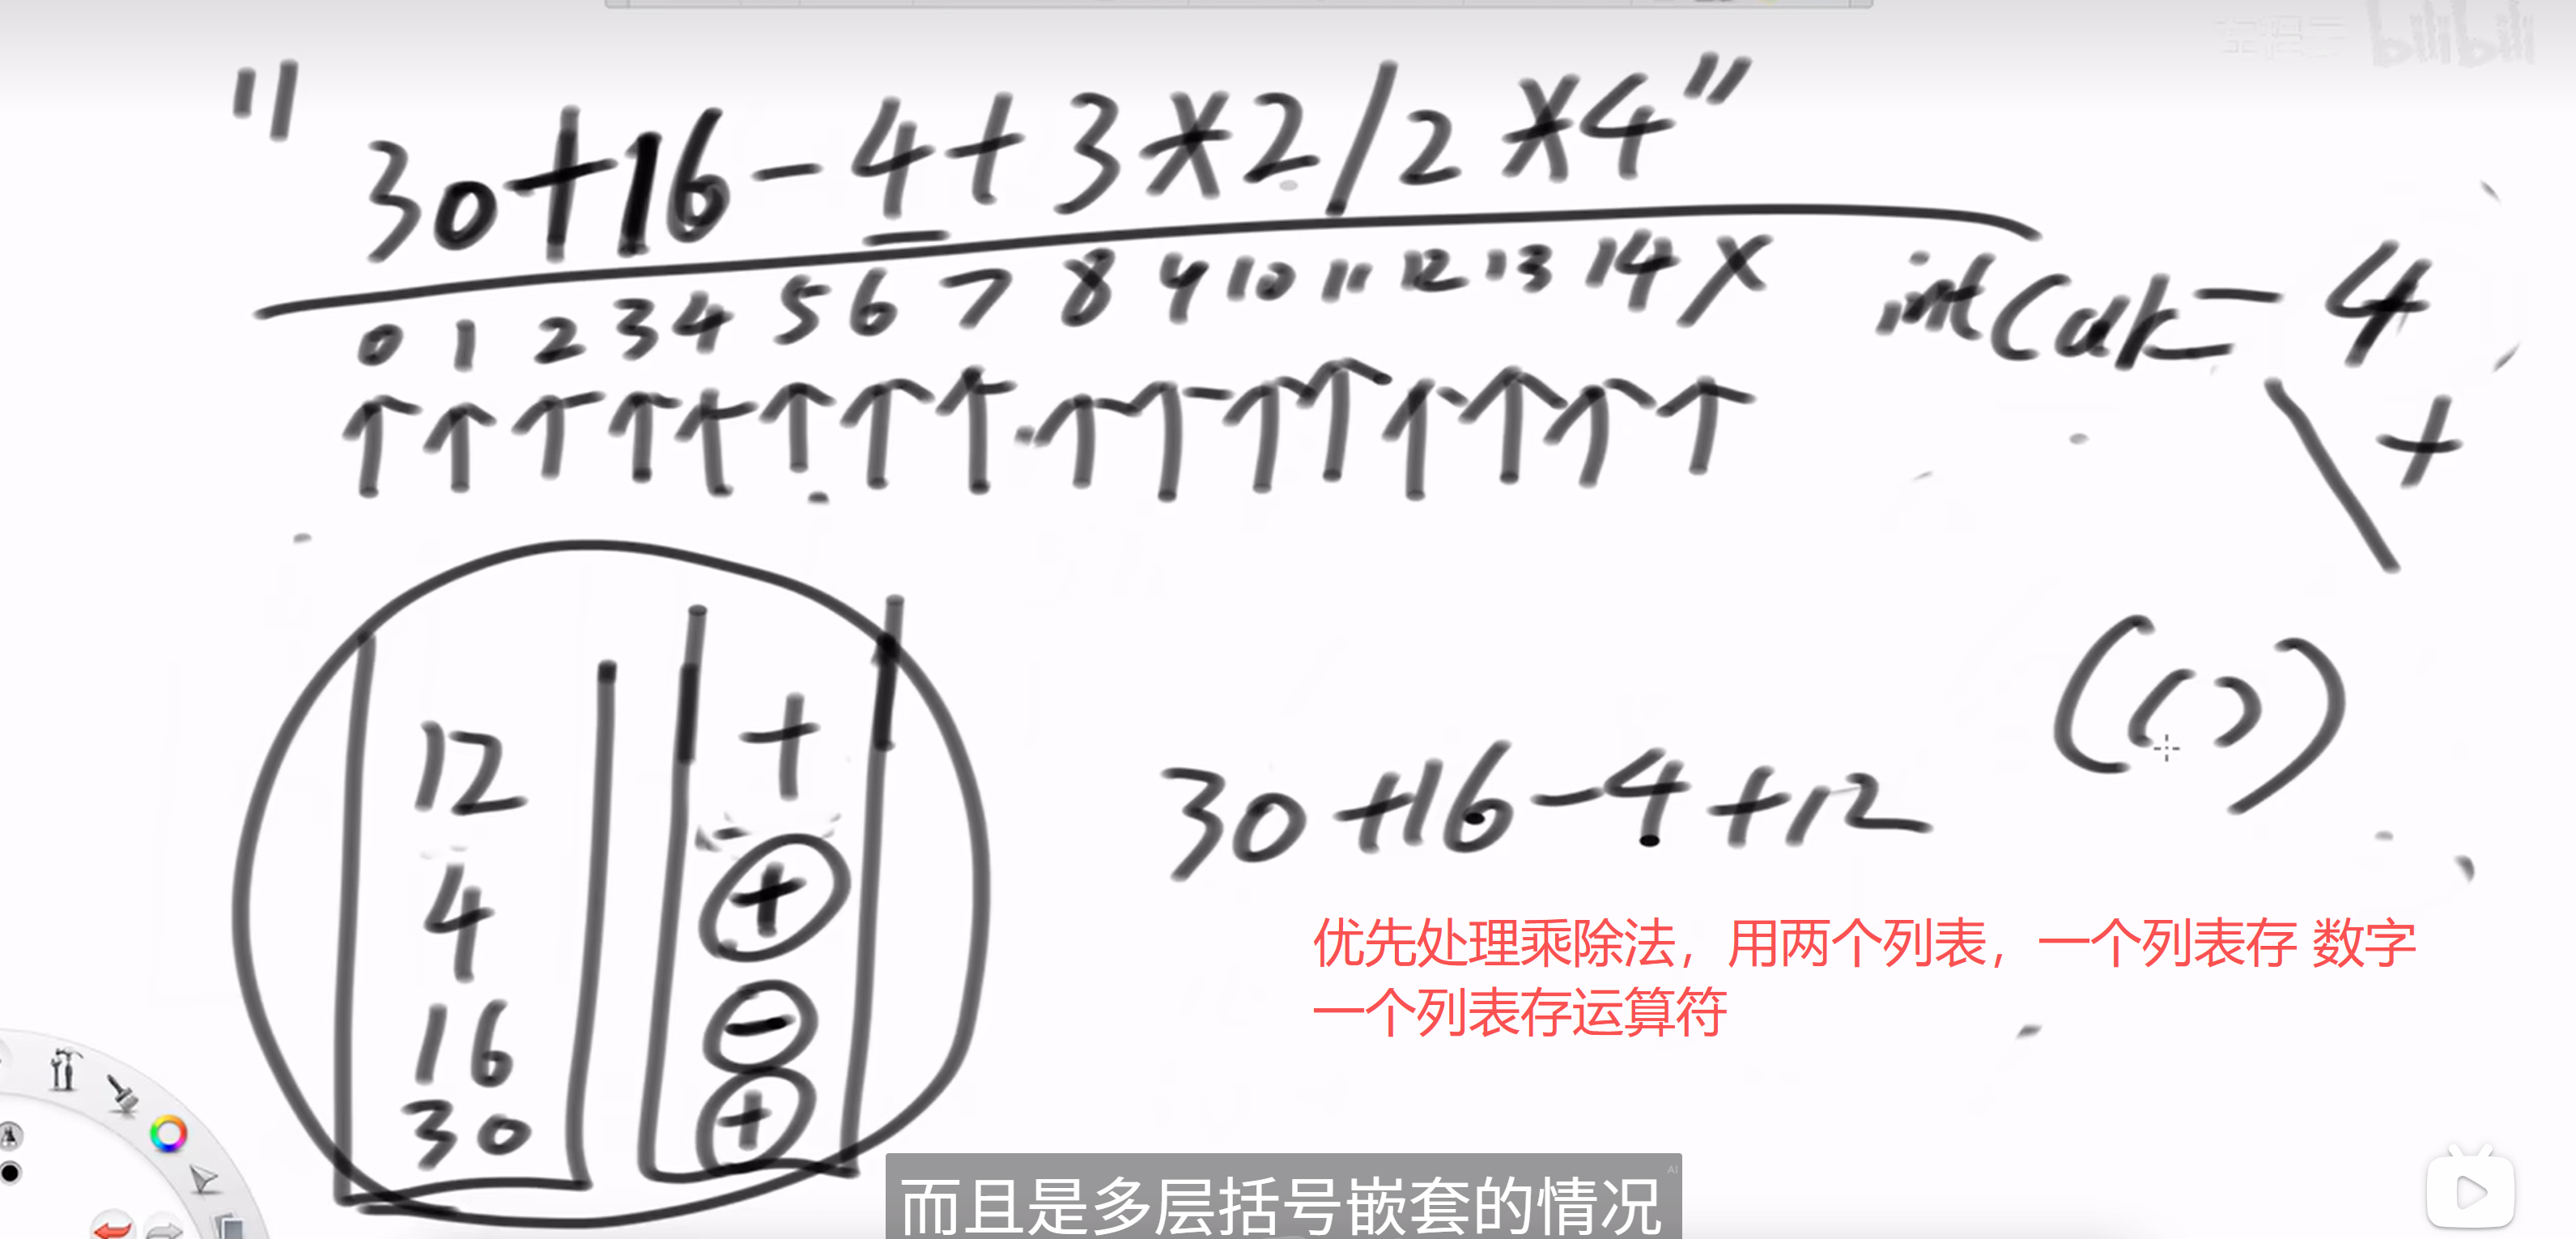
算法执行示例

以数组 [7, 2, 6, 3, 1, 5, 4],查找第4小元素(下标为3)为例:

第一轮:

  • 随机选择 pivot = 3
  • 划分后:[1, 2, 3, 6, 5, 4, 7]
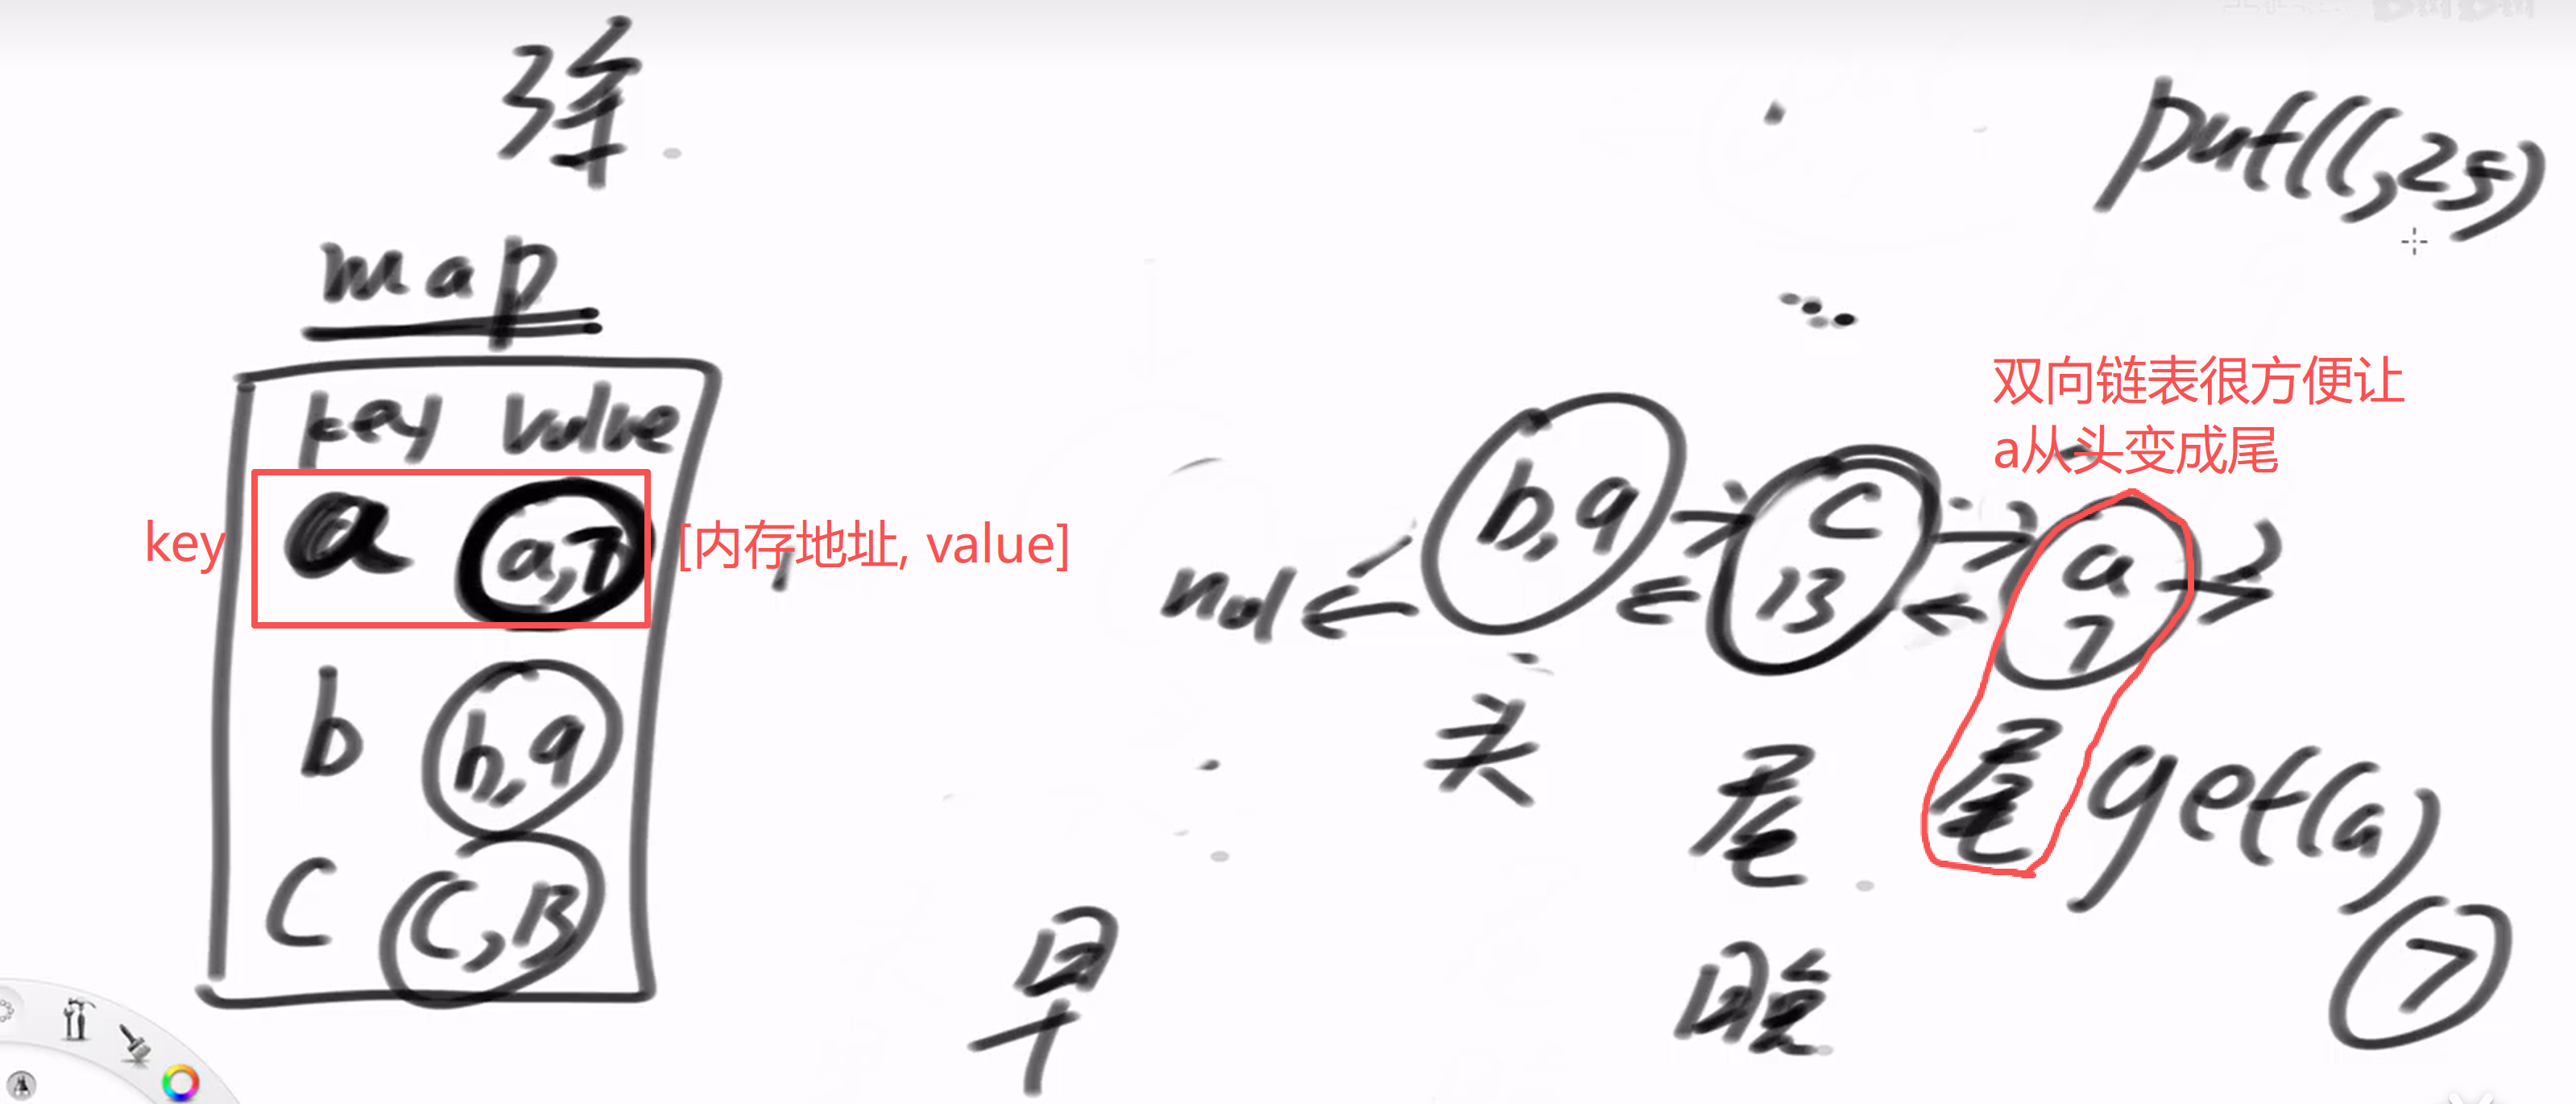
  • 等于区域:first = 2, last = 2
  • 目标下标3 > last=2,继续在右侧 [6, 5, 4, 7] 查找

第二轮:

  • 在右侧区域随机选择 pivot = 4
  • 划分后相对位置:[4, 5, 6, 7](实际在原数组的3,4,5,6位置)
  • 等于区域:first = 3, last = 3
  • 目标下标3 == first == last,找到答案 arr[3] = 4

时间复杂度证明(定性分析)

为什么是O(n)?

每次划分后,下一次只需要处理一侧的数据:

  • 第一次处理:n个元素
  • 第二次处理:n/2个元素(期望)
  • 第三次处理:n/4个元素(期望)
  • …

总时间:n + n/2 + n/4 + n/8 + ... ≈ 2n

因此期望时间复杂度为 O(n)。

与其他算法的比较

算法 时间复杂度 空间复杂度 特点
完全排序 O(n log n) O(1) 简单但过度
堆排序K次 O(n + k log n) O(1) 适合K很小的情况
随机选择 O(n) O(1) 最优解
BFPRT算法 O(n) O(log n) 理论最优但常数大

实际应用场景

  1. Top-K问题:找出数组中最大/最小的K个元素
  2. 中位数查找:快速找到数组的中位数
  3. 分位数计算:统计学中的百分位数计算
  4. 数据分析:快速找到数据集中的特定排名元素

关键要点总结

  1. 随机化的重要性:

    • 避免最坏情况的发生
    • 使算法在期望意义下达到最优复杂度
  2. 荷兰国旗问题的优势:

    • 一次性处理所有相等元素
    • 减少递归/迭代次数
    • 提高算法稳定性
  3. 单侧处理的效率:

    • 与完全排序不同,只需要处理包含目标的一侧
    • 大大减少了计算量
  4. 工程实践建议:

    • 对于一般规模的数据,随机选择算法是首选
    • 当需要多次查询不同K值时,可以考虑先排序
    • 在对稳定性要求极高的场合,可以考虑BFPRT算法

这两个算法(随机快速排序和随机选择)是分治算法的经典应用,展示了随机化在算法设计中的重要作用。掌握这些算法不仅有助于解决实际问题,也为理解更复杂的分治算法奠定了基础。