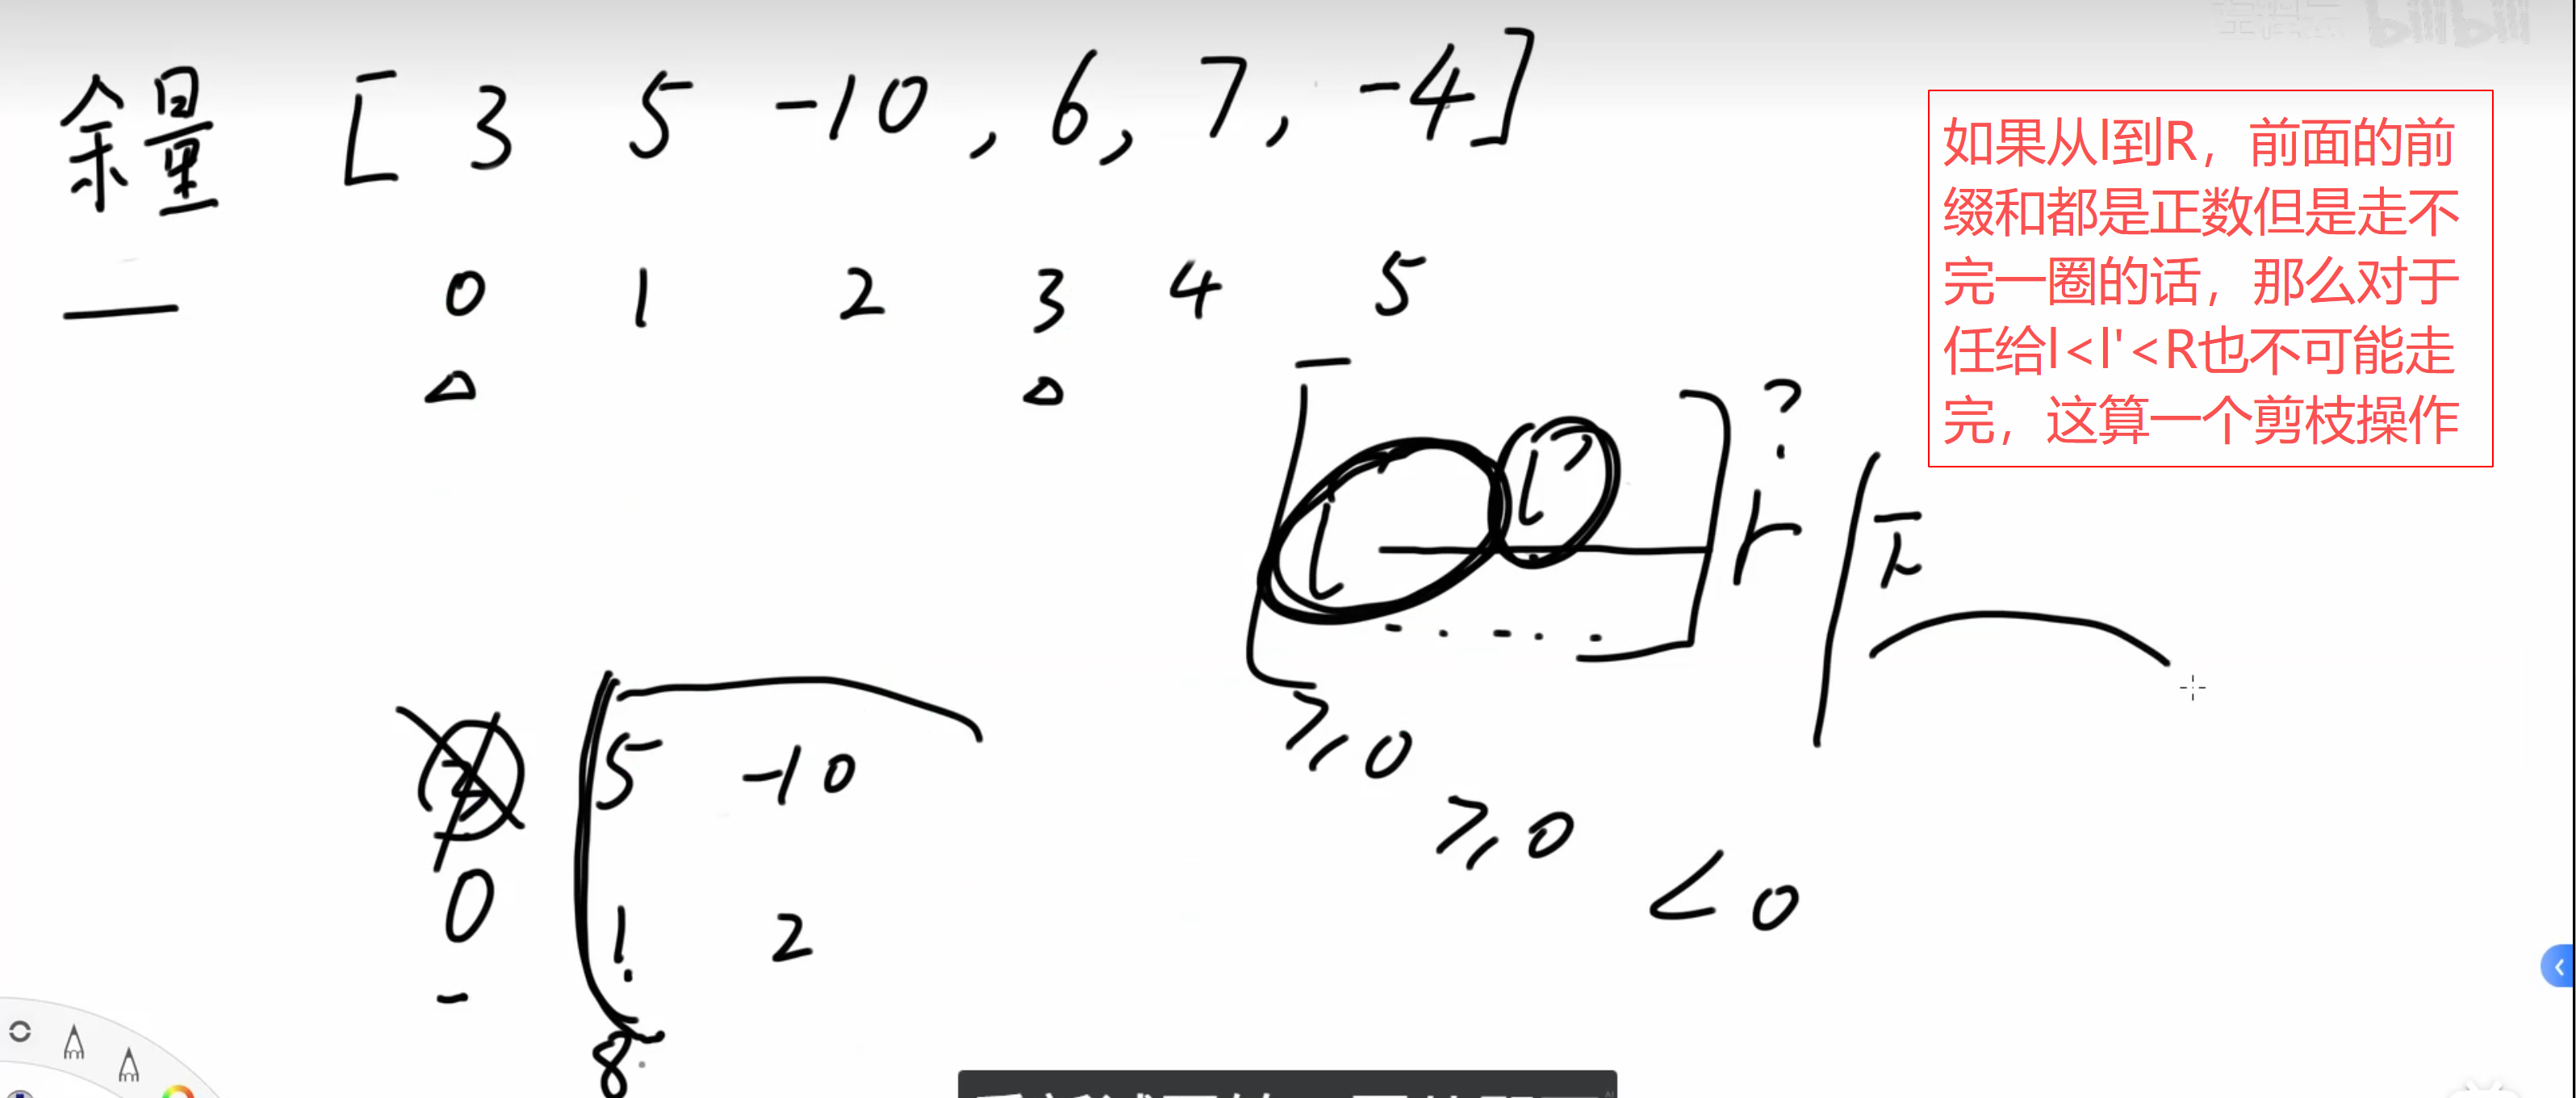0%

生物信息学学习笔记:第 1 章 绪论


0. PDF 内容检查

1. 书名 / 章 / 节 / 小节结构

  • 书名:生物信息学(第二版)(中文教材,配套有《生物信息学实验指导》)
  • 章标题:第 1 章 绪论
  • 节与小节结构(严格按 PDF 顺序):
    • 第一节 生物信息与生物信息学
      • 一、迅速增长的生物信息
      • 二、生物信息学概念
    • 第二节 生物信息学历史与展望
      • 一、发展简史
      • 二、应用领域
      • 三、学科展望
    • 习题(5 题)
    • 历史与人物:“bioinformatics”之名的由来(Paulien Hogeweg / 林华安 Hwa A. Lim)

2. PDF 页与印刷页对应

  • PDF 共 15 页,对应教材印刷页码 第 1~15 页(页脚可见“第 1 章 绪论 1/2/3…”与“生物信息学 2/4/6…”交替,为奇偶页页眉页脚)。对应关系基本 1:1。

3. 缺页 / 重复 / 乱码 / OCR 错误

  • 无明显缺页,章节从开头到习题、历史人物完整。
  • 存在少量 OCR/排版小瑕疵:
    • 图 1.1 的坐标轴数字(14/12/10…)与图注被打散夹在正文里,图本身无法从文本还原,只能读文字说明。
    • 个别外文拼写按原文保留(如 “Fleischman” 应为 Fleischmann、“Ensemble” 应为 Ensembl、“Neighbour-Joining”),这些是教材/OCR 层面的小笔误,我在术语表会给出正确写法。
    • “kisac.ki.se,现为 www.bea.ki.se” 一句被排到图 1.2 描述前面(排版跨页所致),不影响理解。

4. 图表公式可识别性

  • 图 1.1~1.7 只能读到文字标题和说明,图像内容(曲线、漫画、网页截图)无法从文本判读。
  • 表 1.1(学科发展主要事件)、表 1.2(高被引论文)文本完整可读,是本章最有价值的可提取信息。
  • 本章无任何数学公式。

5. 是否完整章节:是,绪论完整。

6. 缺失上下文:本章多次以“详见第 2/3/4 章”“附录 2”指向后续内容(数据类型、数据库、序列联配、系统发生等),这些属于后续章节,不在本 PDF 中。


1. 本节定位与知识地图

1. 本章解决什么问题
回答三个入门问题:①什么是生物信息(biological information)以及它为何爆炸式增长;②什么是生物信息学(bioinformatics)这门学科;③它从哪来、往哪去(历史、应用、展望、就业、我国发展)。

2. 在全书与整个学科体系中的位置
它是全书的“地图与导言”:先建立“数据海洋”的世界观和学科边界,再由后续章节逐一展开数据类型(第 2 章)、数据库(第 3 章)、序列联配(第 4 章)等。

3. 属于哪个子领域:学科概论 / 学科史,不属于任何具体计算子领域。

4. 在真实研究 pipeline 中的位置:不对应任何 pipeline 步骤。它是“为什么要有 pipeline”的动机层。

5. 上游输入 / 6. 下游分析:不适用(无数据流)。可类比理解为:上游是“测序技术产生海量数据”,下游是“本书后续所有分析方法”。

7. 与其他章节 / 实验指导的对应

  • 与主教材:第 2 章(数据类型)、第 3 章(数据库、Dayhoff)、第 4 章(序列联配、Waterman)、进化分析章(Sankoff、NJ、自举法)均在本章被点名预告。
  • 与《实验指导》:本章本身无配套实验,但它列出的工具(BLAST、ClustalW、ORF finder、HMMER、FGENESH、NCBI/EBI 在线服务)正是后续实验的主角。

前置知识

  • 生物学:中心法则(DNA→RNA→蛋白质)、碱基与氨基酸、基因/基因组的基本概念。
  • 数学统计:本章几乎不需要;仅需理解“数据量指数增长/翻番”这类直觉。
  • 算法/数据结构:无硬性要求;了解“动态规划、图论”是名词即可(后续章节才展开)。
  • 编程工具:无;但本章明确建议未来要会 命令行 + Python/Perl + C/C++,会用 Unix/Linux。

知识结构树

1
2
3
4
5
6
7
8
9
10
11
12
绪论(生物信息学是什么)
├── 生物学问题:如何管理/解读/使用爆炸增长的生物数据
├── 核心对象:生物信息(核酸/蛋白序列、结构、表达、通路…)
│ ├── 初级数据库 primary(原始序列/结构)
│ └── 二级数据库 secondary(domain、二级结构、疏水位点…)
├── 学科定义:分子生物学 + 遗传学 + 计算机科学
│ ├── 三大内容:新算法/统计;数据分析解释;数据管理工具
│ └── 研究范式:假设—实验(数据库搜索=一次“实验”)
├── 历史四阶段:萌芽/形成/基因组与互联网/高通量测序
├── 应用领域:序列分析、基因预测、拼接、结构预测、进化、精准医疗…
├── 平民化桥梁:Windows 软件 + 在线 Web 服务(SSS/MSA/BSA)
└── 展望:从"积累数据"转向"解读数据";大数据/AI/合成生物学/就业

2. 按教材顺序精读

第一节 · 一、迅速增长的生物信息 【应该理解】

  1. 要回答的问题:生物信息指什么?增长有多快?
  2. 主要内容:生物信息包含分子序列(核酸/蛋白)、蛋白二级/三维结构等;原始数据构成初级数据库,分析衍生数据构成二级数据库;核酸库数据约每 14 个月翻一番。
  3. 核心结论:数据爆炸 → 催生“如何有效管理、准确解读、充分使用”的新需求。
  4. 重要术语:初级数据库(primary database)、二级数据库(secondary database)、功能区/结构域(domain)、WGS。
  5. 数据(作为素材):DNA 字母表 {A,T,G,C};蛋白 20 个氨基酸字母;GenBank 2000 年底 >100 亿 bp,2020 年 4 月 4158 亿 bp(+WGS 7.8 万亿 → 合计约 8.2 万亿 bp / 14.8 亿条)。
  6. 方法:无(描述性)。
  7. 易错点:“每 14 个月翻一番”是核酸库的历史经验值,不同来源/年份数字不同(人类基因组测序另有“每 5–7 个月翻番”)——不要当作精确定律。
  8. 前后关系:为下一小节“为何需要一门新学科”做铺垫。
  9. 页码/图:印刷 p.1–2,图 1.1(GenBank/WGS 增长曲线)。

第一节 · 二、生物信息学概念 【必须掌握】

  1. 要回答的问题:生物信息学是什么?
  2. 主要内容:一般定义=研究生物信息的采集、处理、存储、传播、分析、解释;三大组成部分=①新算法与统计方法;②数据分析与解释;③数据管理利用工具。引用 Claverie(2000)、Wikipedia 定义。研究范式=假设—实验(如“该序列在库中无同源序列”是无效假设,数据库搜索就是一次验证实验)。
  3. 核心结论:生物信息学不是“移植信息学技术到生物学”的纯应用技术,而是有丰富科学内涵、有大量未解科学问题(生物学的+计算的)的独立学科。
  4. 重要术语:bioinformatics、假设—实验模式、无效假设。
  5. 方法/数据:无。
  6. 易错点:两个常见误解——“人人可做/不花钱/软件都免费”与“只是敲键盘写论文”。教材明确反驳:需算力投入、需实验验证、需想象力。
  7. 前后关系:给出全书立场(学科定位),承上(数据爆炸)启下(历史)。
  8. 页码/图:p.2–4,图 1.2(早期“路线图”)、图 1.3(NCBI 在线工具网页)。
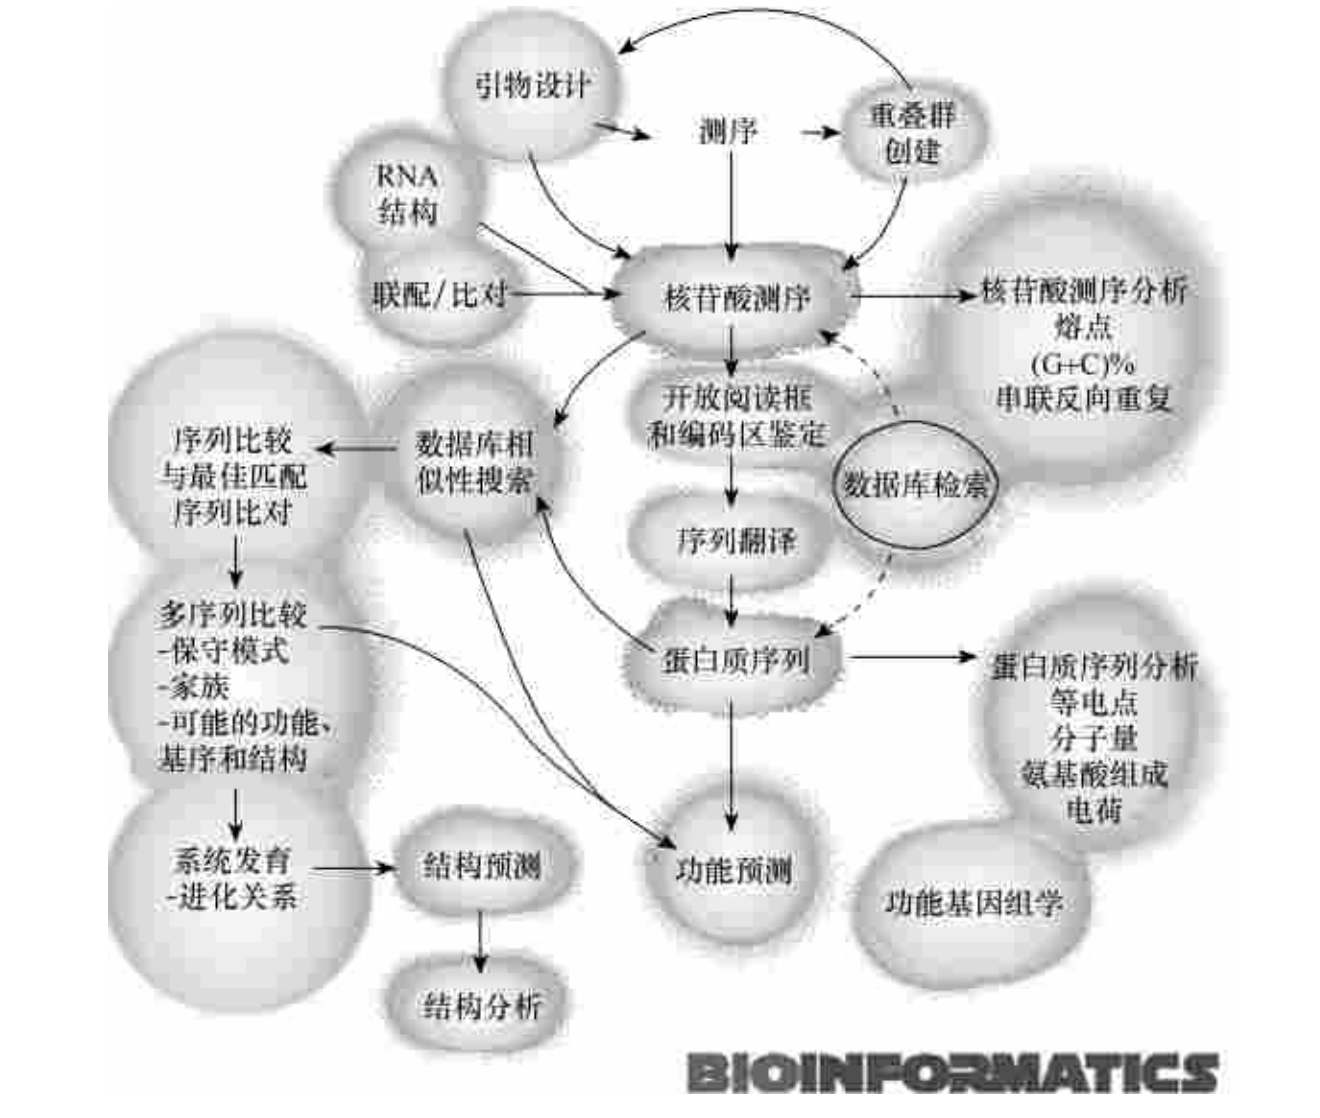
fig1.2早期路线图

第二节 · 一、发展简史 【应该理解 + 部分必须掌握】

  1. 要回答的问题:这门学科怎么来的?关键里程碑有哪些?
  2. 主要内容:起源可追溯到 1960s;术语最早由 Paulien Hogeweg (1978) 提出(“the study of informatic processes in biotic systems”),另一说 1990 年由 林华安 (Hwa A. Lim) 提出并办首届会议。学科奠基人:Margaret Dayhoff、Michael Waterman、David Sankoff。四阶段划分(必须掌握):①萌芽期(1960s–70s,Dayhoff 替换矩阵、Needleman-Wunsch);②形成期(1980s,分子数据库+BLAST/FASTA);③基因组与互联网期(1990s–2005,基因组测序、Phred-Phrap-Consed、在线数据库);④高通量测序期(2005 至今,NGS/三代)。
  3. 核心结论:最核心的算法在 1960–70s 就已奠基(序列联配是最基本内容),之后是不断改进。
  4. 重要术语:替换矩阵、Needleman-Wunsch、Smith-Waterman、BLAST/FASTA、Phred-Phrap-Consed、NGS。
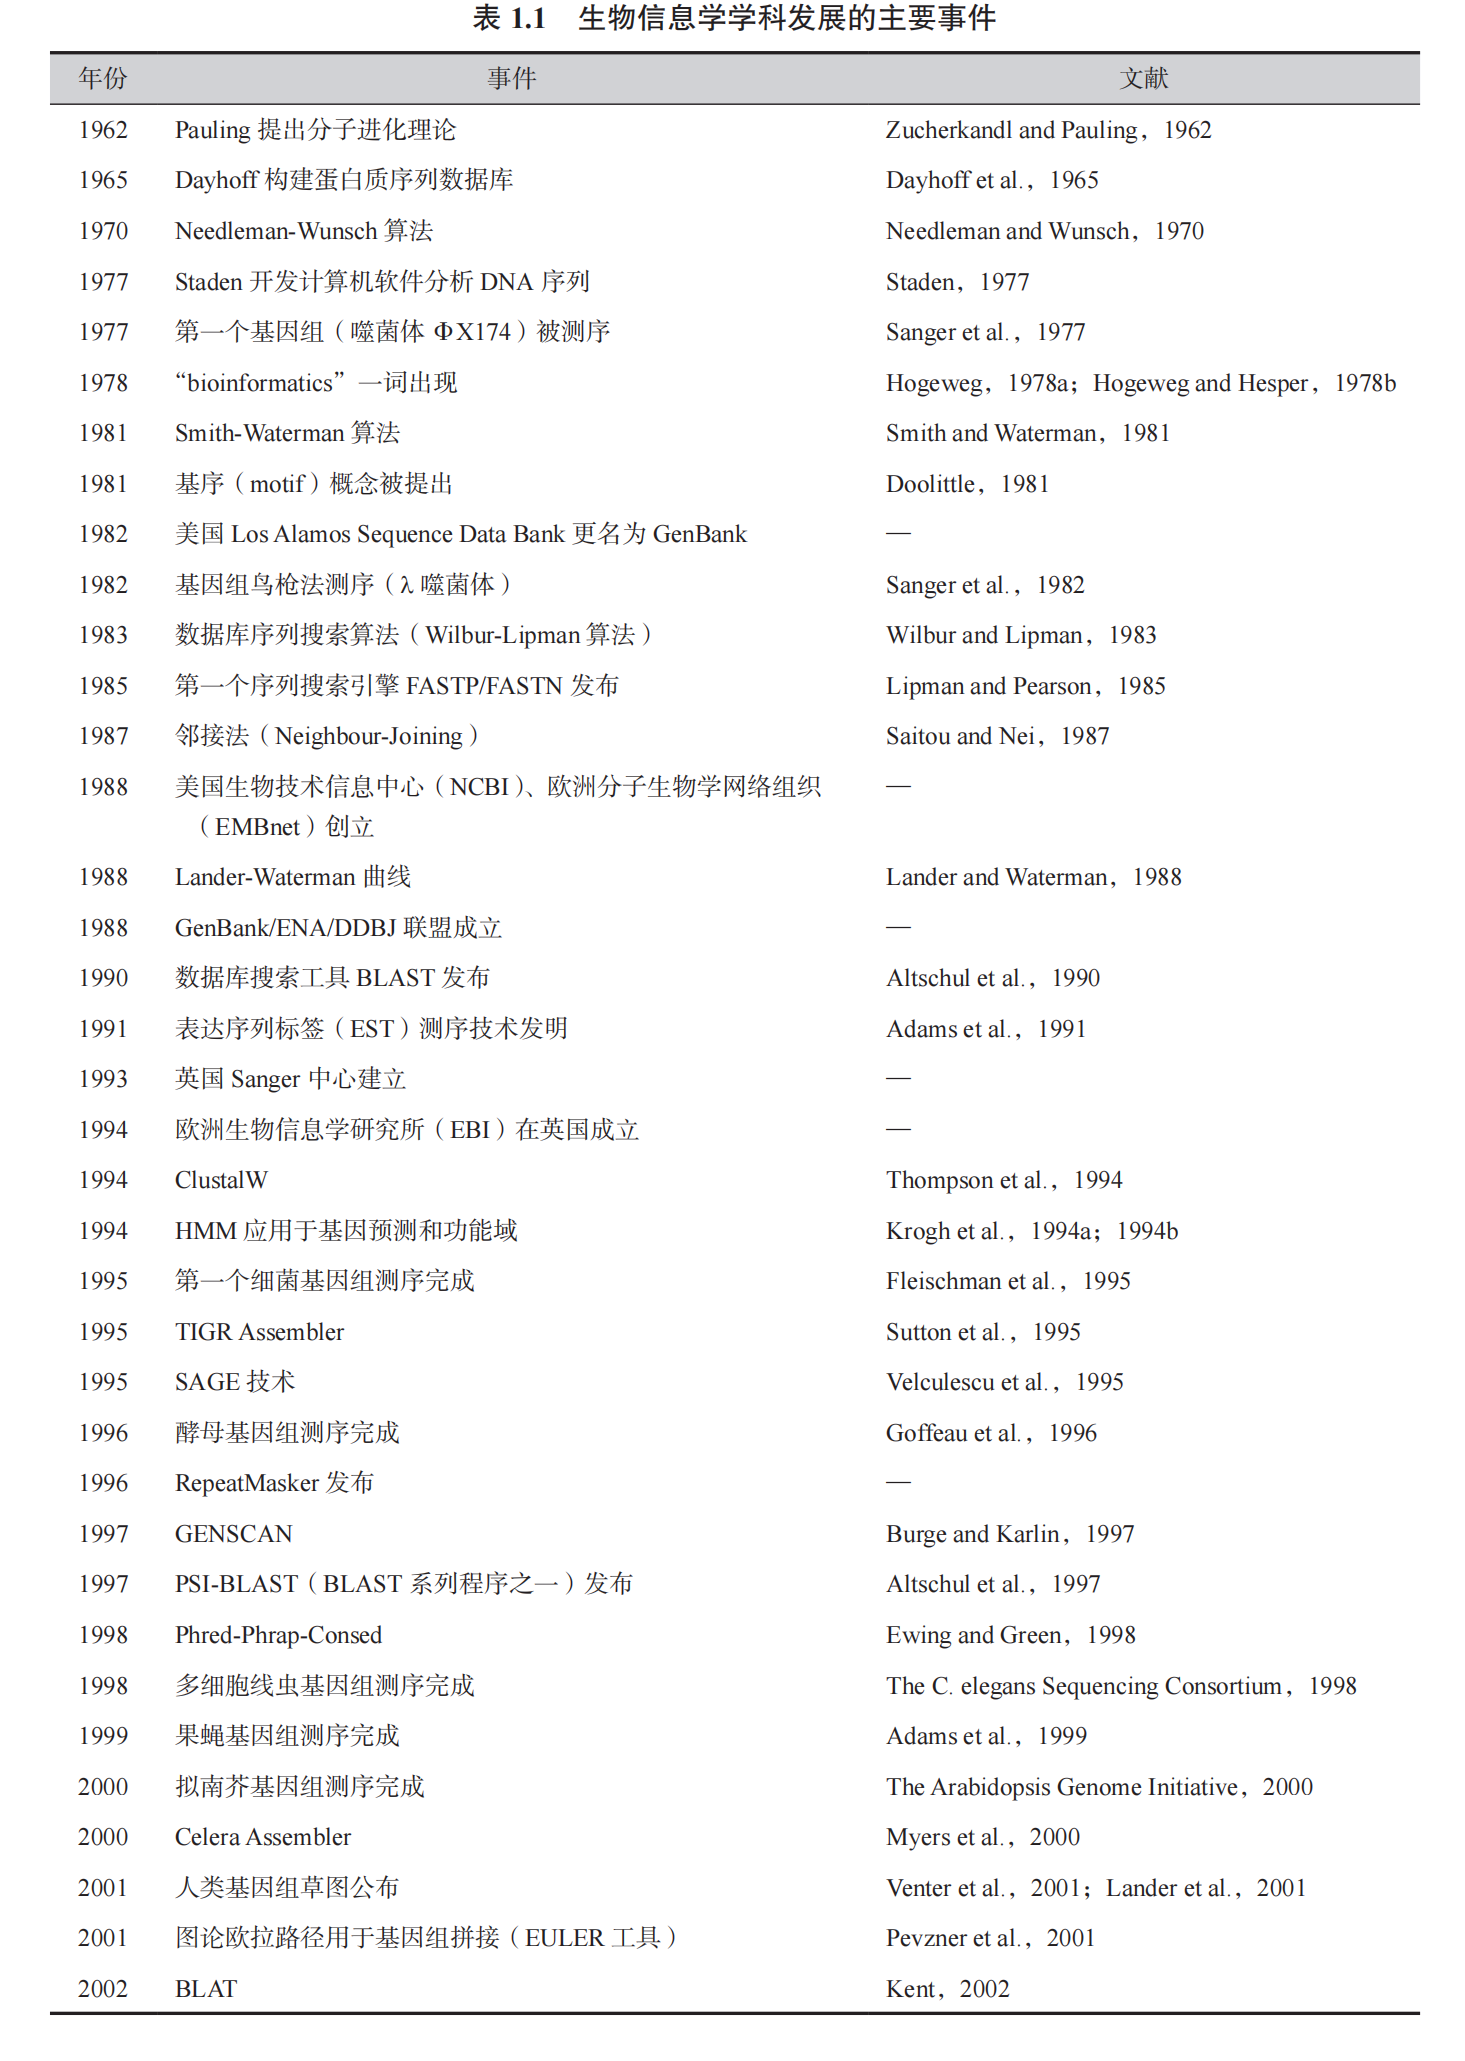
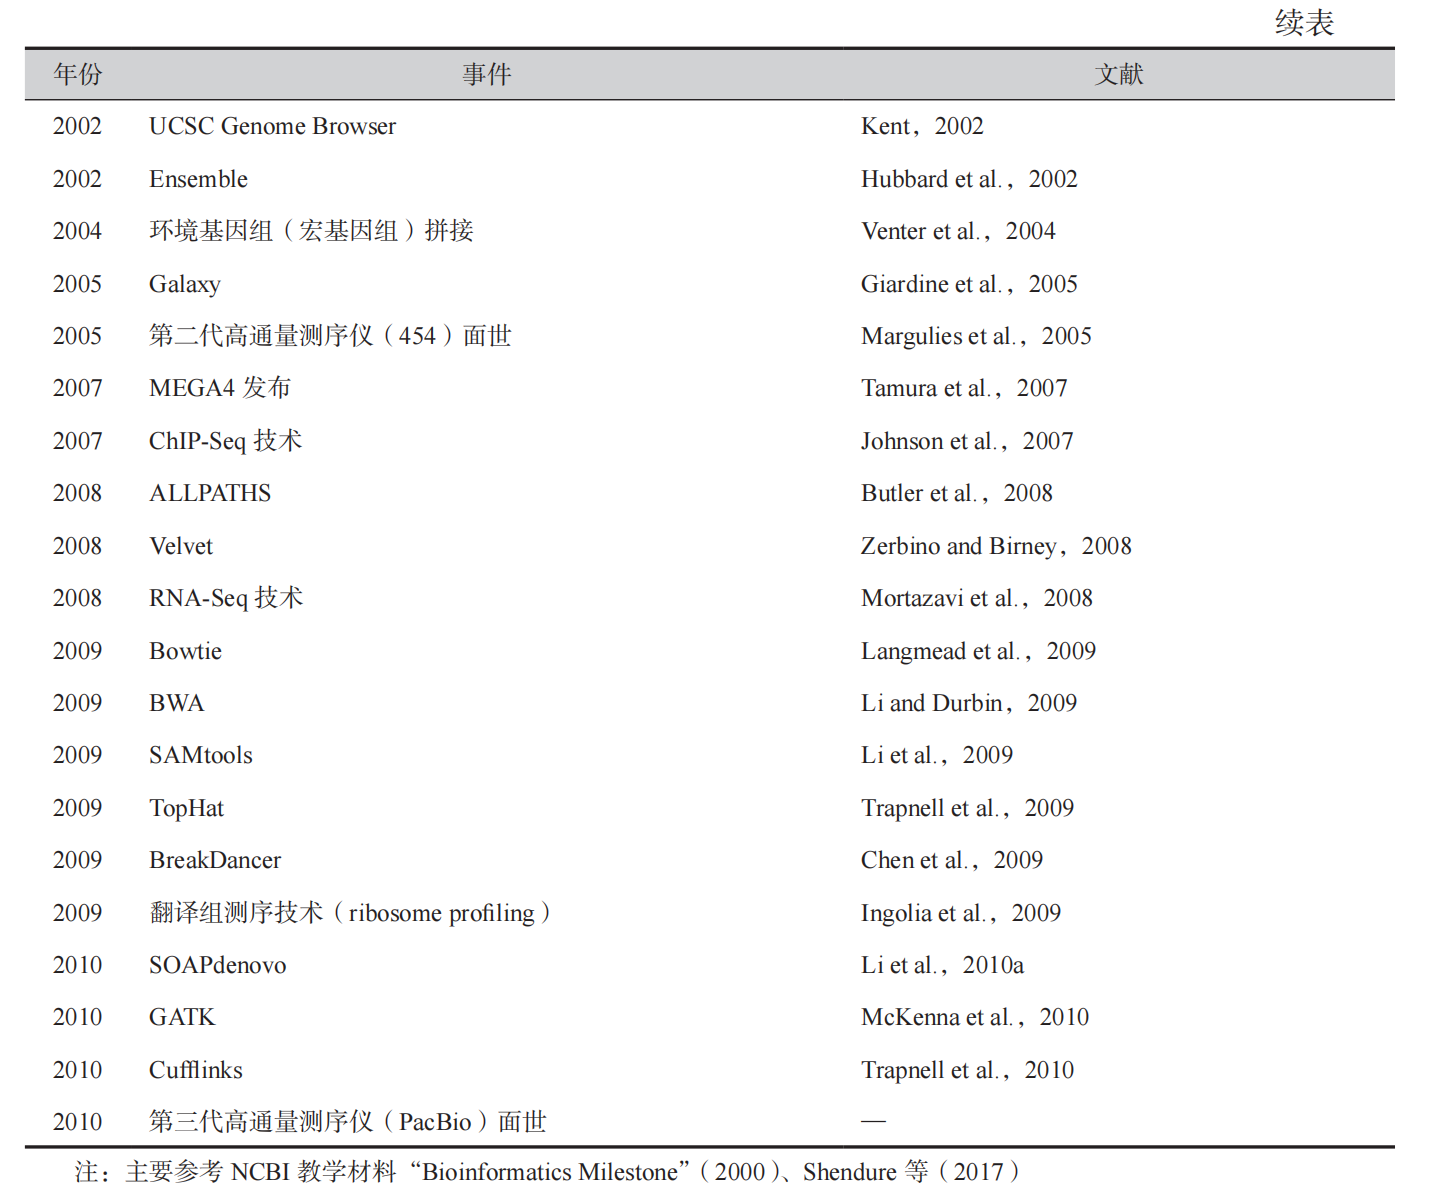
  5. 数据:表 1.1(发展大事记)——本章最值得记的干货。
  6. 易错点:术语“谁最早提出”有两种说法(Hogeweg 1978 vs Lim 1990),教材两者并存;别只记一个。
  7. 前后关系:承接“学科定位”,为“应用/展望”提供时间脉络。
  8. 页码/表:p.4–7,表 1.1。

table1.1生物信息学科发展主要事件
table1.1table1.1生物信息学科发展主要事件_续表

第二节 · 二、应用领域 【应该理解】

  1. 问题:生物信息学有什么用?入门者能做什么?
  2. 主要内容:Nature 高被引 100 篇中生物信息学(含系统发生)占 10 篇(表 1.2,含 ClustalW、BLAST、NJ、自举法、MEGA4、ModelTest、MrBayes 等);“平民化”两条路——Windows 桌面软件 与 在线 Web 服务;EBI 把在线平台分三类 SSS(序列搜索)/MSA(多序列联配)/BSA(序列分析);NAR 每年 Database Issue(1993 起) 和 Web Server Issue(2004 起) 两大专刊是“两座桥梁”。给出“何时该找专业人员帮忙”的判据(>100 条序列、需 Linux、NGS、大规模芯片数据、复杂统计等)。
  3. 核心结论:绝大多数生物学家日常工作集中在数据库搜索 + BLAST + ClustalW。
  4. 术语:SSS、MSA、BSA、workflow management system、Database Issue、Web Server Issue。
  5. 易错点:“在线服务方便”≠“适合所有场景”;超过一定规模/复杂度必须转向命令行与专业分析(本章已明说)。
  6. 前后关系:把历史落到“今天能干嘛”,并引出展望。
  7. 页码/表:p.8–9,表 1.2。

第二节 · 三、学科展望 【了解即可 + 少量必须掌握】

  1. 问题:学科往哪走?我国现状?关键待解难题?就业?
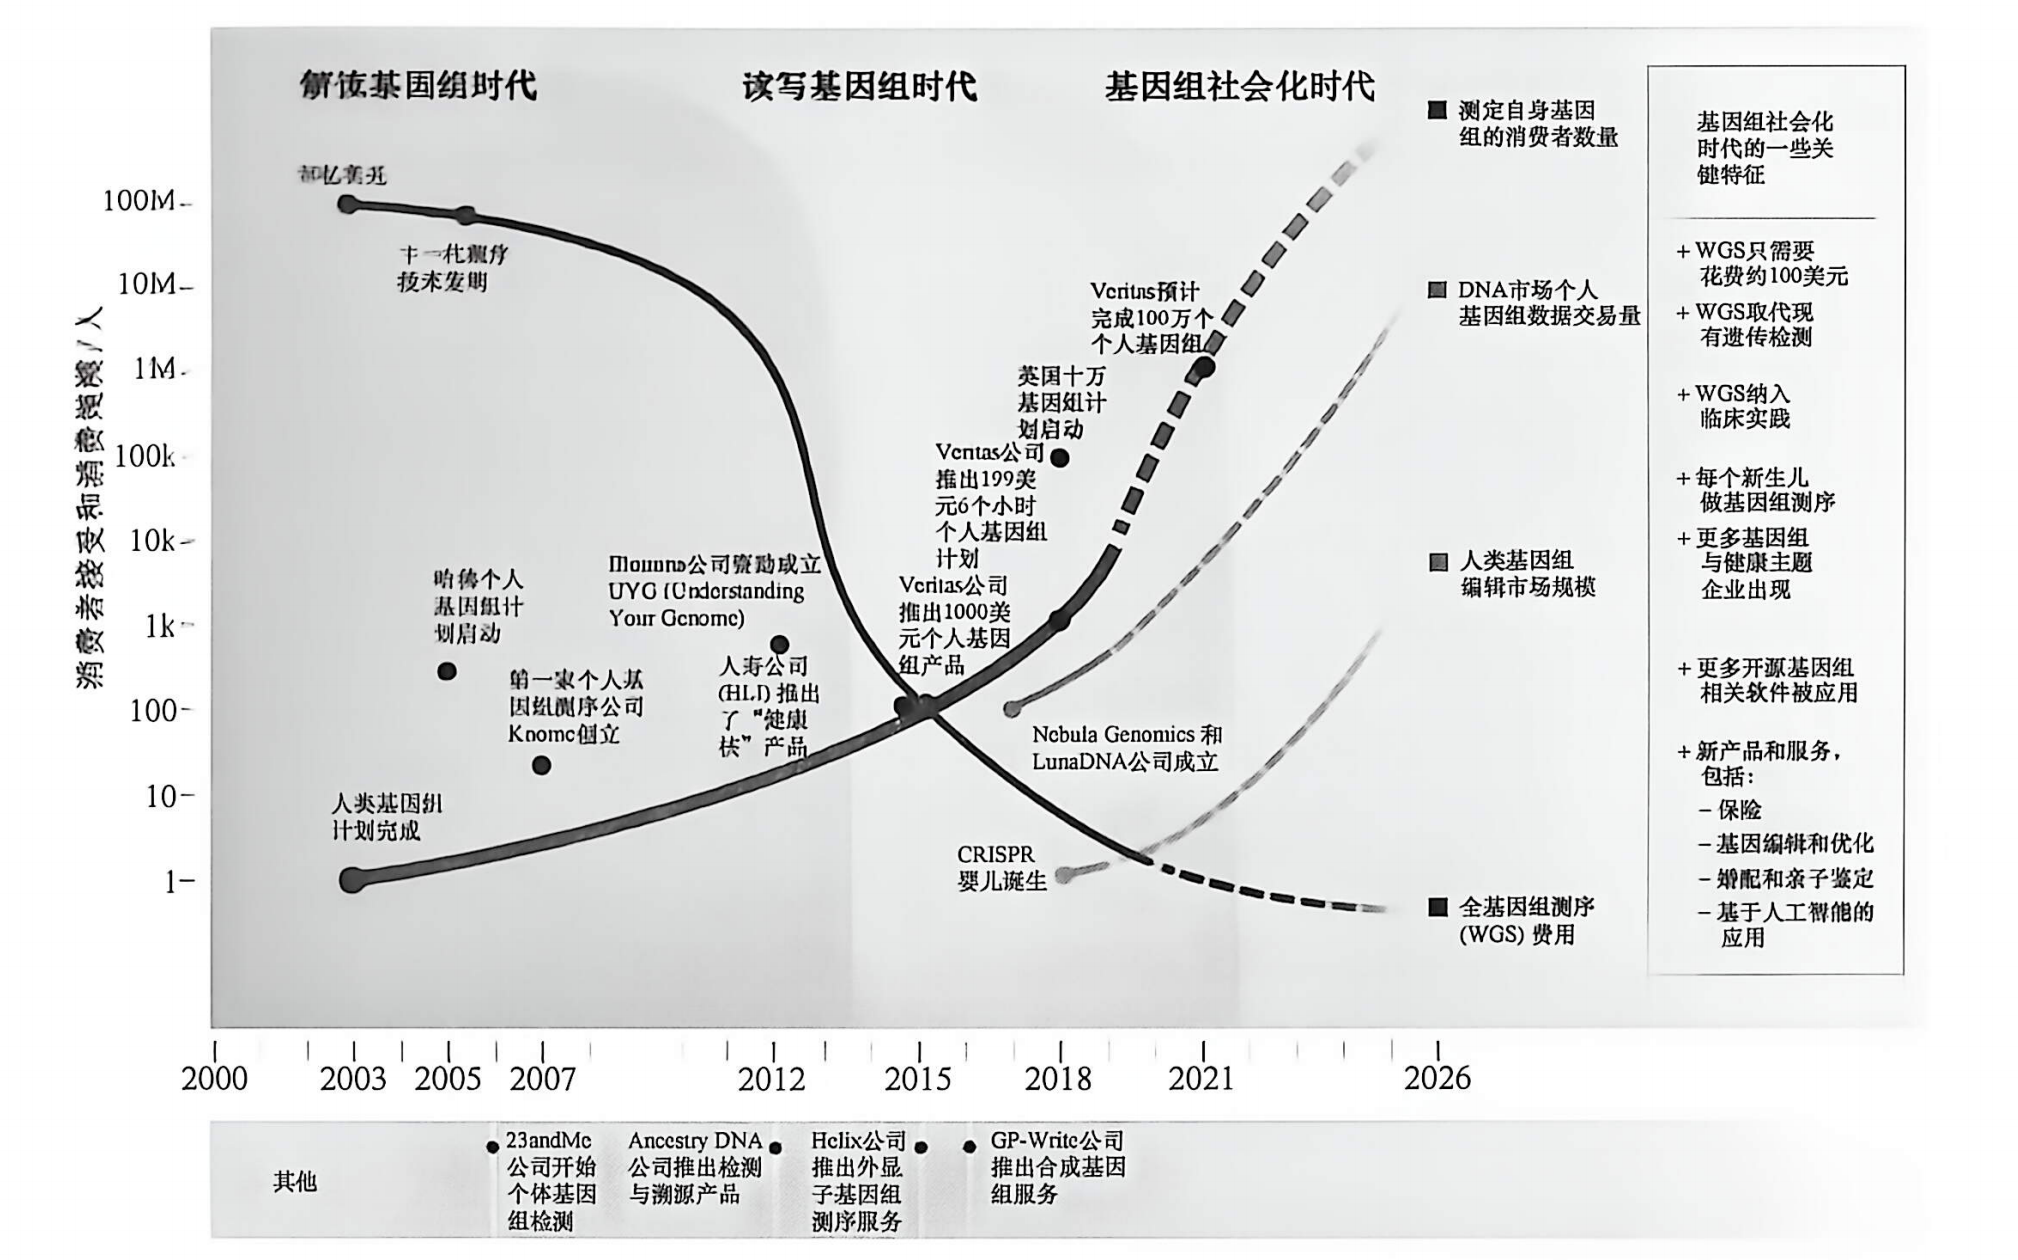
  2. 主要内容:研究重心从数据积累转向数据解读(图 1.4);人类基因组测序数据每 5–7 个月翻番(图 1.5);从“读懂基因组”走向“书写基因组/基因组社会化”(图 1.6);我国机构与人物(北大 CBI、清华、NGDC/CNCB/CNGB、终身成就奖名单);五大急需攻关技术(必须掌握其类别):①大基因组从头组装;②基因组注释;③比较基因组与进化;④群体重测序变异检测(SNP/Indel/SV/CNV);⑤RNA 分析。
  3. 核心结论:大数据时代“产生 > 处理能力”,生物信息学是瓶颈也是马达;就业前景好但要求“生物学理解 + 编程 + 统计 + Linux + 沟通”。
  4. 术语:de novo assembly、注释 annotation、SNP/Indel/SV/CNV、精准医疗、合成生物学、后基因组时代。
  5. 易错点:图 1.5/1.6 的“预测曲线”是预测,教材已注明“实际增长超过预测”——别把预测当事实。
  6. 前后关系:收束全章,指向后续章节的技术内容。
  7. 页码/图:p.9–14,图 1.4–1.7。

fig1.6 生物信息基因组发展与应用

习题 & 历史与人物 【了解即可】

  • 习题 5 道(见第 14 节 G 我已整理并给参考答案思路)。
  • 人物:Hogeweg(1978,理论生物学,迭代多序列联配、RNA 折叠预测);林华安(1988 提 bio-informatique→bioinformatics,1990 办首会)。属背景故事。

3. 生物学问题到计算问题的映射

本章是导论,没有一个具体的计算任务可映射。但它反复给出了整个学科的“总链路直觉”,我据此给出学科级映射(而非某算法的映射)。

  • 生物学对象:核酸/蛋白质序列、结构、表达、通路、群体变异。
  • 不可直接观测的状态:基因功能、进化关系、调控机制、分子结构。
  • 原始生物学问题:如何管理、解读、使用爆炸增长的生物数据。
  • 实验技术测量:(测序等)——本章不展开,属后续章节。
  • 计算任务归类(本章点名的学科任务,非本章实现):序列搜索(BLAST)、序列比对/联配(NW/SW/ClustalW)、基因组拼装(assembly)、基因预测/分类(HMM、GENSCAN)、系统发生推断(NJ、MrBayes)、变异检测(SNP/SV)。
  • 转换中丢失/推断的东西:本章的核心洞见是——生物信息学结论大多是“预测/估计”,是指示实验方向的“路灯”,最终仍需湿实验验证(“你最终还是需要具体的实验”)。

学科级链路(本章的世界观):

1
2
3
4
5
6
7
生物学问题(功能/进化/机制)
→ 高通量实验(测序等)
→ 海量原始数据(primary database)
→ 计算方法(联配/搜索/拼接/预测/推断)
→ 衍生信息(secondary database: domain/结构…)
→ 生物学解释(预测=假设)
→ 湿实验验证

4. 数据对象、文件格式和 shape

本章不定义任何文件格式,也没有可给出 shape 的数据矩阵。为忠实原文,我只把本章**提到的“数据概念”**列出,并标注“具体格式见后续章节”。请不要把下表当作可直接编程的对象。

数据对象 生物学含义 产生方式 文件格式 字段含义 shape 备注
核酸序列 DNA/RNA 一级序列 测序仪 本章未给(后续 FASTA 等) — 概念上 seq ∈ {A,T,G,C}^L 字母表 4 字符
蛋白质序列 氨基酸一级序列 由核酸推导/测定 本章未给 — seq ∈ {20 aa}^L 字母表 20 字符(教材列出 A R N D C Q E G H I L K M F P S T W Y V)
初级数据库 原始序列/结构集合 测序/结构测定汇交 GenBank/EMBL/DDBJ(名称提及,格式未展开) — — 三库联盟
二级数据库 domain/二级结构/疏水位点等 对原始数据分析 未展开 — — 衍生信息
结构数据 蛋白二级/三维结构 结构测定/预测 未展开 — — 后续章节

唯一可明确写出的“数据表示”直觉(本章反复强调):

  • 一批 DNA 序列:sequences ∈ {A,T,G,C,N}^(n × 变长)
  • 一批蛋白序列:sequences ∈ {20 种氨基酸,X}^(n × 变长)

坐标系统、0/1-based、链方向、FASTA/FASTQ 结构等——本章均未涉及,属第 2–3 章。


5. 端到端数据处理流程

本章不适用(无 pipeline)。

它只给出了“学科级的宏观流程直觉”(见第 3 节链路图),以及一个重要的实践决策规则(值得记):

何时从“在线服务/桌面软件”升级到“找专业人员 / Linux / 脚本 / workflow”:

  • 序列数 > ~100
  • 需要 Linux-only 软件
  • 使用高通量测序数据
  • 大规模数据(如芯片/表达矩阵)
  • 数据结构/完整性有问题
  • 需要复杂统计(多假设/前提/检验)

这条规则本身就是你未来搭建真实 pipeline 的“分流开关”。


6. 算法、统计模型和公式

本章不适用——无任何算法细节或公式。

但本章点名了后续要学的核心算法,先建立“待学清单”(都不在本章展开):

算法/模型 首次年份 任务类别 将在哪学
Needleman-Wunsch 1970 全局序列联配(动态规划) 第 4 章
Smith-Waterman 1981 局部序列联配(动态规划) 第 4 章
Dayhoff/PAM 替换矩阵 1965/1978 打分矩阵 第 3/4 章
BLAST/FASTA 1990/1985 数据库序列搜索(启发式) 后续章
Neighbor-Joining 1987 距离法建树 进化章
自举法 Bootstrap 1985 系统发生置信度 进化章
HMM (GENSCAN/功能域) 1994/1997 基因预测/domain(概率模型) 后续章
MrBayes 2003 贝叶斯系统发生推断 进化章

7. 软件、数据库与工具

本章是“工具全景图”,非常适合建立总览。以下区分教材角色与现状。

工具/数据库 Pipeline 位置 用途 教材角色 当前状态
GenBank / EMBL(ENA) / DDBJ 数据存储 国际核酸序列数据库(三库联盟) 经典+现代 仍在用(EMBL 现为 ENA)
NCBI / EBI / BIGD(NGDC) 门户 数据+在线分析 现代常用 活跃
BLAST / PSI-BLAST 序列搜索(SSS) 相似性搜索 经典+现代 仍是标准工具
FASTA/FASTP/FASTN 序列搜索 早期搜索引擎 经典 较少用,历史地位重要
ClustalW / Clustal X 多序列联配(MSA) MSA 经典 部分被 MAFFT/MUSCLE 取代
ORF finder / HMMER / FGENESH 序列分析(BSA) ORF/结构域/基因预测 教材工具 HMMER 仍主流
Phred-Phrap-Consed 测序碱基识别/拼接 Sanger 时代主力 经典 已被 NGS 工具取代
Bowtie/BWA/SAMtools/GATK/TopHat/Cufflinks 比对/变异/RNA-Seq NGS 分析 现代常用 仍高度活跃(表 1.1 提及)
Velvet/SOAPdenovo/ALLPATHS/Celera/EULER 基因组拼接 de novo assembly 经典/现代混合 部分被 SPAdes/长读工具取代【需要查证具体版本】
UCSC Genome Browser / Ensembl / Galaxy 浏览/workflow 可视化与流程 现代常用 活跃
MEGA4 / ModelTest / MrBayes 系统发生 建树/模型选择/贝叶斯 经典+现代 MEGA 已到 MEGA11+

教材实验偏向在线服务 + Windows;真实科研需补充:

  • Linux 命令行版(如 blastn/blastp、mafft、hmmsearch、bwa mem、samtools、gatk);
  • 批量/脚本化(Bash + Python/R);
  • workflow(Nextflow / Snakemake / Galaxy);
  • 环境管理(conda/mamba、容器 Docker/Singularity);
  • HPC(SLURM 作业调度)。
  • 本章给出的官方入口(部分可能变动,需要查证):www.bea.ki.se(早期路线图)、bigd.big.ac.cn(NGDC)、www.bioinformatics.org。

8. 实验设计、QC、偏差与结果解释

本章无具体数据分析,故传统 QC 项目不适用。但它明确了一条方法论红线,值得抽成检查清单:

分析前检查清单(本章精神)

  • 我是否清楚自己的无效假设是什么?(如“该序列无同源序列”)
  • 数据规模/复杂度是否超过在线工具能力(>100 序列、NGS、需 Linux)?
  • 我是否具备该问题的生物学背景知识(避免误解合作方需求)?

结果解释检查清单(本章反复强调)

  • 我的结果是预测/估计还是观测事实?(生物信息学多为预测=“路灯”)
  • 是否需要湿实验验证?(“你最终还是需要具体的实验”)
  • 相关性是否被误当因果?

能/不能由本章支持的结论

  • 能支持:学科定义、历史脉络、工具全景、方法论立场。
  • 不能支持:任何具体数据的分析结论(本章无数据分析)。

9. 易混淆概念

概念 A 概念 B 核心区别 联系 例子 常见误区
初级数据库 primary 二级数据库 secondary primary 存原始数据(序列/结构);secondary 存分析衍生数据(domain/二级结构) secondary 由 primary 分析而来 GenBank(primary) vs Pfam-类 domain 库(secondary) 以为二级=次要/低质量
生物信息学 bioinformatics 计算生物学 computational biology 侧重不同、常混用;前者偏数据/工具/数据库,后者偏建模/理论 高度重叠,界限模糊 Claverie 一文即讨论二者关系 认为完全等同或完全不同
序列相似性 similarity 同源性 homology 相似是可测量的数值;同源是“有共同祖先”的进化推断 高相似常提示同源,但相似≠一定同源 BLAST 报 similarity;结论说 homolog 是推断 把高相似直接当作同源
SSS / MSA / BSA — EBI 三类在线平台:搜索/多序列联配/序列分析 常串联使用 BLAST(SSS)→ClustalW(MSA)→ORF finder(BSA) 把三类混为一谈
预测 prediction 事实/注释验证 计算预测 vs 实验证实 预测指导实验 基因预测≠已证实的基因 把预测当已确证
从头拼接 de novo 参考比对 mapping 无参考 vs 有参考 都属基因组分析第一步族 de novo assembly vs BWA mapping 本章仅提名,细节在后续章

10. Toy example

本章不适用(无可计算的方法)。

作为替代,给一个能手工完成的“字母表核对”小练习(源于本章唯一具体的“数据”——字母表):

  • 生物学背景:本章说 DNA=4 字符、蛋白=20 字符。
  • 练习:教材列出的 20 个氨基酸单字母为
    A R N D C Q E G H I L K M F P S T W Y V
    → 数一数是否恰好 20 个?(答案:是,20 个)
  • 反向核对:标准 20 种氨基酸单字母中未在 DNA 字母表出现的、也未被用作特殊符号的字母有哪些?(如 B、J、O、U、X、Z 不在标准 20 内;X 常表示未知氨基酸,N 常表示未知核苷酸)
  • 意义:理解“alphabet”是后续所有序列算法的基础(打分矩阵、联配、搜索都建立在字母表上)。

最小项目目录(供你未来做真实实验时预先建立的规范,本章不产出文件):

1
2
3
4
5
6
7
project/
├── raw_data/ # 原始序列(FASTA/FASTQ,后续章节)
├── reference/ # 参考基因组/注释
├── metadata/ # 样本信息
├── results/{qc,intermediate,final}/
├── scripts/ # Python/R/Bash
└── environment/ # conda env / Dockerfile

11. 从教学实验到真实科研

本章无配套实验,但它本身就在讨论“教学式在线工具 vs 真实科研”的差别,我据此整理:

维度 教材/在线服务式(本章描述) 真实科研流程
数据规模 少量序列(<100) 海量(NGS、群体、芯片)
运行环境 Windows/浏览器点击 Linux/HPC/云
工具 在线 BLAST/ClustalW 命令行 + workflow
参数 多用默认 显式记录、可调
自动化 手工逐条 脚本/Snakemake/Nextflow
可复现 弱(无日志) 强(版本+种子+env)
QC 几乎无 系统化 QC
计算资源 一台 PC 多核/大内存/集群
结果验证 依赖直觉 对照+统计+湿实验

本章要训练的能力:建立学科世界观 + 知道有哪些工具 + 明白“何时该升级到专业流程”。
真实项目必须补充:命令行技能、脚本化、版本与参数记录、统计设计、验证。


12. 与现代机器学习的联系

本章只在“展望/就业”中点到 AI、机器学习、数据挖掘、模式识别、文本挖掘、Hadoop/MySQL,作为“未来趋势与就业技能”,没有任何可建模的数据或标签。

  • 是否适合把本章内容做成 ML 任务:不适用。
  • 唯一可记的联系(学科层面):教材把“模式识别、数据挖掘、机器学习、可视化”列为生物信息学实现目标的手段,并把 HMM 作为早期概率序列模型的代表(1994/1997)——这是经典方法通向现代序列建模(乃至今天的深度学习/大模型)的历史脉络起点。

13. 研究复现视角

本章不涉及可复现的分析,故传统复现清单不适用。

但本章提出了一个与复现直接相关的重要主张(值得作为科研伦理/复现意识记住):

  • 数据共享与尽早释放:HGP 采用“正式发表前即上网释放”的政策,许多基因组计划沿用。
  • 复现的前提是原始数据(primary data)可获取——本章反问:“测序仪每天产生的初级数据归谁所有?何时公开?能否设限?”这些正是今天数据可获得性 / 复现性的核心议题。

给你的实操提醒:从现在起养成记录 软件版本、数据库版本(如 GenBank Release 号)、访问日期、参数 的习惯——本章多处引用“GenBank Release 120/236”“数据截至 2020 年 2 月”,正示范了“引用数据库要写版本和日期”。


14. 最终汇总

A. 一页式总结

  • 核心生物学问题:生物数据爆炸(核酸库约每 14 个月翻番),如何管理、解读、使用。
  • 核心实验:无(本章为导论);学科动机来自高通量测序。
  • 核心数据:核酸序列 {A,T,G,C}、蛋白序列(20 氨基酸);初级 vs 二级数据库。
  • 核心 shape:seq ∈ {A,T,G,C}^L(概念性)。
  • 核心算法:无本章算法;预告 NW/SW/BLAST/HMM/NJ 等。
  • 核心工具:BLAST、ClustalW、NCBI/EBI 在线服务(SSS/MSA/BSA)。
  • 核心 pipeline:无;给出“何时升级到 Linux/专业流程”的分流规则。
  • 核心假设/范式:假设—实验模式(数据库搜索=一次实验)。
  • 核心 QC:区分“预测”与“事实”。
  • 核心解释边界:生物信息学结论多为预测,是“路灯”,最终需湿实验验证。

B. 必须记住的知识点(12 条)

  1. 生物信息学=研究生物信息的采集/处理/存储/传播/分析/解释的学科(分子生物学+遗传学+计算机科学)。
  2. 三大组成:新算法与统计、数据分析与解释、数据管理工具。
  3. 初级数据库(原始) vs 二级数据库(衍生 domain/结构等)。
  4. DNA 字母表 4 个;蛋白字母表 20 个(会背单字母更好)。
  5. 术语提出者两说:Hogeweg(1978) / 林华安(1990)。
  6. 三位奠基人:Dayhoff、Waterman、Sankoff。
  7. 历史四阶段:萌芽/形成/基因组与互联网/高通量测序。
  8. 里程碑算法年份:NW 1970、SW 1981、NJ 1987、BLAST 1990、HMM 应用 1994。
  9. 三大数据库联盟:GenBank + EMBL(ENA) + DDBJ。
  10. EBI 在线平台三类:SSS / MSA / BSA;NAR 两大专刊:Database Issue(1993)、Web Server Issue(2004)。
  11. 研究范式=假设—实验;结论多为预测,需实验验证(“最终还是需要具体的实验”)。
  12. 五大待攻关技术:从头组装、注释、比较基因组/进化、群体变异检测(SNP/Indel/SV/CNV)、RNA 分析。

C. 术语表

缩写/术语 英文全称 中文含义 本节作用
bioinformatics bioinformatics 生物信息学 学科主题
primary database primary database 初级数据库 存原始数据
secondary database secondary database 二级数据库 存衍生信息
domain domain 结构域/功能区 二级数据库内容
WGS Whole Genome Shotgun 全基因组鸟枪法(数据) GenBank 单列大类
NGS Next-Generation Sequencing 二代/高通量测序 第四阶段核心
SSS Sequence Search Service 序列搜索服务 EBI 平台分类
MSA Multiple Sequence Alignment 多序列联配 EBI 平台分类
BSA Biological Sequence Analysis 生物序列分析 EBI 平台分类
NW Needleman-Wunsch 全局联配算法 萌芽期里程碑
SW Smith-Waterman 局部联配算法 形成期里程碑
HMM Hidden Markov Model 隐马尔可夫模型 基因预测/domain
NJ Neighbor-Joining 邻接法 建树
SNP/Indel/SV/CNV 见全称 单核苷酸多态/插入缺失/结构变异/拷贝数变异 群体变异类型
HGP Human Genome Project 人类基因组计划 数据共享范例
NAR Nucleic Acids Research 期刊名 两大专刊来源
ISCB International Society for Computational Biology 国际计算生物学会 Bioinformatics 期刊主办
NGDC/CNCB/CNGB 见正文 国家基因组科学数据中心/国家生物信息中心/国家基因库 我国机构

正名:EMBL Data Library → 现 ENA;表 1.1 中 “Ensemble”应为 Ensembl,“Fleischman”应为 Fleischmann。

D. 数据 shape 汇总表

阶段 数据对象 行/列/字段 shape 数据类型 文件格式
概念 DNA 序列 字符序列 {A,T,G,C}^L 字符 (后续 FASTA)
概念 蛋白序列 字符序列 {20 aa}^L 字符 (后续 FASTA)

本章仅此两项为概念性;无真实矩阵/坐标/文件结构。

E. 工具汇总表

阶段 工具 输入 输出 核心参数 QC
序列搜索 BLAST 查询序列+库 相似命中(E-value 等) 见后续章 区分相似/同源
多序列联配 ClustalW 多条序列 MSA 见后续章 人工检查列
数据/门户 NCBI/EBI/NGDC — 数据+在线分析 — 记录版本日期

参数细节本章未给,均属后续章节/官方文档,需要查证。

F. 掌握程度清单

  • 应能口头解释:生物信息学定义、三大组成、初级/二级数据库、假设—实验范式、历史四阶段、“预测=路灯,需实验验证”。
  • 应能手工计算:本章无(仅字母表计数练习)。
  • 应能从头编程实现:本章无算法(NW/SW 留待第 4 章)。
  • 应能调用工具完成:能在 NCBI/EBI 上做一次在线 BLAST(作为体验,细节后续学)。
  • 应能设计的 pipeline:本章无;但应记住“何时升级到 Linux/脚本/专业流程”的判据。
  • 只需知道其存在:具体人物生平、我国机构名单、期刊史、就业调查细节、表 1.1 全部年份(记大事件即可)。

G. 自测题

概念题

  1. 用一句话给出生物信息学的定义,并列出其三大组成部分。
  2. 初级数据库与二级数据库有何区别?各举一例。
  3. 为什么说生物信息学结论常是“预测”而非“事实”?举例说明假设—实验范式。
  4. 谁被认为是“bioinformatics”一词的提出者?为何有两种说法?
  5. EBI 把在线分析平台分为哪三类?各对应什么任务?

数据格式与 shape 题
6. DNA 与蛋白质序列的字母表各有多少字符?分别写出。
7. 用集合记号写出“一条 DNA 序列”的概念表示,并说明 L 代表什么。
8. GenBank 为什么把 WGS 数据单列一类?这提示序列数据具有什么特征?

算法/公式题(本章仅涉及“提名”,考查历史定位)
9. Needleman-Wunsch 与 Smith-Waterman 分别属于哪种联配、分属哪个历史阶段?
10. HMM 在生物信息学中最早被用于哪两类任务(举本章提到的例子)?
11. 按提出年份排序:BLAST、Neighbor-Joining、Needleman-Wunsch、Smith-Waterman。

pipeline 设计题
12. 你拿到 500 条蛋白序列要做进化分析,为什么不建议全程用在线网页工具?给出本章依据。
13. 请据本章“何时求助专业人员”的判据,列出至少 4 种应转向专业/Linux 流程的情形。
14. 若要让一次 BLAST 分析可复现,你至少应记录哪些信息?(结合第 13 节)

批判性思考题
15. 教材说数据每若干月翻一番、并给出“预测曲线”,你如何看待“预测被实际超过”这一事实对“数据处理能力滞后”论断的支持或削弱?
16. “人人都能做生物信息学”这一说法错在哪里?请从经费、软件、验证三方面反驳。

参考答案

  1. 研究生物信息的采集、处理、存储、传播、分析与解释的交叉学科(分子生物学+遗传学+计算机科学);三大组成=新算法与统计方法、数据分析与解释、数据管理与利用工具。
  2. 初级库存原始数据(如 GenBank 的序列、PDB 的结构);二级库存由原始数据分析衍生的信息(如结构域 domain、二级结构、疏水位点)。
  3. 因为多数结果是从数据中推断/估计出来的(如同源、基因位置、结构),不是直接观测;它像“路灯”指示实验方向。范式:先立无效假设(如“该序列无同源序列”),用数据库搜索作为“实验”去验证,拒绝或接受假设,最终仍需湿实验确证。
  4. 两说:Paulien Hogeweg(1978,最早文献)与林华安 Hwa A. Lim(1990 年被普遍认为提出并办首会);因不同来源追溯口径不同,教材两者并存。
  5. SSS(序列搜索)、MSA(多序列联配)、BSA(序列分析)。
  6. DNA 4 个:A、T、G、C;蛋白 20 个:A R N D C Q E G H I L K M F P S T W Y V。
  7. seq ∈ {A,T,G,C}^L,L=序列长度(碱基数),不同序列 L 可变。
  8. 因为 WGS(全基因组鸟枪法)数据体量极大(万亿 bp 级),单列便于管理;提示序列数据规模巨大、增长极快、异质。
  9. NW=全局联配,属萌芽期(1970);SW=局部联配,属形成期(1981)。
  10. 功能域(domain)分析 与 基因预测(GENSCAN)。
  11. NW(1970) → SW(1981) → NJ(1987) → BLAST(1990)。
  12. 序列数已接近/超过在线工具适用上限(本章以 >100 条为经验阈值),且进化分析常需模型选择、自举、复杂统计与批处理,网页工具难以胜任、不可批量、难复现——本章明确建议此类情形求助专业/Linux 流程。
  13. ①>100 条序列;②需 Linux-only 软件;③使用高通量测序数据;④处理大规模数据(如芯片/表达矩阵);⑤数据结构或完整性有问题;⑥需复杂统计(多假设/前提/检验)。(任列 4 项)
  14. 查询序列与数据库、数据库版本与访问日期、程序与版本、参数(矩阵、E-value 阈值、gap 罚分等)、运行环境。
  15. 开放题要点:实际增长超过预测,说明数据产生速度被低估,反而强化“数据产生 > 处理能力”的论断;同时提醒“预测曲线”不可当精确定律,应关注趋势方向而非具体数值。
  16. ①经费误解:算力/大型机与商业软件昂贵,并非零成本;②软件误解:先进商业软件多需付费,非全免费;③验证误解:计算结果是预测,“最终还是需要具体实验”,仅有电脑和教科书不足以产出可靠科学结论。

H. 下一步学习建议

  • 下一节/章:进入第 2 章(生物数据/数据类型),把本章“核酸/蛋白/结构/初级二级库”的概念落到具体文件格式与 shape;随后第 3 章(数据库、Dayhoff)、第 4 章(序列联配 NW/SW,Waterman)。
  • 需补的前置:中心法则、碱基/氨基酸生化基础;命令行入门(bash)、Python 基础——本章已明确点名为必备技能。
  • 值得亲手实现的算法:读到第 4 章时,自己用 Python 实现 Needleman-Wunsch(本章埋下的最经典起点)。
  • 值得实际运行的工具:去 NCBI 做一次在线 BLAST,体验 SSS 流程;再用 EBI 做一次 ClustalW/MSA。
  • 值得手工查看的文件格式:下一章的 FASTA(本章尚未出现,但是所有后续分析的入口)。
  • 配套实验:本章无专属实验;从第 2/3 章起对接《实验指导》中数据库检索与 BLAST/ClustalW 实验。
  • 需查最新官方资料:GenBank/ENA/DDBJ 现状与最新 Release、NGDC(bigd.big.ac.cn)、BLAST/ClustalW 现行版本与替代工具(MAFFT/MUSCLE、DIAMOND)——本章数字截至 2020 年,需要查证更新。
引言

参照的是左程云的课程:https://space.bilibili.com/8888480/lists/3509640?type=series

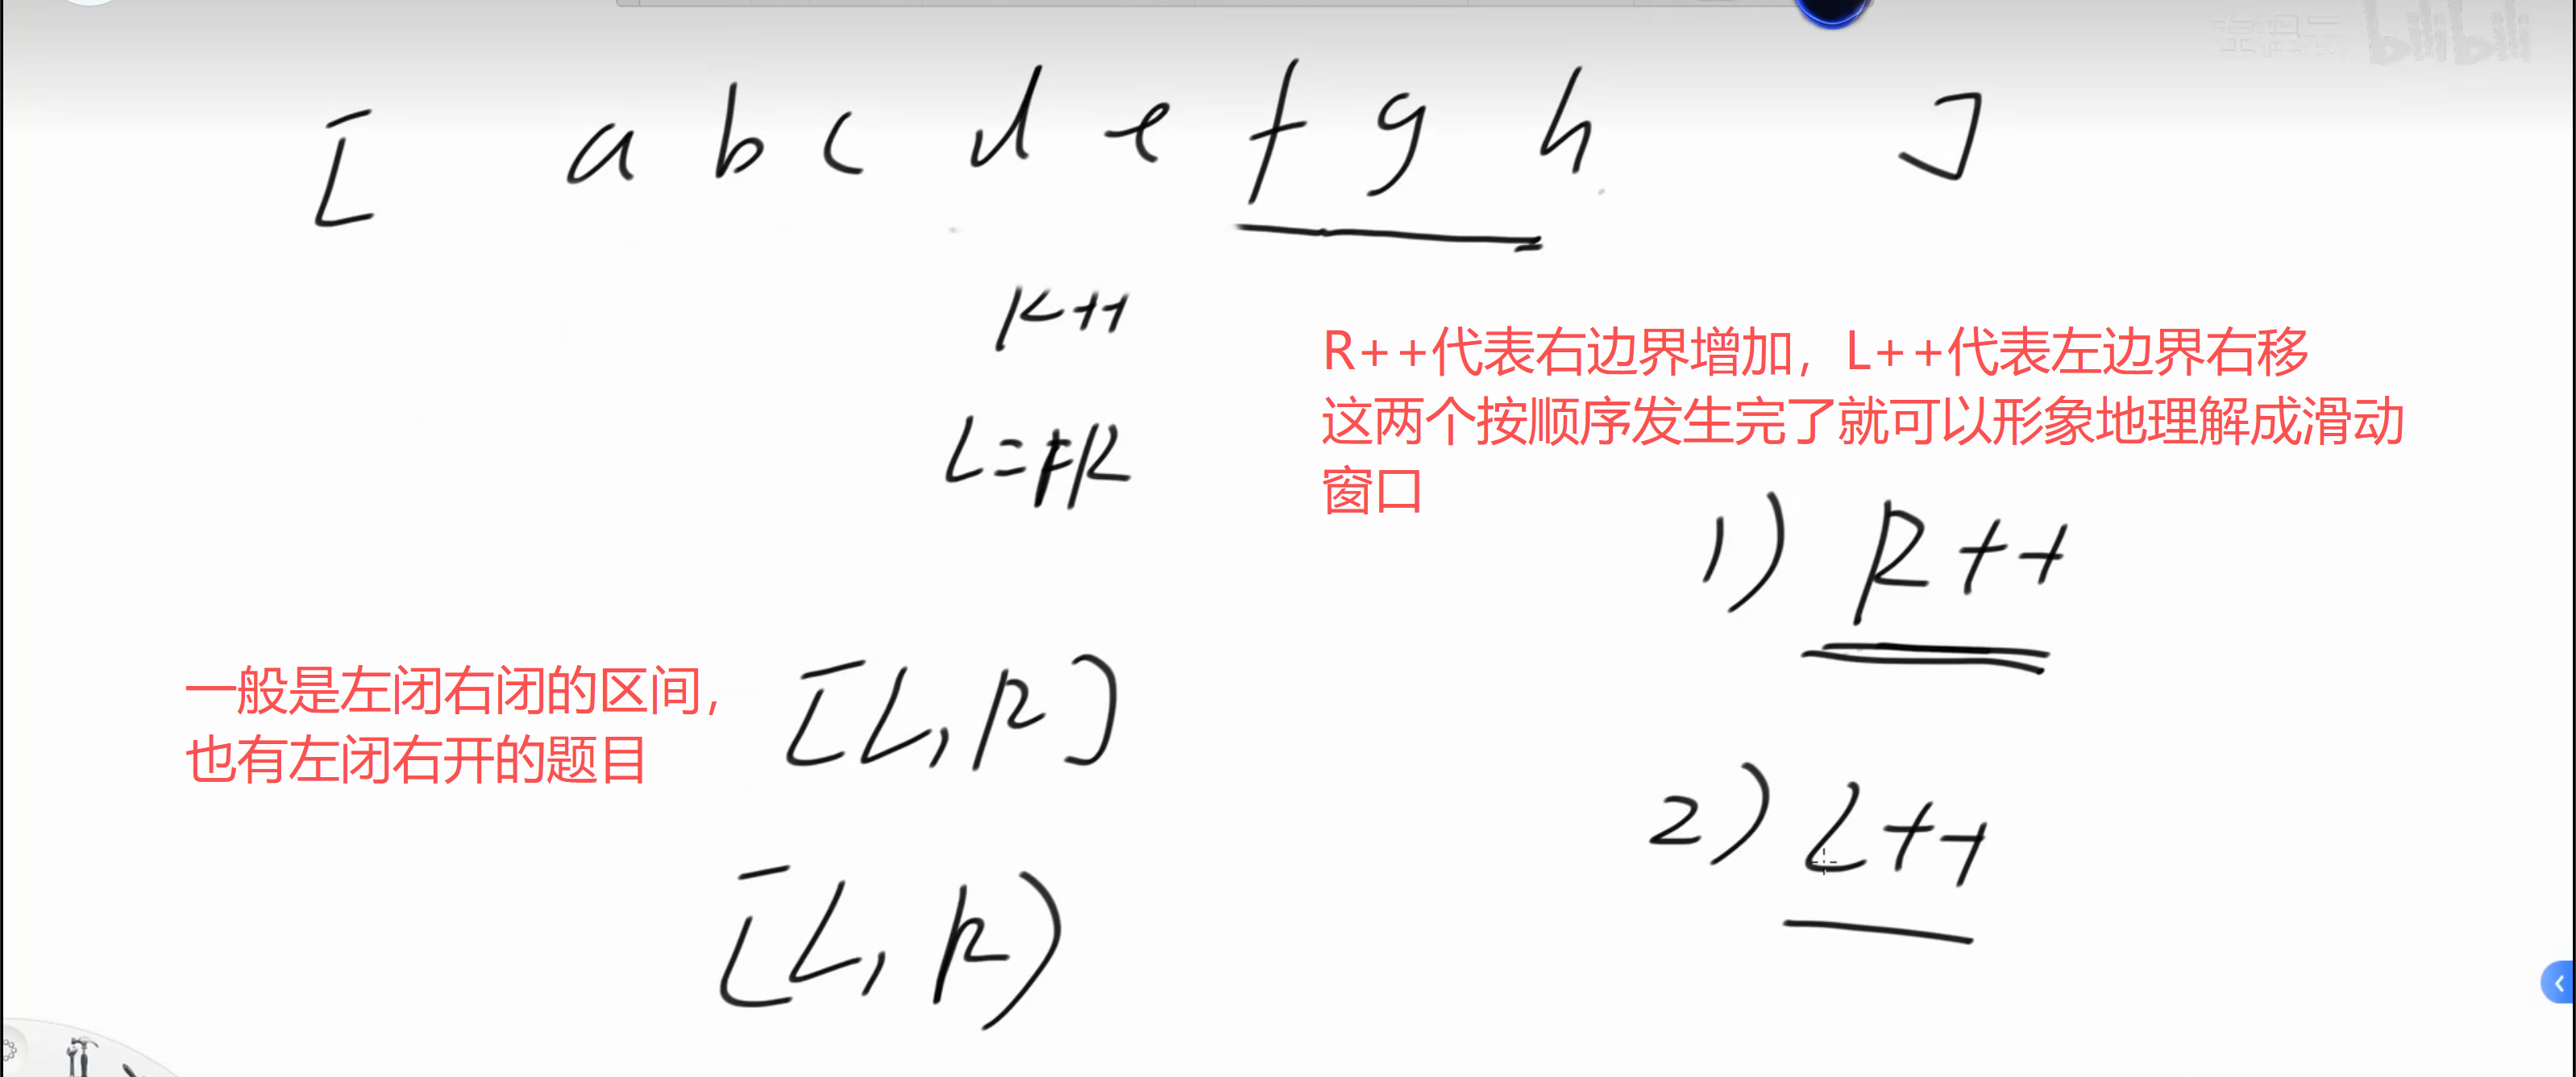
本笔记为class49的内容。滑动窗口是处理子数组(子串)问题的重要技巧,通过维持左右边界都不回退的一段范围,可以高效求解各类连续区间问题。
前置知识

学习滑动窗口之前,需要掌握以下基础知识:

  • 双指针的基本概念
  • 数组和字符串的基本操作
  • 哈希表或数组的计数技巧
  • 贪心思想的理解

049【必备】滑动窗口技巧与相关题目

基本思想

滑动窗口是通过维护一个动态区间来求解子数组或子串问题的技巧:

  • 核心特征:左右边界都不回退(单调移动)
  • 关键要素:找到范围和答案指标之间的单调性关系
  • 维护信息:使用简单变量或额外结构(如数组、哈希表)来维护窗口信息
  • 求解方式:通常固定一个边界(左或右),移动另一个边界来找答案

单调性关系

滑动窗口能够应用的前提是找到单调性:

1
2
3
4
5
6
7
# 示例1:累加和的单调性
# 范围变大 → 累加和一定变大(或不变)
# 范围变小 → 累加和一定变小(或不变)

# 示例2:字符种类的单调性
# 范围变大 → 字符种类一定增加(或不变)
# 范围变小 → 字符种类一定减少(或不变)

窗口维护策略

1
2
3
4
5
6
7
8
9
10
11
12
13
# 标准滑动窗口模板
l = 0 # 左边界
for r in range(n): # 右边界遍历
# 1. 扩展右边界,加入新元素
add_element(r)

# 2. 收缩左边界,维持窗口性质
while not_valid():
remove_element(l)
l += 1

# 3. 更新答案
update_answer(l, r)

滑动窗口理解


题目一:长度最小的子数组

问题描述

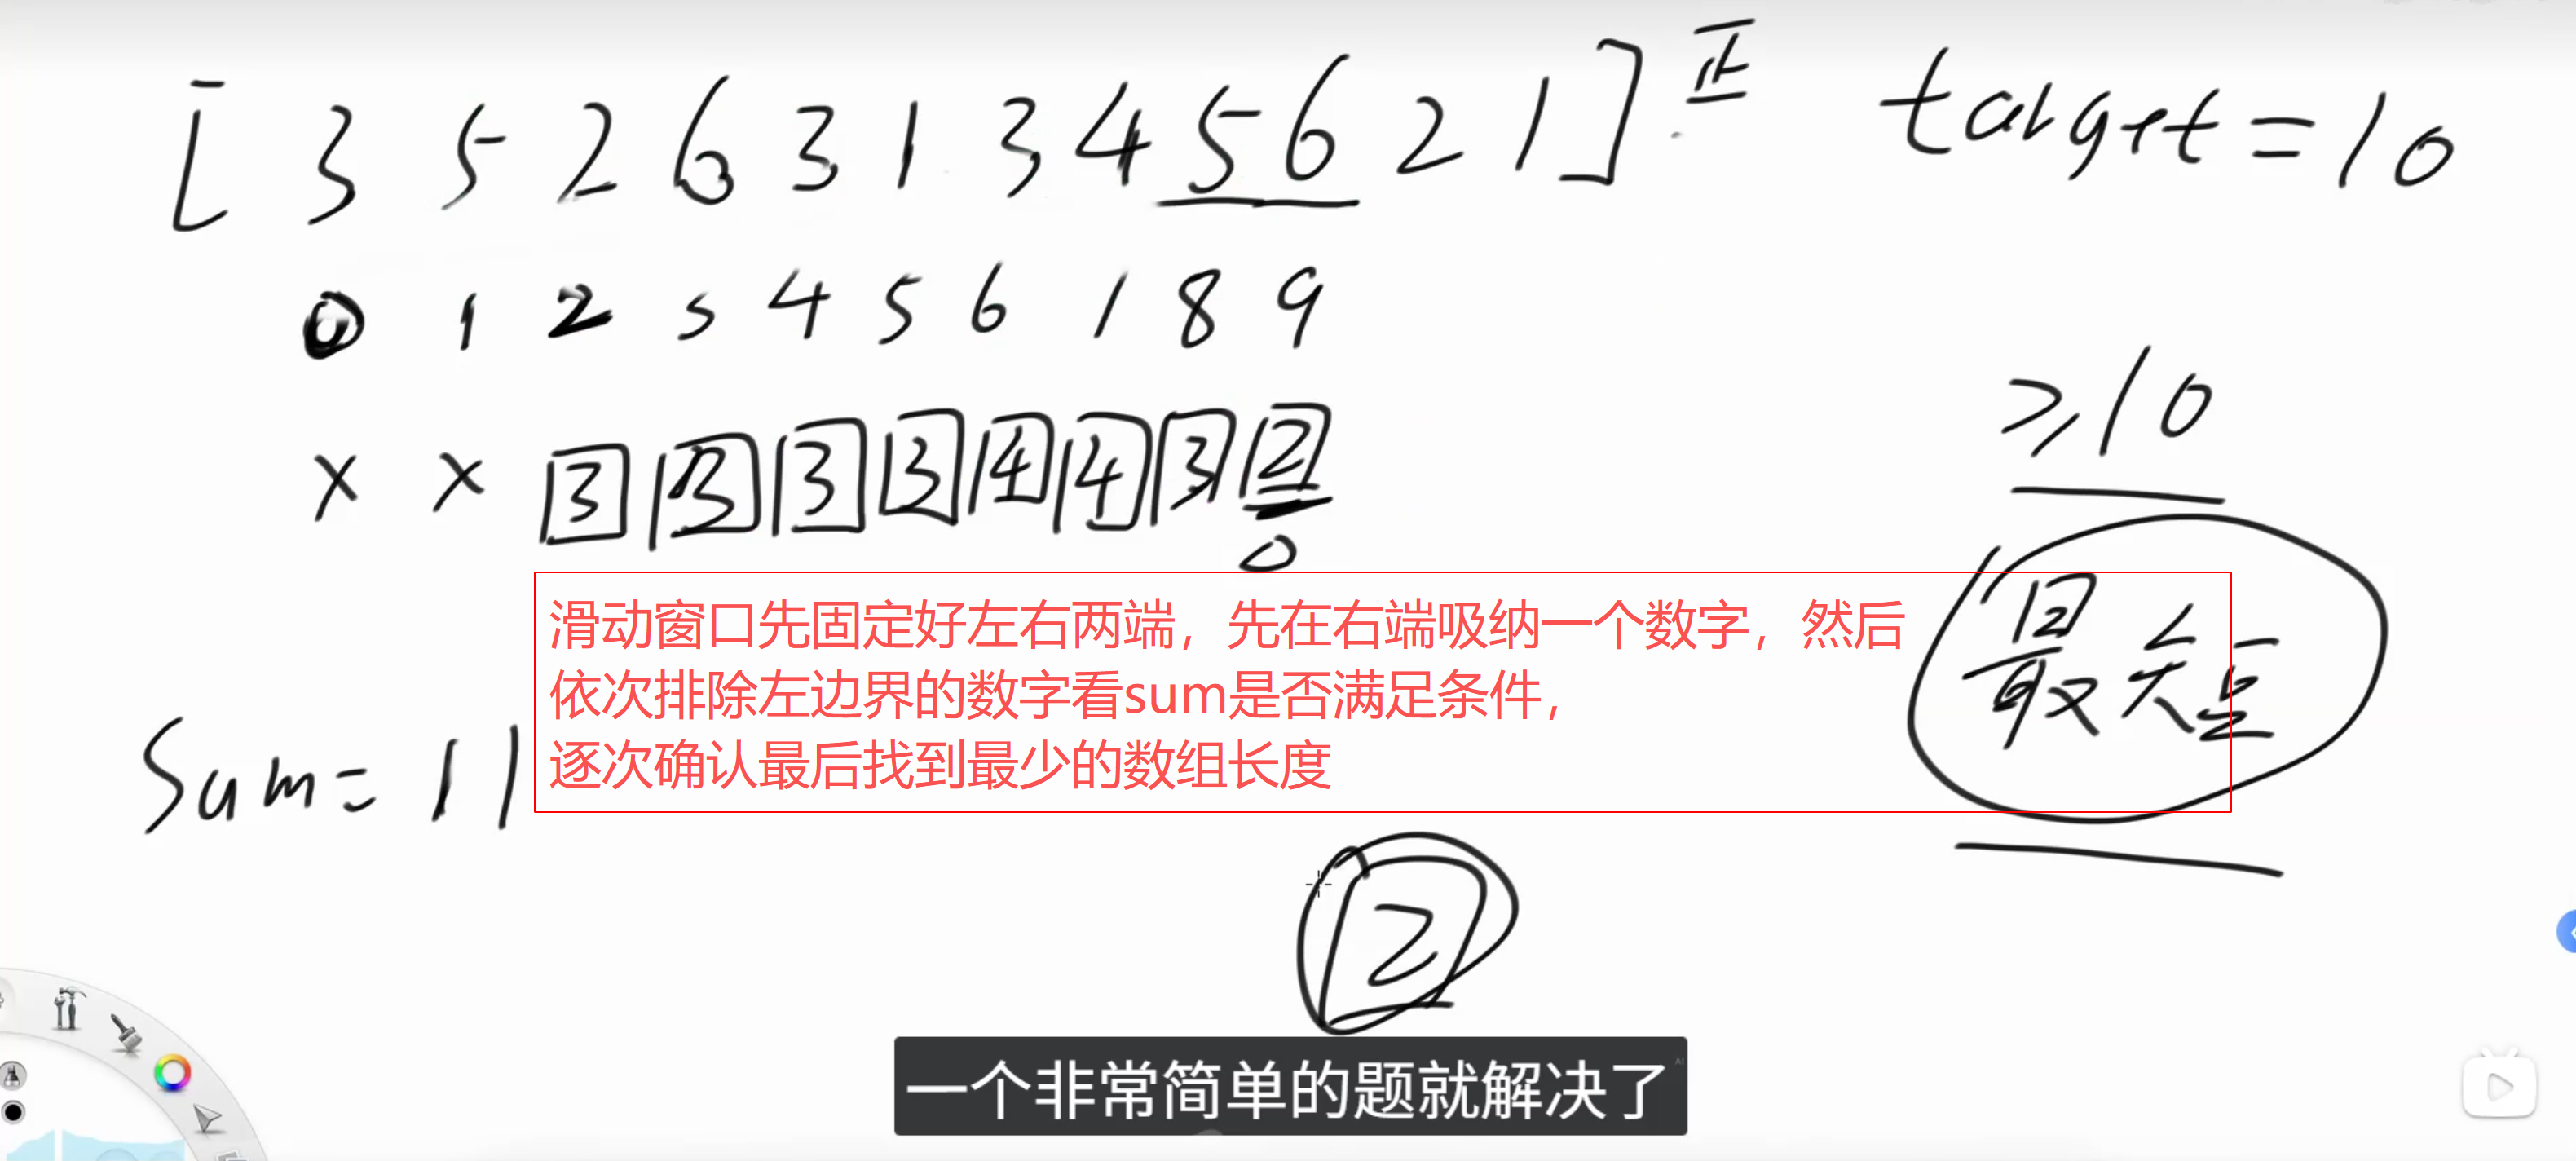
给定一个含有n个正整数的数组和一个正整数target,找到累加和≥target的长度最小的子数组并返回其长度。如果不存在符合条件的子数组返回0。

测试链接:https://leetcode.cn/problems/minimum-size-subarray-sum/

题目一

核心思想

利用累加和的单调性质:范围变大累加和一定增加

  1. 右边界扩展:不断加入新元素增加累加和
  2. 左边界收缩:当满足条件时,尝试缩小窗口
  3. 贪心策略:在满足条件的前提下找最小长度
1
2
3
4
5
6
7
8
9
10
11
12
13
14
示例:target = 7, nums = [2,3,1,2,4,3]

初始:l=0, r=0, sum=0
r=0: sum=2, [2]
r=1: sum=5, [2,3]
r=2: sum=6, [2,3,1]
r=3: sum=8, [2,3,1,2] ✓ 满足,尝试收缩
→ 移除2,sum=6 < 7,不满足,停止收缩
答案=4
r=4: sum=10, [3,1,2,4] ✓ 满足,收缩
→ 移除3,sum=7 ✓ 仍满足,继续
→ 移除1,sum=6 < 7,停止
答案=min(4,3)=3
...

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
class Solution:
def minSubArrayLen(self, target: int, nums: list[int]) -> int:
"""
滑动窗口求最短达标子数组

时间复杂度:O(n)
- 虽然是for+while双层循环,但每个元素最多被访问两次
- 右指针遍历n次,左指针最多移动n次

空间复杂度:O(1)
"""
ans = float('inf') # 初始化答案为无穷大
l = 0 # 左指针
sum_val = 0 # 当前窗口的累加和

# 右指针遍历数组
for r in range(len(nums)):
sum_val += nums[r] # 右边界扩展,加入新元素

# 尝试收缩左边界,保持累加和刚好 >= target
# 贪心思想:如果去掉l位置的数还能达标,那就去掉
while sum_val - nums[l] >= target:
sum_val -= nums[l] # l位置的数从窗口出去
l += 1 # 左指针右移

# 如果当前窗口满足条件,更新答案
if sum_val >= target:
ans = min(ans, r - l + 1)

# 如果没有找到满足条件的子数组,返回0
return 0 if ans == float('inf') else ans

算法分析

  • 时间复杂度:O(n)(每个元素最多访问两次)
  • 空间复杂度:O(1)
  • 关键技巧:贪心收缩窗口

题目二:无重复字符的最长子串

问题描述

给定一个字符串s,请找出其中不含有重复字符的最长子串的长度。

测试链接:https://leetcode.cn/problems/longest-substring-without-repeating-characters/

题目二

核心思想

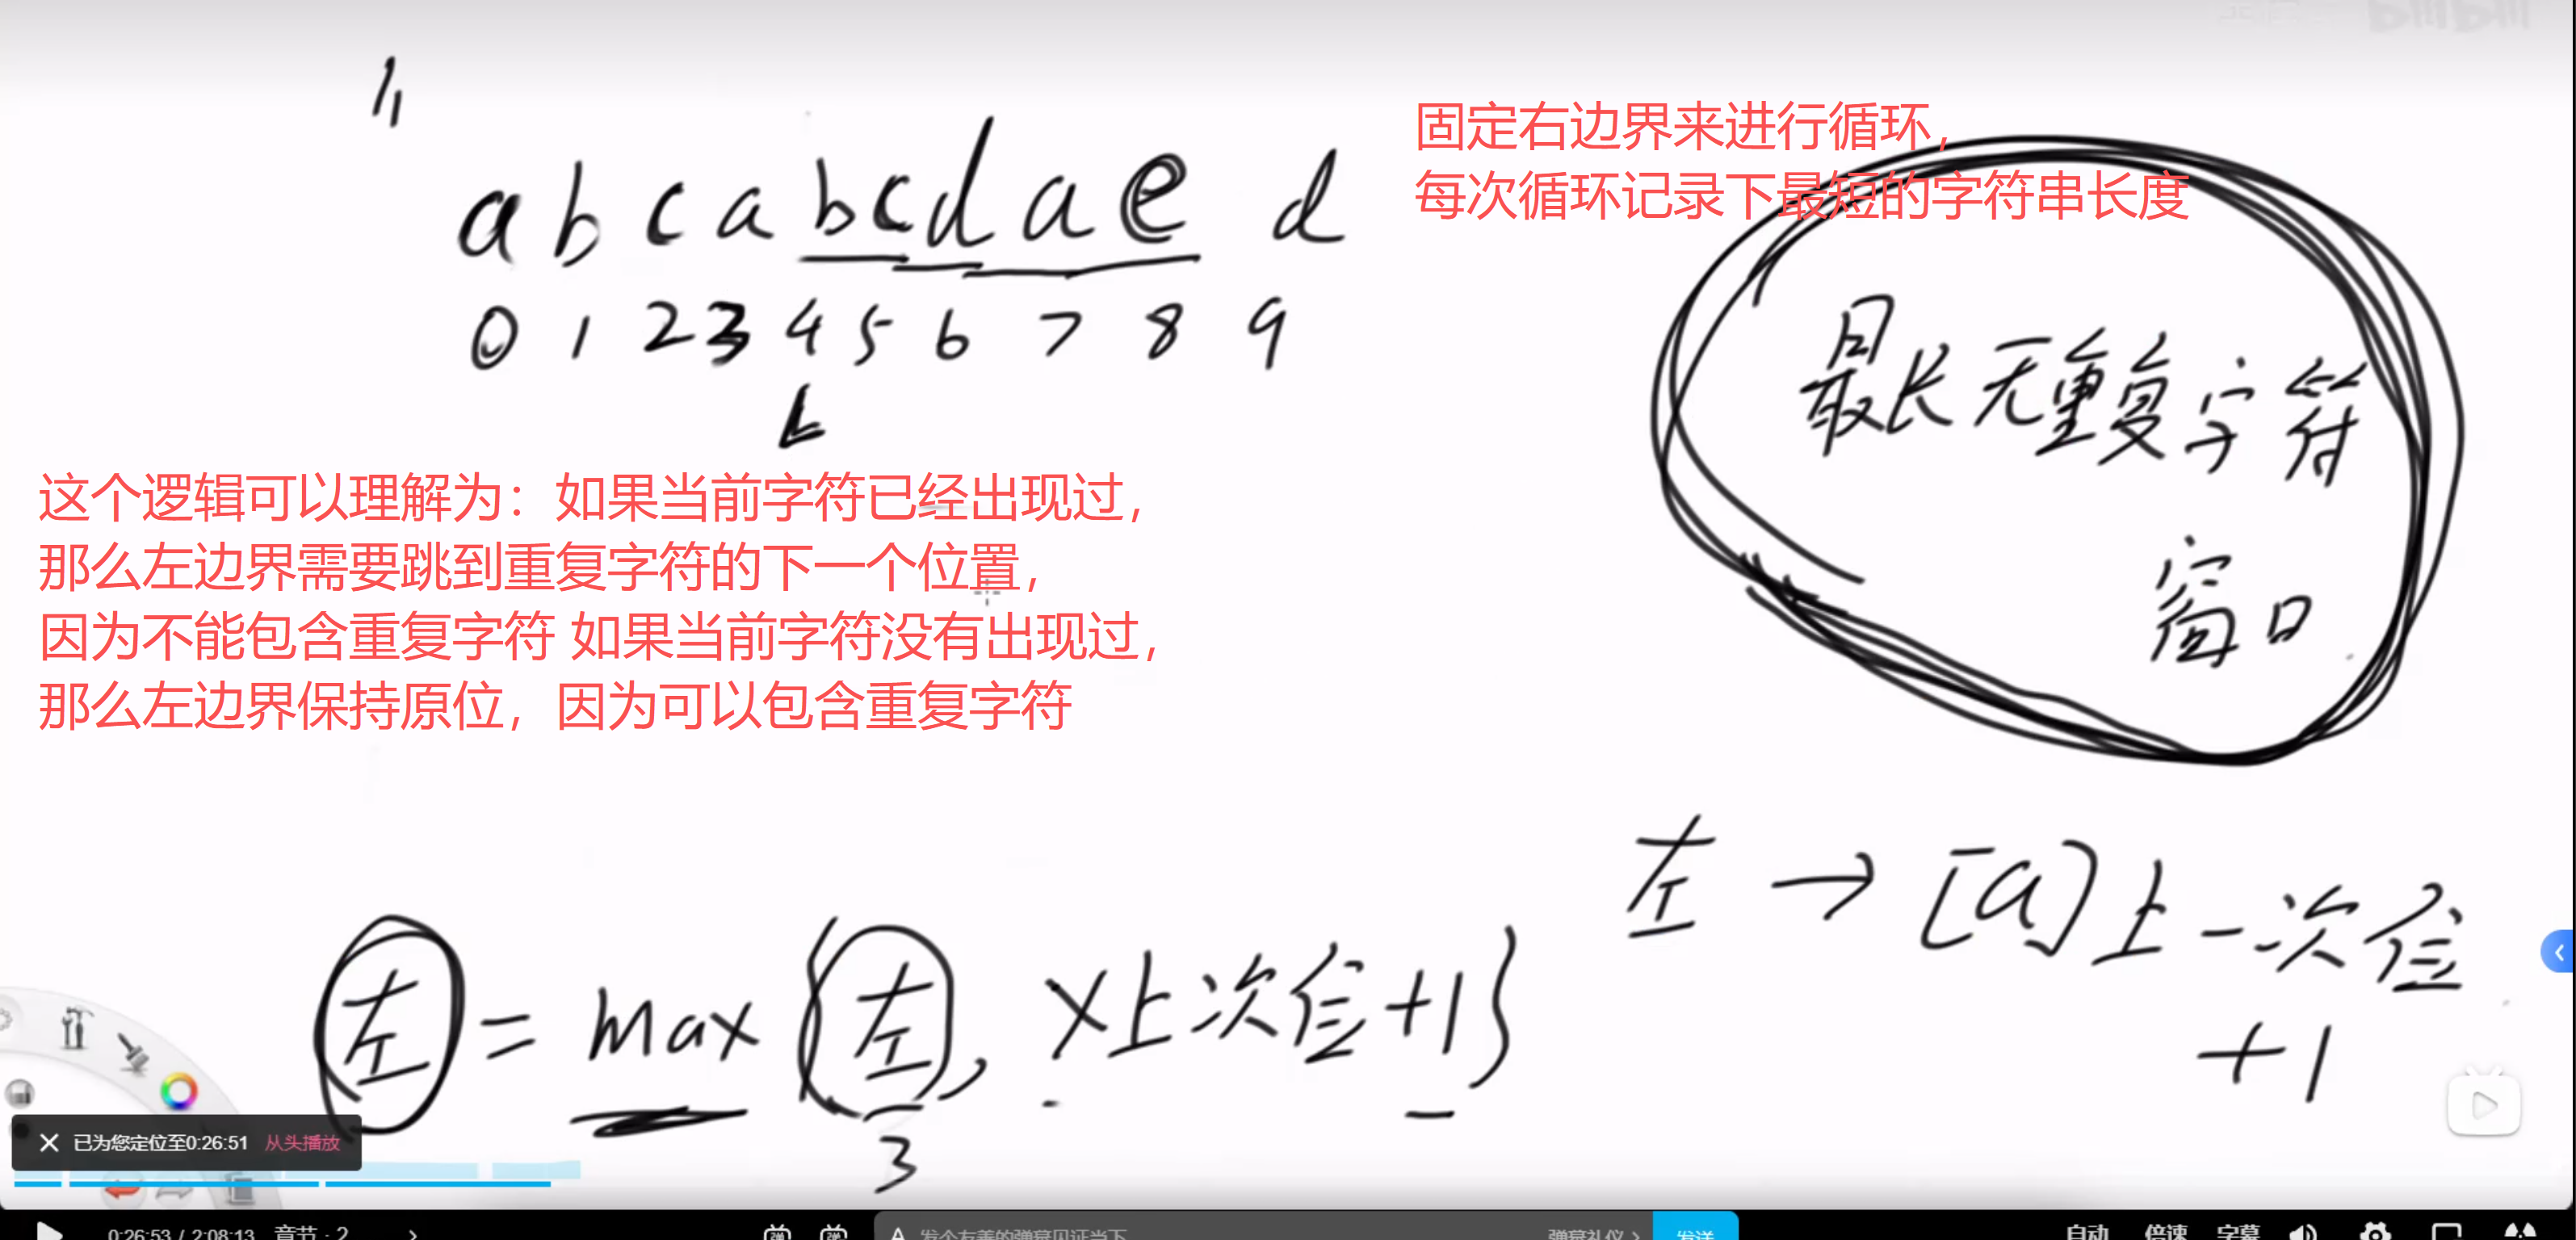
使用数组记录每个字符最后出现的位置,动态调整左边界:

  1. 位置记录:last[c]记录字符c上次出现的位置
  2. 左边界更新:遇到重复字符时,左边界跳到重复位置的下一位
  3. 答案更新:每次右边界扩展时更新最长长度
1
2
3
4
5
6
7
8
9
10
示例:s = "abcabcbb"

r=0: 'a', last['a']=-1→0, l=0, len=1
r=1: 'b', last['b']=-1→1, l=0, len=2
r=2: 'c', last['c']=-1→2, l=0, len=3
r=3: 'a', last['a']=0→3, l=max(0,0+1)=1, len=3
↑重复了,左边界跳到1
r=4: 'b', last['b']=1→4, l=max(1,1+1)=2, len=3
r=5: 'c', last['c']=2→5, l=max(2,2+1)=3, len=3
...

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
class Solution:
def lengthOfLongestSubstring(self, s: str) -> int:
"""
滑动窗口 + 位置记录

核心思想:
1. 固定窗口右边界,动态调整左边界
2. 使用last数组记录每个字符上次出现的位置
3. 遇到重复字符时,左边界跳到重复字符的下一个位置

时间复杂度:O(n)
空间复杂度:O(1)(last数组固定256大小)
"""
n = len(s)
# 记录每个字符上次出现的位置,初始化为-1表示未出现过
last = [-1] * 256 # ASCII码范围
ans = 0 # 记录最长子串的长度
l = 0 # 左指针

# 右指针遍历字符串
for r in range(n):
char_code = ord(s[r]) # 获取字符的ASCII码

# 更新左指针:要么保持原位,要么跳到重复字符的下一个位置
# 这个逻辑可以理解为:如果当前字符已经出现过,那么左边界需要跳到重复字符的下一个位置,因为不能包含重复字符
# 如果当前字符没有出现过,那么左边界保持原位,因为可以包含重复字符
l = max(l, last[char_code] + 1)

# 更新答案
ans = max(ans, r - l + 1)

# 更新当前字符最后出现的位置
last[char_code] = r

return ans

关键点说明

1
2
3
4
5
6
7
8
# 为什么使用max(l, last[char_code] + 1)?

示例:"abba"
r=0: 'a', last['a']=-1, l=max(0,-1+1)=0 ✓
r=1: 'b', last['b']=-1, l=max(0,-1+1)=0 ✓
r=2: 'b', last['b']=1, l=max(0,1+1)=2 ✓ 左边界跳过第一个'b'
r=3: 'a', last['a']=0, l=max(2,0+1)=2 ✓ 左边界不回退
如果不用max,会错误地回到1

算法分析

  • 时间复杂度:O(n)
  • 空间复杂度:O(1)(256大小的数组)
  • 优化技巧:通过位置数组避免重复扫描

题目三:最小覆盖子串

问题描述

给你一个字符串s、一个字符串t。返回s中涵盖t所有字符的最小子串。如果s中不存在涵盖t所有字符的子串,则返回空字符串””。

测试链接:https://leetcode.cn/problems/minimum-window-substring/

题目三

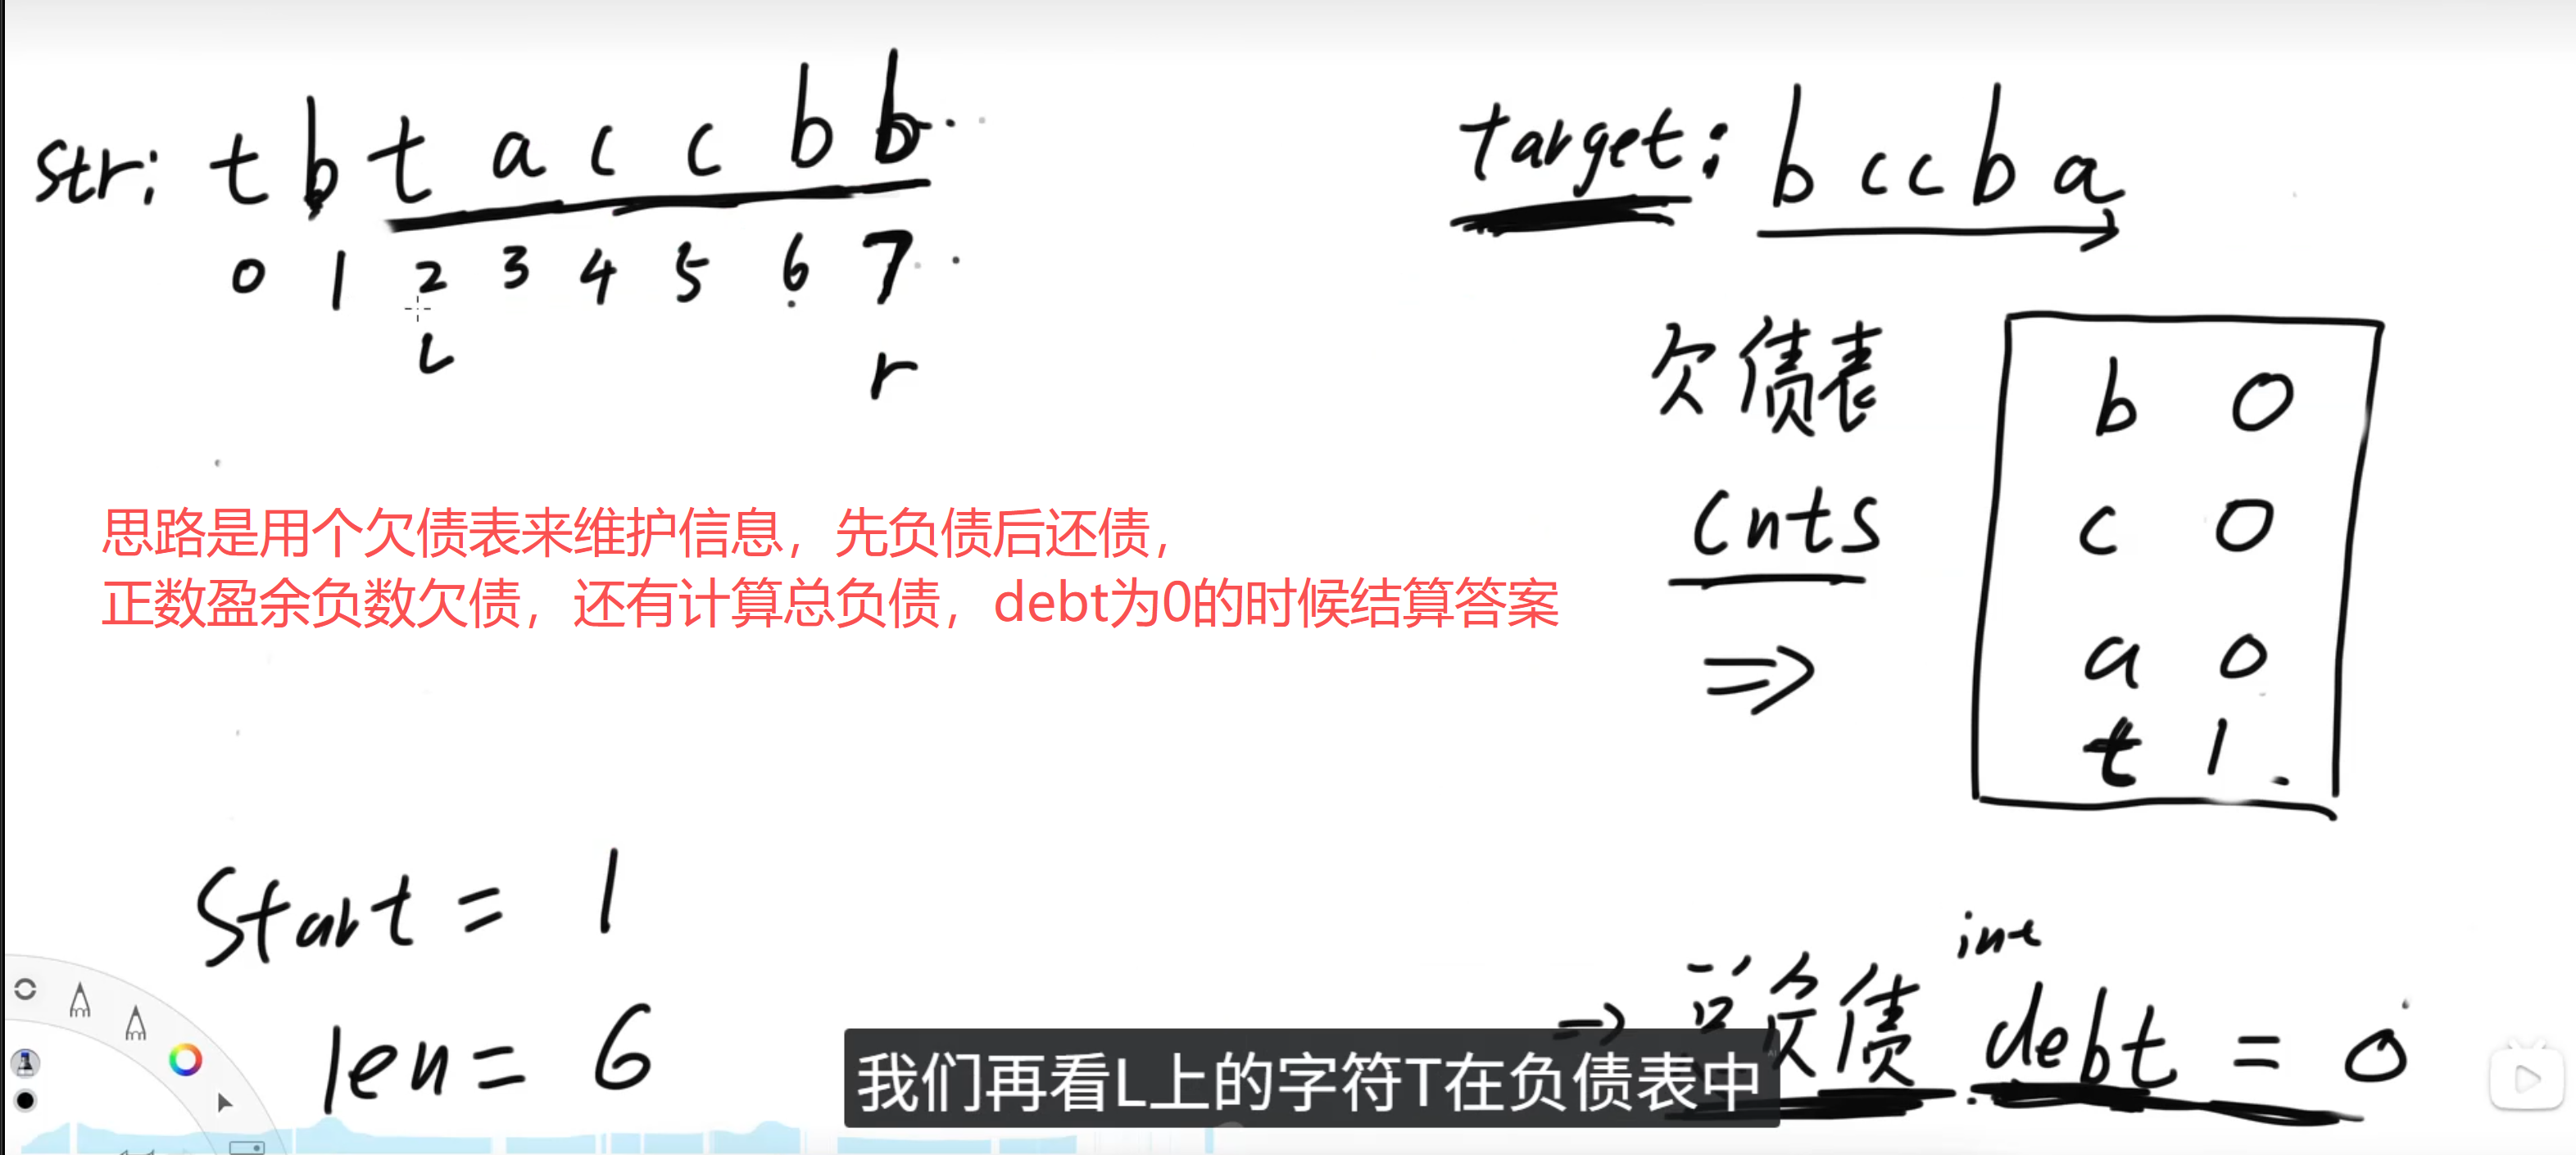
核心思想

使用”欠债表”维护字符需求,先负债后还债:

  1. 欠债表:cnts[c] < 0表示还需要字符c,> 0表示字符c多余
  2. 债务管理:debt记录总债务(还需要多少个字符)
  3. 两阶段处理:先扩展找到覆盖,再收缩找到最小
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
示例:s = "ADOBECODEBANC", t = "ABC"

初始化欠债表:
cnts['A'] = -1 (欠1个A)
cnts['B'] = -1 (欠1个B)
cnts['C'] = -1 (欠1个C)
debt = 3

扩展阶段:
r=0: 'A', cnts['A']=-1→0, debt=3→2
r=1: 'D', cnts['D']=0→1, debt=2
r=2: 'O', cnts['O']=0→1, debt=2
r=3: 'B', cnts['B']=-1→0, debt=2→1
r=4: 'E', cnts['E']=0→1, debt=1
r=5: 'C', cnts['C']=-1→0, debt=1→0 ✓ 债务还清!

收缩阶段:
去掉'A':cnts['A']=0→-1, 不行(会欠债)
窗口:"ADOBEC",长度=6

继续扩展...

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
class Solution:
def minWindow(self, s: str, t: str) -> str:
"""
滑动窗口 + 欠债表

核心思想:
1. cnts数组维护欠债情况:
- cnts[i] < 0:字符i有负债(还需要)
- cnts[i] > 0:字符i有盈余(多了)
2. debt记录总债务(还需要多少个字符)
3. 先扩展窗口还债,债务清零后再收缩窗口

时间复杂度:O(n + m),n是s长度,m是t长度
空间复杂度:O(1)(cnts数组固定256大小)
"""
# 记录每种字符的欠债情况
cnts = [0] * 256

# 统计t中每个字符的需求,初始为负数(欠债)
for char in t:
cnts[ord(char)] -= 1

length = float('inf') # 最小覆盖子串的长度
start = 0 # 最小覆盖子串的起始位置
debt = len(t) # 总债务(还需要多少个字符)
l = 0 # 左指针

# 右指针遍历字符串s
for r in range(len(s)):
char_code = ord(s[r])

# 如果当前字符是需要的(cnts < 0),则减少债务
if cnts[char_code] < 0:
debt -= 1
cnts[char_code] += 1 # 字符进入窗口

# 如果债务已还清(找到了包含t所有字符的窗口)
if debt == 0:
# 收缩左边界,去掉多余的字符
while cnts[ord(s[l])] > 0:
cnts[ord(s[l])] -= 1
l += 1

# 更新最小窗口
if r - l + 1 < length:
length = r - l + 1
start = l

# 如果没有找到满足条件的子串,返回空字符串
return "" if length == float('inf') else s[start:start + length]

欠债表机制详解

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
# 欠债表的工作原理

初始状态(t = "ABC"):
cnts['A'] = -1 # 欠1个A
cnts['B'] = -1 # 欠1个B
cnts['C'] = -1 # 欠1个C
其他字符 = 0 # 不欠不多

加入字符'A':
cnts['A'] = -1 + 1 = 0 # 刚好够,debt减1
加入字符'A':
cnts['A'] = 0 + 1 = 1 # 多了1个,debt不变

去掉字符'A':
cnts['A'] = 1 - 1 = 0 # 还是刚好,可以去掉
去掉字符'A':
cnts['A'] = 0 - 1 = -1 # 又欠了,不能再去掉

算法分析

  • 时间复杂度:O(n + m)
  • 空间复杂度:O(1)
  • 核心技巧:欠债表 + 两阶段处理

题目四:加油站

问题描述

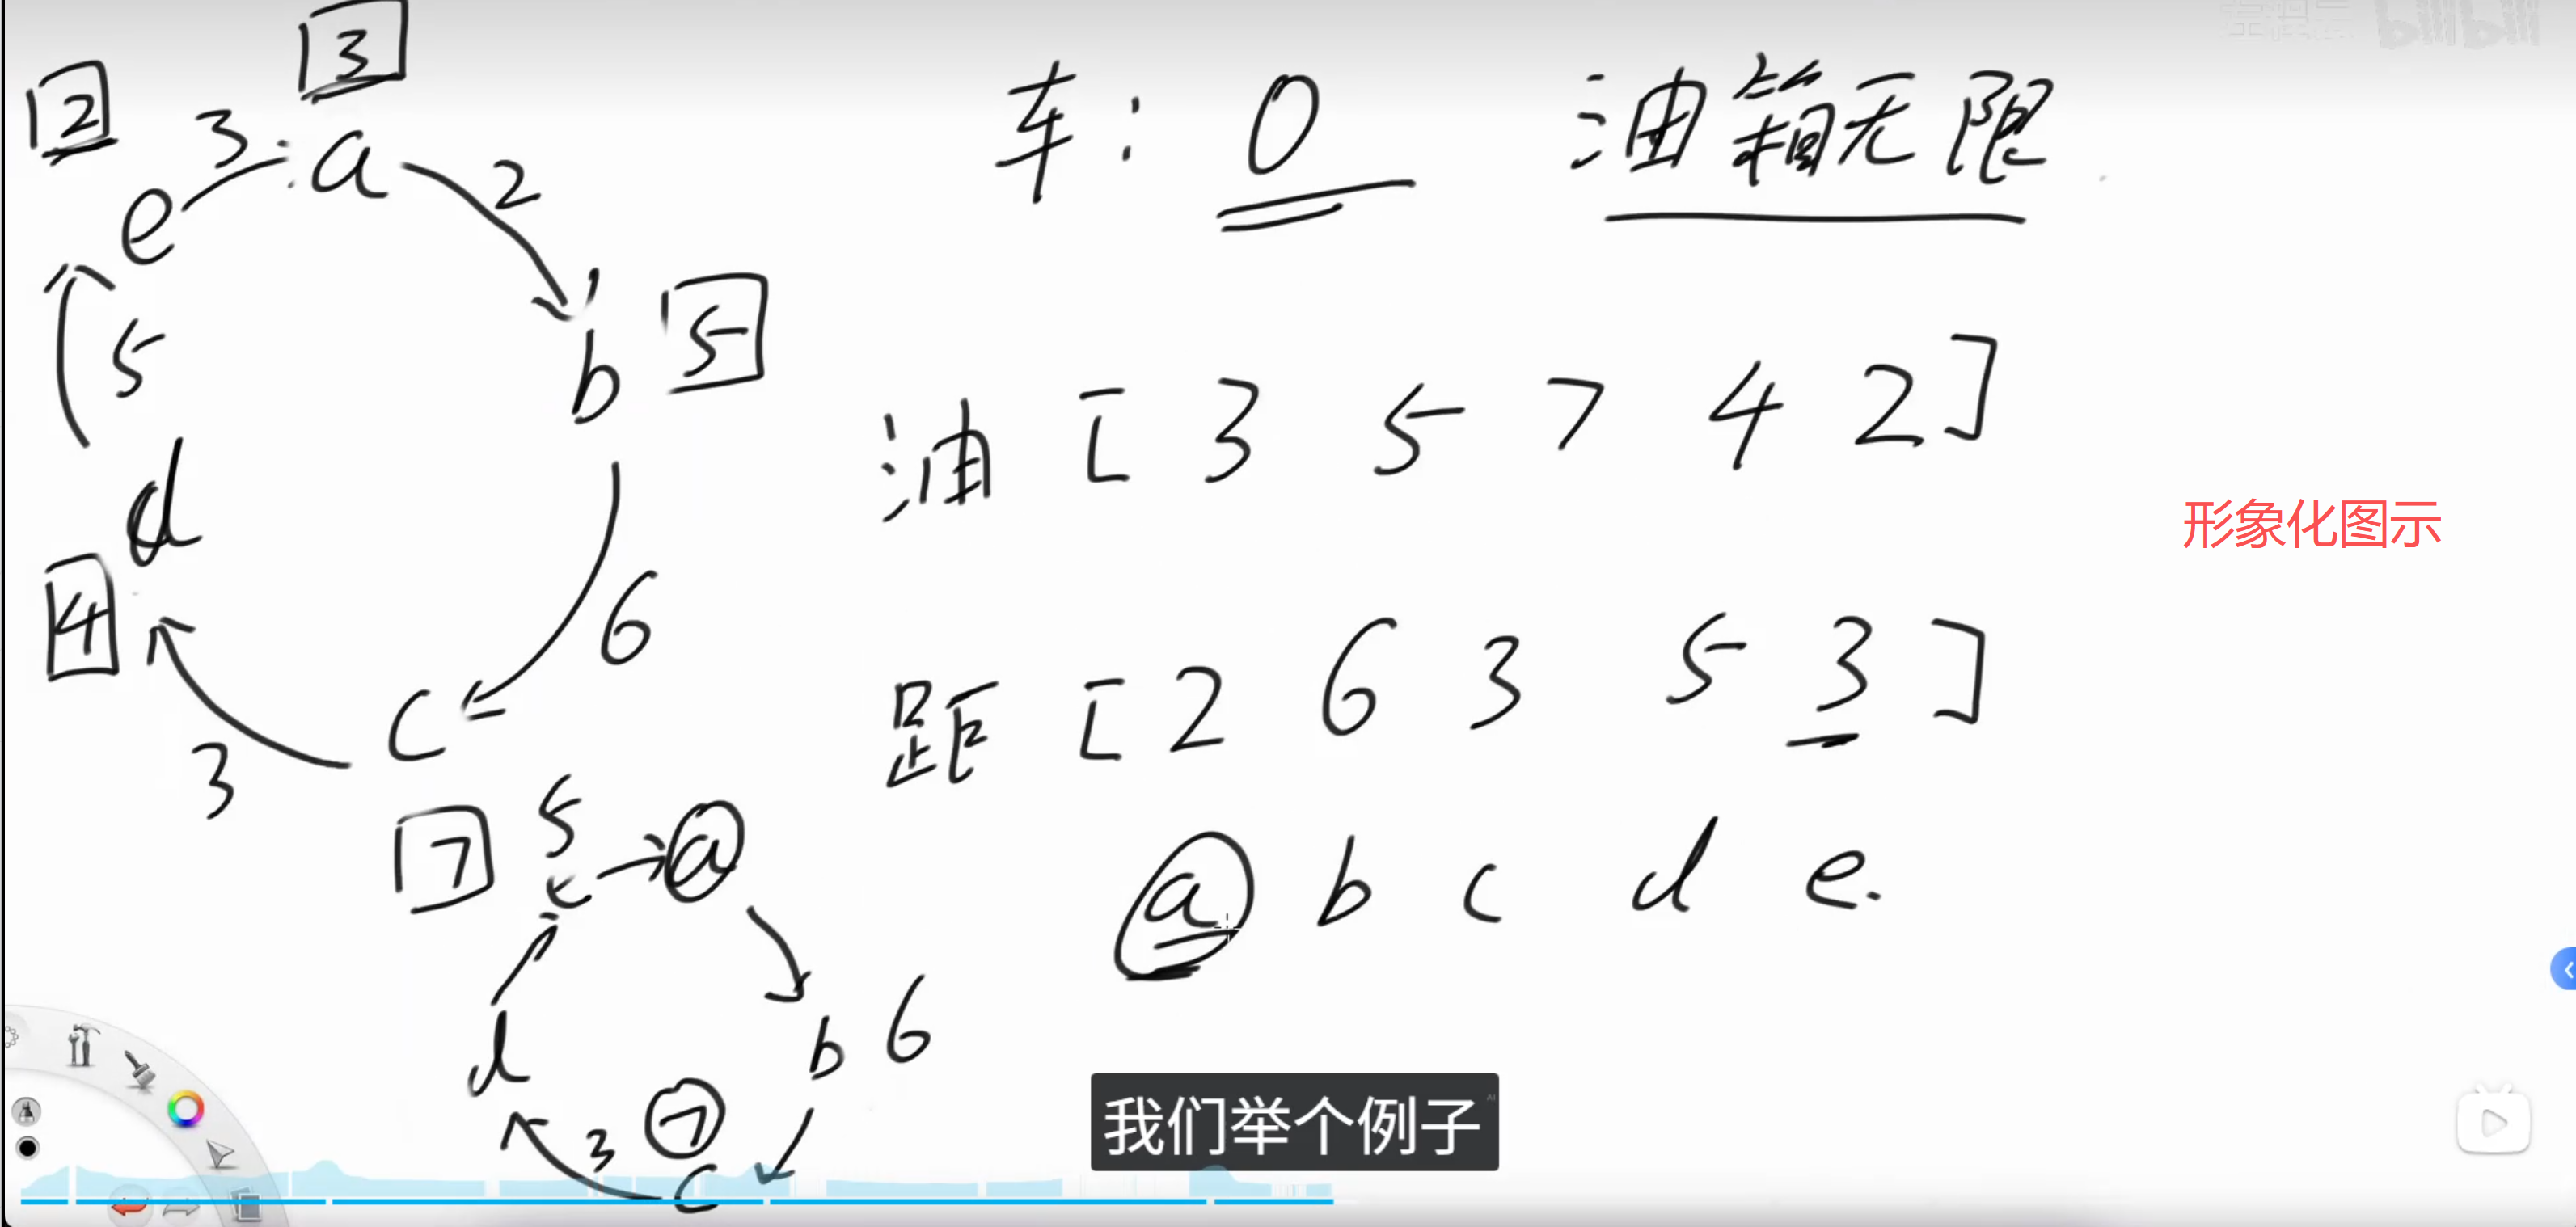
在一条环路上有n个加油站,其中第i个加油站有汽油gas[i]升。你有一辆油箱容量无限的汽车,从第i个加油站开往第i+1个加油站需要消耗汽油cost[i]升。如果你可以按顺序绕环路行驶一周,则返回出发时加油站的编号,否则返回-1。

测试链接:https://leetcode.cn/problems/gas-station/

题目四图示
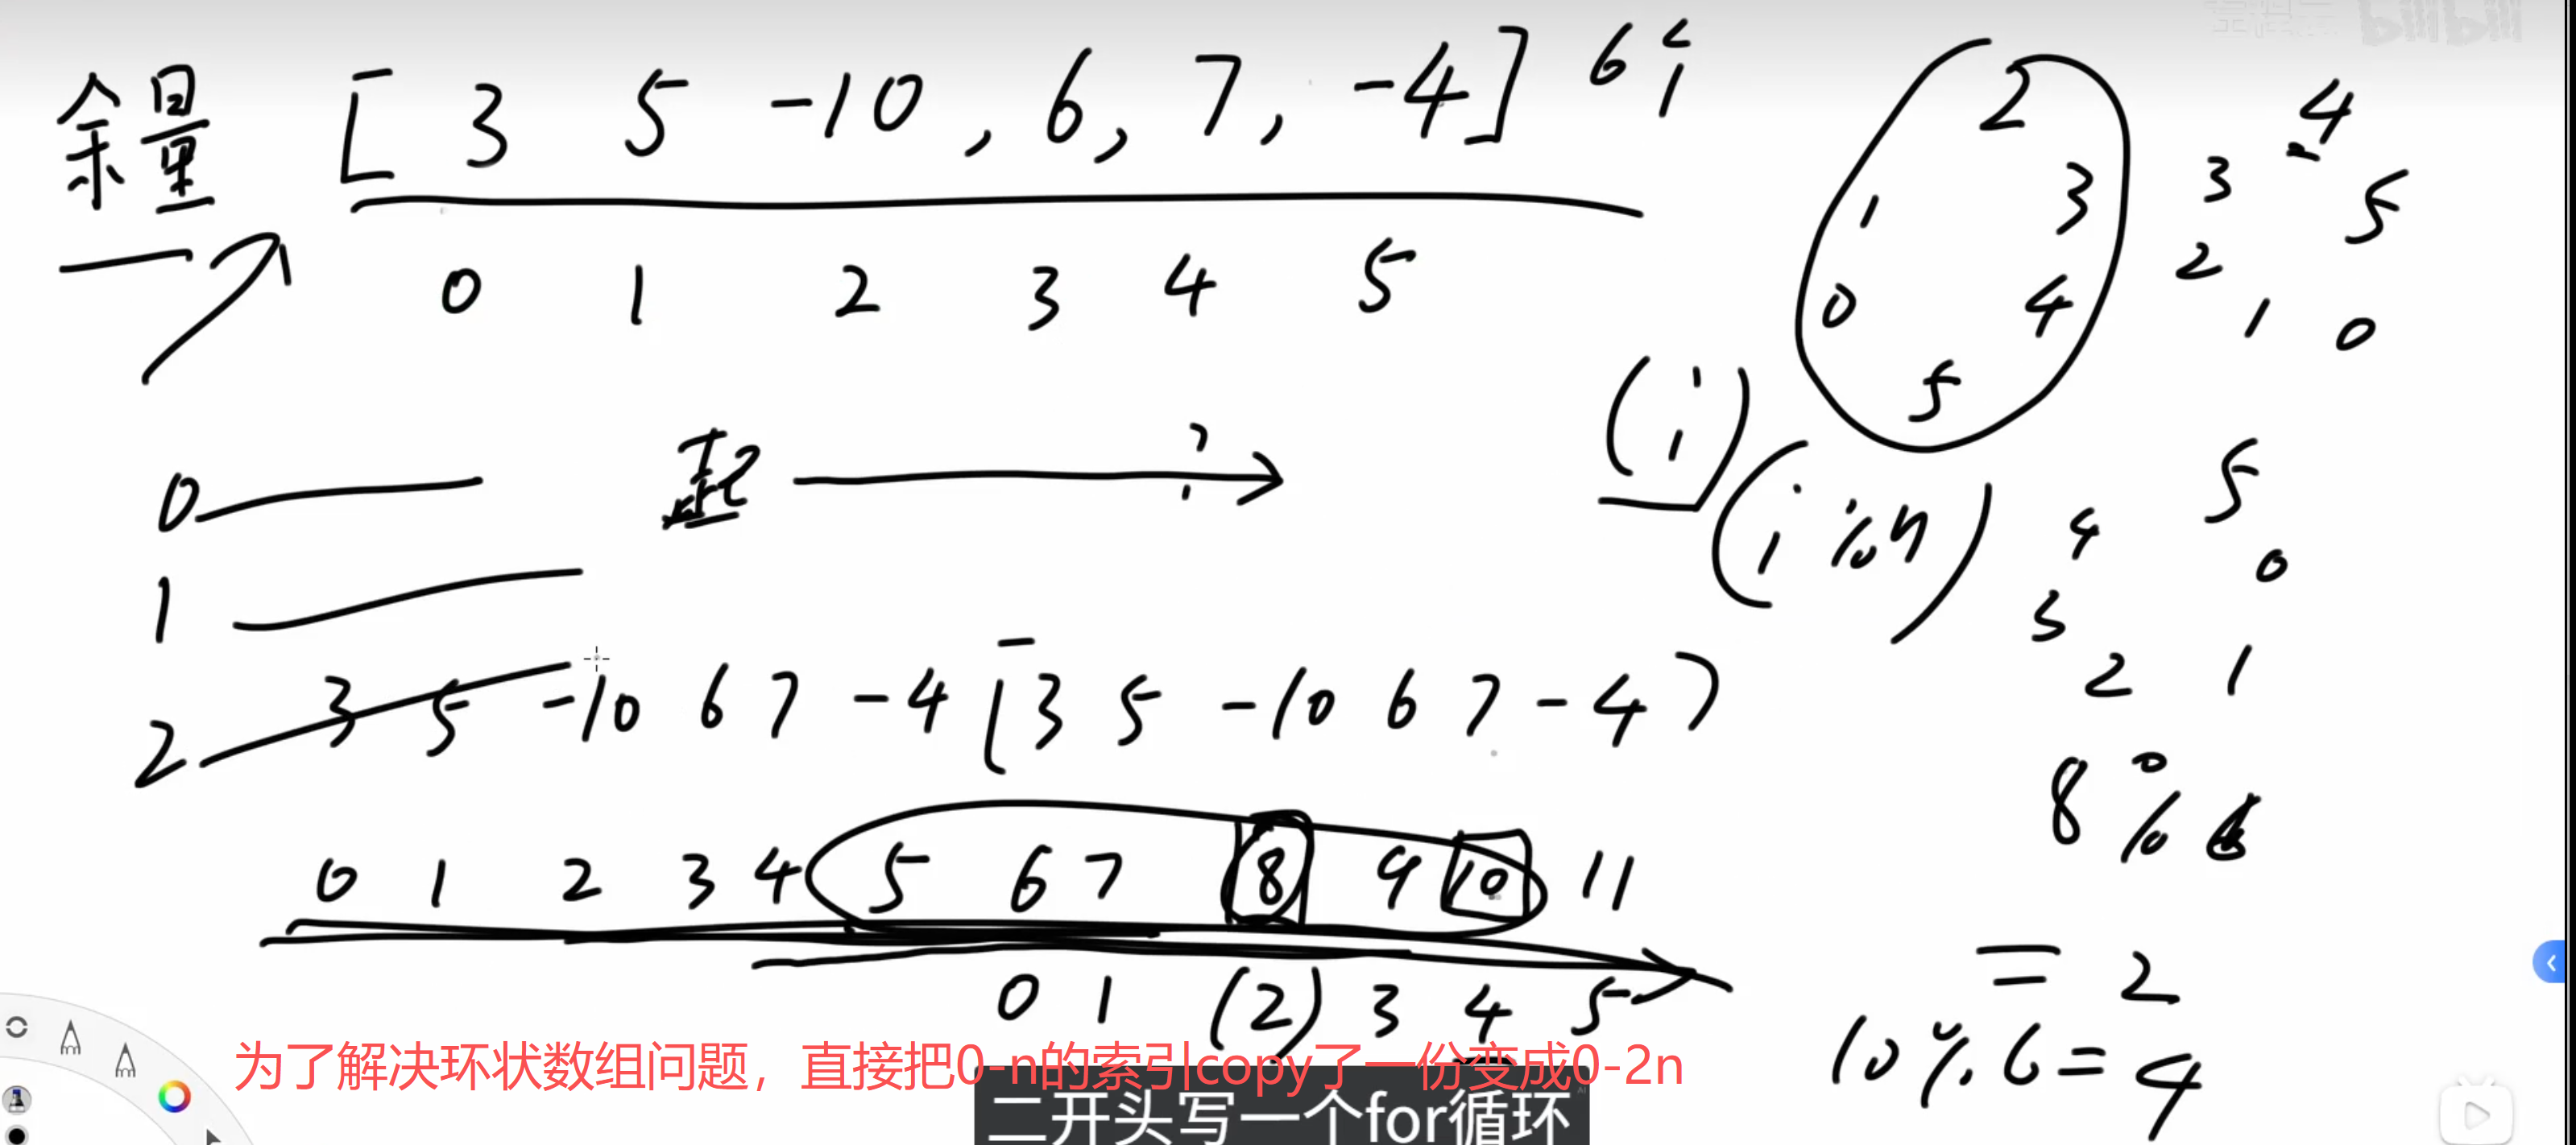
题目四环状数组
题目四剪枝操作

核心思想

通过结余数组和滑动窗口找到合适的起点:

  1. 结余计算:每个位置的结余 = gas[i] - cost[i]
  2. 环路扩展:将数组扩展为两倍处理环路
  3. 窗口验证:从每个位置出发,看能否走完一圈
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
示例:gas = [1,2,3,4,5], cost = [3,4,5,1,2]
结余数组 = [-2,-2,-2,3,3]

扩展数组:
索引:0 1 2 3 4 5 6 7 8 9
结余:-2 -2 -2 3 3 -2 -2 -2 3 3
↑原数组重复

从l=0开始:
r=0: sum=-2 < 0,失败,跳到r+1=1
从l=1开始:
r=1: sum=-2 < 0,失败,跳到r+1=2
...
从l=3开始:
r=3: sum=3 ✓
r=4: sum=6 ✓
r=5: sum=4 ✓
r=6: sum=2 ✓
r=7: sum=0 ✓
走完一圈!答案=3

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
class Solution:
def canCompleteCircuit(self, gas: list[int], cost: list[int]) -> int:
"""
滑动窗口处理环路问题

核心思想:
1. 将环路扩展为两倍:[a,b,c,d,e] → [a,b,c,d,e,a,b,c,d,e]
2. 窗口范围[l,r),左闭右开,r是到不了的位置
3. 从每个位置l出发,看能否走完n个站点
4. 如果失败,直接跳到r+1位置(剪枝)

时间复杂度:O(n)
- 外层循环l最多到n-1
- 内层循环r最多移动到2n
- 总移动次数不超过2n

空间复杂度:O(1)
"""
n = len(gas)
l = 0

while l < n:
r = l # 右指针从左指针开始
sum_val = 0 # 当前油量余额

# 尝试从l位置出发
while sum_val + gas[r % n] - cost[r % n] >= 0:
# 检查是否已经绕了一圈
if r - l + 1 == n:
return l # 找到答案

# r位置进入窗口,累加油量余额
sum_val += gas[r % n] - cost[r % n]
r += 1

# 从l出发无法完成,直接跳到r+1开始尝试(剪枝)
# 原理:如果从l到r失败,那么从l+1到r也必然失败
l = r + 1

return -1 # 没有找到可行的起点

剪枝原理说明

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
# 为什么可以直接跳到r+1?

假设从位置i到位置j失败(油量不足):
i → i+1 → i+2 → ... → j (失败)

如果从i能到j-1,说明:
sum(i到j-1) >= 0

但在j失败,说明:
sum(i到j) < 0
即 sum(i到j-1) + rest[j] < 0

现在考虑从i+1出发:
sum(i+1到j) = sum(i到j) - rest[i]

因为sum(i到j) < 0,且rest[i] <= sum(i到j-1)(否则到不了i+1)
所以 sum(i+1到j) <= sum(i到j) < 0

结论:从i+1、i+2...j出发都无法到达j,可以直接跳过

算法分析

  • 时间复杂度:O(n)
  • 空间复杂度:O(1)
  • 核心技巧:环路扩展 + 剪枝优化

题目五:替换子串得到平衡字符串

问题描述

有一个只含有’Q’,’W’,’E’,’R’四种字符,且长度为n的字符串。假如在该字符串中,这四个字符都恰好出现n/4次,那么它就是一个「平衡字符串」。请通过「替换一个子串」的方式,使原字符串变成一个「平衡字符串」,返回待替换子串的最小可能长度。

测试链接:https://leetcode.cn/problems/replace-the-substring-for-balanced-string/

核心思想

反向思考:找到包含所有多余字符的最小窗口

  1. 字符整数化:将QWER映射为0123
  2. 计算过剩:统计每种字符超过n/4的数量
  3. 窗口覆盖:找到包含所有过剩字符的最小窗口
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
示例:s = "QWER", n = 4
期望:每种字符1个

示例:s = "QQWE", n = 4
Q出现2次,多1个
W出现1次,正好
E出现1次,正好
R出现0次,少1个

初始欠债表:
cnts[Q] = 1-2 = -1 (多1个Q要放进窗口)
cnts[W] = 1-1 = 0
cnts[E] = 1-1 = 0
cnts[R] = 1-0 = 1 (缺1个R,不用管)
debt = 1

找到包含这1个多余Q的最小窗口即可

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
class Solution:
def balancedString(self, s: str) -> int:
"""
滑动窗口 + 字符整数化

核心思想:
1. 将字符映射为数字:Q→0, W→1, E→2, R→3
2. 计算每种字符的过剩数量(超过n/4的部分)
3. 找到包含所有过剩字符的最小窗口
4. 这个窗口就是需要替换的最小子串

时间复杂度:O(n)
空间复杂度:O(1)(cnts数组固定4大小)
"""
n = len(s)
# 将字符映射为数字
char_to_num = []
cnts = [0] * 4 # 统计四种字符的出现次数

for char in s:
if char == 'W':
num = 1
elif char == 'E':
num = 2
elif char == 'R':
num = 3
else: # 'Q'
num = 0
char_to_num.append(num)
cnts[num] += 1

# 计算每种字符的欠债情况
debt = 0
for i in range(4):
if cnts[i] < n // 4:
# 该字符不足,不需要减少
cnts[i] = 0
else:
# 该字符过多,需要减少到n/4
cnts[i] = n // 4 - cnts[i] # 负数表示需要减少的数量
debt -= cnts[i]

# 如果已经平衡,直接返回0
if debt == 0:
return 0

ans = float('inf')
l = 0

# 滑动窗口
for r in range(n):
# 窗口右边界向右,给出字符
if cnts[char_to_num[r]] < 0:
debt -= 1
cnts[char_to_num[r]] += 1

# 如果债务已还清
if debt == 0:
# 窗口左边界向右,拿回字符
while cnts[char_to_num[l]] > 0:
cnts[char_to_num[l]] -= 1
l += 1
# 更新答案
ans = min(ans, r - l + 1)

return ans

字符整数化技巧

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
# 为什么要字符整数化?

方法1:直接用字符作为索引(不推荐)
cnts = {}
cnts['Q'] = ... # 字典操作,较慢

方法2:字符整数化(推荐)
cnts = [0] * 4 # 数组操作,更快
Q → 0
W → 1
E → 2
R → 3

优势:
1. 数组访问比字典快
2. 空间固定,不需要哈希表
3. 代码更清晰

算法分析

  • 时间复杂度:O(n)
  • 空间复杂度:O(1)
  • 核心技巧:字符整数化 + 反向思考

题目六:K个不同整数的子数组

问题描述

给定一个正整数数组nums和一个整数k,返回nums中「好子数组」的数目。如果nums的某个子数组中不同整数的个数恰好为k,则称这个连续子数组为「好子数组」。

测试链接:https://leetcode.cn/problems/subarrays-with-k-different-integers/

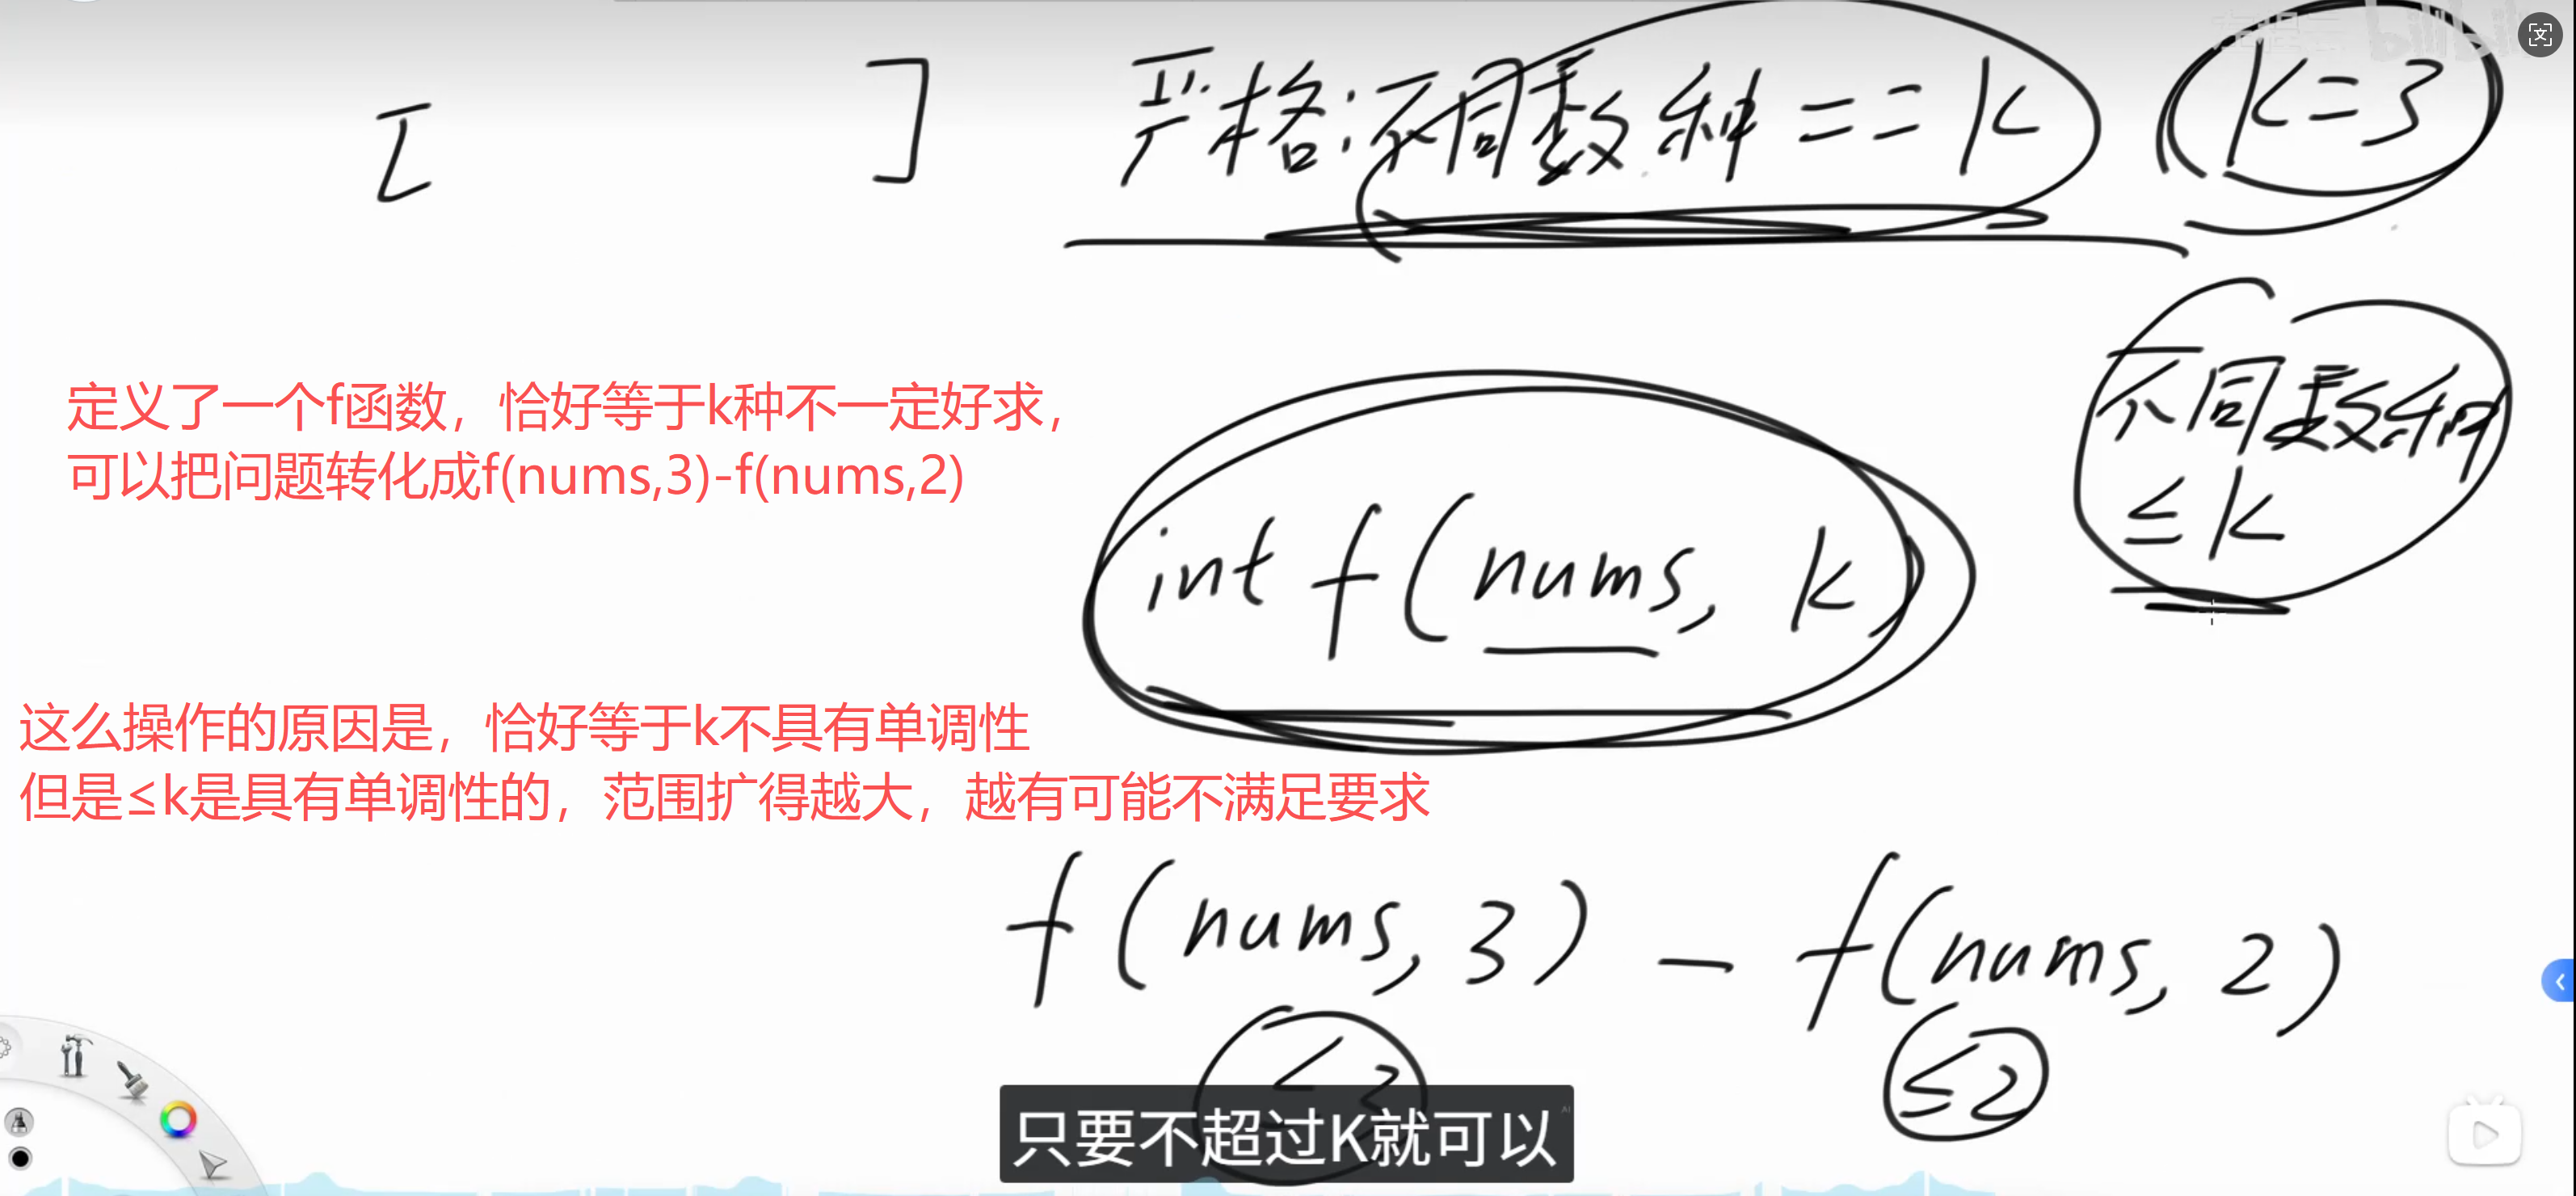
题目六问题转化

核心思想

将”恰好k种”转化为”最多k种”的差值:

核心公式:恰好k种 = 最多k种 - 最多k-1种

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
示例:nums = [1,2,1,2,3], k = 2

最多2种的子数组:
[1] 1种 ✓
[1,2] 2种 ✓
[2] 1种 ✓
[1] 1种 ✓
[1,2] 2种 ✓
[2] 1种 ✓
[2,1] 2种 ✓
[1] 1种 ✓
[2] 1种 ✓
[2,3] 2种 ✓
[3] 1种 ✓
...
总计:最多2种的数量 = X

最多1种的子数组:
[1] 1种 ✓
[2] 1种 ✓
[1] 1种 ✓
[2] 1种 ✓
[3] 1种 ✓
总计:最多1种的数量 = Y

恰好2种的数量 = X - Y

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
class Solution:
def subarraysWithKDistinct(self, nums: list[int], k: int) -> int:
"""
恰好k种 = 最多k种 - 最多k-1种

核心思想:
1. "恰好k种"不好直接计算
2. "最多k种"可以用滑动窗口
3. 利用差值关系转化问题
"""
return self.numsOfMostKinds(nums, k) - self.numsOfMostKinds(nums, k - 1)

def numsOfMostKinds(self, arr: list[int], k: int) -> int:
"""
计算数组中有多少子数组,数字种类不超过k

核心思想:
1. 固定右边界r,计算以r结尾的满足条件的子数组数量
2. 对于固定的r,所有从[l,r]区间的子数组都满足条件
3. 数量 = r - l + 1

时间复杂度:O(n)
空间复杂度:O(n)(cnts数组大小)
"""
cnts = [0] * 20001 # 统计每个数字出现的次数
ans = 0
collect = 0 # 当前窗口中不同数字的种类数
l = 0

for r in range(len(arr)):
# 右边界扩展
cnts[arr[r]] += 1
if cnts[arr[r]] == 1:
collect += 1

# 如果种类数超过k,收缩左边界
while collect > k:
cnts[arr[l]] -= 1
if cnts[arr[l]] == 0:
collect -= 1
l += 1

# 以r结尾的,种类数不超过k的子数组个数
# 例如:l=0, r=3,则子数组有[0,3],[1,3],[2,3],[3,3]
ans += r - l + 1

return ans

计数原理详解

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
# 为什么ans += r - l + 1?

固定右边界r,所有从[l,r]区间开始的子数组都满足条件

示例:l=1, r=4,数组=[a,b,c,d,e]
窗口内:[b,c,d,e],种类数≤k

以r=4结尾的满足条件的子数组:
[b,c,d,e] 从1到4
[c,d,e] 从2到4
[d,e] 从3到4
[e] 从4到4

共4个,即 r - l + 1 = 4 - 1 + 1 = 4

累加过程:
r=0: ans += 1 (1个子数组)
r=1: ans += ... (若干个子数组)
r=2: ans += ...
...
最终ans = 所有满足条件的子数组总数

转化技巧总结

1
2
3
4
5
6
7
8
9
10
11
# 恰好 vs 最多 转化技巧

问题类型 转化方式
========================================================
恰好k个 = 最多k个 - 最多k-1个
至少k个 = 全部 - 最多k-1个
恰好在[a,b]区间内 = 最多b - 最多a-1
========================================================

这种转化技巧可以将复杂的"恰好"问题转化为
更容易处理的"最多"问题

算法分析

  • 时间复杂度:O(n)
  • 空间复杂度:O(n)
  • 核心技巧:”恰好”转化为”最多”的差值

题目七:至少有K个重复字符的最长子串

问题描述

给你一个字符串s和一个整数k,请你找出s中的最长子串,要求该子串中的每一字符出现次数都不少于k。返回这一子串的长度。

测试链接:https://leetcode.cn/problems/longest-substring-with-at-least-k-repeating-characters/

核心思想

固定字符种类 + 滑动窗口

为什么要固定字符种类?因为直接求解没有单调性:

  • 窗口变大:字符种类可能增加,但某些字符可能不达标
  • 窗口变小:字符种类可能减少,但剩余字符可能达标

解决方案:枚举字符种类数(1到26),对每种情况求最长子串

1
2
3
4
5
6
7
8
9
10
11
12
示例:s = "aaabb", k = 3

要求:每种字符必须出现≥3次

情况1:恰好1种字符
窗口[aaa]:'a'出现3次 ✓,长度=3

情况2:恰好2种字符
窗口[aaabb]:'a'出现3次 ✓,'b'出现2次 ✗
无满足条件的窗口

答案 = 3

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
class Solution:
def longestSubstring(self, s: str, k: int) -> int:
"""
固定字符种类 + 滑动窗口

核心思想:
1. 直接求解没有单调性,需要固定字符种类
2. 枚举字符种类数require(1到26)
3. 对每种情况,用滑动窗口求最长子串
4. 维护两个指标:
- collect: 窗口中字符种类数
- satisfy: 达标的字符种类数(次数≥k)

时间复杂度:O(26n) = O(n)
空间复杂度:O(1)(cnts数组固定256大小)
"""
n = len(s)
ans = 0

# 枚举字符种类数:1到26种
for require in range(1, 27):
cnts = [0] * 256 # 统计每个字符出现的次数
collect = 0 # 窗口中字符种类数
satisfy = 0 # 达标的字符种类数(次数≥k)
l = 0

# 滑动窗口
for r in range(n):
char_code = ord(s[r])
cnts[char_code] += 1

# 新增一种字符
if cnts[char_code] == 1:
collect += 1
# 该字符达标
if cnts[char_code] == k:
satisfy += 1

# 种类数超过require,收缩左边界
while collect > require:
left_char_code = ord(s[l])
if cnts[left_char_code] == 1:
collect -= 1
if cnts[left_char_code] == k:
satisfy -= 1
cnts[left_char_code] -= 1
l += 1

# 所有字符都达标,更新答案
if satisfy == require:
ans = max(ans, r - l + 1)

return ans

为什么要固定字符种类?

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
# 反例:不固定字符种类的问题

s = "aaabbc", k = 3

窗口扩展过程:
[a] 'a':1 ✗
[aa] 'a':2 ✗
[aaa] 'a':3 ✓ 达标!
[aaab] 'a':3 ✓, 'b':1 ✗ 不达标
[aaabb] 'a':3 ✓, 'b':2 ✗ 不达标
[aaabbc] 'a':3 ✓, 'b':2 ✗, 'c':1 ✗ 更不达标

问题:窗口变大后,新字符可能不达标
没有明确的单调性

解决:固定字符种类后
require=1: [aaa] ✓
require=2: 无满足条件的窗口
require=3: 无满足条件的窗口

双指标维护

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
# collect 和 satisfy 的关系

collect: 窗口中有多少种字符
satisfy: 其中有多少种达标(出现次数≥k)

示例:s = "aabbc", k = 2, require = 2

r=0: 'a' cnts['a']=1, collect=1, satisfy=0
r=1: 'a' cnts['a']=2, collect=1, satisfy=1 (a达标)
r=2: 'b' cnts['b']=1, collect=2, satisfy=1
r=3: 'b' cnts['b']=2, collect=2, satisfy=2 (a,b都达标)
✓ satisfy == require,更新答案

关键判断:
if satisfy == require: # 所有种类都达标
ans = max(ans, r - l + 1)

算法分析

  • 时间复杂度:O(26n) = O(n)
  • 空间复杂度:O(1)
  • 核心技巧:固定变量制造单调性

滑动窗口技巧总结

1. 核心模板

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
# 标准滑动窗口框架

def sliding_window(arr, constraint):
"""
arr: 输入数组/字符串
constraint: 约束条件
"""
n = len(arr)
l = 0 # 左指针
ans = 初始值 # 根据题目初始化

# 维护信息的数据结构(根据题目选择)
info = {} # 或 [], 或 变量

for r in range(n): # 右指针遍历
# 1. 扩展右边界,更新信息
update_info_add(arr[r])

# 2. 收缩左边界,维持约束
while not satisfy_constraint():
update_info_remove(arr[l])
l += 1

# 3. 更新答案
update_answer(l, r)

return ans

2. 常见维护信息的方式

信息类型 数据结构 示例
计数 数组/字典 字符出现次数
位置 数组 最后出现位置
总和 变量 窗口累加和
种类 变量 不同字符数
达标数 变量 满足条件的数量

3. 滑动窗口 vs 其他技巧

1
2
3
4
5
6
7
8
9
10
11
12
13
# 何时使用滑动窗口?

适用情况:
✓ 连续子数组/子串问题
✓ 存在单调性关系
✓ 需要维护区间信息
✓ 左右边界都单向移动

不适用情况:
✗ 非连续子序列
✗ 需要回溯的问题
✗ 边界需要回退
✗ 需要排序的问题

4. 时间复杂度分析

1
2
3
4
5
6
7
8
9
10
11
12
13
14
# 为什么是O(n)?

虽然代码是双层循环:
for r in range(n): # O(n)
while ...: # 看起来O(n)
l += 1

但实际上:
- 右指针r:从0移动到n-1,移动n次
- 左指针l:从0移动到n-1,最多移动n次
- 总移动次数:2n次
- 时间复杂度:O(n)

关键:每个元素最多被访问常数次(进入窗口1次,离开窗口1次)

5. 常见技巧汇总

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
# 技巧1:位置数组避免重复扫描
last = [-1] * 256
l = max(l, last[char] + 1) # 左边界不回退

# 技巧2:欠债表维护需求
cnts[char] = -need # 负数表示欠债
debt = total_need # 总债务

# 技巧3:字符整数化
char_to_num = {'Q': 0, 'W': 1, 'E': 2, 'R': 3}

# 技巧4:恰好转化为最多
exactly_k = at_most_k - at_most_(k-1)

# 技巧5:固定变量制造单调性
for require in range(1, 27): # 固定字符种类
# 滑动窗口求解

6. 调试技巧

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
# 调试检查点

1. 左右边界是否正确移动?
- 打印l和r的值
- 检查边界条件

2. 维护信息是否正确?
- 打印info的内容
- 验证更新逻辑

3. 答案更新时机是否正确?
- 检查更新条件
- 验证窗口状态

4. 边界情况是否处理?
- 空数组
- 单元素
- 全相同元素

学习建议

1. 理解单调性

滑动窗口的核心是单调性关系:

  • 明确范围和答案的关系
  • 识别哪些变量具有单调性
  • 理解如何固定变量制造单调性

2. 掌握维护技巧

熟练使用各种数据结构维护窗口信息:

  • 数组计数(字符频次)
  • 位置记录(避免重复扫描)
  • 多变量跟踪(种类数、达标数等)

3. 练习转化思维

学会将复杂问题转化为简单问题:

  • “恰好”转化为”最多”的差值
  • 固定变量降低问题维度
  • 反向思考问题本质

4. 注意边界处理

重点关注边界条件:

  • 左右边界的移动时机
  • 答案更新的条件判断
  • 特殊情况的处理

5. 复杂度分析

理解滑动窗口为什么是O(n):

  • 每个元素最多访问两次
  • 左右指针都单向移动
  • 总移动次数是线性的

通过掌握滑动窗口技巧,可以高效解决各类子数组和子串问题。关键在于识别单调性关系,选择合适的维护方式,以及灵活运用转化技巧。

引言

本笔记总结了Linux操作系统的基础知识和实用技巧,涵盖远程连接工具、常用命令、系统设置、定时任务、用户管理、文件权限等内容。

前置知识

在学习本笔记内容之前,建议具备以下基础:

  • 基本的计算机操作知识
  • 了解操作系统的基本概念
  • 熟悉命令行界面的使用方式
  • 建议购买云服务器进行实践操作

Linux使用总结

1. Linux介绍

历史背景

Linux,全称GNU/Linux,是一套免费使用和自由传播的类UNIX操作系统。其内核由林纳斯·本纳第克特·托瓦兹(Linus Torvalds)于1991年第一次释出。它主要受到Minix和Unix思想的启发,是一个基于POSIX和Unix的多用户、多任务、支持多线程和多CPU的操作系统。

核心特点:

  • Linux内核kernel最初由芬兰人李纳斯·托瓦兹在赫尔辛基大学上学时出于个人爱好编写
  • 1991年10月5日第一次正式向外公布
  • Linux借鉴了Unix的思想,但没有一行Unix的代码
  • Linux英文解释:Linux is not Unix,业界称为”类Unix”系统

Linux构成

Linux系统由以下部分组成:

  • Linux Kernel(内核):系统的核心部分
  • 软件包:各种应用程序和工具

主流发行版本

目前市面上比较知名的Linux发行版有:

  • RedHat:企业级商业发行版
  • CentOS:社区企业操作系统(常用于Web服务器)
  • Ubuntu:用户友好的桌面和服务器版本
  • Fedora:RedHat的社区版本
  • Debian:稳定性强的发行版
  • Aliyun Linux:阿里云定制版本
  • SUSE Linux:企业级发行版
  • Open SUSE:SUSE的社区版本
  • CoreOS:容器化操作系统
  • FreeBSD:类Unix系统

应用场景选择:

  • Web应用(Java、PHP等)→ 选择CentOS
  • 微软技术栈(ASP、.NET、SQL Server)→ 选择Windows Server

2. Linux常用远程连接工具

建议:购买云服务器(阿里云、华为云等)进行实践,多练习才能熟练掌握Linux。

推荐工具组合

最佳组合:Xshell + WinSCP

主流远程连接工具

1. SecureCRT

  • 功能:可直接连接并上传文件
  • 下载地址:https://www.vandyke.com
  • 特点:集成度高,功能全面

2. XShell

3. Putty

4. XFTP

5. WinSCP


3. Linux常用命令总结

3.1 Linux特色目录符号

1
2
3
4
.      # 当前目录
.. # 上一级目录
- # 上一个工作目录(配合cd使用)
~ # 用户根目录(/root)

使用示例:

1
2
3
cd -   # 返回上一个工作目录
cd ~ # 返回用户根目录
cd .. # 返回上一级目录

3.2 磁盘管理

目录切换与查看

1
2
3
4
5
6
7
8
9
10
11
12
# 进入目录
cd 目录名 # 进入某个目录
cd /info/a # 进入多级目录
cd .. # 返回上一级目录
cd / # 返回根目录
cd - # 返回上一个工作目录

# 显示当前目录
pwd # 显示当前完整路径

# 查看分区
fdisk -l # 查看新的分区

列出文件和目录

1
2
3
4
5
6
7
8
9
10
11
# 基本列出命令
ll # 纵向列出(含详细信息)
ll -a # 额外展示隐藏文件
ll -h # 人性化显示大小(KB、MB、GB)
ls # 横向列出
ls -a # 额外展示隐藏文件
dir # 列出当前目录内容

# ll vs ls 区别
# ll:纵向展示,显示权限、所有者、组、大小等详细信息
# ls:横向简洁展示

磁盘空间查看

1
2
3
4
# df 命令 - 查看文件系统级别的磁盘使用
df # 查看磁盘空间使用情况
df -h # 人性化显示(GB、MB格式)
df -T # 显示文件系统类型

df 输出字段说明:

  • Filesystem:文件系统
  • Size:总容量
  • Used:已使用
  • Avail:可用空间
  • Use%:使用百分比
  • Mounted on:挂载点
1
2
3
# du 命令 - 查看文件/目录级别的磁盘使用
du # 查看文件和目录大小
du -h # 人性化显示大小

使用场景:

  • df:查看磁盘分区整体使用情况
  • du:查看具体文件和文件夹占用空间

3.3 文件管理

创建目录

1
2
3
4
5
6
7
8
9
# 基本创建
mkdir 目录名 # 创建单个目录
mkdir -p file1/file2 # 递归创建多级目录
mkdir -v file4 # 显示创建信息
mkdir -vp {hello/,maven/} # 一次创建多个目录结构

# 参数说明
# -p, --parents : 自动创建父目录
# -v, --verbose : 显示详细信息

文件操作

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
# 创建文件
touch 文件名 # 创建空文件或更新修改时间

# 删除操作
rm -f 文件 # 强制删除文件
rm -rf 目录 # 递归删除目录及内容

# 移动/重命名
mv 源文件 目标文件 # 移动或重命名

# mv 常用参数
# -b : 覆盖前先备份
# -f : 强制覆盖
# -i : 覆盖前询问
# -u : 仅当源文件较新时才更新
# -t : 指定目标目录
# -v : 显示过程

查看文件内容

1
2
3
4
5
cat 文件名                          # 一次性输出全部内容
more 文件名 # 逐屏输出(空格翻页)
less 文件名 # 逐屏输出(PgUp/PgDn翻页,q退出)
head 文件名 # 显示前10行
tail 文件名 # 显示后10行

复制与查找

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
# 复制
cp 源文件 目标文件 # 复制文件
cp -rf 源目录 目标目录 # 递归复制目录

# 查找文件
find ./ -name 文件名 # 按名称查找
find ./ -mtime +5 # 查找5天前修改的文件

# 查找命令
which 命令 # 查找命令位置(PATH中)
whereis 程序名 # 查找程序相关文件
# whereis 参数:
# -b : 只搜索二进制文件
# -m : 只搜索man说明文件
# -s : 只搜索源代码文件

3.4 系统设置

进程管理

1
2
3
4
5
6
7
# 查看进程
ps -aux # 查看所有进程(BSD风格)
ps -ef # 查看所有进程(标准风格)

# 终止进程
kill PID # 正常终止进程
kill -9 PID # 强制终止进程

系统信息

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
# 日期时间
date # 显示/设置系统日期时间

# 语言环境
echo $LANG # 显示当前语言环境
locale # 查看语言包

# 系统信息
uname # 查看系统信息
cat /etc/centos-release # 查看CentOS版本

# 用户信息
who # 显示已登录用户
whoami # 显示当前用户
su 用户名 # 切换用户

系统操作

1
2
3
shutdown -h now                    # 立即关机
reboot # 重启系统
clear # 清屏(内容上移)

实用技巧:

  • 按 Tab 键自动补全命令或文件名

系统负载监控

1
2
# top 命令 - 实时监控系统
top # 动态显示系统资源使用情况

top 可查看信息:

  • CPU使用率
  • 内存使用情况
  • 系统运行时间
  • 进程线程信息
  • 交换分区使用情况
1
2
# uptime 命令 - 系统负载概览
uptime # 显示系统运行时长和负载

系统负载解读:

  • 系统平均负载:特定时间间隔内运行队列中的平均进程数
  • 每个CPU核心活动进程数 ≤ 3:系统运行良好
  • 四核CPU:负载 < 12 为正常
  • 负载达到20:系统负载严重

进程进入运行队列的条件:

  • 没有在等待I/O操作
  • 没有主动进入等待状态
  • 没有被停止

内存管理

1
2
3
free                              # 显示内存使用(KB)
free -m # 显示内存使用(MB)
free -h # 显示内存使用(GB,人性化)

3.5 Linux定时任务

详细教程:可参考博文《Linux crontab 命令详细使用》

Crontab 基本命令

1
2
3
crontab -e                        # 创建或编辑定时任务
crontab -l # 查看当前定时任务
crontab -r # 删除所有定时任务(慎用)

Crontab 语法格式

1
2
3
4
5
6
7
* * * * * command
│ │ │ │ │
│ │ │ │ └─── 星期 (0-7, 0和7都表示周日)
│ │ │ └───── 月份 (1-12)
│ │ └─────── 日期 (1-31)
│ └───────── 小时 (0-23)
└─────────── 分钟 (0-59)

使用示例

1
2
3
4
5
6
7
8
# 每分钟执行一次
*/1 * * * * echo "hello world" >> /opt/crontab.log

# 每天凌晨2点执行
0 2 * * * /path/to/script.sh

# 每周一上午9点执行
0 9 * * 1 /path/to/script.sh

查看执行日志

1
tail -f /var/log/cron             # 实时查看定时任务执行情况

重定向符号说明

1
2
3
4
>  a.log                          # 重定向覆盖输出
>> a.log # 重定向追加输出
| # 管道符,左边输出作为右边输入
> a.log # 清空日志文件

常用组合:

1
ps -ef | grep tomcat              # 查找tomcat进程

扩展阅读:重定向详解参考博文 https://blog.csdn.net/smilehappiness/article/details/105181739


3.6 用户管理

详细教程:https://www.runoob.com/linux/linux-user-manage.html

用户操作

1
2
3
4
5
6
7
8
9
10
11
12
13
14
# 添加用户
useradd 用户名 # 创建新用户

# 删除用户
userdel -r zhangsan # 删除用户及主目录
# -r 参数:同时删除用户主目录

# 修改密码
passwd # 修改当前用户密码
passwd zhangsan # 修改指定用户密码(需root权限)

# 查看用户信息
id 用户名 # 查看用户ID信息
# 输出示例: uid=1001(用户名) gid=1002(组名) groups=1002(组名)

用户组操作

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
# 查看用户和组
cat /etc/passwd # 查看所有用户
cat /etc/group # 查看所有用户组

# 创建和删除组
groupadd 组名 # 创建用户组
groupdel 组名 # 删除用户组

# 查看用户所属组
groups # 查看当前用户所在组
groups 用户名 # 查看指定用户所在组

# 用户加入组
usermod -g 组名 用户名 # 修改用户主组
gpasswd -a 用户名 组名 # 将用户添加到附加组

# 从组中移除用户
gpasswd -d 用户名 组名 # 将用户从组中删除
# 注意:组名不能是用户的主组

3.7 文件权限

文件类型识别

使用 ll 命令查看文件权限信息:

1
ll                               # 显示详细文件信息

Linux 7种文件类型:

1
2
3
4
5
6
7
-rw-rw-rw   -  普通文件
drw-rw-rw d 目录(Directory)
srw-rw-rw s 套接字文件(Socket)
brw-rw-rw b 块设备(Block device)
crw-rw-rw c 字符设备(Character device)
lrw-rw-rw l 符号链接(Link)
prw-rw-rw p 管道文件(Pipe)

权限详解

权限表示:

  • r(read):读权限,值=4
  • w(write):写权限,值=2
  • x(execute):执行权限,值=1
  • rwx:所有权限,值=7(4+2+1)

常见权限值:

  • 644:rw-r–r–(文件常用)
  • 755:rwxr-xr-x(目录常用)
  • 777:rwxrwxrwx(完全开放,不推荐)

权限结构解析

以 drwxr-xr-x 为例:

1
2
3
4
5
6
d rwx r-x r-x
│ │ │ │
│ │ │ └─ 其他用户权限(Others)
│ │ └───── 用户组权限(Group)
│ └───────── 文件所有者权限(Owner)
└──────────── 文件类型

位置说明:

  • 第1位:文件类型
  • 第2-4位:属主权限(创建者)
  • 第5-7位:属组权限(所属组)
  • 第8-10位:其他用户权限

文件中rwx的含义

1
2
3
r : 可查看文件内容(如 cat 命令)
w : 可编辑或删除文件
x : 可作为命令执行

目录中rwx的含义

1
2
3
r : 可列出目录内容(ls 命令)
w : 可在目录中创建文件
x : 可切换进入目录(cd 命令)+ 查看详细信息(ls -l)

权限修改命令

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
# 修改权限
chmod 640 aa.txt # 设置文件权限为640
chmod -R 755 /usr/local # 递归设置目录权限
# -R : 递归应用到子文件和子目录

# 修改所有者
chown centos aa.txt # 修改文件所有者
chown -R centos /usr/local # 递归修改所有者

# 修改所属组
chgrp centos aa.txt # 修改文件所属组
chgrp -R centos /usr/local # 递归修改所属组

# 同时修改所有者和所属组
chown centos:centos aa.txt # 一次性修改
chown -R centos:centos /usr/local # 递归修改

# 查看当前用户所在组
groups

3.8 文档处理

文本搜索与处理

1
2
3
4
5
6
7
8
9
10
11
12
13
# 文本搜索
grep 'keyword' 文件名 # 搜索包含关键词的行
ps -ef | grep tomcat # 查找进程

# 排序和去重
sort 文件名 # 排序输出
cat aa.log | sort # 排序日志内容
uniq # 去除相邻重复行
cat aa.txt | sort | uniq # 排序后去重

# 统计
wc 文件名 # 统计行数、单词数、字符数
cat aa.txt | wc # 输出格式:行数 单词数 字符数

日志查看与分析

1
2
3
4
5
6
7
8
9
10
11
12
13
14
# 关键词上下文查看
grep -A 100 'Exception' catalina.out # 关键词后100行(After)
grep -B 100 'Exception' catalina.out # 关键词前100行(Before)
grep -C 100 'Exception' catalina.out # 关键词上下100行(Center)

# 管道方式
cat catalina.out | grep -C 100 'Exception'
cat catalina.out | grep -A 100 'Exception'
cat catalina.out | grep -B 100 'Exception'

# 实时查看日志
tail -f catalina.out # 实时查看日志
tail -100f catalina.out # 实时查看最后100行
tail -f -n 100 catalina.out # 同上

3.9 网络通讯

网络工具

1
2
3
4
5
6
7
8
9
10
# 网页抓取
curl https://example.com # 抓取网页内容

# 文件下载
wget https://example.com/file # 下载文件

# 命令确认
yes # 自动输入y确认
y # 输入y确认
no 或 n # 输入no或n拒绝

网络配置与测试

1
2
3
4
5
6
7
# IP查看
ifconfig # 查看本机IP配置
curl ipinfo.io/ip # 查看外网IP
curl ifconfig.me # 查看外网IP(备选)

# 连通性测试
ping 域名或IP # 测试网络连通性

端口与进程查看

1
2
3
4
5
6
7
8
9
10
11
# 端口占用查看
lsof -i 端口号 # 查看端口占用情况
lsof -i 8000 # 查看8000端口使用情况

# 安装lsof(如未安装)
yum -y install lsof

# 网络连接查看
netstat # 查看所有网络端口
netstat -nlp # 查看监听端口
netstat -tunlp | grep 8000 # 查看指定端口

netstat 参数说明:

1
2
3
4
5
-t (tcp)    : 仅显示tcp相关选项
-u (udp) : 仅显示udp相关选项
-n : 拒绝显示别名,全部转化为数字
-l : 仅列出在监听(Listen)的服务
-p : 显示建立连接的程序名

3.10 备份压缩

tar 压缩与解压

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
# 解压命令
tar -zxvf xxx.tar.gz # 解压.tar.gz文件
tar -zxvf xxx.tar.gz -C /usr/local # 解压到指定目录
tar -xvf xxx.tar # 解压.tar文件

# 压缩命令
tar -zcvf xxx.tar.gz ./file/* # 压缩为.tar.gz
tar -cvf xxx.tar ./file/* # 压缩为.tar

# 不同格式压缩(压缩率递增,速度递减)
tar -zcvf file.tar.gz 目录 # .tar.gz格式
tar -jcvf file.tar.bz2 目录 # .tar.bz2格式
tar -Jcvf file.tar.xz 目录 # .tar.xz格式

# 通用解压
tar -xvf 压缩文件 # 自动识别格式解压

压缩格式对比:

  • tar.gz:常用,压缩适中
  • tar.bz2:压缩率高,速度较慢
  • tar.xz:压缩率最高,速度最慢

zip 压缩与解压

1
2
3
4
5
# 压缩
zip a.zip a.txt # 压缩为zip格式

# 解压
unzip a.zip # 解压zip文件

3.11 Linux上rz和sz的使用

对于小文件传输,可以使用rz/sz命令,无需XFTP或WinSCP。

安装

1
yum -y install lrzsz

使用

1
2
rz                              # 上传文件到服务器
sz 文件名 # 下载文件到本地

使用场景:

  • 小文件快速传输
  • 临时文件上传下载
  • 配合Xshell等终端使用

Shell重定向详解

标准文件描述符

1
2
3
0 : 标准输入(stdin)  - 键盘
1 : 标准输出(stdout) - 屏幕
2 : 错误输出(stderr) - 屏幕

/dev/null 黑洞设备

1
2
/dev/null                       # Linux空设备文件
# 所有写入内容都会被丢弃

常用重定向组合

1
2
3
4
5
6
7
8
9
10
11
12
13
command > file                  # 标准输出重定向到文件
command 2> file # 错误输出重定向到文件
command > file 2>&1 # 标准输出和错误输出都重定向到文件
command &> file # 同上(简写)
command >> file # 追加标准输出到文件
command 2>> file # 追加错误输出到文件

# 丢弃所有输出
command > /dev/null 2>&1 # 标准输出和错误输出都丢弃
command &> /dev/null # 同上(简写)

# 后台运行
nohup command > /dev/null 2>&1 & # 后台运行并丢弃所有输出

重定向顺序的重要性

1
2
3
4
5
6
7
8
9
10
11
12
13
# 正确写法
>/dev/null 2>&1
# 执行顺序:
# 1. 标准输出重定向到/dev/null
# 2. 错误输出重定向到标准输出(即/dev/null)
# 结果:两者都被丢弃

# 错误写法
2>&1 >/dev/null
# 执行顺序:
# 1. 错误输出绑定到当前标准输出(屏幕)
# 2. 标准输出重定向到/dev/null
# 结果:标准输出被丢弃,错误输出仍显示在屏幕

nohup 命令详解

1
2
3
4
5
6
nohup command &                     # 后台运行,输出到nohup.out
nohup command > log.txt 2>&1 & # 后台运行,输出到log.txt
nohup command > /dev/null 2>&1 & # 后台运行,不产生任何输出

# 常用于启动Java服务
nohup java -jar xxxx.jar > /dev/null 2>&1 &

重点建议

1. 实践为主

  • 购买云服务器进行实际操作
  • 每个命令都亲自尝试
  • 出错是正常的,重要的是理解为什么出错

2. 循序渐进

  • 先掌握基础命令
  • 再学习高级特性
  • 最后进行综合应用

3. 善用帮助

1
2
3
man 命令                        # 查看命令手册
command --help # 查看命令帮助
whatis 命令 # 查看命令简介

4. 命令组合

  • 熟练使用管道符 |
  • 掌握重定向符号 > >>
  • 学会使用 && 和 || 连接命令

5. 安全意识

  • 谨慎使用 rm -rf 命令
  • 修改系统文件前做好备份
  • 使用非root用户进行日常操作
  • 定期备份重要数据

6. 效率提升

  • 使用Tab键自动补全
  • 使用历史命令(↑↓方向键)
  • 学习vim或nano编辑器
  • 掌握快捷键(Ctrl+C、Ctrl+Z等)

7. 日志管理

1
2
3
4
# 查看系统日志
tail -f /var/log/messages # 系统日志
tail -f /var/log/secure # 安全日志
tail -f /var/log/cron # 定时任务日志

引言

参照的是左程云的课程:https://space.bilibili.com/8888480/lists/3509640?type=series

本笔记是class048的内容,总结了二维前缀和、二维差分和离散化技巧的核心思想和应用。这些技巧是处理二维矩阵问题的重要工具,特别适用于矩形区域的批量查询和修改。

前置知识

在学习二维前缀和与差分之前,需要掌握以下基础知识:

  • 一维前缀和与差分的原理
  • 矩阵的基本操作
  • 容斥原理的理解
  • 坐标系统和索引处理

048【必备】二维前缀和、二维差分、离散化技巧

核心概念

二维前缀和的基本思想

二维前缀和是一维前缀和在二维空间的扩展:

  • 原理:预处理出每个位置到左上角(0,0)的矩形区域和
  • 查询优化:任意矩形区域的和查询在O(1)时间内完成
  • 核心公式:使用容斥原理计算矩形区域和

二维差分的基本思想

二维差分用于优化矩形区域的批量修改:

  • 原理:将矩形区域修改转化为四个关键点的修改
  • 适用场景:大量矩形修改操作,最后统一查询
  • 实现方式:通过四点修改实现区域增减,最后二维前缀和还原

离散化技巧

离散化用于处理坐标范围过大的问题:

  • 核心思想:将大范围坐标映射到小范围数组
  • 关键步骤:收集关键坐标、排序去重、建立映射关系
  • 应用场景:坐标值很大但关键点有限的问题

题目一:二维前缀和模板

问题描述

给定一个二维矩阵matrix,实现一个类来处理以下类型的多次查询:

  • 计算其子矩形范围内元素的总和,该子矩形的左上角为(row1, col1),右下角为(row2, col2)。

测试链接:https://leetcode.cn/problems/range-sum-query-2d-immutable/

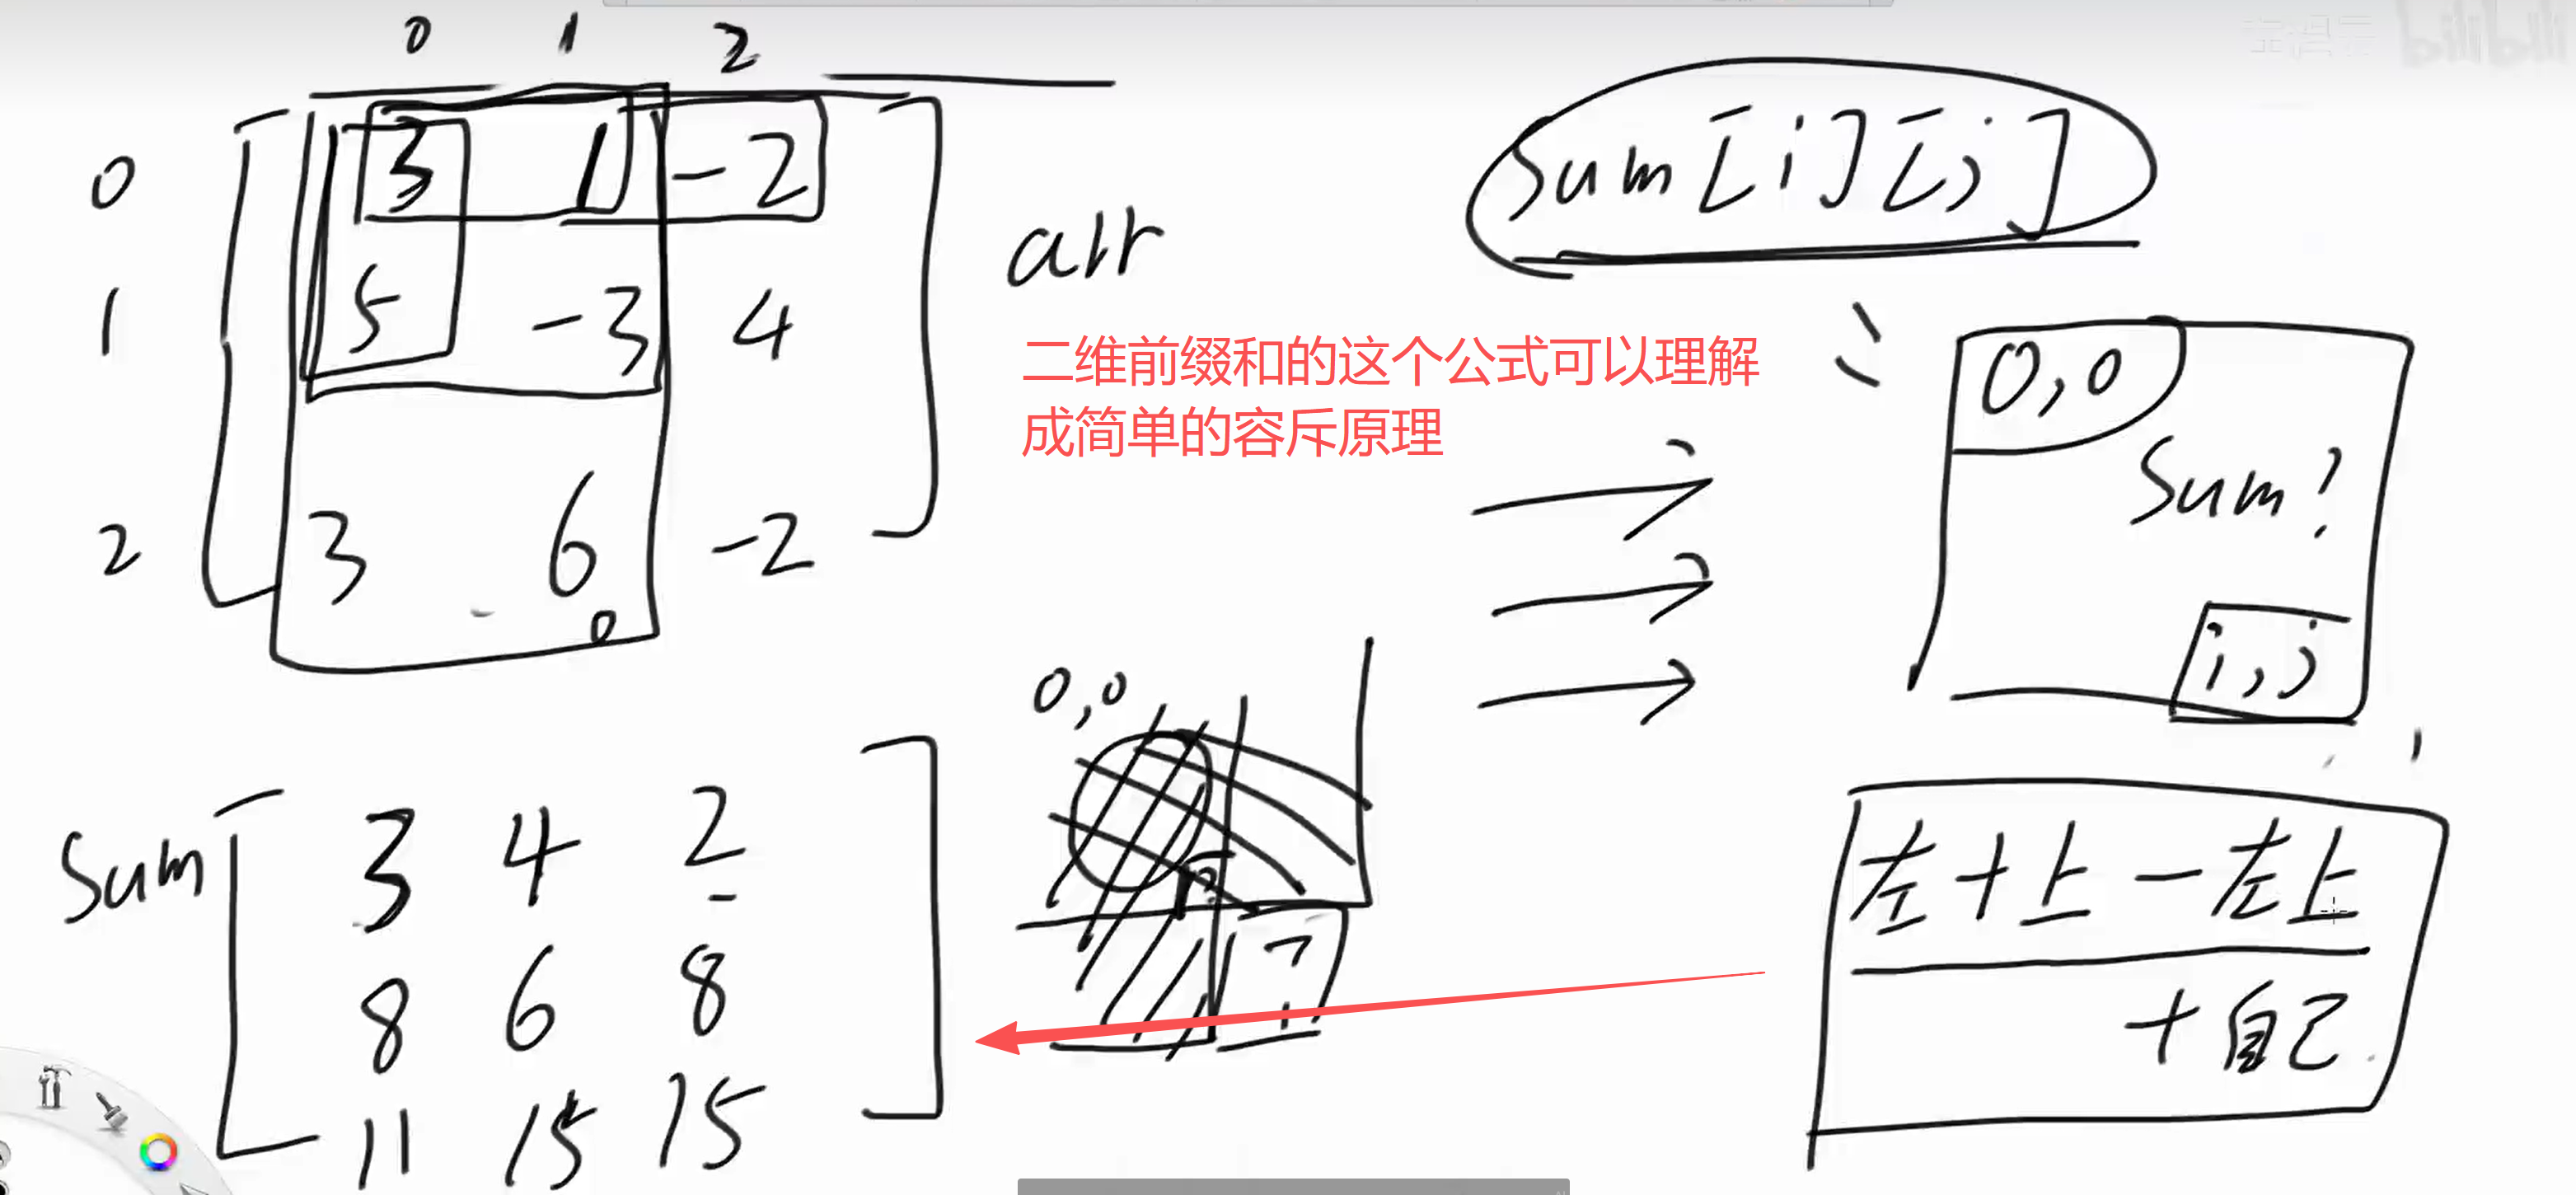
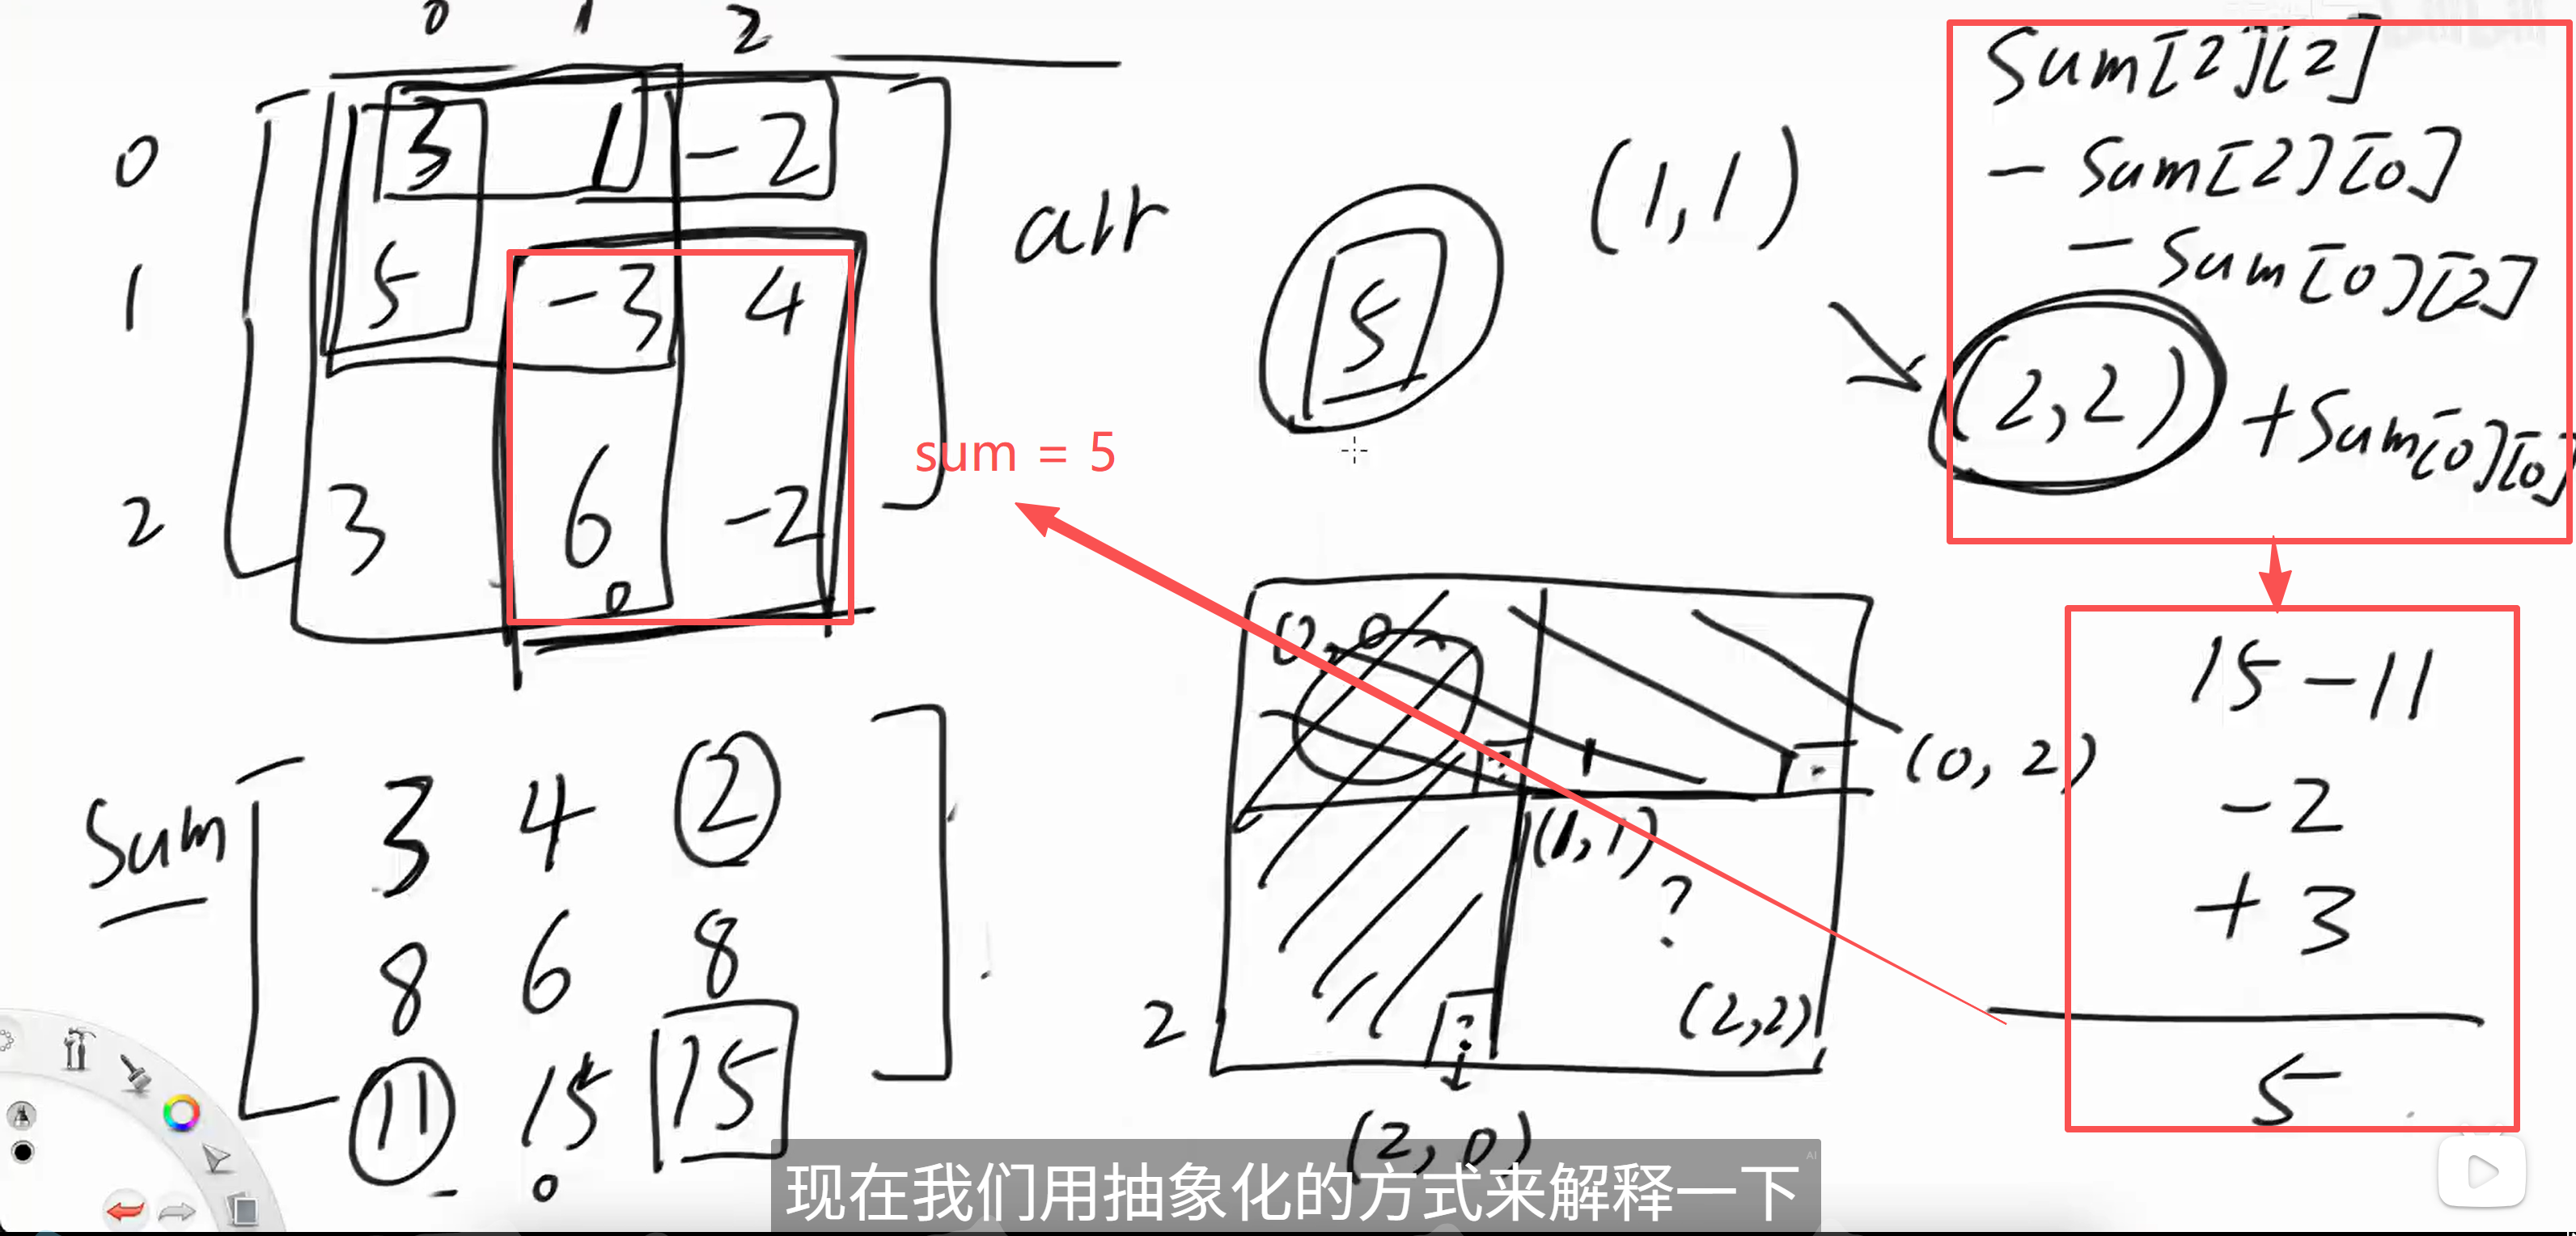
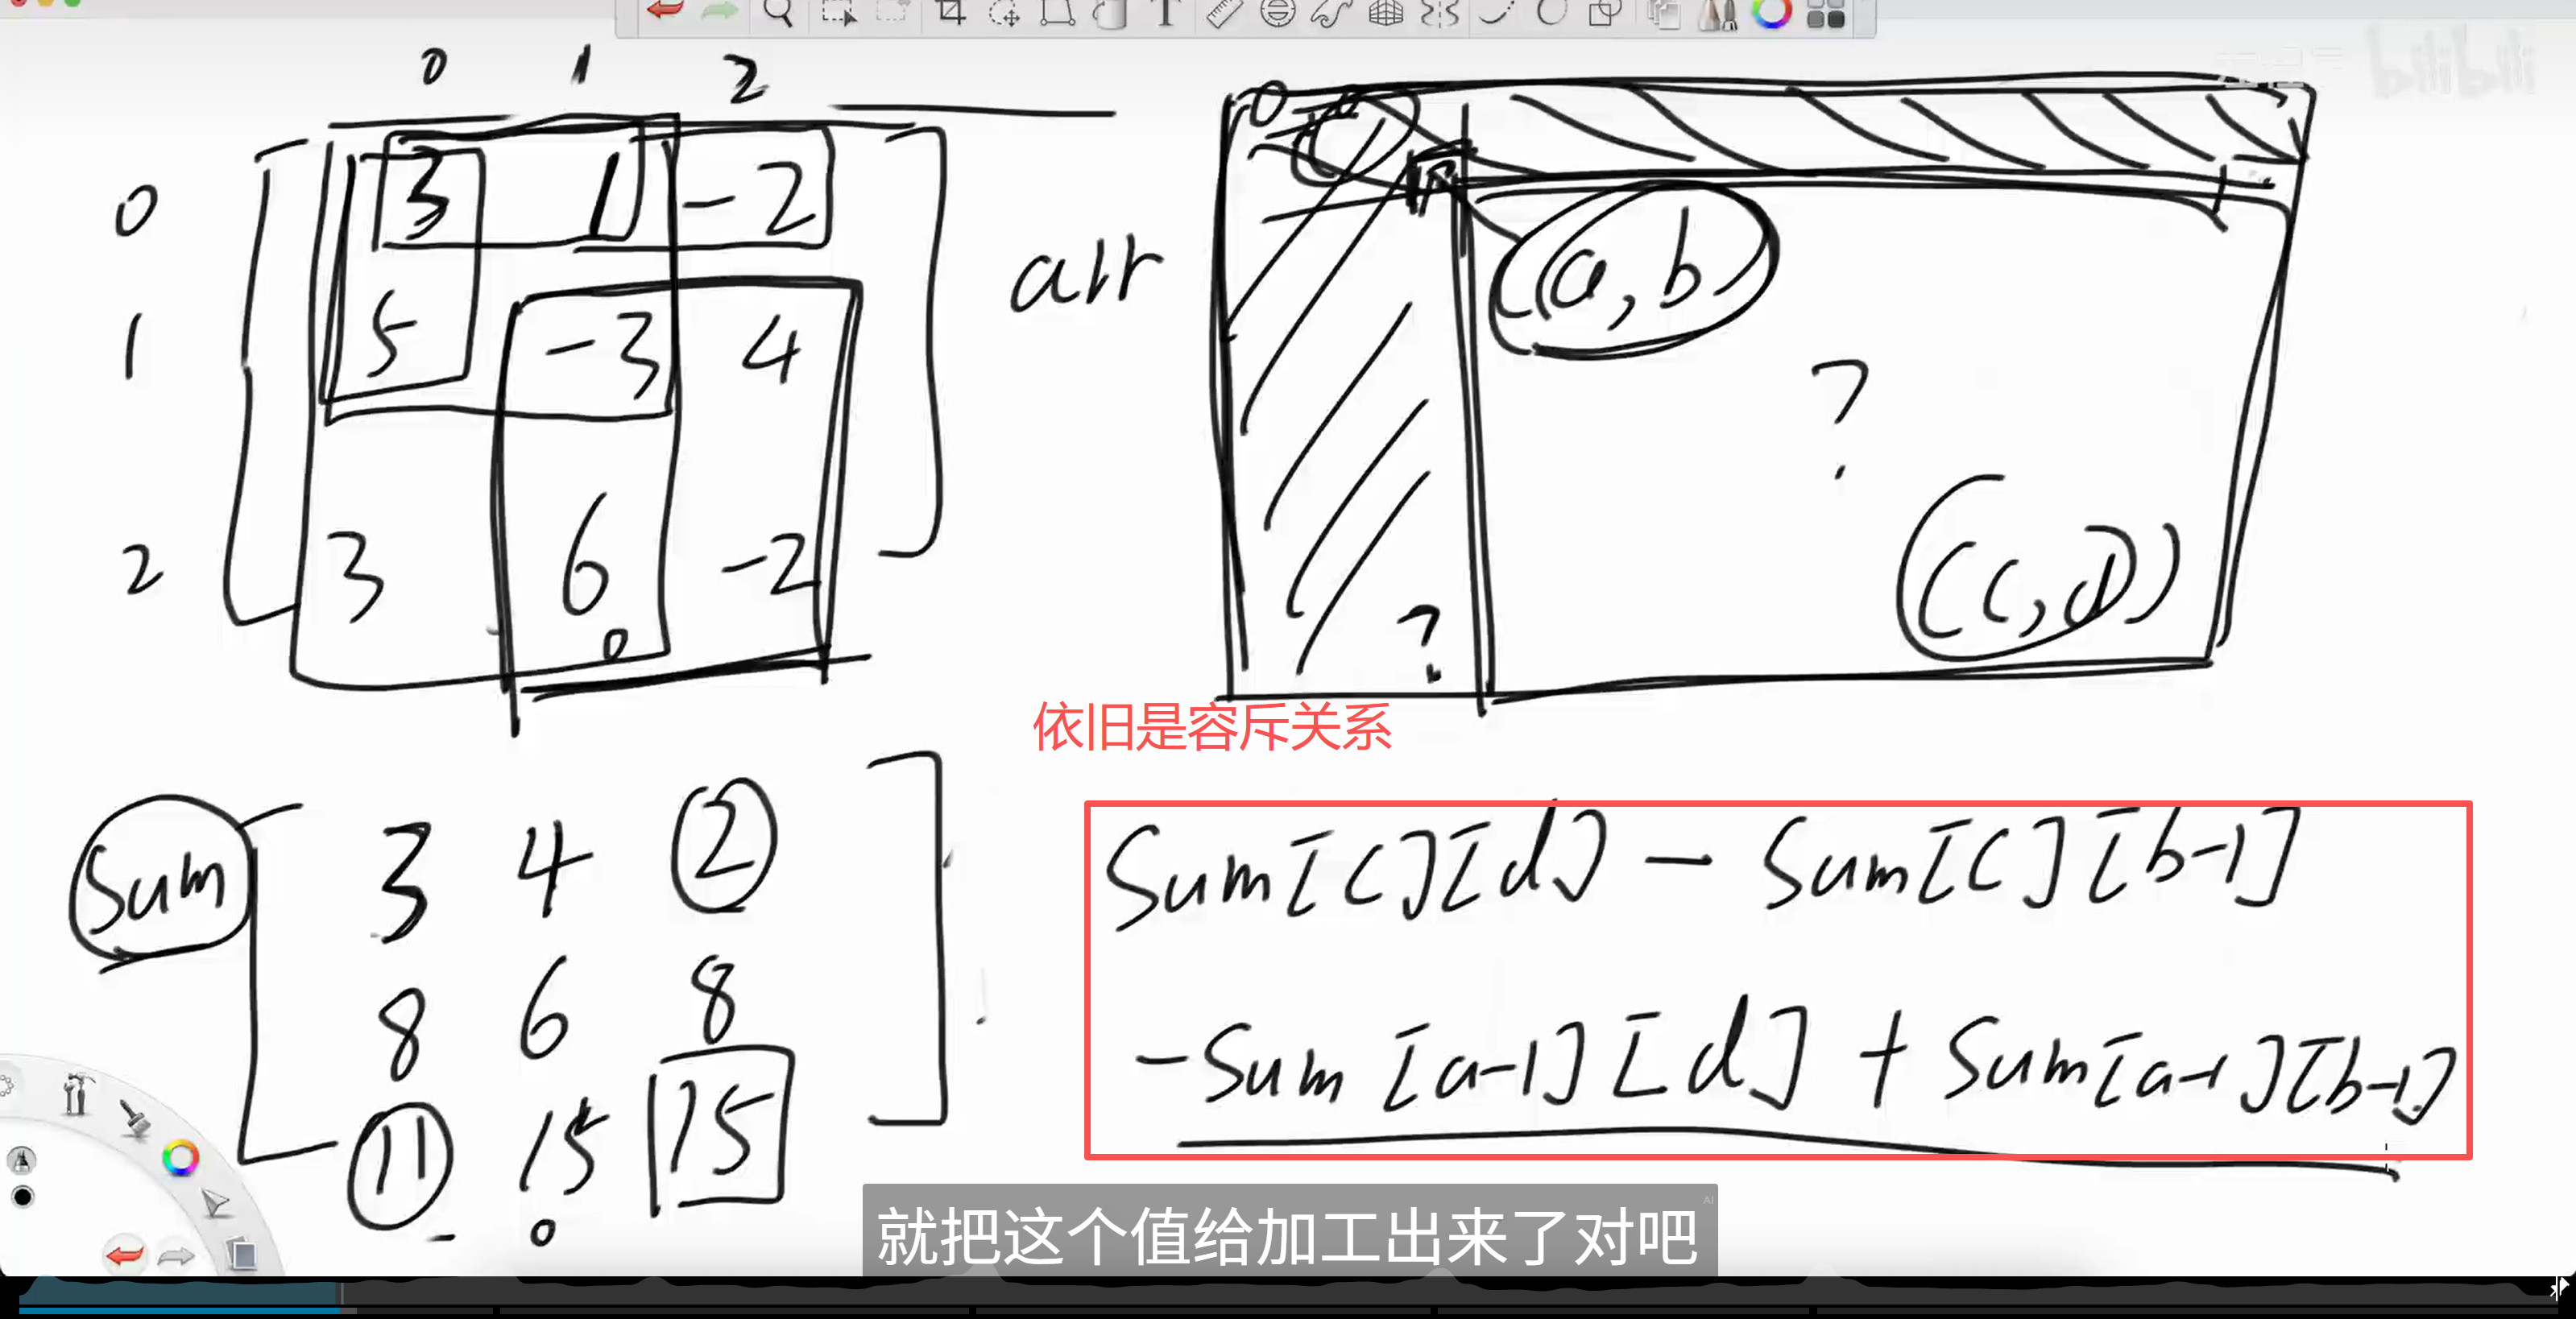
核心思想

通过预计算二维前缀和,实现O(1)时间复杂度的矩形区域和查询:

  1. 前缀和构建:s[i][j] 存储从左上角(0,0)到右下角(i-1,j-1)的区域和
  2. 容斥原理:利用四个矩形的加减关系计算目标区域
  3. 边界处理:通过增加一圈0来简化边界判断

前缀和的公式
求二维数组子数组的和
求二维数组子数组的和抽象化

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
from typing import List

class NumMatrix:
"""
通过预计算二维前缀和,实现O(1)时间复杂度的矩形区域和查询。
核心思想 (Inclusion-Exclusion Principle):
1. 创建一个比原矩阵行列各大1的前缀和矩阵 `self.s`。
2. `self.s[i][j]` 存储原矩阵中从左上角 (0,0) 到右下角 (i-1,j-1) 的矩形区域内所有元素的和。
3. 构建公式: s[i][j] = matrix[i-1][j-1] + s[i-1][j] + s[i][j-1] - s[i-1][j-1]
(当前格子的值 + 上方矩形和 + 左方矩形和 - 左上方被重复计算的矩形和)
4. 查询 (r1,c1)到(r2,c2)的区域和:
ans = s[r2+1][c2+1] - s[r1][c2+1] - s[r2+1][c1] + s[r1][c1]
(大矩形 - 上方多余矩形 - 左方多余矩形 + 左上方被重复减去的矩形)
"""
def __init__(self, matrix: List[List[int]]):
if not matrix or not matrix[0]:
self.s = [[0]]
return

n = len(matrix)
m = len(matrix[0])
# s 的行列都比原 matrix 大 1,方便处理边界
self.s = [[0] * (m + 1) for _ in range(n + 1)]

# 构建前缀和矩阵,在左边上边和左上补0
for i in range(1, n + 1):
for j in range(1, m + 1):
self.s[i][j] = matrix[i - 1][j - 1] + self.s[i - 1][j] + self.s[i][j - 1] - self.s[i - 1][j - 1]

def sumRegion(self, r1: int, c1: int, r2: int, c2: int) -> int:
# 传入的r1, c1, r2, c2是0-indexed, 对应到前缀和矩阵需要+1
r1, c1, r2, c2 = r1 + 1, c1 + 1, r2 + 1, c2 + 1
return self.s[r2][c2] - self.s[r1 - 1][c2] - self.s[r2][c1 - 1] + self.s[r1 - 1][c1 - 1]

容斥原理图解

1
2
3
4
5
6
7
8
9
10
11
12
13
14
查询矩形区域 (r1,c1) 到 (r2,c2) 的和:
目标区域 = 大矩形 - 上方矩形 - 左方矩形 + 重叠矩形

(0,0) ----- (0,c1)----- (0,c2)
| A | B |
| | |
(r1,0) ---- (r1,c1) ---- (r1,c2)
| C | D |
| | |
(r2,0) ---- (r2,c1) ---- (r2,c2)


答案 = (A+B+C+D) - (A+B) - (A+C) + A = D
即:s[r2][c2] - s[r1-1][c2] - s[r2][c1-1] + s[r1-1][c1-1]

算法分析

  • 预处理时间复杂度:O(n×m)
  • 查询时间复杂度:O(1)
  • 空间复杂度:O(n×m)

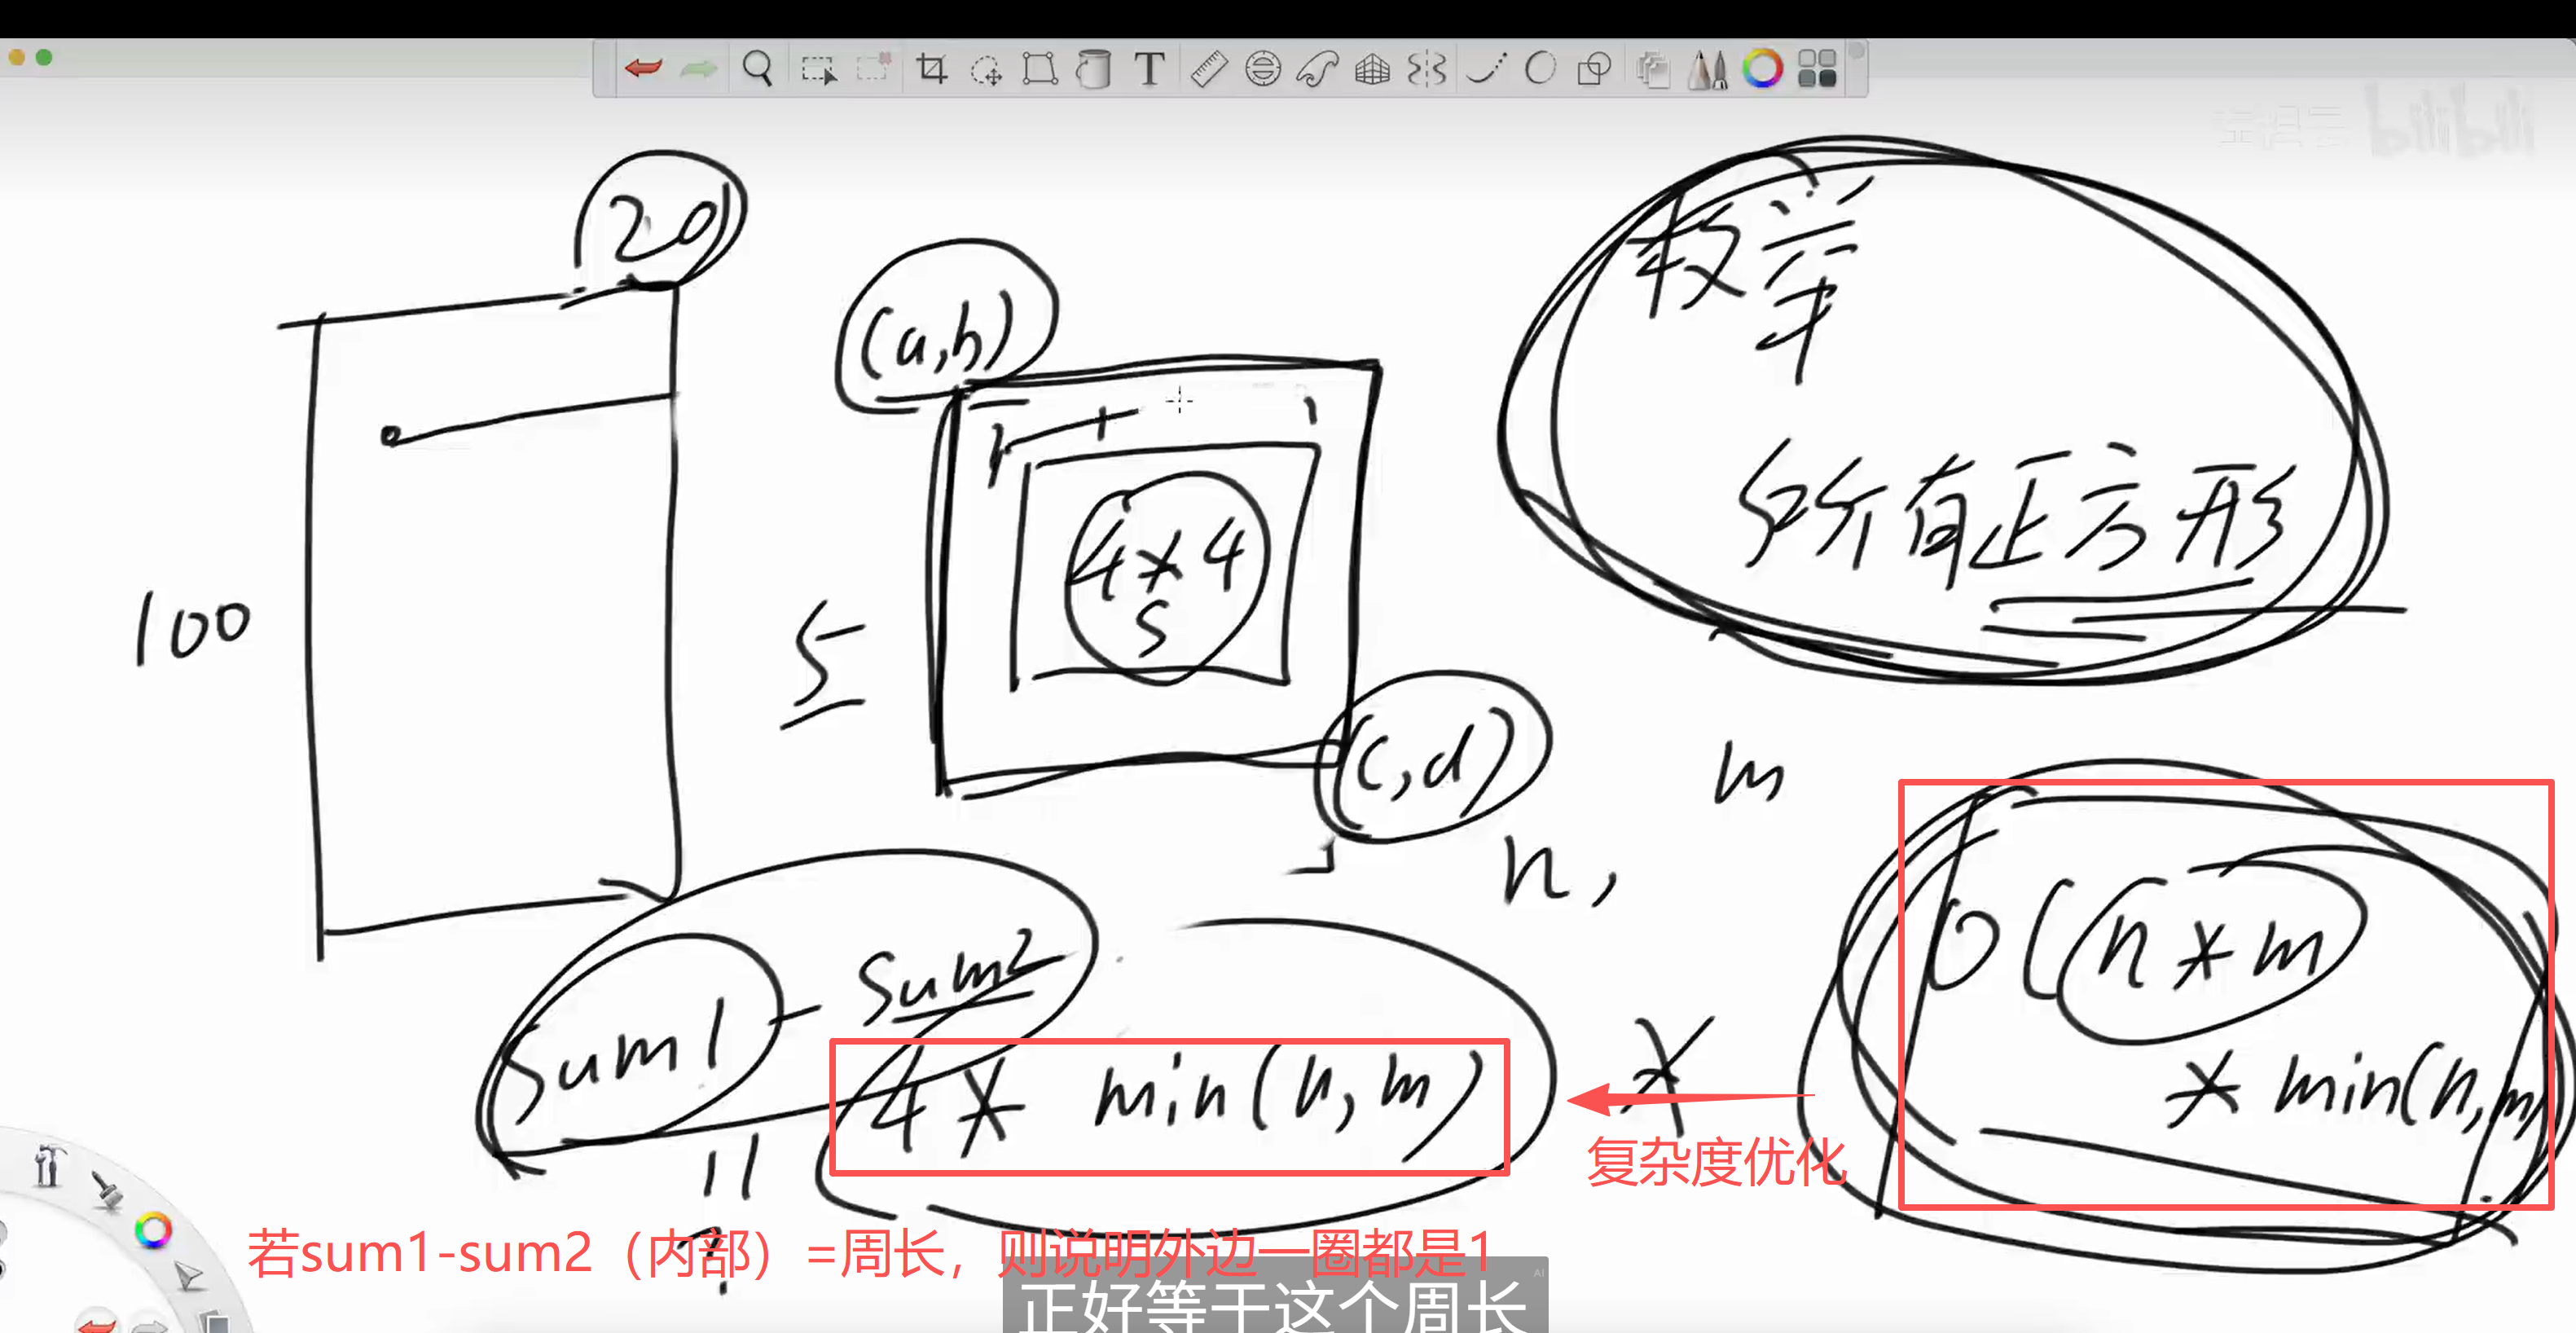
题目二:边框为1的最大正方形

问题描述

给你一个由若干0和1组成的二维网格grid,请你找出边界全部由1组成的最大正方形子网格,并返回该子网格中的元素数量。如果不存在,则返回0。

测试链接:https://leetcode.cn/problems/largest-1-bordered-square/

核心思想

利用二维前缀和快速验证正方形边框是否全为1:

  1. 边框验证:边框和 = 整个正方形和 - 内部正方形和
  2. 边框元素数量:边长为k的正方形边框有4×(k-1)个元素
  3. 枚举优化:从已知最大边长+1开始尝试,进行剪枝

寻找最大的周长都是1的四边形

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
class Solution:
# 打败比例不高,但完全是常数时间的问题
# 时间复杂度O(n * m * min(n,m)),额外空间复杂度O(1),因为直接复用的自己
# 复杂度指标上绝对是最优解
def largest1BorderedSquare(self, grid: List[List[int]]) -> int:
"""
核心思想:
1. 使用二维前缀和快速计算任意子矩阵的元素和。
为了节省空间,直接在原输入 `grid` 上构建前缀和矩阵。
2. 遍历所有可能的正方形。一个正方形由其左上角 `(r1, c1)` 和边长 `k` 决定。
3. 对于一个边长为 `k` 的正方形,其右下角为 `(r2, c2)`。
要判断其边框是否全为1,可以计算边框上所有元素的和。
边框和 = (整个正方形的和) - (去掉边框后的内部小正方形的和)
4. 一个边长为 `k` 的正方形,其边框共有 `4 * (k - 1)` 个单元格 (如果k>1)。
5. 如果计算出的 "边框和" 等于 `4 * (k - 1)`,则说明这个正方形边框全为1,
我们更新找到的最大边长。
6. 从大到小或从小到大遍历边长均可,这里是从小到大。
"""
n = len(grid)
m = len(grid[0])

# 直接在 grid 上构建前缀和矩阵
self._build(n, m, grid)

# 找到的最大合法正方形的边长
ans = 0
# 检查是否存在至少一个 1
if self._sum(grid, 0, 0, n - 1, m - 1) > 0:
ans = 1

for r1 in range(n):
for c1 in range(m):
# (r1, c1) 作为所有可能的左上角点
# k 是当前尝试的边长
# 从已知的最大边长+1开始尝试,进行剪枝
k = ans + 1
while r1 + k - 1 < n and c1 + k - 1 < m:
r2 = r1 + k - 1
c2 = c1 + k - 1

# 边框和 = 大正方形和 - 小正方形和
border_sum = self._sum(grid, r1, c1, r2, c2) - self._sum(grid, r1 + 1, c1 + 1, r2 - 1, c2 - 1)

# 边长为k的正方形,边框有 4 * (k-1) 个格子,可以带入前缀和公式逐个元素相加得到下面成立
if border_sum == (k - 1) * 4:
ans = k
k += 1

return ans * ans

def _build(self, n, m, g):
"""把g变成原始二维数组的前缀和数组sum,复用自己"""
for i in range(n):
for j in range(m):
g[i][j] += self._get(g, i, j - 1) + self._get(g, i - 1, j) - self._get(g, i - 1, j - 1)

def _sum(self, g, r1, c1, r2, c2):
"""计算 (r1,c1) 到 (r2,c2) 矩形区域的和"""
if r1 > r2 or c1 > c2:
return 0
return self._get(g, r2, c2) - self._get(g, r2, c1 - 1) - self._get(g, r1 - 1, c2) + self._get(g, r1 - 1, c1 - 1)

def _get(self, g, i, j):
"""安全地获取前缀和,处理边界情况"""
return g[i][j] if i >= 0 and j >= 0 else 0

算法分析

  • 时间复杂度:O(n×m×min(n,m))
  • 空间复杂度:O(1)(复用输入数组)
  • 优化策略:剪枝搜索,从大边长开始尝试

题目三:二维差分模板

问题描述

给定一个n×n的矩阵,初始时所有元素都是0。进行q次操作,每次操作给定一个矩形区域(r1,c1)到(r2,c2),将该区域内所有元素加1。求所有操作完成后的矩阵。

测试链接:https://www.luogu.cn/problem/P3397

核心思想

使用二维差分数组优化矩形区域的批量修改:

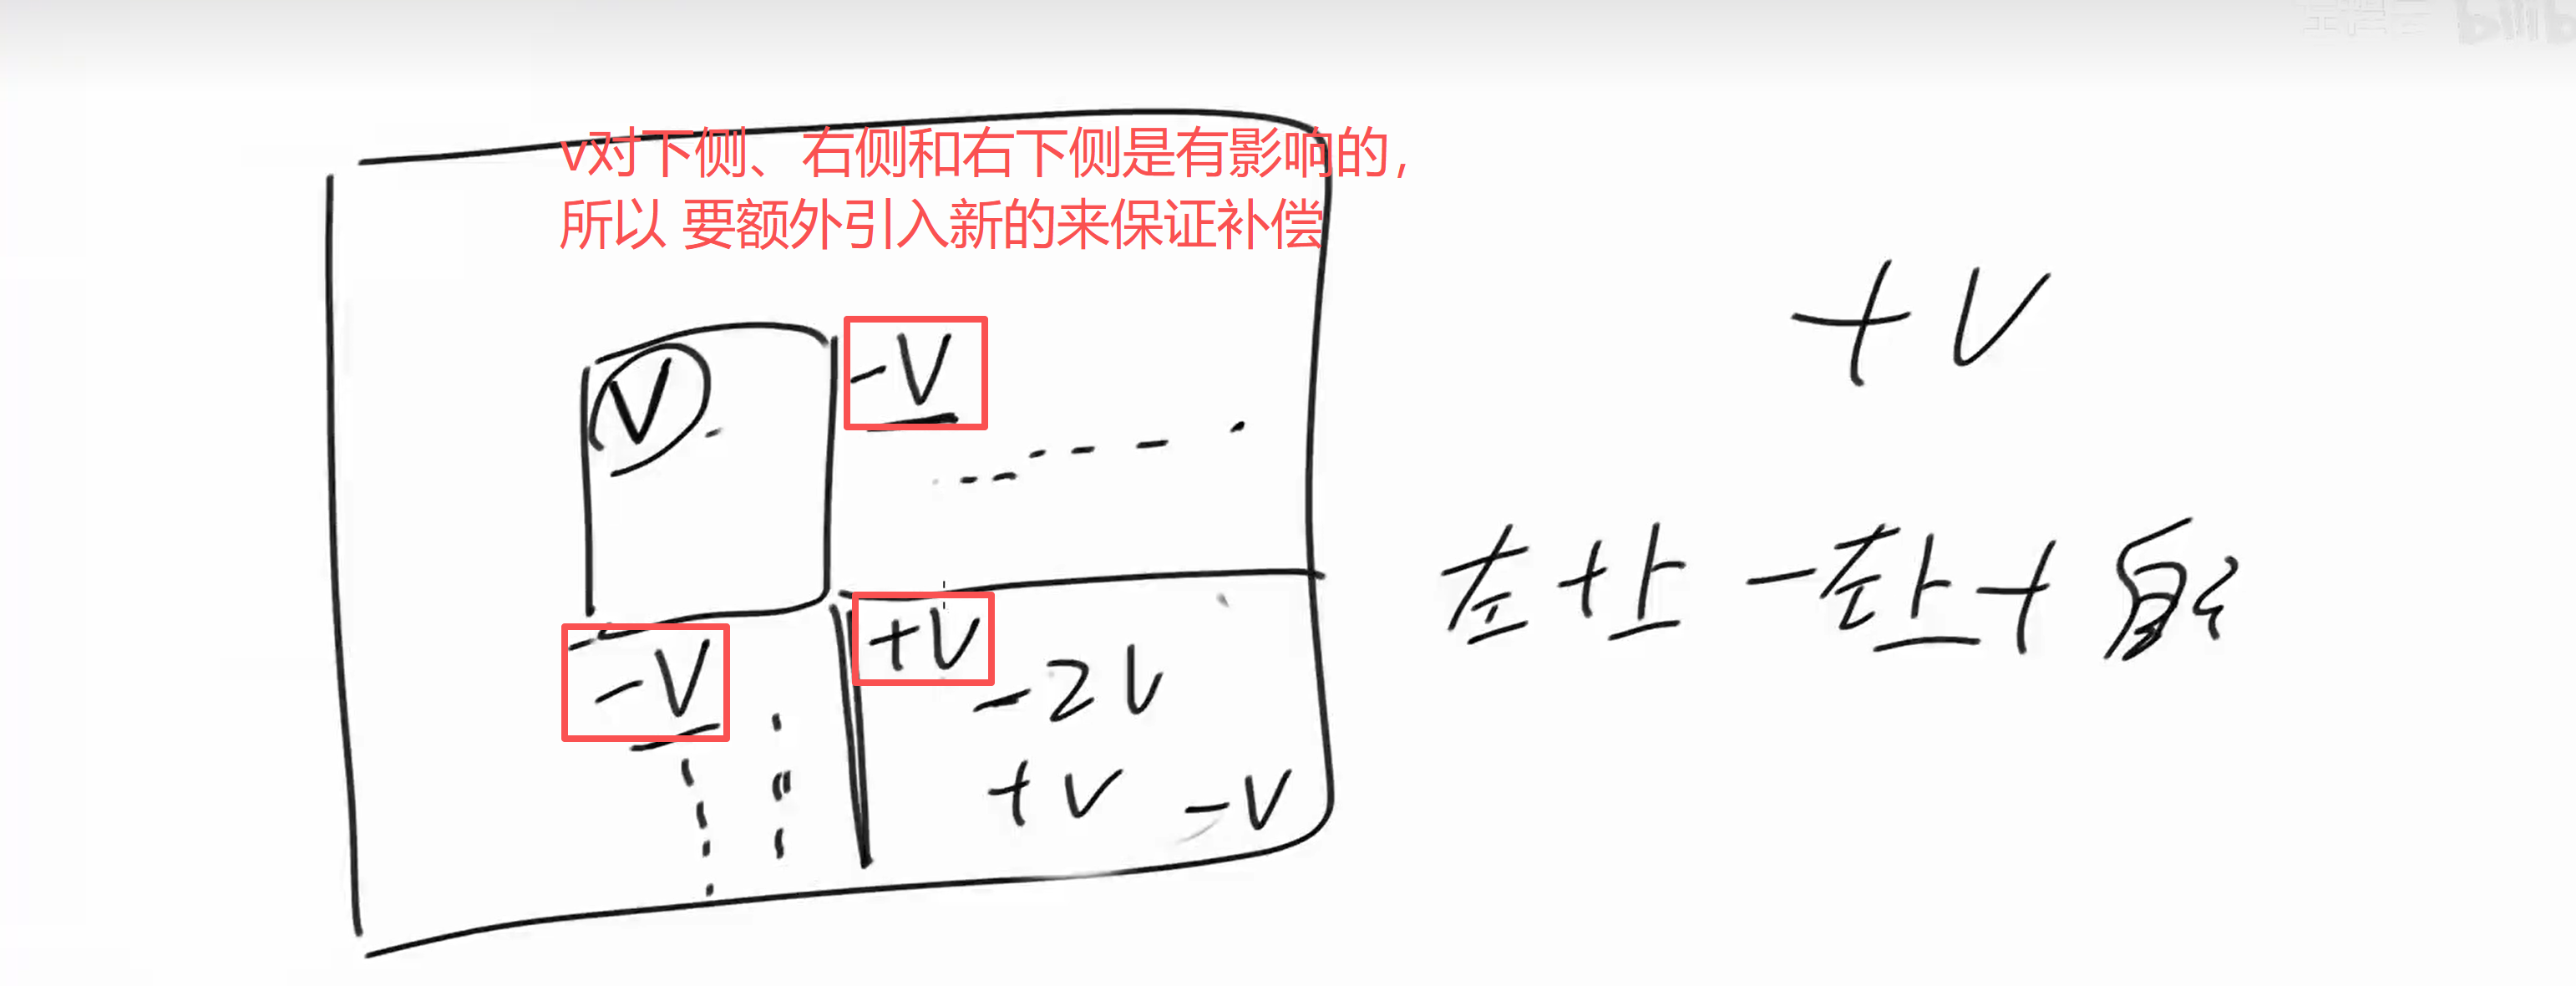
  1. 四点修改:对矩形区域的修改转化为四个关键点的修改
  2. 差分还原:通过二维前缀和从差分数组还原最终结果
  3. 边界处理:使用额外的边界空间简化边界判断

二维差分补偿

关键函数解析

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
def add(r1, c1, r2, c2, k):
"""
在二维差分矩阵上进行修改,以实现对原矩阵的矩形区域加值。
这是通过在矩形的四个角点进行修改来完成的。

数学原理:
要让矩形区域(r1,c1)到(r2,c2)都增加k,需要:
- 在(r1,c1)处 +k:影响从该点到右下角的所有区域
- 在(r2+1,c1)处 -k:抵消下方区域的影响
- 在(r1,c2+1)处 -k:抵消右方区域的影响
- 在(r2+1,c2+1)处 +k:补偿被重复抵消的右下角区域
"""
diff[r1][c1] += k
diff[r2 + 1][c1] -= k
diff[r1][c2 + 1] -= k
diff[r2 + 1][c2 + 1] += k

def build():
"""
通过一次二维前缀和运算,从差分矩阵还原出最终的矩阵。
"""
for i in range(1, n + 1):
for j in range(1, n + 1):
diff[i][j] += diff[i - 1][j] + diff[i][j - 1] - diff[i - 1][j - 1]

二维差分图解

1
2
3
4
5
6
7
8
9
10
11
12
13
14
原始矩形修改:对区域(r1,c1)到(r2,c2)加k

(r1,c1) -------- (r1,c2+1)
| 目标区域 |
| |
(r2+1,c1) ---- (r2+1,c2+1)

四点修改:
diff[r1][c1] += k (左上角)
diff[r2+1][c1] -= k (左下角)
diff[r1][c2+1] -= k (右上角)
diff[r2+1][c2+1] += k (右下角)

前缀和还原后,只有目标区域内的值增加k

完整实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
import sys

MAXN = 1002
diff = [[0] * MAXN for _ in range(MAXN)]
n, q = 0, 0

def add(r1, c1, r2, c2, k):
"""在二维差分矩阵上进行修改"""
diff[r1][c1] += k
diff[r2 + 1][c1] -= k
diff[r1][c2 + 1] -= k
diff[r2 + 1][c2 + 1] += k

def build():
"""从差分矩阵还原出最终矩阵"""
for i in range(1, n + 1):
for j in range(1, n + 1):
diff[i][j] += diff[i - 1][j] + diff[i][j - 1] - diff[i - 1][j - 1]

def clear():
"""清空差分矩阵"""
for i in range(1, n + 2):
for j in range(1, n + 2):
diff[i][j] = 0

def main():
"""
核心思想:二维差分数组
1. 对一个矩阵的子矩阵`(r1,c1)`到`(r2,c2)`范围内的所有元素加`k`,
如果暴力修改,效率很低。
2. 我们可以使用一个差分矩阵`D`。对上述范围的修改,只需在`D`的4个点上操作。
3. 在处理完所有`q`个操作后,对差分矩阵`D`求一次二维前缀和,
就可以得到最终的矩阵。
"""
global n, q
lines = sys.stdin.readlines()
if not lines:
return

line_iter = iter(lines)

try:
while True:
n_q_line = next(line_iter)
if not n_q_line: break

n, q = map(int, n_q_line.strip().split())
clear()

for _ in range(q):
r1, c1, r2, c2 = map(int, next(line_iter).strip().split())
add(r1, c1, r2, c2, 1)

build()

# 打印结果
for i in range(1, n + 1):
print(' '.join(map(str, diff[i][1:n+1])))

except StopIteration:
pass

if __name__ == "__main__":
main()

算法分析

  • 时间复杂度:O(q + n²)
  • 空间复杂度:O(n²)
  • 核心优势:将每次O(n²)的区域修改优化为O(1)的四点修改

题目四:用邮票贴满网格图

问题描述

给你一个m×n的二进制矩阵grid,每个格子要么为0(空)要么为1(被占据)。给你邮票的尺寸为stampHeight×stampWidth。要求用邮票覆盖所有空格子,不覆盖任何被占据的格子。邮票可以相互重叠,但不允许旋转,必须完全在矩阵内。

测试链接:https://leetcode.cn/problems/stamping-the-grid/

核心思想

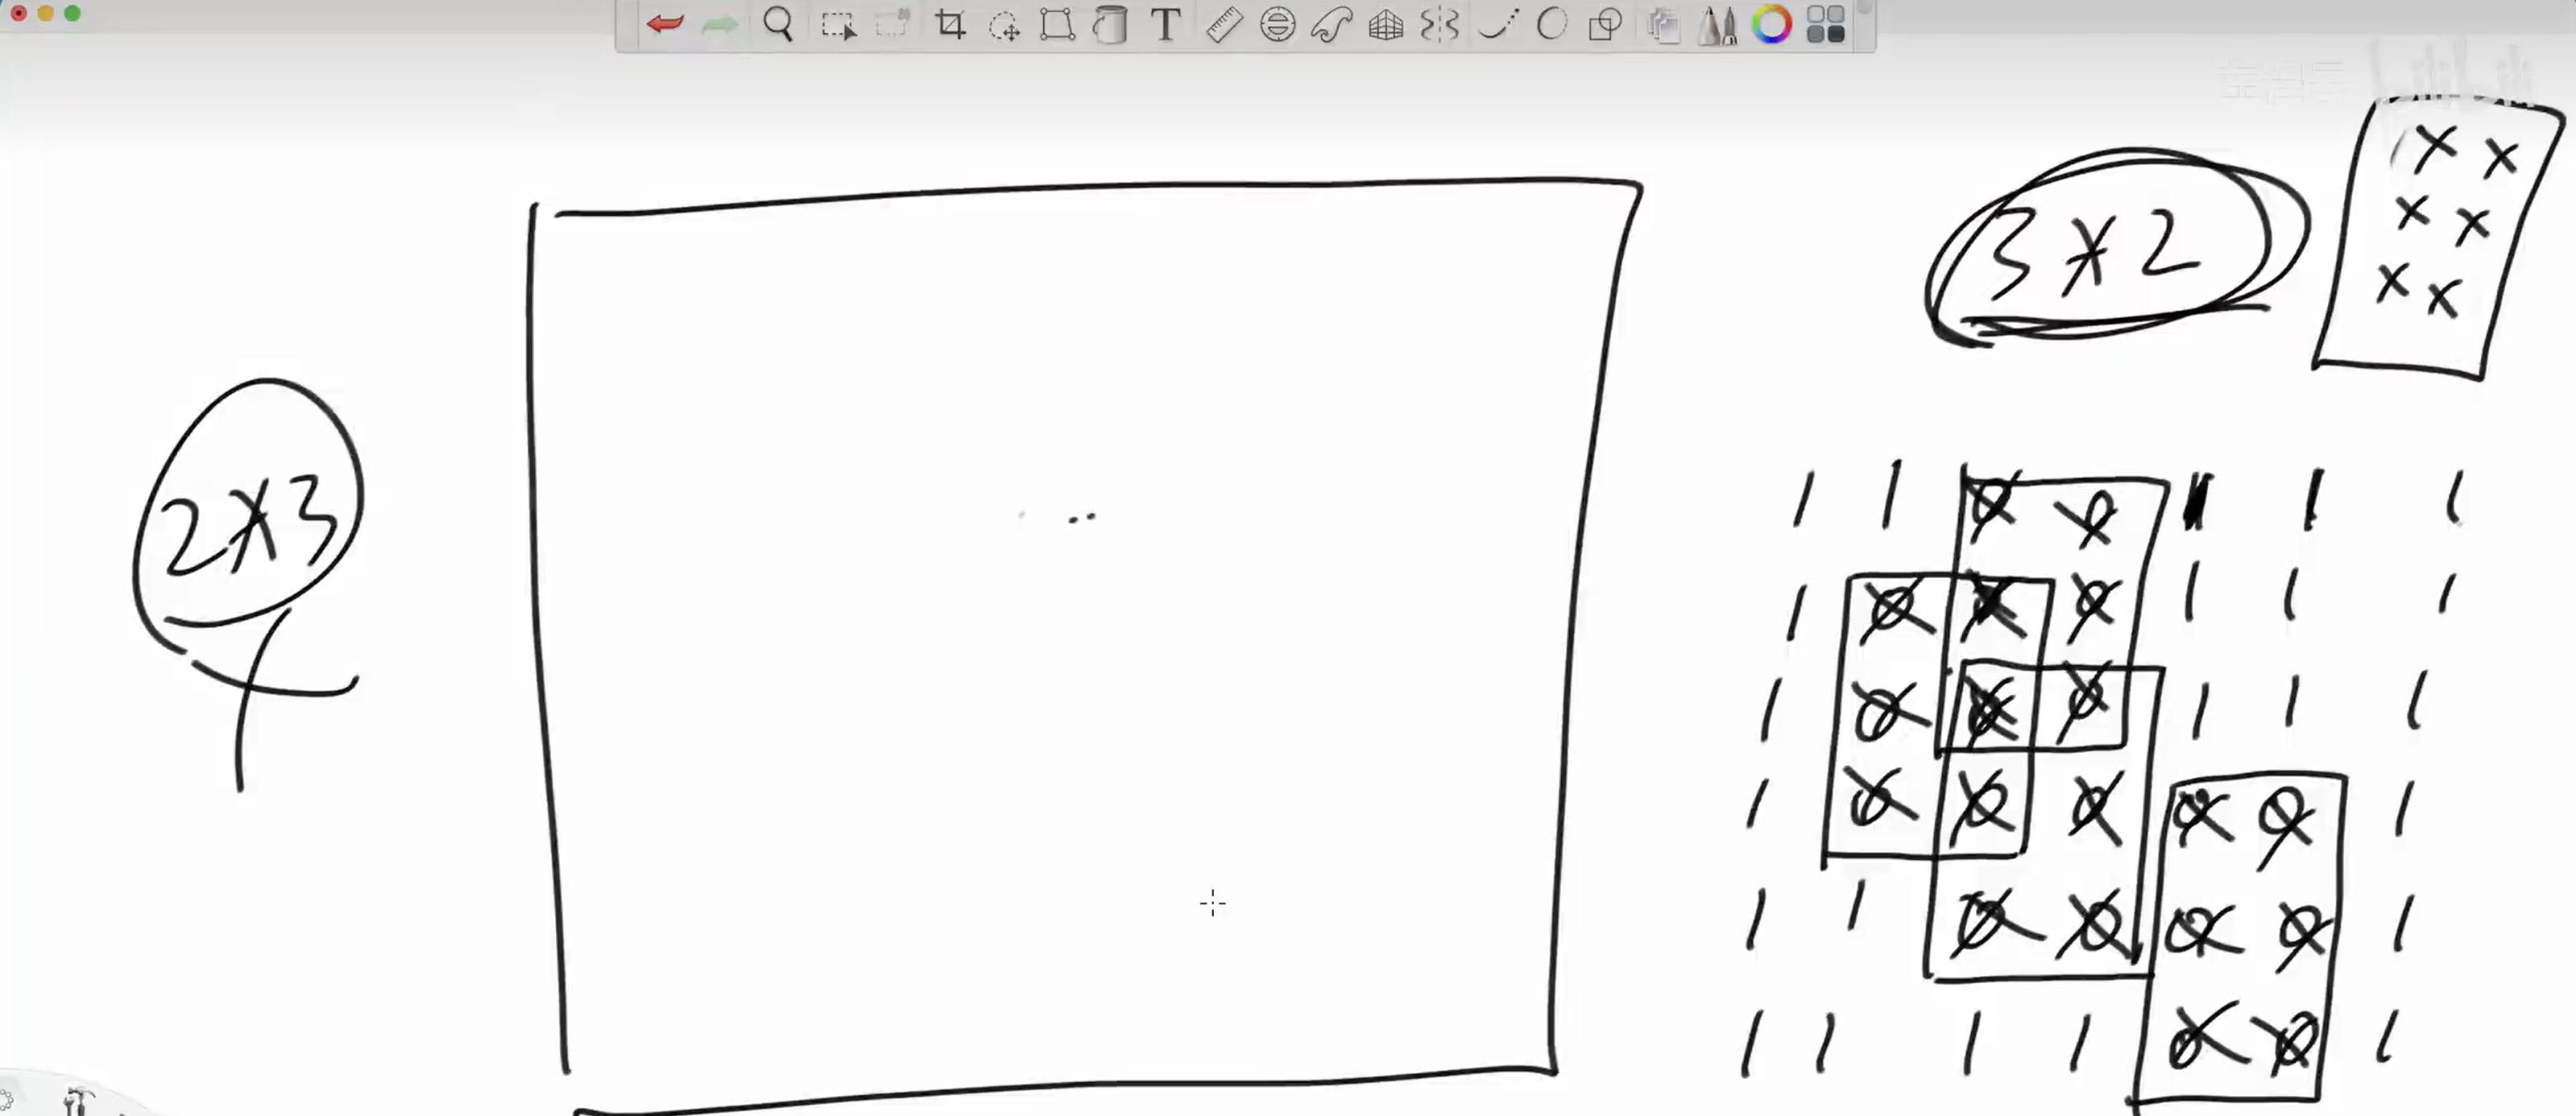
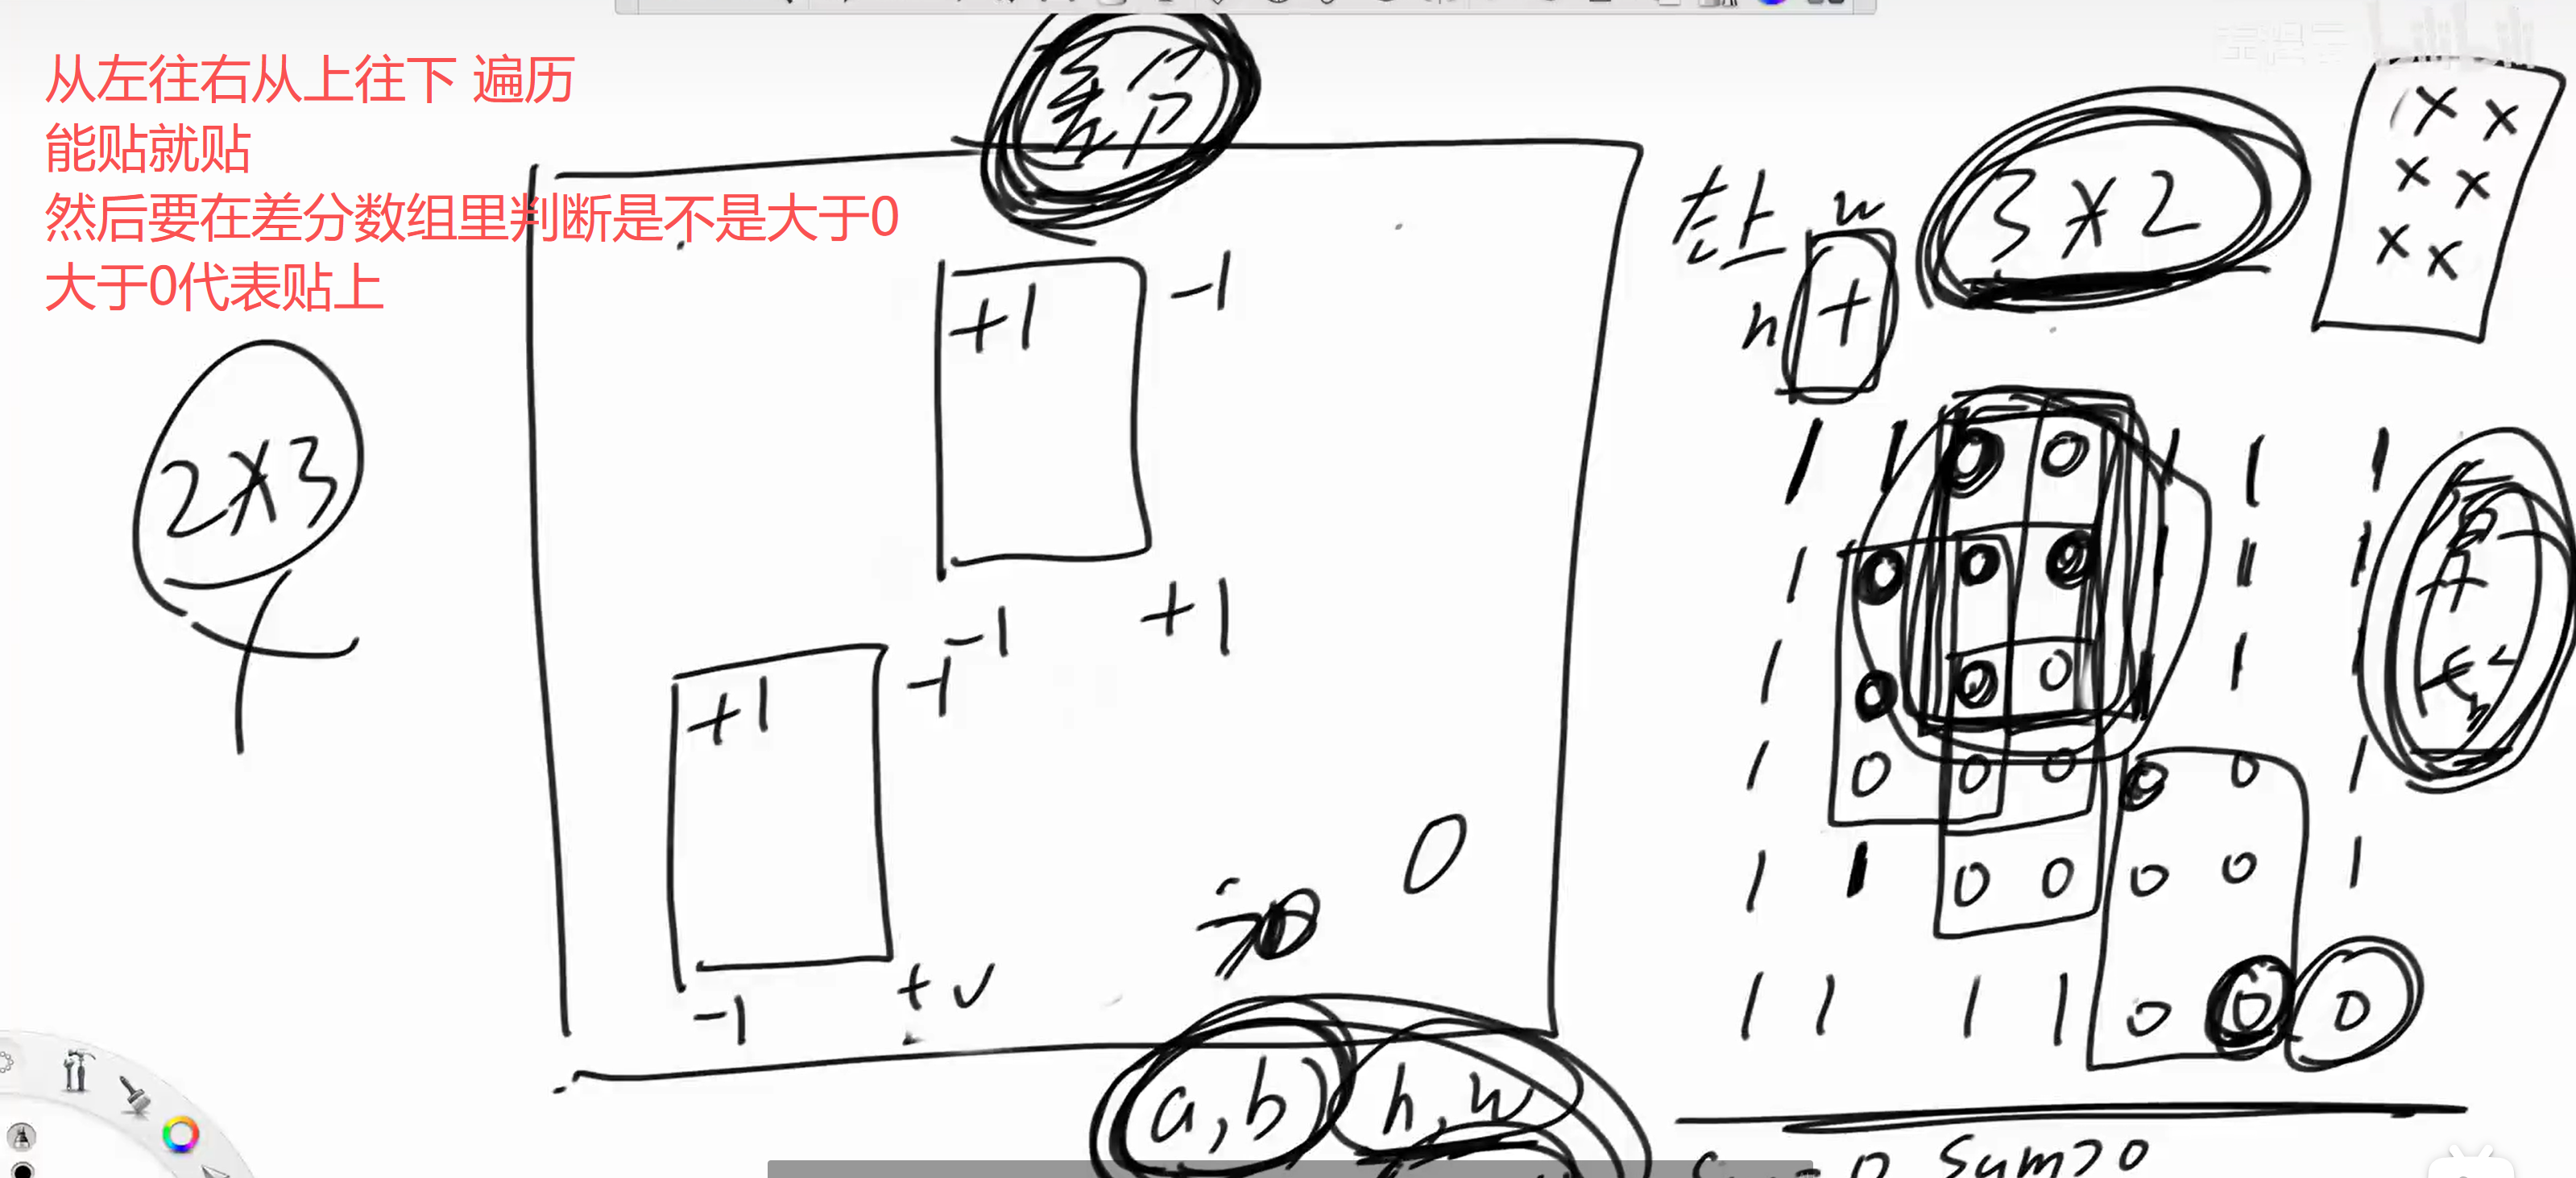
分两步解决:找出所有可贴位置,然后验证覆盖完整性:

  1. 可贴位置检测:使用二维前缀和快速判断区域是否全为0
  2. 覆盖标记:使用二维差分标记所有被邮票覆盖的位置
  3. 完整性验证:检查所有空格子是否都被覆盖

填补邮票案例
贴邮票

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
class Solution:
def possibleToStamp(self, grid: List[List[int]], h: int, w: int) -> bool:
"""
核心思想:分两步走
1. 找出所有可以贴邮票的位置:
- 对原 `grid` 建立一个二维前缀和数组 `s`,这样可以 O(1) 查询任何矩形区域的和。
- 遍历所有可能的邮票左上角 `(r, c)`,利用前缀和 `s` 检查对应的 `h x w` 区域
是否全为0 (即区域和为0)。
2. 标记所有被邮票覆盖的空格子:
- 创建一个二维差分数组 `diff`。
- 对于第一步中找到的每一个可以贴邮票的区域,我们在 `diff` 数组上执行一次
范围增加 `+1` 的操作。
- 所有可贴位置都处理完后,对 `diff` 数组求一次二维前缀和。
这样 `diff[r][c]` 的值就代表了 `(r, c)` 这个格子被多少张邮票覆盖了。
3. 验证结果:
- 遍历原 `grid`,如果发现任何一个空格子 (`grid[r][c] == 0`)
在 `diff` 数组中对应的值也为0,说明这个空格子没有被任何邮票覆盖,
因此无法完成任务,返回 `False`。
- 如果所有空格子都被覆盖了,返回 `True`。
"""
n = len(grid)
m = len(grid[0])

# 1. 构建 grid 的前缀和数组
s = [[0] * (m + 1) for _ in range(n + 1)]
for i in range(n):
for j in range(m):
s[i + 1][j + 1] = grid[i][j]
self._build(s)

# 2. 创建差分数组并标记所有可贴邮票的区域
diff = [[0] * (m + 2) for _ in range(n + 2)]
for r1 in range(1, n - h + 2):
for c1 in range(1, m - w + 2):
r2, c2 = r1 + h - 1, c1 + w - 1
# 如果 h x w 区域全为0,则可以贴邮票
if self._sum_region(s, r1, c1, r2, c2) == 0:
self._add(diff, r1, c1, r2, c2)

# 3. 从差分数组构建覆盖矩阵
self._build(diff)

# 4. 验证所有空格子是否都被覆盖
for i in range(n):
for j in range(m):
if grid[i][j] == 0 and diff[i + 1][j + 1] == 0:
return False

return True

def _build(self, mat: List[List[int]]):
"""对矩阵构建二维前缀和"""
n = len(mat)
m = len(mat[0])
for i in range(1, n):
for j in range(1, m):
mat[i][j] += mat[i - 1][j] + mat[i][j - 1] - mat[i - 1][j - 1]

def _sum_region(self, s: List[List[int]], r1: int, c1: int, r2: int, c2: int) -> int:
"""查询区域和"""
return s[r2][c2] - s[r2][c1 - 1] - s[r1 - 1][c2] + s[r1 - 1][c1 - 1]

def _add(self, diff: List[List[int]], r1: int, c1: int, r2: int, c2: int):
"""二维差分操作"""
diff[r1][c1] += 1
diff[r2 + 1][c2 + 1] += 1
diff[r2 + 1][c1] -= 1
diff[r1][c2 + 1] -= 1

算法分析

  • 时间复杂度:O(n×m)
  • 空间复杂度:O(n×m)
  • 核心技巧:前缀和检测 + 差分标记

题目五:最强祝福力场(离散化技巧)

问题描述

小扣发现了带有「祝福」效果的力场,每个力场覆盖以坐标(x,y)为中心、边长为side的正方形区域。求力场强度最强处的力场强度(即覆盖该点的力场数量的最大值)。

测试链接:https://leetcode.cn/problems/xepqZ5/

核心思想

使用离散化技巧处理大坐标范围问题:

  1. 坐标收集:收集所有力场的边界坐标
  2. 坐标压缩:排序去重得到压缩坐标轴
  3. 映射转换:将原始坐标映射到压缩空间
  4. 差分处理:在压缩空间中进行二维差分操作

离散化原理

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
# 离散化的核心步骤:
# 1. 收集关键坐标
coordinates = []
for field in fields:
x, y, side = field
coordinates.extend([x-side//2, x+side//2+1]) # 边界坐标

# 2. 排序去重
coordinates = sorted(list(set(coordinates)))

# 3. 建立映射关系
def get_index(val):
return bisect.bisect_left(coordinates, val)

# 4. 在压缩空间中操作
compressed_index = get_index(original_coordinate)

力场平移变换

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
import bisect
from typing import List

class Solution:
def fieldOfGreatestBlessing(self, fields: List[List[int]]) -> int:
"""
核心思想:坐标压缩 + 二维差分
1. 坐标范围可能很大,无法直接建立网格。但起决定性作用的只有力场的边界。
因此,我们先进行"坐标压缩"(或称"离散化")。
2. 收集所有力场正方形的左右边界和上下边界。
3. 对收集到的 x 和 y 坐标分别排序并去重,得到两组唯一的、有序的坐标轴。
4. 这两组坐标轴构成了一个压缩后的网格。每个原始的力场矩形都可以映射到
这个压缩网格上的一个小矩形区域。
5. 创建一个基于压缩坐标尺寸的二维差分数组。
6. 遍历每个原始力场,将其边界坐标在压缩坐标轴中进行二分查找,
得到其在压缩网格中的索引。
7. 在差分数组上对这个压缩后的矩形区域执行 `+1` 的范围增加操作。
8. 所有力场处理完毕后,对差分数组求二维前缀和,得到每个压缩单元格的力场强度。
"""
n = len(fields)
xs, ys = [0] * (n * 2), [0] * (n * 2)

# 收集所有边界坐标 (乘以2以避免处理小数)
for i, (x, y, side) in enumerate(fields):
xs[2 * i] = 2 * x - side
xs[2 * i + 1] = 2 * x + side
ys[2 * i] = 2 * y - side
ys[2 * i + 1] = 2 * y + side

# 排序并去重,得到唯一的坐标轴,只有不同的才保留
xs = sorted(list(set(xs)))
ys = sorted(list(set(ys)))

size_x = len(xs)
size_y = len(ys)
diff = [[0] * (size_y + 2) for _ in range(size_x + 2)]

# 对每个力场,在压缩后的差分矩阵上进行修改
for x, y, side in fields:
# 找到力场边界在压缩坐标轴上的索引(rank)
# bisect_left 实现了二分查找,效率高
r1 = bisect.bisect_left(xs, 2 * x - side) + 1 # bisect_left返回的是目标值在有序列表中的插入位置。
c1 = bisect.bisect_left(ys, 2 * y - side) + 1
# 注意:右边界和上边界在差分矩阵中对应的是块的结束,而不是下一个块的开始
# rank(v) 找到的是 v 的位置,而这个位置是区间的开始,所以是rank(end)-1
# 但add操作是[c+1],所以直接rank(end)即可
r2 = bisect.bisect_left(xs, 2 * x + side) + 1
c2 = bisect.bisect_left(ys, 2 * y + side) + 1
self._add(diff, r1, c1, r2-1, c2-1) #对每个力场调用 add → 在差分数组上标记覆盖

ans = 0
# 从差分矩阵进行前缀和还原,并找到最大值
for i in range(1, size_x + 1):
for j in range(1, size_y + 1):
diff[i][j] += diff[i - 1][j] + diff[i][j - 1] - diff[i - 1][j - 1]
ans = max(ans, diff[i][j])

return ans

def _add(self, diff: List[List[int]], r1: int, c1: int, r2: int, c2: int):
"""二维差分操作"""
diff[r1][c1] += 1
diff[r2 + 1][c2 + 1] += 1
diff[r2 + 1][c1] -= 1
diff[r1][c2 + 1] -= 1

离散化技巧总结

  1. 适用场景:坐标范围大但关键点少
  2. 核心步骤:收集→排序→去重→映射
  3. 空间优化:从O(坐标范围)降到O(关键点数量)
  4. 查找效率:使用二分查找进行坐标映射

算法分析

  • 时间复杂度:O(n²log n)
  • 空间复杂度:O(n²)
  • 优化效果:坐标压缩后空间大大减少

技巧总结与应用场景

1. 二维前缀和应用场景

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
# 适用情况:
# 1. 大量矩形区域查询
# 2. 查询频率远大于修改频率
# 3. 矩阵相对较小,可以承受O(n×m)的预处理

# 核心模板:
def build_prefix_sum(matrix):
"""构建二维前缀和"""
n, m = len(matrix), len(matrix[0])
s = [[0] * (m + 1) for _ in range(n + 1)]
for i in range(1, n + 1):
for j in range(1, m + 1):
s[i][j] = matrix[i-1][j-1] + s[i-1][j] + s[i][j-1] - s[i-1][j-1]
return s

def query_sum(s, r1, c1, r2, c2):
"""查询矩形区域和"""
return s[r2+1][c2+1] - s[r1][c2+1] - s[r2+1][c1] + s[r1][c1]

2. 二维差分应用场景

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
# 适用情况:
# 1. 大量矩形区域修改
# 2. 修改完成后批量查询
# 3. 不需要边修改边查询

# 核心模板:
def add_rectangle(diff, r1, c1, r2, c2, val):
"""矩形区域增加val"""
diff[r1][c1] += val
diff[r2+1][c1] -= val
diff[r1][c2+1] -= val
diff[r2+1][c2+1] += val

def build_result(diff):
"""从差分数组构建结果"""
n, m = len(diff)-1, len(diff[0])-1
for i in range(1, n):
for j in range(1, m):
diff[i][j] += diff[i-1][j] + diff[i][j-1] - diff[i-1][j-1]

3. 离散化应用场景

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
# 适用情况:
# 1. 坐标范围很大(如10^9)
# 2. 关键坐标点相对较少
# 3. 需要在坐标上进行区间操作

# 核心模板:
def discretize(coordinates):
"""坐标离散化"""
# 去重排序
sorted_coords = sorted(list(set(coordinates)))

# 建立映射
coord_to_index = {coord: i for i, coord in enumerate(sorted_coords)}

return sorted_coords, coord_to_index

def get_compressed_index(coord, sorted_coords):
"""获取压缩后的索引"""
return bisect.bisect_left(sorted_coords, coord)

复杂度分析对比

技巧 预处理 单次操作 空间复杂度 适用场景
二维前缀和 O(n×m) O(1)查询 O(n×m) 多查询少修改
二维差分 O(1) O(1)修改 + O(n×m)构建 O(n×m) 多修改后查询
离散化 O(k log k) 依赖具体算法 O(k²) 大坐标少关键点

学习建议

1. 理解容斥原理

  • 掌握二维前缀和的数学基础
  • 理解四个矩形的加减关系
  • 练习边界处理技巧

2. 掌握差分思想

  • 理解二维差分的四点修改原理
  • 熟练掌握差分与前缀和的转换
  • 注意边界扩展的重要性

3. 熟练离散化技巧

  • 理解坐标压缩的核心思想
  • 掌握二分查找在离散化中的应用
  • 练习大坐标问题的转换

4. 综合应用能力

  • 能够识别适合使用哪种技巧的问题
  • 掌握多种技巧的组合使用
  • 注意边界条件和特殊情况的处理

5. 调试技巧

  • 验证前缀和构建的正确性
  • 检查差分操作的边界
  • 测试离散化映射的准确性

通过掌握二维前缀和、二维差分和离散化技巧,可以高效解决各种二维矩阵问题。关键在于理解每种技巧的适用场景,以及合理的边界处理和空间优化策略。

引言

参照的是左程云的课程:https://space.bilibili.com/8888480/lists/3509640?type=series

本笔记是class047的内容,总结了一维差分与等差数列差分的核心思想和应用。差分技巧是处理区间修改问题的重要工具,特别适用于大量区间操作后的批量查询场景。

前置知识

在学习差分数组之前,需要掌握以下基础知识:

  • 数组的基本操作
  • 前缀和的概念与应用
  • 理解数组索引和边界处理

047【必备】一维差分与等差数列差分

核心概念

一维差分的基本思想

一维差分是一种优化区间修改操作的技巧:

  • 原理:通过维护一个差分数组,将区间修改转化为两个单点修改
  • 适用场景:多次区间修改,最后统一查询所有位置的值
  • 限制:不支持边操作边查询,需要先完成所有修改再构建最终数组

等差数列差分

等差数列差分是一维差分的扩展,用于处理区间内加等差数列的操作:

  • 核心特性:等差数列的二阶差分是常数
  • 应用场景:需要在区间内按等差数列规律增加数值
  • 实现方式:通过二阶差分数组进行操作,最后两次前缀和还原

题目一:航班预订统计

问题描述

这里有n个航班,它们分别从1到n进行编号。有一份航班预订表bookings,表中第i条预订记录bookings[i] = [firsti, lasti, seatsi]意味着在从firsti到lasti(包含firsti和lasti)的每个航班上预订了seatsi个座位。

请你返回一个长度为n的数组answer,里面的元素是每个航班预定的座位总数。

测试链接:https://leetcode.cn/problems/corporate-flight-bookings/

核心思想

使用差分数组优化区间修改操作:

  1. 差分数组构建:diff[i] 记录 ans[i] 相对于 ans[i-1] 的变化量
  2. 区间修改转化:对于预订 [first, last, seats]:
    • diff[first] += seats:从first开始增加seats
    • diff[last + 1] -= seats:从last+1开始撤销增加效应
  3. 结果还原:通过计算差分数组的前缀和得到最终结果ans[i] = ans[i-1] + diff[i]

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
class Solution:
def corpFlightBookings(self, bookings: List[List[int]], n: int) -> List[int]:
"""
使用差分数组优化区间修改操作
时间复杂度:O(m + n),空间复杂度:O(n)
"""
# 差分数组,长度 n+2 是为了方便处理边界,如 book[1]+1 可能达到 n+1
diff = [0] * (n + 2)

# 根据每个预订记录,更新差分数组
for first, last, seats in bookings:
diff[first] += seats
if last + 1 <= n: # 边界检查
diff[last + 1] -= seats

# 计算前缀和来还原最终的座位数数组
ans = [0] * n
# ans[0] 就是 diff[1] 的值 (因为航班从1开始编号)
ans[0] = diff[1]
for i in range(1, n):
# 当前航班的座位数 = 上一个航班的座位数 + 差分值
ans[i] = ans[i-1] + diff[i+1] # diff的索引比ans大1

return ans

算法分析

  • 时间复杂度:O(m + n),其中m是预订次数,n是航班数量
  • 空间复杂度:O(n)
  • 核心优势:将每次O(n)的区间修改优化为O(1)的两次单点修改

题目二:等差数列差分模板

问题描述

一开始1n范围上的数字都是0,一共有m个操作,每次操作为(l,r,s,e,d)表示在lr范围上依次加上首项为s、末项为e、公差为d的数列。m个操作做完之后,统计1~n范围上所有数字的最大值和异或和。

测试链接:https://www.luogu.com.cn/problem/P4231

过两遍前缀和
反向推导

核心思想

使用二阶差分处理等差数列的区间加操作:

  1. 数学原理:等差数列的二阶差分是常数
  2. 操作分解:在二阶差分数组上进行四个关键点修改
  3. 结果构建:通过两次前缀和运算还原最终数组

关键函数解析

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
def set_arithmetic_sequence(l, r, s, e, d):
"""
在二阶差分数组上进行修改,以实现对原数组的等差数列范围加。
这是通过数学推导得出的在二阶差分数组上的四个关键点修改。
"""
arr[l] += s #在起始位置加上首项
arr[l + 1] += d - s # 这确保了从位置l+1开始,一阶差分增加d(公差)
arr[r + 1] -= (d + e) #在区间结束后,需要"撤销"等差数列的影响,因为后续的数字不会再增加
arr[r + 2] += e #补偿操作,确保边界正确

def build():
"""
通过两次前缀和运算,从二阶差分数组还原出最终数组。等差数列有一个重要性质:二阶差分是常数
第一次前缀和:arr 从二阶差分数组变为一阶差分数组。
第二次前缀和:arr 从一阶差分数组变为最终的结果数组。
"""
# 第一次前缀和
for i in range(1, n + 2):
arr[i] += arr[i - 1]
# 第二次前缀和
for i in range(1, n + 1):
arr[i] += arr[i - 1]

完整实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
MAXN = 10000005
arr = [0] * MAXN
n, m = 0, 0

def main():
"""
核心思想:二阶差分 (Difference of Differences)
1. 对一个数组`a`进行范围`[l, r]`加一个常数`c`,可以在其一阶差分数组`b`上
通过`b[l]+=c`, `b[r+1]-=c`实现。
2. 对一个数组`a`进行范围`[l, r]`加一个等差数列,其变化在一阶差分数组`b`上表现为:
`b[l]`增加首项`s`,`b[l+1...r]`范围增加公差`d`,`b[r+1]`有一个特殊变化。
3. 这个“范围加常数”的操作,又可以被一个二阶差分数组`c`来优化。
4. `set`函数中的四次修改,就是将“加等差数列”这一复杂操作,
分解为在二阶差分数组`c`上的四个单点修改。
5. 所有修改完成后,对`c`做一次前缀和得到`b`,再对`b`做一次前缀和得到最终的`a`。
"""
global n, m
lines = sys.stdin.readlines()
line_iter = iter(lines)

while True:
try:
n_m_line = next(line_iter)
if not n_m_line: break
n, m = map(int, n_m_line.strip().split())

# 清零 arr 数组以处理多个测试用例
# 只需要清到可能被修改的最大位置即可,这里为了简单直接清一部分
max_r = 0

# 读取m个操作并更新二阶差分数组
ops = []
for _ in range(m):
l, r, s, e = map(int, next(line_iter).strip().split())
ops.append((l, r, s, e))
max_r = max(max_r, r)

for i in range(max_r + 3): # 清理数组
arr[i] = 0

for l, r, s, e in ops:
if r == l: # 公差为0的特殊情况
d = 0
else:
d = (e - s) // (r - l)
set_arithmetic_sequence(l, r, s, e, d)

# 还原最终数组
build()

# 计算最大值和异或和
max_val = 0
xor_sum = 0
for i in range(1, n + 1):
max_val = max(max_val, arr[i])
xor_sum ^= arr[i]

print(f"{xor_sum} {max_val}")

except StopIteration:
break

算法分析

  • 时间复杂度:O(m + n)
  • 空间复杂度:O(n)
  • 核心技巧:二阶差分 + 两次前缀和

题目三:水位高度计算

问题描述

一群人落水后求每个位置的水位高度。每个人落水会产生复杂的水波模式,需要计算所有水波叠加后的最终水位。

测试链接:https://www.luogu.com.cn/problem/P5026

问题三描述可视化
问题三不越界

核心思想

将复杂的水波描述分解为四个等差数列的叠加,使用OFFSET技巧处理负坐标:

  1. 水波分解:每次落水产生四个等差数列段
  2. 坐标处理:使用OFFSET避免负数索引问题
  3. 叠加计算:多次调用等差数列差分函数

关键函数

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
OFFSET = 30001  # 数值保护,防止索引越界

def fall(v, x):
"""
一个人落水,会产生四个等差数列的水波,调用四次set函数来模拟。
"""
set_arithmetic_sequence(x - 3 * v + 1, x - 2 * v, 1, v, 1)
set_arithmetic_sequence(x - 2 * v + 1, x, v - 1, -v, -1)
set_arithmetic_sequence(x + 1, x + 2 * v, -v + 1, v, 1)
set_arithmetic_sequence(x + 2 * v + 1, x + 3 * v - 1, v - 1, 1, -1)

def set_arithmetic_sequence(l, r, s, e, d):
"""
与上题完全相同的二阶差分修改函数,但所有索引都加上了 OFFSET。
OFFSET 技巧:
通过给所有位置索引加上一个大的偏移量,可以确保即使 `l` 是负数,
`l + OFFSET` 也是一个合法的正数数组下标,从而避免了复杂的边界条件判断。
"""
arr[l + OFFSET] += s
arr[l + 1 + OFFSET] += d - s
arr[r + 1 + OFFSET] -= d + e
arr[r + 2 + OFFSET] += e

def build():
"""
同样通过两次前缀和运算,从二阶差分数组还原出最终的水位高度数组。
"""
# 数组足够大,只需要计算到受影响的最右边界即可
# 简化处理,直接使用 m + OFFSET
for i in range(1, m + OFFSET * 2):
arr[i] += arr[i - 1]
for i in range(1, m + OFFSET * 2):
arr[i] += arr[i - 1]

完整实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
import sys
# 湖泊最大宽度
MAXN = 1000001
# 数值保护,防止索引越界
OFFSET = 30001
# 准备一个足够大的数组来容纳所有可能的位置
arr = [0] * (OFFSET + MAXN + OFFSET)
n, m = 0, 0

def main():
"""
核心思想:
1. 将题目中复杂的水波描述,分解为四个等差数列的叠加。
2. 使用与上一题完全相同的“二阶差分”技巧来处理多个等差数列的范围增加操作。
3. 使用 OFFSET 技巧来优雅地处理可能为负数的位置索引,避免边界判断。
4. 所有落水操作完成后,通过两次前缀和还原出每个位置的最终水位。
"""
global n, m
lines = sys.stdin.readlines()
line_iter = iter(lines)

while True:
try:
n_m_line = next(line_iter)
if not n_m_line: break
n, m = map(int, n_m_line.strip().split())

# 找到可能影响的最大范围,用于清理数组
max_coord = 0
ops = []
for _ in range(n):
v, x = map(int, next(line_iter).strip().split())
ops.append((v, x))
max_coord = max(max_coord, x + 3 * v)

for i in range(max_coord + OFFSET + 2):
arr[i] = 0

# 对每次落水,更新二阶差分数组
for v, x in ops:
fall(v, x)

# 还原最终水位
build()

# 收集并打印 1~m 位置的答案
# 正式位置 1...m 对应于 arr 数组中的 OFFSET+1...OFFSET+m
start = OFFSET + 1
result = [str(arr[i]) for i in range(start, start + m)]
print(" ".join(result))

except StopIteration:
break

算法分析

  • 时间复杂度:O(n + m)
  • 空间复杂度:O(n + OFFSET)
  • 核心技巧:OFFSET处理负坐标 + 复杂水波分解

差分技巧总结

1. 一维差分的应用场景

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
# 适用情况:
# 1. 大量区间修改操作
# 2. 最后统一查询所有位置
# 3. 不需要边操作边查询

# 基本操作:
def range_add(diff, l, r, val):
"""区间[l,r]增加val"""
diff[l] += val
diff[r + 1] -= val

def build_result(diff, n):
"""构建最终结果"""
result = [0] * n
result[0] = diff[0]
for i in range(1, n):
result[i] = result[i-1] + diff[i]
return result

2. 等差数列差分的核心原理

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
# 数学基础:
# 原数组:a[0], a[1], a[2], ...
# 一阶差分:b[i] = a[i] - a[i-1]
# 二阶差分:c[i] = b[i] - b[i-1]

# 等差数列性质:
# 等差数列的一阶差分是常数
# 等差数列的二阶差分是0(除了边界)

# 操作模板:
def arithmetic_sequence_add(arr, l, r, s, e, d):
"""在l~r范围加等差数列[s,s+d,s+2d,...,e]"""
arr[l] += s
arr[l + 1] += d - s
arr[r + 1] -= (d + e)
arr[r + 2] += e

3. 边界处理技巧

1
2
3
4
5
6
7
8
9
10
# OFFSET技巧:处理负坐标
OFFSET = 30001
real_index = coordinate + OFFSET

# 边界扩展:防止越界
arr = [0] * (n + 2) # 额外空间处理边界

# 范围检查
if r + 1 <= n:
diff[r + 1] -= val

复杂度分析对比

方法 区间修改 单点查询 区间查询 适用场景
暴力 O(n) O(1) O(n) 修改少,查询多
差分数组 O(1) O(n) O(n) 修改多,批量查询
线段树 O(log n) O(log n) O(log n) 边修改边查询

学习建议

1. 理解差分本质

  • 差分是前缀和的逆运算
  • 区间修改转化为端点修改
  • 适用于修改多查询少的场景

2. 掌握模板套路

  • 熟练掌握一维差分的基本模板
  • 理解等差数列差分的数学原理
  • 练习边界处理和特殊情况

3. 注意实现细节

  • 数组大小的合理设计
  • 索引边界的仔细处理
  • OFFSET技巧的灵活运用

4. 扩展应用

  • 二维差分矩阵
  • 树上差分
  • 线段树lazy标记的差分思想

5. 调试技巧

  • 验证差分数组的正确性
  • 检查前缀和构建过程
  • 测试边界情况和特殊输入

通过掌握差分数组的核心思想和实现技巧,可以高效解决各种区间修改问题。关键在于理解差分与前缀和的关系,以及合理的边界处理策略。

引言

参照的是左程云的课程:https://space.bilibili.com/8888480/lists/3509640?type=series

本笔记是class046的内容,总结了构建前缀信息的技巧来解决子数组相关问题。这类问题通过预处理前缀信息,结合哈希表等数据结构,可以将原本O(n²)或更高时间复杂度的问题优化到O(n)。

前置知识

在学习前缀信息技巧之前,需要掌握以下基础知识:

  • 讲解026 - 哈希表的用法
  • 数组基础操作和累加和概念
  • 基本的数学推导能力

046【必备】构建前缀信息的技巧-解决子数组相关问题

核心解题思路

前缀和的基本概念

前缀和是一种预处理技巧,通过构建辅助数组来快速计算任意区间的累加和:

1
2
3
4
5
6
# 前缀和数组构建
s = [0] * (len(nums) + 1) # 比原数组长1
for i in range(len(nums)):
s[i + 1] = s[i] + nums[i]

# 区间[left, right]的和 = s[right+1] - s[left]

前缀信息 + 哈希表的套路

解决子数组问题的通用套路:

  1. 构建前缀信息:根据问题需求构建前缀和、前缀状态等
  2. 设计哈希表:存储前缀信息的位置或次数
  3. 遍历求解:边计算前缀信息,边查询哈希表更新答案

题目一:前缀和数组 - 快速区间求和

问题描述

设计一个支持快速查询数组区间和的数据结构。

测试链接:https://leetcode.cn/problems/range-sum-query-immutable/

核心思想

通过预计算前缀和,实现O(1)时间复杂度的范围和查询:
通过预计算前缀和,实现O(1)时间复杂度的范围和查询。

  1. 创建一个比原数组长1的前缀和数组 s。
  2. s[i] 存储原数组 nums 从 0 到 i-1 位置的累加和。
  3. nums 数组从 left 到 right 的范围和,
    就可以通过 s[right+1] - s[left] 快速得到。
    s[right+1] 是 0…right 的和
    s[left] 是 0…left-1 的和
    两者相减即为 left…right 的和。

题目一暴力解法

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
import sys

arr = []
n, aim = 0, 0
# key : 某个前缀和
# value : 这个前缀和最早出现的位置
prefix_sum_map = {}

def compute():
"""
通过预计算前缀和,实现O(1)时间复杂度的范围和查询。
"""
prefix_sum_map.clear()
# 重要 : 0这个前缀和,在-1位置(一个数字也没有的时候),就存在了
# 这可以正确处理从0开始的子数组
prefix_sum_map[0] = -1
ans = 0
current_sum = 0
for i in range(n):
current_sum += arr[i]
# 查找是否存在一个 j,使得 0..j 的前缀和为 current_sum - aim
if (current_sum - aim) in prefix_sum_map:
j = prefix_sum_map[current_sum - aim]
ans = max(ans, i - j)

# 只记录每个前缀和第一次出现的位置
if current_sum not in prefix_sum_map:
prefix_sum_map[current_sum] = i
return ans

def main():
"""
处理输入和输出的主函数
"""
global n, aim, arr
# 高效读取所有输入行
lines = sys.stdin.readlines()
if not lines:
return

line_iter = iter(lines)
while True:
try:
line = next(line_iter)
if not line: break

n, aim = map(int, line.strip().split())
arr_line = next(line_iter)
arr = list(map(int, arr_line.strip().split()))

print(compute())

except StopIteration:
break

if __name__ == "__main__":
main()

算法分析

  • 预处理时间复杂度:O(n)
  • 查询时间复杂度:O(1)
  • 空间复杂度:O(n)

题目二:累加和为给定值的最长子数组

问题描述

给定一个无序数组arr,其中元素可正、可负、可0。给定一个整数aim,求arr所有子数组中累加和为aim的最长子数组长度。

测试链接:https://www.nowcoder.com/practice/36fb0fd3c656480c92b569258a1223d5

核心思想

使用前缀和 + 哈希表记录每个前缀和最早出现的位置:

  1. 遍历数组,计算到当前位置 i 的前缀和 s
  2. 如果存在位置 j,使得 (0...i的前缀和) - (0...j的前缀和) = aim
  3. 即 s - (0...j的前缀和) = aim,所以需要查找前缀和为 s - aim 的位置
  4. 为了让子数组最长,j 应该尽可能小,所以只记录每个前缀和首次出现的位置

题目二

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
import sys
from collections import defaultdict

def compute():
"""
计算累加和为aim的最长子数组长度
"""
prefix_sum_map = {}
# 重要:0这个前缀和,在-1位置(一个数字也没有的时候)就存在了
# 这可以正确处理从0开始的子数组
prefix_sum_map[0] = -1

ans = 0
current_sum = 0
for i in range(n):
current_sum += arr[i]
# 查找是否存在一个 j,使得 0..j 的前缀和为 current_sum - aim
if (current_sum - aim) in prefix_sum_map:
j = prefix_sum_map[current_sum - aim]
ans = max(ans, i - j)

# 只记录每个前缀和第一次出现的位置
if current_sum not in prefix_sum_map:
prefix_sum_map[current_sum] = i
return ans
### 类似上一题那样定义main和继续处理

算法分析

  • 时间复杂度:O(n)
  • 空间复杂度:O(n)
  • 核心技巧:记录最早位置 + 前缀和差值

题目三:累加和为给定值的子数组个数

问题描述

返回无序数组中累加和为给定值的子数组个数。

测试链接:https://leetcode.cn/problems/subarray-sum-equals-k/

核心思想

与寻找最长子数组类似,但哈希表存储的是前缀和出现的次数:

  • prefix_sum_map[s - aim] 的值代表有多少个合法的子数组可以在 i 位置结尾
  • 累加这些次数得到总的子数组个数

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
from typing import List
from collections import defaultdict

class Solution:
def subarraySum(self, nums: List[int], aim: int) -> int:
"""
计算累加和为aim的子数组个数。
核心思想:
与寻找最长子数组类似,但哈希表的用途不同。
1. 这里的哈希表 `prefix_sum_map` 存储的是 {前缀和 -> 该前缀和出现的次数}。
2. 遍历数组,计算到位置 `i` 的前缀和 `s`。
3. 同样,我们寻找 `s - aim` 这个目标前缀和。
4. 哈希表中 `prefix_sum_map[s - aim]` 的值,就代表了有多少个合法的子数组
可以在 `i` 位置结尾。我们将这个次数累加到 `ans` 中。
5. 遍历完 `i` 后,更新 `s` 在哈希表中的出现次数。
"""
# key: 前缀和, value: 该前缀和出现的次数
# 使用 defaultdict 可以简化代码
prefix_sum_map = defaultdict(int)

# 0这个前缀和,在没有任何数字的时候,已经有1次了
# 空集也算一个子集
prefix_sum_map[0] = 1

ans = 0
current_sum = 0
for num in nums:
# current_sum : 0...i前缀和
current_sum += num

# 查找有多少个 j 满足 0..j 的前缀和为 current_sum - aim
count = prefix_sum_map[current_sum - aim]
ans += count

# 更新当前前缀和的出现次数
prefix_sum_map[current_sum] += 1

return ans

算法分析

  • 时间复杂度:O(n)
  • 空间复杂度:O(n)
  • 核心技巧:记录出现次数 + 累加计数

题目四:正数和负数个数相等的最长子数组

问题描述

给定一个无序数组arr,其中元素可正、可负、可0。求arr所有子数组中正数与负数个数相等的最长子数组的长度。

测试链接:https://www.nowcoder.com/practice/545544c060804eceaed0bb84fcd992fb

核心思想

问题转化:将原数组进行转换,正数变为1,负数变为-1,0保持为0。在新数组中,如果一个子数组的累加和为0,就意味着其中1和-1的数量相等,对应原数组中正数和负数数量相等。

之后算法就和”累加和为0的最长子数组”完全一样。

题目四

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
def compute():
"""
核心思想:
1. 这个问题可以转化为“累加和为0的最长子数组长度”问题。
2. 将原数组进行转换:正数变为1,负数变为-1,0保持为0。
3. 在新数组中,如果一个子数组的累加和为0,
就意味着其中的1和-1的数量相等,这正好对应原数组中正数和负数数量相等。
4. 之后,算法就和“累加和为aim的最长子数组”完全一样,只是这里的aim固定为0。
"""
prefix_sum_map.clear()
prefix_sum_map[0] = -1
ans = 0
current_sum = 0
for i in range(n):
current_sum += transformed_arr[i]

# 寻找目标前缀和 (current_sum - 0)
if current_sum in prefix_sum_map:
j = prefix_sum_map[current_sum]
ans = max(ans, i - j)

if current_sum not in prefix_sum_map:
prefix_sum_map[current_sum] = i

return ans

def main():
global n, transformed_arr
lines = sys.stdin.readlines()
if not lines:
return

line_iter = iter(lines)
while True:
try:
line = next(line_iter)
if not line: break

n = int(line.strip())
arr_line = next(line_iter)
original_arr = list(map(int, arr_line.strip().split()))

# 转换数组
transformed_arr = [0] * n
for i in range(n):
num = original_arr[i]
if num > 0:
transformed_arr[i] = 1
elif num < 0:
transformed_arr[i] = -1
# 0 保持为 0

print(compute())

except StopIteration:
break

if __name__ == "__main__":
main()

算法分析

  • 时间复杂度:O(n)
  • 空间复杂度:O(n)
  • 核心技巧:问题转化 + 前缀和

题目五:表现良好的最长时间段

问题描述

给你一份工作时间表 hours,上面记录着某一位员工每天的工作小时数。当员工一天中的工作小时数大于8小时的时候,那么这一天就是劳累的一天。表现良好的时间段,意味在这段时间内,「劳累的天数」是严格大于不劳累的天数。请你返回表现良好时间段的最大长度。

测试链接:https://leetcode.cn/problems/longest-well-performing-interval/

核心思想

问题转化:将 >8 小时的天记为 +1,<=8 小时的天记为 -1。问题变成了”求和为正数的最长子数组长度”。

关键处理:

  1. 如果当前前缀和 > 0,说明从开头到当前位置整个时间段都表现良好
  2. 如果前缀和 <= 0,需要找到最早的位置 j,使得 j+1 到 i 的子数组和 > 0
  3. 这等价于寻找前缀和为 current_sum - 1 的最早位置

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
from typing import List

class Solution:
def longestWPI(self, hours: List[int]) -> int:
"""
核心思想:
1. 将问题进行转换:将 >8 小时的天记为 +1,<=8 小时的天记为 -1。
问题就变成了“求和为正数的最长子数组长度”。
2. 使用前缀和与哈希表。我们遍历数组,计算当前的前缀和 `current_sum`。
3. 哈希表 `prefix_sum_map` 存储 {前缀和 -> 该和首次出现的位置}。
4. 如果当前前缀和 `current_sum` > 0,说明从开头到当前位置的整个时间段都是
表现良好的,长度为 `i + 1`,这是一个候选答案。
5. 如果 `current_sum` <= 0,我们需要找到一个最早的位置 `j`,使得 `j+1` 到 `i` 的
子数组和 > 0。这等价于 `current_sum - prefix_sum[j] > 0`,
即 `current_sum > prefix_sum[j]`。
为了使 `i - j` 最长,我们需要 `j` 最早,并且 `prefix_sum[j]` 尽可能小。
我们寻找 `current_sum - 1` 这个前缀和最早出现的位置,因为它能保证
`prefix_sum[j]` 严格小于 `current_sum`,从而找到一个候选的更长子数组。
"""
# 某个前缀和,最早出现的位置
prefix_sum_map = {}
# 0这个前缀和,最早出现在-1,一个数也没有的时候
prefix_sum_map[0] = -1

ans = 0
current_sum = 0
for i, h in enumerate(hours):
current_sum += 1 if h > 8 else -1

# 如果当前前缀和 > 0,说明从0到i的整个子数组都是一个解
if current_sum > 0:
ans = i + 1
else:
# current_sum <= 0
# 我们寻找是否存在一个更早的前缀和,值为 current_sum - 1
# 如果存在,就能构成一个和为1的子数组,这也是一个解
if (current_sum - 1) in prefix_sum_map:
ans = max(ans, i - prefix_sum_map[current_sum - 1])

# 只记录每个前缀和第一次出现的位置,因为我们要找的是最早的位置
if current_sum not in prefix_sum_map:
prefix_sum_map[current_sum] = i

return ans

算法分析

  • 时间复杂度:O(n)
  • 空间复杂度:O(n)
  • 核心技巧:转化为正数和问题 + 特殊查找逻辑

题目六:使数组和能被P整除

问题描述

给你一个正整数数组 nums,请你移除最短子数组(可以为空),使得剩余元素的和能被 p 整除。不允许将整个数组都移除。请你返回你需要移除的最短子数组的长度,如果无法满足题目要求,返回 -1。

测试链接:https://leetcode.cn/problems/make-sum-divisible-by-p/

核心思想

关键观察:设总和为 total,我们需要移除一个子数组使得 (total - 子数组和) % p = 0。

设 mod = total % p,则需要移除的子数组和满足 子数组和 % p = mod。

使用前缀和余数 + 哈希表记录最晚出现的位置(为了让子数组最短)

题目六核心概念
题目六-问题转化

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
from typing import List

class Solution:
def minSubarray(self, nums: List[int], p: int) -> int:
"""
核心思想:
1. 首先计算整个数组的和对 p 取模,得到 `mod`。
如果 `mod == 0`,则无需移除任何元素,返回 0。
2. 我们的目标是移除一个子数组,其和对 p 取模的结果也等于 `mod`。
这样 `(总和 - 子数组和) % p` 就会等于 `(mod - mod) % p = 0`。
3. 问题转化为:寻找和对 p 取模为 `mod` 的最短子数组。
4. 使用前缀和与哈希表。哈希表 `prefix_mod_map` 存储 {前缀和模p -> 该模值最晚出现的位置}。
我们需要最晚的位置,是为了让 `i - j` 这个子数组长度最短。
5. 遍历数组,计算到 `i` 的前缀和模 `p` 的值 `current_mod`。
6. 我们需要寻找一个 `j`,使得 `(i...j)` 子数组的和模 `p` 为 `mod`。
这等价于 `(prefix_mod[i] - prefix_mod[j-1]) % p == mod`。
变形得 `prefix_mod[j-1] == (current_mod - mod + p) % p`。
7. 我们在哈希表中查找这个目标 `find` 值,如果找到,就更新最短子数组长度。
"""
# 整体余数
mod = sum(nums) % p

# 如果总和本身就能被p整除,无需移除
if mod == 0:
return 0

# key : 前缀和%p的余数
# value : 最晚出现的位置
prefix_mod_map = {0: -1}
ans = len(nums)

current_mod = 0
for i, num in enumerate(nums):
# 0...i这部分的余数
current_mod = (current_mod + num) % p

# 我们要找的目标前缀和余数 find
# find = (current_mod - mod) % p
# +p 是为了处理负数情况
find = (current_mod - mod + p) % p

if find in prefix_mod_map:
ans = min(ans, i - prefix_mod_map[find])

# 存入当前前缀和余数出现的位置
prefix_mod_map[current_mod] = i

# 如果ans等于原数组长度,说明我们必须移除整个数组,按题意返回-1
return ans if ans < len(nums) else -1

算法分析

  • 时间复杂度:O(n)
  • 空间复杂度:O(p),最多存储p个不同的余数
  • 核心技巧:取模运算 + 最晚位置

题目七:每个元音包含偶数次的最长子串

问题描述

给你一个字符串 s,请你返回满足以下条件的最长子字符串的长度:每个元音字母,即 ‘a’,’e’,’i’,’o’,’u’ 在子字符串中都恰好出现了偶数次。

测试链接:https://leetcode.cn/problems/find-the-longest-substring-containing-vowels-in-even-counts/

核心思想

状态压缩:用5位二进制数表示五个元音字母出现次数的奇偶性。

  • 例如:01100 表示 ‘e’ 和 ‘i’ 出现了奇数次,’a’,’o’,’u’出现了偶数次
  • 如果两个位置的状态码相同,说明中间子串中每个元音都出现了偶数次

关键是找到相同状态码的最远距离。

题目七

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
class Solution:
def findTheLongestSubstring(self, s: str) -> int:
"""
核心思想:
1. 我们只关心五个元音字母'a,e,i,o,u'出现次数的奇偶性。
这可以用一个5位的二进制数(状态码/bitmask)来表示。
例如,二进制 `01100` 表示 'e' 和 'i' 出现了奇数次,'a','o','u'出现了偶数次。
2. 遍历字符串,维护一个从开头到当前位置的`status`状态码。
遇到一个元音,就用异或(XOR)操作翻转其对应的位。
3. 问题转化为:找到两个位置 `i` 和 `j`,使得它们的前缀状态码相同。
如果 `prefix_status[i] == prefix_status[j]`,那么 `j+1` 到 `i` 的子串中,
所有元音的奇偶性变化都抵消了,即每个元音都出现了偶数次。
4. 我们需要找到最长的这样的子串,即最大化 `i - j`。
5. 使用一个数组 `status_map` 记录每个状态码第一次出现的位置。
`status_map[status] = earliest_index`。
6. 初始化 `status_map[0] = -1`,表示初始状态(0次,偶数)出现在-1位置。
"""
n = len(s)
# 用一个数组来存储每种状态第一次出现的位置
# 状态码范围是 0 (00000) 到 31 (11111)
status_map = [-2] * 32 #-2是初始值,表示这个状态码没有出现过

# 初始状态0 (所有元音都是偶数次0) 出现在-1位置
status_map[0] = -1

ans = 0
status = 0
vowel_map = {'a': 0, 'e': 1, 'i': 2, 'o': 3, 'u': 4}

for i, char in enumerate(s):
# status : 0....i-1字符串上,aeiou的奇偶性

# 检查当前字符是否为元音,并更新状态
if char in vowel_map:
move = vowel_map[char] # 在vowel_map里看,a是0,e是1,i是2,o是3,u是4
status ^= (1 << move) # status是0...i-1字符串上,aeiou的奇偶性,用异或操作翻转其对应的位

# status: 0....i字符串上,aeiou的奇偶性,是个五位的二进制数

# 检查当前状态是否之前出现过
if status_map[status] != -2:
# 如果出现过,计算长度并更新最大值
ans = max(ans, i - status_map[status])
else:
# 如果是第一次出现,记录当前位置
status_map[status] = i

return ans

算法分析

  • 时间复杂度:O(n)
  • 空间复杂度:O(1),状态数组固定大小32
  • 核心技巧:状态压缩 + 位运算

核心套路总结

1. 前缀信息构建模板

1
2
3
4
5
6
7
8
9
10
# 基础前缀和
prefix_sum = [0] * (n + 1)
for i in range(n):
prefix_sum[i + 1] = prefix_sum[i] + nums[i]

# 前缀状态(如奇偶性、余数等)
prefix_state = initial_state
for i in range(n):
prefix_state = update_state(prefix_state, nums[i])
# 处理当前状态

2. 哈希表设计策略

问题类型 哈希表存储内容 选择策略
最长子数组 {前缀信息 → 最早位置} 只存首次出现
最短子数组 {前缀信息 → 最晚位置} 覆盖存储
子数组计数 {前缀信息 → 出现次数} 累加计数

3. 边界条件处理

1
2
3
4
5
6
# 重要:处理从0开始的子数组
hash_map[initial_value] = -1

# 避免重复计算
if condition_to_update:
hash_map[key] = value

4. 问题转化技巧

1
2
3
4
5
6
7
8
# 正负数相等 → 转化为累加和为0
transform = lambda x: 1 if x > 0 else (-1 if x < 0 else 0)

# 工作时间 → 转化为劳累天数大于非劳累天数
transform = lambda x: 1 if x > 8 else -1

# 元音奇偶性 → 状态压缩
state ^= (1 << vowel_index) # 异或翻转对应位

复杂度分析总结

题目类型 时间复杂度 空间复杂度 核心数据结构
前缀和查询 O(1) 查询 O(n) 前缀和数组
最长子数组 O(n) O(n) 哈希表
子数组计数 O(n) O(n) 哈希表
状态压缩 O(n) O(1) 固定数组

学习建议

1. 掌握核心思想

  • 理解前缀信息的作用:将子数组问题转化为两个前缀的差值问题
  • 掌握哈希表的不同用法:位置记录 vs 次数统计
  • 熟练运用问题转化技巧

2. 注意实现细节

  • 初始状态的正确设置(如 map[0] = -1)
  • 哈希表更新时机的选择
  • 边界条件的处理

3. 练习变形题目

  • 不同的累加和目标值
  • 不同的转化规则
  • 多种约束条件的组合

4. 优化技巧

  • 状态压缩减少空间占用
  • 合理选择数据结构
  • 避免不必要的重复计算

通过掌握前缀信息 + 哈希表的解题套路,可以高效解决各种子数组相关问题。关键在于正确构建前缀信息,合理设计哈希表存储策略,以及灵活运用问题转化技巧。

引言

参照的是左程云的课程:https://space.bilibili.com/8888480/lists/3509640?type=series

本笔记是class044和class045的内容,详细介绍了前缀树(Trie树)的原理和代码实现并总结了前缀树(Trie)在实际算法题目中的应用。前缀树是一种专门用于处理字符串前缀查询的高效数据结构,在搜索引擎、自动补全、拼写检查等场景中有广泛应用。


044【必备】前缀树原理和代码详解

前置知识

在学习前缀树之前,需要掌握以下基础知识:

  • 讲解008-数据结构分类
  • 讲解017-二叉树基本概念
  • 讲解019-处理输入和输出-推荐静态空间的实现
  • 讲解026-哈希表的使用

前缀树基本概念

什么是前缀树

前缀树(Trie Tree),又叫字典树,是一种树形数据结构:

  • 每个样本都从头节点开始,根据前缀字符或前缀数字建出来的一棵大树
  • 没有路就新建节点;已经有路了,就复用节点
  • 每个节点代表一个字符,从根到某个节点的路径构成一个前缀

前缀树的特点

使用场景:需要根据前缀信息来查询的场景

优点:

  • 根据前缀信息选择树上的分支,可以节省大量的时间
  • 查询效率高,时间复杂度为O(m),其中m为字符串长度

缺点:

  • 比较浪费空间,空间复杂度与总字符数量和字符种类相关
  • 需要预先知道字符集的范围

定制信息:

  • pass:有多少个单词经过了这个节点
  • end:有多少个单词以这个节点结尾
  • 节点的子节点可以用数组或哈希表/字典来存储

核心节点结构

每个前缀树节点通常包含以下信息:

1
2
3
4
5
class TrieNode:
def __init__(self):
self.pass = 0 # 有多少个单词经过了这个节点
self.end = 0 # 有多少个单词以这个节点结尾
self.nexts = [] # 指向子节点的链接(数组或字典)

前缀树形式

实现方式一:用类描述(不推荐)

测试链接

子节点用数组实现

适用于字符集固定且较小的情况(如26个小写英文字母):

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
class Trie1:
"""
提交时把类名、构造方法改为Trie
Trie树的实现,子节点用固定长度的数组存储。
适用于字符集固定且较小的情况(如26个小写英文字母)。
"""
class _TrieNode:
def __init__(self):
# pass: 有多少个单词经过了这个节点
self.pas = 0
# end: 有多少个单词以这个节点结尾
self.end = 0
# nexts: 指向26个可能的子节点的链接,是一个小数组
self.nexts = [None] * 26

def __init__(self):
"""
初始化Trie树,创建一个空的根节点。
"""
self._root = self._TrieNode()

def insert(self, word: str):
"""
向前缀树中插入一个单词。
"""
node = self._root
node.pas += 1
# 从左往右遍历字符
for char in word:
# 由字符,对应成走向哪条路 (0-25)
path = ord(char) - ord('a') # ord获取char的ASCII码,a的ASCII码是97
# 检查这个字符的路径是否已经存在节点
if not node.nexts[path]:
node.nexts[path] = self._TrieNode() # 如果path位置为空,则创建一个新节点
node = node.nexts[path]
node.pas += 1
node.end += 1

def erase(self, word: str):
"""
如果之前word插入过前缀树,那么此时删掉一次。
如果之前word没有插入过前缀树,那么什么也不做。
"""
if self.countWordsEqualTo(word) > 0: # 先用countWordsEqualTo方法检查word是否存在
node = self._root
node.pas -= 1
for char in word:
path = ord(char) - ord('a')
# 如果删除后,路径上的节点的pass值为0,说明没有其他单词经过此路
# 可以直接将后续节点删除(在Python中由垃圾回收处理)
node.nexts[path].pas -= 1
if node.nexts[path].pas == 0:
node.nexts[path] = None
return
node = node.nexts[path]
node.end -= 1

def countWordsEqualTo(self, word: str) -> int:
"""
查询前缀树里,word单词出现了几次。
"""
node = self._root
for char in word:
path = ord(char) - ord('a')
if not node.nexts[path]:
return 0
node = node.nexts[path] # 循环一次,node就走到下一个节点
return node.end

def countWordsStartingWith(self, pre: str) -> int:
"""
查询前缀树里,有多少单词以pre做前缀。
"""
node = self._root
for char in pre:
path = ord(char) - ord('a')
if not node.nexts[path]:
return 0
node = node.nexts[path]
return node.pas

子节点用哈希表实现

适用于字符集不固定或非常大的情况,更节省空间:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
class Trie2:
"""
Trie树的实现,子节点用字典存储。
适用于字符集不固定或非常大的情况,更节省空间。
"""
class _TrieNode:
def __init__(self):
self.pas = 0
self.end = 0
# nexts: 存储字符到子节点的映射
self.nexts = {}

def __init__(self):
self._root = self._TrieNode()

def insert(self, word: str):
node = self._root
node.pas += 1
for char in word:
if char not in node.nexts:
node.nexts[char] = self._TrieNode()
node = node.nexts[char]
node.pas += 1
node.end += 1

def erase(self, word: str):
if self.countWordsEqualTo(word) > 0:
node = self._root
node.pas -= 1
for char in word:
next_node = node.nexts[char]
next_node.pas -= 1
if next_node.pas == 0:
# 如果pass为0,直接从字典中移除该路径
node.nexts.pop(char)
return
node = next_node
node.end -= 1

def countWordsEqualTo(self, word: str) -> int:
node = self._root
for char in word:
if char not in node.nexts:
return 0
node = node.nexts[char]
return node.end

def countWordsStartingWith(self, pre: str) -> int:
node = self._root
for char in pre:
if char not in node.nexts:
return 0
node = node.nexts[char]
return node.pas

实现方式二:静态数组实现(推荐)

核心思想

抛弃节点对象的概念,将所有节点信息存储在几个大的全局数组中:

  • 使用一个整数 cnt 作为节点编号或索引
  • tree[i][j]:表示编号为 i 的节点的第 j 条路(对应某个字符)指向的子节点的编号
  • end[i]:表示以编号为 i 的节点结尾的单词数量
  • pas[i]:表示经过编号为 i 的节点的单词数量

这种方式内存是静态分配的,且数据在内存中连续,通常有更好的缓存性能。

静态前缀树
打散位信息

测试链接

完整实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
import sys

# 如果将来增加了数据量,就改大这个值
MAXN = 150001

# 全局变量模拟 Java 的静态变量
tree = [[0] * 26 for _ in range(MAXN)]
end = [0] * MAXN
pas = [0] * MAXN
cnt = 0

def build():
"""
初始化/重置Trie。根节点编号为1,总节点数从1开始。
"""
global cnt
cnt = 1

def insert(word: str):
"""
向前缀树中插入一个单词。
"""
global cnt
cur = 1
pas[cur] += 1 # pas[cur]:节点 cur 被经过的次数
for char in word:
path = ord(char) - ord('a')
if tree[cur][path] == 0: # tree[cur][path]:邻接表的数组实现,记录了从节点 cur 出发,沿着字符 path 能到达的下一个节点
# 如果路径不存在,创建一个新节点
cnt += 1
tree[cur][path] = cnt
cur = tree[cur][path]
pas[cur] += 1
end[cur] += 1

def search(word: str) -> int:
"""
查询一个单词在前缀树中出现的次数。
"""
cur = 1
for char in word:
path = ord(char) - ord('a')
if tree[cur][path] == 0:
return 0
cur = tree[cur][path]
return end[cur]

def prefix_number(pre: str) -> int:
"""
查询以 pre 为前缀的单词数量。
"""
cur = 1
for char in pre:
path = ord(char) - ord('a')
if tree[cur][path] == 0:
return 0
cur = tree[cur][path]
return pas[cur]

def delete(word: str):
"""
从前缀树中删除一个单词。
"""
if search(word) > 0:
cur = 1
# 根节点的 pass 值减1
pas[cur] -= 1
for char in word:
path = ord(char) - ord('a')
# 路径上节点的 pass 值减1
pas[tree[cur][path]] -= 1
if pas[tree[cur][path]] == 0:
# 如果 pass 减到0,说明此路径不再被任何单词使用,可以删除
tree[cur][path] = 0
return
cur = tree[cur][path]
# 最后一个节点的 end 值减1
end[cur] -= 1

def clear():
"""
清空Trie树,为下一个测试用例做准备。
"""
global tree, end, pas
for i in range(1, cnt + 1):
for j in range(26):
tree[i][j] = 0
end[i] = 0
pas[i] = 0

def main():
"""
处理输入输出的主函数。
"""
lines = sys.stdin.readlines()
if not lines:
return

line_iter = iter(lines)

# 持续读取直到没有输入
while True:
try:
# 为每个测试用例重置/构建Trie
build()

m_line = next(line_iter) # next获得迭代器里获得下一个对象
if not m_line: continue
m = int(m_line.strip())

for _ in range(m):
splits = next(line_iter).strip().split(" ")
op = int(splits[0])
word = splits[1]

if op == 1:
insert(word)
elif op == 2:
delete(word)
elif op == 3:
print("YES" if search(word) > 0 else "NO")
elif op == 4:
print(prefix_number(word))

# 清理本次用例的数据(虽然对于某些OJ,不清理也行,因为是新进程)
clear()

except StopIteration:
break

if __name__ == "__main__":
main()

前缀树的基本操作

1. 插入操作 (Insert)

1
2
3
4
5
6
7
8
9
10
11
12
13
def insert(word: str):
"""插入一个单词到前缀树中"""
node = root
node.pass += 1 # 根节点被经过

for char in word:
path = ord(char) - ord('a') # 计算字符对应的路径
if not node.nexts[path]:
node.nexts[path] = TrieNode() # 创建新节点
node = node.nexts[path] # 移动到下一个节点
node.pass += 1 # 更新经过次数

node.end += 1 # 标记单词结尾

时间复杂度:O(m),其中m是单词长度
空间复杂度:O(m),最坏情况下需要创建m个新节点

1
2
3
4
5
6
7
8
9
10
11
def search(word: str) -> int:
"""查找单词在前缀树中的出现次数"""
node = root

for char in word:
path = ord(char) - ord('a')
if not node.nexts[path]:
return 0 # 路径不存在,单词不在树中
node = node.nexts[path]

return node.end # 返回以此节点结尾的单词数量

时间复杂度:O(m)
空间复杂度:O(1)

1
2
3
4
5
6
7
8
9
10
11
def countWordsStartingWith(prefix: str) -> int:
"""查询以prefix为前缀的单词数量"""
node = root

for char in prefix:
path = ord(char) - ord('a')
if not node.nexts[path]:
return 0
node = node.nexts[path]

return node.pass # 返回经过此节点的单词数量

时间复杂度:O(m)
空间复杂度:O(1)

4. 删除操作 (Delete)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
def delete(word: str):
"""从前缀树中删除一个单词"""
if search(word) == 0:
return # 单词不存在,无需删除

node = root
node.pass -= 1

for char in word:
path = ord(char) - ord('a')
next_node = node.nexts[path]
next_node.pass -= 1

if next_node.pass == 0:
# 如果经过次数为0,删除整个分支
node.nexts[path] = None
return

node = next_node

node.end -= 1 # 减少结尾标记

时间复杂度:O(m)
空间复杂度:O(1)

前缀树的应用场景

1. 自动补全

前缀树非常适合实现自动补全功能:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
def autocomplete(prefix: str, max_suggestions: int = 10) -> List[str]:
"""根据前缀返回自动补全建议"""
node = root

# 找到前缀对应的节点
for char in prefix:
path = ord(char) - ord('a')
if not node.nexts[path]:
return [] # 前缀不存在
node = node.nexts[path]

# 从该节点开始收集所有单词
suggestions = []
_collect_words(node, prefix, suggestions, max_suggestions)
return suggestions

def _collect_words(node, current_prefix, suggestions, max_suggestions):
"""递归收集以当前前缀开始的所有单词"""
if len(suggestions) >= max_suggestions:
return

if node.end > 0:
suggestions.append(current_prefix)

for i in range(26):
if node.nexts[i]:
next_char = chr(i + ord('a'))
_collect_words(node.nexts[i], current_prefix + next_char,
suggestions, max_suggestions)

2. 拼写检查

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
def spell_check(word: str, max_distance: int = 1) -> List[str]:
"""返回与给定单词编辑距离在max_distance内的所有单词"""
suggestions = []
_find_similar_words(root, "", word, 0, max_distance, suggestions)
return suggestions

def _find_similar_words(node, current_word, target, distance, max_distance, suggestions):
"""使用动态规划找到相似单词"""
if distance > max_distance:
return

if node.end > 0 and len(current_word) == len(target):
if distance <= max_distance:
suggestions.append(current_word)

# 递归遍历所有可能的路径
for i in range(26):
if node.nexts[i]:
next_char = chr(i + ord('a'))
# 计算新的编辑距离
new_distance = distance
if len(current_word) < len(target) and target[len(current_word)] != next_char:
new_distance += 1

_find_similar_words(node.nexts[i], current_word + next_char,
target, new_distance, max_distance, suggestions)

3. 单词频率统计

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
def get_word_frequency_stats():
"""获取前缀树中的单词频率统计"""
stats = {}
_collect_frequencies(root, "", stats)
return stats

def _collect_frequencies(node, current_word, stats):
"""递归收集所有单词及其频率"""
if node.end > 0:
stats[current_word] = node.end

for i in range(26):
if node.nexts[i]:
next_char = chr(i + ord('a'))
_collect_frequencies(node.nexts[i], current_word + next_char, stats)

复杂度分析总结

操作 时间复杂度 空间复杂度 说明
插入 O(m) O(1) m为单词长度,使用预分配的静态数组
查找 O(m) O(1) m为单词长度
前缀查询 O(m) O(1) m为前缀长度
删除 O(m) O(1) m为单词长度
自动补全 O(m + k) O(h + k) m=前缀长度,k=返回结果总字符数,h=树最大深度

空间复杂度(整体):O(ALPHABET_SIZE × N × M)

  • ALPHABET_SIZE:字符集大小(如26)
  • N:插入的单词数量
  • M:平均单词长度

优化技巧和注意事项

1. 内存优化

压缩前缀树(Compressed Trie):

  • 将只有一个子节点的路径压缩成一条边
  • 节省空间,但增加了实现复杂度

数组 vs 哈希表选择:

  • 字符集固定且较小:使用数组
  • 字符集大或不确定:使用哈希表

2. 性能优化

静态数组实现:

1
2
3
# 推荐使用静态数组,避免频繁的内存分配
MAXN = 150001
tree = [[0] * 26 for _ in range(MAXN)]

批量操作:

1
2
3
4
def batch_insert(words: List[str]):
"""批量插入,减少函数调用开销"""
for word in words:
insert(word)

3. 扩展功能

支持通配符查询:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
def wildcard_search(pattern: str) -> List[str]:
"""支持'.'作为通配符的查询"""
results = []
_wildcard_dfs(root, pattern, 0, "", results)
return results

def _wildcard_dfs(node, pattern, index, current_word, results):
if index == len(pattern):
if node.end > 0:
results.append(current_word)
return

char = pattern[index]
if char == '.':
# 通配符,尝试所有可能的字符
for i in range(26):
if node.nexts[i]:
next_char = chr(i + ord('a'))
_wildcard_dfs(node.nexts[i], pattern, index + 1,
current_word + next_char, results)
else:
# 普通字符
path = ord(char) - ord('a')
if node.nexts[path]:
_wildcard_dfs(node.nexts[path], pattern, index + 1,
current_word + char, results)

实战应用示例

LeetCode相关题目

  1. 208. 实现 Trie (前缀树):基础的前缀树实现
  2. 211. 添加与搜索单词:支持通配符的前缀树
  3. 212. 单词搜索 II:在二维网格中搜索单词
  4. 421. 数组中两个数的最大异或值:使用前缀树优化位运算
  5. 648. 单词替换:使用前缀树实现单词替换

工程实践建议

  1. 选择合适的实现方式:

    • 简单应用:使用类实现
    • 高性能要求:使用静态数组
    • 内存敏感:使用哈希表
  2. 内存管理:

    • 及时清理不需要的节点
    • 考虑使用对象池减少GC压力
  3. 并发安全:

    • 读写分离
    • 使用读写锁
    • 考虑无锁数据结构

总结

前缀树是一种强大的字符串处理数据结构,特别适合:

  • 前缀查询:快速找到所有具有特定前缀的字符串
  • 自动补全:实现搜索建议功能
  • 拼写检查:找到相似的单词
  • 字符串匹配:高效的模式匹配

通过合理选择实现方式和优化策略,前缀树可以在保持高效性能的同时,提供丰富的字符串操作功能。在实际应用中,需要根据具体的使用场景选择最适合的实现方案。


045【必备】前缀树的相关题目

前置知识

在学习前缀树相关题目之前,需要掌握以下基础知识:

  • 讲解044:前缀树原理和代码详解-静态空间的方式实现
  • 基本的字符串操作和递归思想
  • 深度优先搜索(DFS)的基本概念

前缀树基础回顾

核心数据结构

1
2
3
4
5
6
7
8
9
10
# 前缀树的全局变量设计
MAXN = 2000001 # 根据题目数据规模调整

# tree[i][j] 表示编号为i的节点,走向字符j的下一个节点编号
tree = [[0] * 字符集大小 for _ in range(MAXN)]
# pas[i] 表示编号为i的节点被多少个字符串经过
pas = [0] * MAXN
# end[i] 表示编号为i的节点是否为某个字符串的结尾
end = [0] * MAXN # 或存储具体的字符串
cnt = 0 # 节点计数器

基本操作模板

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
def build():
"""初始化Trie,根节点编号为1"""
global cnt
cnt = 1

def insert(word: str):
"""将字符串插入Trie"""
global cnt
cur = 1
pas[cur] += 1
for char in word:
path = get_path(char) # 将字符映射到路径索引
if tree[cur][path] == 0:
cnt += 1
tree[cur][path] = cnt
cur = tree[cur][path]
pas[cur] += 1
end[cur] = word # 或设置为True

def search(word: str) -> bool:
"""搜索字符串是否存在"""
cur = 1
for char in word:
path = get_path(char)
if tree[cur][path] == 0:
return False
cur = tree[cur][path]
return end[cur] is not None

def count_prefix(prefix: str) -> int:
"""计算以prefix为前缀的字符串数量"""
cur = 1
for char in prefix:
path = get_path(char)
if tree[cur][path] == 0:
return 0
cur = tree[cur][path]
return pas[cur]

题目一:接头密匙(差值序列匹配)

问题描述

牛牛和他的朋友们约定了一套接头密匙系统,用于确认彼此身份。密匙由一组数字序列表示,两个密匙被认为是一致的,如果满足以下条件:

  • 密匙 b 的长度不超过密匙 a 的长度
  • 对于任意 0 <= i < length(b),有 b[i+1] - b[i] == a[i+1] - a[i]

现在给定了m个密匙 b 的数组,以及n个密匙 a 的数组,请你返回一个长度为 m 的结果数组 ans,表示每个密匙b都有多少一致的密匙。

测试链接:https://www.nowcoder.com/practice/c552d3b4dfda49ccb883a6371d9a6932

识别字符串

核心思想

问题的关键在于比较”差值序列”,而不是原始数字序列:

  1. 差值序列转换:将每个键 a (如 [3, 6, 50]) 转换为其差值字符串 (如 “3#44#”)
  2. 前缀树构建:将所有 a 的差值字符串插入到一个前缀树 (Trie) 中。每个节点记录有多少个字符串经过它 (pass计数)
  3. 前缀匹配查询:对于每个键 b,将其转换为差值字符串,在Trie中查询以此为前缀的字符串数量
  4. 一致性判定:这个数量就是与 b 一致的 a 的数量。因为如果 a 的差值序列以 b 的差值序列为前缀,就满足题目中的“一致”条件

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
# 如果将来增加了数据量,就改大这个值
MAXN = 2000001

# 全局变量模拟 Java 的静态变量
tree = [[0] * 12 for _ in range(MAXN)]
pas = [0] * MAXN
cnt = 0

def build():
"""初始化Trie,根节点编号为1"""
global cnt
cnt = 1

# '0'~'9' -> 0~9, '#' -> 10, '-' -> 11
def get_path(char: str) -> int:
"""将字符映射到Trie的路径索引"""
if char == '#':
return 10
elif char == '-': # - 是负差值
return 11
else:
return int(char)

def insert(word: str):
"""将差值字符串插入Trie"""
global cnt
cur = 1
pas[cur] += 1
for char in word:
path = get_path(char)
if tree[cur][path] == 0:
cnt += 1
tree[cur][path] = cnt
cur = tree[cur][path]
pas[cur] += 1

def count(pre: str) -> int:
"""计算以 pre 为前缀的字符串数量"""
cur = 1
for char in pre:
path = get_path(char)
if tree[cur][path] == 0:
return 0
cur = tree[cur][path]
return pas[cur]

def count_consistent_keys(b, a):
"""主函数,处理接头密匙逻辑"""
build()

# 将所有 a 的差值序列插入Trie
for nums in a:
diff_str_parts = []
for i in range(1, len(nums)):
diff_str_parts.append(str(nums[i] - nums[i-1]))
diff_str_parts.append("#")
insert("".join(diff_str_parts))

ans = [0] * len(b)
# 查询每个 b 的差值序列在前缀树中的计数
for i in range(len(b)):
nums = b[i]
if len(nums) <= 1:
# 如果 b 只有一个或零个元素,差值序列为空
# 空前缀匹配所有插入的 a,所以结果是 a 的总数
ans[i] = len(a)
else:
diff_str_parts = []
for j in range(1, len(nums)):
diff_str_parts.append(str(nums[j] - nums[j-1]))
diff_str_parts.append("#")
ans[i] = count("".join(diff_str_parts))

return ans

算法分析

  • 时间复杂度:O(a数组的数字个数 * 10) + O(b数组的数字个数 * 10)
  • 空间复杂度:O(a数组的数字个数 * 10),这是树上的节点数量
  • 核心技巧:差值序列 + 前缀匹配

题目二:数组中两个数的最大异或值

问题描述

给你一个整数数组 nums,返回 nums[i] XOR nums[j] 的最大运算结果,其中 0<=i<=j<=n。

测试链接:https://leetcode.cn/problems/maximum-xor-of-two-numbers-in-an-array/

算法实现

方法一:前缀树解法

核心思想

使用前缀树存储所有数字的二进制表示,然后贪心地寻找最大异或值:

  1. 二进制Trie构建:将所有数字的二进制表示(从高位到低位)插入到一个Trie中
  2. 贪心搜索:遍历每个数字 num,然后在Trie中为它寻找一个最佳的配对 x,以最大化 num XOR x
  3. 位级贪心:寻找最佳配对的过程是贪心的:从最高位开始,对于 num 的每一位,我们都期望在Trie中找到与之相反的位。如果Trie中存在相反位的路径,我们就走这条路,这会使结果的当前位为1。如果不存在,我们只能走相同位的路径,结果的当前位为0
  4. 最优解更新:遍历所有数字,找到全局最大异或值
具体实现

题目2-异或

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
MAXN = 3000001
tree = [[0] * 2 for _ in range(MAXN)]
cnt = 0
high = 0

def build(nums):
"""构建Trie树,插入所有数字的二进制表示"""
global cnt, high
cnt = 1
# 找到数组中的最大值,以确定需要处理的二进制位数
maximum = max(nums) if nums else 0
# high: 最高位的索引。例如,max=13(1101), bit_length=4, high=3
high = maximum.bit_length() - 1 if maximum > 0 else -1 #bit_length返回的是二进制所需的位数,maximum>0表示没有有效位数
for num in nums:
insert(num)

def insert(num):
"""将一个数字的二进制位插入Trie"""
global cnt
cur = 1
# 从最高有效位开始
for i in range(high, -1, -1):
path = (num >> i) & 1 #将 num 的二进制表示向右移动 i 位,结果只保留最低位(第0位)
if tree[cur][path] == 0:
cnt += 1
tree[cur][path] = cnt
cur = tree[cur][path]

def max_xor(num): #就前缀树的这个
"""对于给定的num,在Trie中寻找能使其异或结果最大的数"""
ans = 0
cur = 1
for i in range(high, -1, -1):
# status: num 在第 i 位的状态 (0 or 1)
status = (num >> i) & 1
# want: 希望遇到的对方路径,即与 status相反的位,这样异或结果在该位上是1
want = 1 - status
# 检查Trie中是否存在期望的路径
if tree[cur][want] == 0:
# 如果期望的路径不存在,只能走另一条路
want = 1 - want

# (status ^ want) 是当前位实际的异或结果
# 将其左移 i 位,加到 ans 中
ans |= (status ^ want) << i #计算当前位的异或结果,将结果左移到正确的位置,累加到最终答案中
cur = tree[cur][want] #在Trie树中移动到下一个节点
return ans

def clear():
"""清空Trie"""
for i in range(1, cnt + 1):
tree[i][0] = tree[i][1] = 0

def findMaximumXOR1(nums):
"""
Trie解法主函数
"""
if not nums or len(nums) < 2:
return 0
build(nums)
ans = 0
for num in nums:
ans = max(ans, max_xor(num))
clear()
return ans

方法二:哈希表解法

核心思想

使用前缀树存储所有数字的二进制表示,然后贪心地寻找最大异或值:

  1. 假设我们已经确定了最大值的前k位(从高到低),结果是 ans。
  2. 现在我们来确定第 i 位。我们贪心地希望第 i 位是 1。
    令我们的目标 better = ans | (1 << i)。
  3. 问题转化为:是否存在两个数 p 和 q,使得 (p XOR q) 的前缀等于 better?
    这等价于 p 的前缀等于 better 的前缀 XOR q 的前缀。
  4. 我们将所有数字的前缀(保留高位,低位置0)放入一个哈希集合 set 中。
  5. 然后遍历这个集合,对于每个前缀 p_prefix,检查 better ^ p_prefix 是否也在集合中。
  6. 如果在,说明 better 这个目标是可以达成的,我们就更新 ans = better。
    否则,第 i 位只能是 0,ans 保持不变。
  7. 重复此过程直到最低位。

题目2-hashset解法

具体实现
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35

def findMaximumXOR2(nums):
"""
哈希表解法主函数
核心思想:
从最高位向最低位,一位一位地确定最大异或值的可能值。
"""
if not nums or len(nums) < 2:
return 0
maximum = max(nums)
high_bit = maximum.bit_length() - 1 if maximum > 0 else -1

ans = 0
seen_prefixes = set()
for i in range(high_bit, -1, -1):
# 贪心目标:尝试让第 i 位为 1
better = ans | (1 << i)
seen_prefixes.clear() # 先clear掉hashset里的所有元素

# 将所有数字的 i-位前缀放入集合
for num in nums:
seen_prefixes.add(num >> i)

# 检查 better 这个前缀是否可以由集合中的某两个数异或得到
# a ^ b = c <=> a ^ c = b
found = False
for p in seen_prefixes: #遍历hashset里的所有元素
if (better >> i) ^ p in seen_prefixes:
ans = better
found = True
break
# if any(((better >> i) ^ p) in seen_prefixes for p in seen_prefixes):
# ans = better

return ans

算法分析

  • 时间复杂度:O(n * logV),V是数值范围
  • 空间复杂度:O(n * logV)
  • 核心技巧:二进制前缀树 + 贪心搜索

题目三:在二维字符数组中搜索可能的单词

问题描述

给定一个 m x n 二维字符网格 board 和一个单词(字符串)列表 words,返回所有二维网格上的单词。单词必须按照字母顺序,通过相邻的单元格内的字母构成,其中”相邻”单元格是那些水平相邻或垂直相邻的单元格。同一个单元格内的字母在一个单词中不允许被重复使用。

测试链接:https://leetcode.cn/problems/word-search-ii/

题目3-用前缀树的好处

核心思想

结合前缀树和深度优先搜索,实现高效的多单词同时搜索:

  1. 前缀树构建:将所有 words 构建成一棵前缀树。这使得我们可以同时搜索所有的单词。
  2. DFS:从 board 的每一个单元格出发,进行深度优先搜索(DFS)。
  3. Trie同步:DFS 的每一步不仅在 board 上移动,也同步在前缀树上移动。
  4. 如果在 board 上的路径能在前缀树中走通,说明这个路径是一个或多个单词的前缀。
  5. 如果走到了一个前缀树的 end 节点,说明找到了一个单词,将其加入结果集。
  6. 剪枝优化:
    a. 在DFS中,如果前缀树的某个路径后续没有单词了(pass计数为0),则停止该方向的搜索。
    b. 找到一个单词后,将其从前缀树中“逻辑删除”(如将end设为None),并更新pass计数,避免重复查找和无效搜索。
  7. 回溯处理:使用哨兵值标记已访问格子,回溯时恢复现场

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
from typing import List

# 全局变量模拟静态数组
MAXN = 30001 # words.length * words[i].length
tree = [[0] * 26 for _ in range(MAXN)]
pas = [0] * MAXN
end = [None] * MAXN
cnt = 0

def build(words: List[str]):
"""将所有待查单词构建成一棵Trie树"""
global cnt
cnt = 1
for word in words:
cur = 1
pas[cur] += 1
for char in word:
path = ord(char) - ord('a')
if tree[cur][path] == 0:
cnt += 1
tree[cur][path] = cnt # 把当前节点 cur 在这条路径 path 上的“指针”设为新节点编号
cur = tree[cur][path] # 在Trie树中移动到下一个节点
pas[cur] += 1
end[cur] = word

def clear():
"""清理Trie树"""
for i in range(1, cnt + 1):
for j in range(26):
tree[i][j] = 0
pas[i] = 0
end[i] = None

def dfs(board: List[List[str]], i: int, j: int, t: int, ans: List[str]) -> int:
"""
深度优先搜索函数

board: 二维网格
i, j: 当前格子位置
t: 当前在前缀树中的节点编号
ans: 结果列表,里面是收集到的字符串
返回值: 从 (i,j) 出发,新收集到了几个字符串
"""
# 大剪枝:i,j越界 或 走了回头路(board[i][j] == 0,即ascii码=0),直接返回
if i < 0 or i == len(board) or j < 0 or j == len(board[0]) or board[i][j] == 0:
return 0

tmp = board[i][j]
road = ord(tmp) - ord('a') #路的编号而不是节点的编号
# t: 当前节点, tree[t][road]: 下一节点
t_next = tree[t][road]

# 剪枝:如果后续路径上没有任何单词(t_next == 0)或者结果已经收集全了(pas[t_next] == 0),则无需继续搜索。不过其实这两个条件是等价的
if t_next == 0: # or pas[t_next] == 0:
return 0

# fix: 从当前 (i, j) 位置出发,总共收集到了几个新字符串
fix = 0
# 如果当前Trie节点是一个单词的结尾
if end[t_next] is not None:
fix += 1
ans.append(end[t_next]) # 前缀树的尽头
# 防止重复添加
end[t_next] = None

# 标记当前位置已访问
board[i][j] = 0
# 向上、下、左、右四个方向递归搜索
fix += dfs(board, i - 1, j, t_next, ans)
fix += dfs(board, i + 1, j, t_next, ans)
fix += dfs(board, i, j - 1, t_next, ans)
fix += dfs(board, i, j + 1, t_next, ans)

# 剪枝优化:回溯时,更新Trie树的pass计数。
# fix是本次DFS调用中找到的单词总数。
# 将这些单词从后续的搜索路径中“移除”,避免不必要的搜索。
pas[t_next] -= fix # 把本次从 t_next 开始的 DFS 一共找到的单词数 fix,从该 Trie 节点的经过计数 pas[t_next] 中减掉
# 回溯:恢复现场。过程:进入格子前保存字符到 tmp → 标记已访问为 0(哨兵,避免重复走)→ 递归结束后把 board[i][j] 设回 tmp,这样其他路径还能正常使用该格子。
board[i][j] = tmp
return fix

def findWords(board: List[List[str]], words: List[str]) -> List[str]:
"""
主函数
"""
build(words)
ans = []
for i in range(len(board)):
for j in range(len(board[0])):
dfs(board, i, j, 1, ans) # 根节点编号为1
clear()
return ans

算法分析

  • 时间复杂度:O(m * n * 4^L),L是最长单词长度
  • 空间复杂度:O(总字符数)
  • 核心技巧:前缀树 + DFS + 动态剪枝

前缀树应用总结

1. 适用场景分析

场景类型 典型特征 前缀树优势
前缀匹配 查询以某字符串为前缀的内容 O(L)查询,支持前缀计数
多模式匹配 同时搜索多个字符串 共享前缀,减少重复搜索
字符串编码 处理字符到数字的映射 灵活的路径编码方案
动态剪枝 搜索过程中动态优化 pass计数支持智能剪枝

2. 设计要点

字符映射策略

1
2
3
4
5
6
7
8
# 根据字符集选择合适的映射方案
def get_path(char):
if char.isdigit():
return int(char) # 数字字符
elif char.isalpha():
return ord(char) - ord('a') # 字母字符
else:
return 特殊字符映射 # 如'#'->10, '-'->11

节点信息设计

1
2
3
4
# 根据需求选择节点存储的信息
pas[i] = 经过次数 # 支持前缀计数
end[i] = 是否结尾 # 支持单词判定
end[i] = 完整单词 # 支持单词返回

剪枝优化策略

1
2
3
4
5
6
# 多种剪枝技巧组合使用
if tree[cur][path] == 0: # 路径不存在剪枝
return
if pas[cur] == 0: # 无有效单词剪枝
return
pas[cur] -= found_count # 动态更新剪枝

3. 性能优化技巧

空间优化

  • 合理评估MAXN大小,避免内存浪费
  • 及时清理无用节点,重复利用空间
  • 考虑使用哈希表替代数组(适用于稀疏情况)

时间优化

  • 预计算字符映射函数,避免重复计算
  • 使用位运算优化二进制操作
  • 合理设计剪枝条件,减少无效搜索

代码优化

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
# 通用的前缀树工具类设计
class TrieTree:
def __init__(self, charset_size=26):
self.MAXN = 100001
self.tree = [[0] * charset_size for _ in range(self.MAXN)]
self.pas = [0] * self.MAXN
self.end = [False] * self.MAXN
self.cnt = 1

def clear(self):
for i in range(1, self.cnt + 1):
for j in range(len(self.tree[i])):
self.tree[i][j] = 0
self.pas[i] = 0
self.end[i] = False
self.cnt = 1

4. 常见错误避免

边界处理

  • 空字符串的处理
  • 单字符串的特殊情况
  • 数组越界检查

状态管理

  • 全局变量的正确初始化和清理
  • 递归过程中状态的正确传递
  • 回溯时现场的完整恢复

逻辑正确性

  • 前缀匹配 vs 完全匹配的区别
  • 路径索引映射的一致性
  • 剪枝条件的准确性

学习建议

1. 掌握基础操作

  • 熟练掌握前缀树的构建、插入、查询操作
  • 理解pass计数和end标记的作用
  • 练习不同字符集的映射方案

2. 理解应用场景

  • 识别哪些问题适合用前缀树解决
  • 学会将复杂问题转化为前缀匹配问题
  • 掌握前缀树与其他算法的结合使用

3. 优化思维培养

  • 学会分析时间空间复杂度
  • 掌握各种剪枝优化技巧
  • 培养动态调整搜索策略的能力

4. 实战经验积累

  • 多做不同类型的前缀树题目
  • 总结常见的代码模板和套路
  • 练习在限时条件下的快速实现

通过系统学习前缀树的这些经典应用,可以很好地理解前缀树在实际算法问题中的强大作用,为解决更复杂的字符串和搜索问题打下坚实基础。

引言

参照的是左程云的课程:https://space.bilibili.com/8888480/lists/3509640?type=series

本笔记是class043的内容,介绍了算法竞赛和面试中极其重要的一个技巧——根据数据量猜解法。这是”天字第一号重要技巧”,能够帮助我们在看到题目后迅速判断应该使用什么复杂度的算法。

前置知识

在学习本技巧之前,需要掌握以下基础知识:

  • 时间复杂度的概念(讲解007)
  • 全排列递归代码的执行细节(讲解038)

核心原理

基本事实

无论在什么测试平台、什么CPU上,都有一个基本的性能标准:

  • C/C++:运行时间1秒,对应常数指令操作量约为 10^7 ~ 10^8
  • Java/Python/Go等其他语言:运行时间1-2秒,对应常数指令操作量约为 10^7 ~ 10^8

这个数量级是固定的,是我们进行算法复杂度估算的重要依据。

运用条件

要成功运用这个技巧,需要满足两个条件:

  1. 题目给定各个参数的范围最大值

    • 正式笔试、比赛的题目一定会给出
    • 面试中需要和面试官确认
  2. 对自己设计的算法有准确的时间复杂度估计

    • 这需要扎实的算法基础
    • 对各种算法模式的复杂度要熟悉

问题规模与可用算法对照表

数据规模n logn n n*logn n*√n n² 2^n n!
n ≤ 11 ✓ ✓ ✓ ✓ ✓ ✓ ✓
n ≤ 25 ✓ ✓ ✓ ✓ ✓ ✓ ✗
n ≤ 5000 ✓ ✓ ✓ ✓ ✓ ✗ ✗
n ≤ 10^5 ✓ ✓ ✓ ✓ ✗ ✗ ✗
n ≤ 10^6 ✓ ✓ ✓ ✗ ✗ ✗ ✗
n ≤ 10^7 ✓ ✓ ✗ ✗ ✗ ✗ ✗
n ≥ 10^8 ✓ ✗ ✗ ✗ ✗ ✗ ✗

说明

  • n√n 复杂度*:常出现在”莫队算法”相关题目中
  • 这张表提供参考,但实际应用中要考虑多个参数的组合影响
  • 关键是记住常数指令操作量 10^7 ~ 10^8这个基准

043【必备】根据数据量猜解法的技巧-天字第一号重要技巧

实战案例

案例一:最优的技能释放顺序

问题描述

现在有一个打怪类型的游戏:

  • 你有n个技能,每个技能最多只能释放一次
  • 每个技能有基础伤害值
  • 当怪物血量小于等于某个阈值时,该技能可能造成双倍伤害
  • 已知怪物有m点血量
  • 求最少用几个技能能消灭怪物

约束条件:

  • 1 ≤ n ≤ 10
  • 1 ≤ m、x[i]、y[i] ≤ 10^6

测试链接: https://www.nowcoder.com/practice/d88ef50f8dab4850be8cd4b95514bbbd

复杂度分析

由于 n ≤ 10,我们可以尝试所有技能的排列组合:

  • 排列数:n! ≤ 10! = 3,628,800
  • 远小于 10^7,所以回溯算法完全可行

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
import sys
import math

class Solution:
def __init__(self):
self.kill = [] # 技能伤害值
self.blood = [] # 触发双倍伤害的血量阈值
self.n = 0

def _f(self, i: int, r: int) -> int:
"""
回溯算法核心函数
i: 当前使用的技能数量
r: 怪物剩余血量
返回: 从当前状态到击败怪物还需要的最少技能数
"""
# base case: 怪物已被击败
if r <= 0:
return 0

# base case: 技能用完但怪物未死
if i == self.n:
return math.inf

ans = math.inf
# 尝试所有未使用的技能
for j in range(i, self.n):
# 将第j个技能换到位置i尝试
self._swap(i, j)

# 计算伤害(是否触发双倍)
damage = self.kill[i] if r > self.blood[i] else self.kill[i] * 2

# 递归求解
res = self._f(i + 1, r - damage)
if res != math.inf:
ans = min(ans, 1 + res)

# 回溯
self._swap(i, j)

return ans

def _swap(self, i: int, j: int):
"""交换第i个和第j个技能"""
self.kill[i], self.kill[j] = self.kill[j], self.kill[i]
self.blood[i], self.blood[j] = self.blood[j], self.blood[i]

优化版本(剪枝)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
def solve_optimized():
t = int(input())
for _ in range(t):
n, m = map(int, input().split())
skills = []
for _ in range(n):
skills.append(tuple(map(int, input().split())))

ans = -1

def dfs(blood, used=set()):
nonlocal ans

# 剪枝1: 假设剩余技能全部打出双倍伤害
rest_max_damage = sum([2 * skills[i][0] for i in range(n) if i not in used])
if blood > rest_max_damage:
return

# 剪枝2: 如果当前已使用技能数不优于已知答案
if ans != -1 and len(used) >= ans:
return

# 成功条件
if blood <= 0:
ans = min(ans, len(used)) if ans >= 0 else len(used)
return

# 失败条件
if len(used) == n and blood > 0:
return

# 尝试每个未使用的技能
for i, (damage, threshold) in enumerate(skills):
if i not in used:
used.add(i)
actual_damage = 2 * damage if blood <= threshold else damage
dfs(blood - actual_damage, used)
used.remove(i)

dfs(m)
print(ans)

案例二:超级回文数的数目

问题描述

如果一个正整数自身是回文数,而且它也是一个回文数的平方,那么我们称这个数为超级回文数。

给定两个正整数L和R,返回包含在范围[L, R]中的超级回文数的数目。

约束条件:

  • 1 ≤ len(L) ≤ 18
  • 1 ≤ len(R) ≤ 18
  • L和R表示[1, 10^18)范围的整数

测试链接: https://leetcode.cn/problems/super-palindromes/

复杂度分析

设超级回文数为S = x²,其中S和x都是回文数:

  • S最大为10^18,所以x最大为10^9
  • 回文数的数量远少于普通数
  • 可以通过”种子”生成回文数,种子范围约为10^5
  • 时间复杂度约为O(√10^9) = O(10^5),完全可行

根据seed生成回文数
小数据办大事

算法实现

方法一:枚举回文数的根
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
import math

class Solution:
def superpalindromesInRange1(self, left: str, right: str) -> int:
"""
核心思想:枚举所有可能的回文数x,检查x²是否也是回文且在范围内
"""
l, r = int(left), int(right)
limit = int(math.sqrt(r))

ans = 0
seed = 1

while True:
# 生成偶数长度回文数
num_even = self._even_enlarge(seed)
if num_even > limit:
break
square = num_even * num_even
if self._check(square, l, r):
ans += 1

# 生成奇数长度回文数
num_odd = self._odd_enlarge(seed)
if num_odd <= limit:
square = num_odd * num_odd
if self._check(square, l, r):
ans += 1

seed += 1

return ans

def _even_enlarge(self, seed: int) -> int:
"""将种子扩展为偶数长度回文数,如123→123321"""
ans = seed
temp = seed
while temp != 0:
ans = ans * 10 + temp % 10
temp //= 10
return ans

def _odd_enlarge(self, seed: int) -> int:
"""将种子扩展为奇数长度回文数,如123→12321"""
ans = seed
temp = seed // 10
while temp != 0:
ans = ans * 10 + temp % 10
temp //= 10
return ans

def _check(self, num: int, l: int, r: int) -> bool:
"""检查数字是否在范围内且为回文数"""
return l <= num <= r and self._is_palindrome_num(num)

def _is_palindrome_num(self, num: int) -> bool:
"""判断数字是否为回文数"""
if num < 0:
return False
if num == 0:
return True

# 双指针思想:同时从最高位和最低位比较
offset = 1
while num // offset >= 10:
offset *= 10

while num != 0:
if num // offset != num % 10:
return False
num = (num % offset) // 10
offset //= 100
return True
方法二:打表法
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
class Solution:
# 预计算所有超级回文数
_record = [
1, 4, 9, 121, 484, 10201, 12321, 14641, 40804, 44944,
1002001, 1234321, 4008004, 100020001, 102030201, 104060401,
# ... 更多预计算的值
1234323468643234321, 4000000008000000004
]

def superpalindromesInRange2(self, left: str, right: str) -> int:
"""
打表法:预先计算好所有超级回文数,查询时直接范围查找
"""
l, r = int(left), int(right)

# 二分查找或线性扫描
count = 0
for num in self._record:
if l <= num <= r:
count += 1
elif num > r:
break

return count

案例三:回文数判断

问题描述

判断一个整数是否是回文数,不使用字符串转换。

测试链接: https://leetcode.cn/problems/palindrome-number/

核心思想

  1. 负数不是回文数。
  2. 计算出一个 offset,使其与 num 的位数相同(例如,num=12321, offset=10000)。
    这个 offset 可以用来取出最高位的数字 (num // offset)。
  3. 循环比较最高位 (num // offset) 和最低位 (num % 10)。
  4. 如果不相等,则不是回文数。
  5. 如果相等,则去掉最高位和最低位,继续比较。
    • 去掉最低位: num % 10
    • 去掉最高位: num % offset
    • 组合起来: (num % offset) // 10
  6. 同时,offset 需要除以 100,因为我们一次处理了两位数。

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
class Solution:
def isPalindrome(self, num: int) -> bool:
"""
不使用字符串转换判断回文数
核心思想:双指针,同时比较最高位和最低位
"""
if num < 0:
return False

# 计算与num位数相同的offset
offset = 1
while num // offset >= 10:
offset *= 10

# 同时比较首尾数字
while num != 0:
# 比较最高位和最低位
if num // offset != num % 10:
return False

# 去掉首尾两位数字
num = (num % offset) // 10
offset //= 100

return True

技巧应用步骤

1. 分析数据规模

1
2
3
# 示例:看到题目约束
# n ≤ 10, m ≤ 10^6
# 立即想到:n很小,可以用指数级算法;m较大,需要高效处理

2. 估算操作次数

1
2
3
# 示例:全排列问题
# n ≤ 10 → n! ≤ 10! ≈ 3.6 × 10^6 < 10^7 ✓ 可行
# n ≤ 15 → n! ≤ 15! ≈ 1.3 × 10^12 > 10^8 ✗ 不可行

3. 选择合适算法

1
2
3
4
5
6
7
# 根据复杂度选择算法类型:
# O(1), O(logn) → 数学公式、二分查找
# O(n) → 线性扫描、简单遍历
# O(n logn) → 排序、分治算法
# O(n²) → 双重循环、动态规划
# O(2^n) → 回溯、状态压缩DP
# O(n!) → 全排列、旅行商问题

4. 考虑常数优化

1
2
3
4
5
# 即使复杂度合适,也要考虑:
# - 剪枝优化
# - 缓存计算结果
# - 避免重复计算
# - 选择高效的数据结构

常见复杂度模式

1. 递归分治

1
2
# T(n) = a × T(n/b) + O(n^c)
# 主定理:比较a与b^c的大小关系

2. 动态规划

1
2
3
4
# 状态数 × 转移复杂度
# 一维DP: O(n)
# 二维DP: O(n²)
# 区间DP: O(n³)

3. 图算法

1
2
3
# BFS/DFS: O(V + E)
# 最短路径: O(V²) 或 O(E logV)
# 最小生成树: O(E logE)

4. 字符串算法

1
2
3
# 暴力匹配: O(n×m)
# KMP: O(n + m)
# 字典树: O(总长度)

学习建议

1. 熟记基准值

  • 核心记忆:10^7 ~ 10^8 操作/秒
  • 常见数据规模的复杂度上限
  • 不同语言的性能差异

2. 积累经验

  • 多做题,培养对复杂度的直觉
  • 记录不同类型题目的常见数据规模
  • 总结复杂度估算的常见陷阱

3. 实践验证

  • 实际提交验证时间复杂度估算
  • 对比不同算法的实际运行时间
  • 学会分析超时的原因

4. 深入理解

  • 不仅要会算复杂度,还要理解为什么
  • 掌握各种算法的适用场景
  • 学会在时间和空间之间做权衡

总结

“根据数据量猜解法”是算法竞赛和技术面试中极其重要的技巧:

  1. 核心原理:基于10^7~10^8操作/秒的基准进行复杂度估算
  2. 应用场景:快速判断算法可行性,指导解题方向
  3. 关键要素:准确的复杂度分析 + 对数据规模的敏感度
  4. 实战价值:避免选择错误的算法方向,提高解题效率

通过掌握这个技巧,我们可以在看到题目的第一时间就大致确定解题的复杂度范围,从而选择合适的算法策略,这对于在有限时间内解决算法问题具有重要意义。

引言

参照的是左程云的课程:https://space.bilibili.com/8888480/lists/3509640?type=series

本笔记内容囊括class41-class42,class41讲的是数学基础中的最大公约数、最小公倍数计算,以及同余原理的应用。此外class42讲了对数器打表找规律的技巧,通过暴力解小规模数据,观察输出规律,最终得到高效的数学解法。

重要说明

这两个内容都和数学比较相关,所以放在了一起。同余原理等等都是抽象代数的基本操作,对数器打表则需要我们观察数学规律,然后再高效求解。


041【必备】最大公约数、同余原理

前置知识

在学习本内容之前,需要掌握以下基础知识:

  • 基本的数学运算
  • 递归的概念
  • 二分查找的基本思想

重要说明

  • 本期内容涵盖欧几里得算法(辗转相除法)的原理与实现
  • 同余原理在防止大数溢出方面的应用
  • 二分答案法与容斥原理的简单应用
  • 更高效的Stein算法和裴蜀定理会在后续扩展课程中讲述

核心知识点一:最大公约数与最小公倍数

欧几里得算法(辗转相除法)

算法原理

辗转相除法的核心是证明以下关系:
$$\gcd(a, b) = \gcd(b, a \bmod b)$$

其中 $a \bmod b$ 表示 $a$ 除以 $b$ 的余数。

正确性证明

设 $a \bmod b = r$,即需要证明:$\gcd(a, b) = \gcd(b, r)$

证明过程:

  1. 由 $a \bmod b = r$ 可得:

    • $a = b \times q + r$(其中 $q$ 为商)
    • $r = a - b \times q$
  2. 设 $u$ 是 $a$ 和 $b$ 的公因子,则有:$a = s \times u$,$b = t \times u$

  3. 将上式代入得:$r = s \times u - t \times u \times q = (s - t \times q) \times u$

  4. 这说明:$u$ 如果是 $a$ 和 $b$ 的公因子,那么 $u$ 也是 $r$ 的因子

  5. 反之,设 $v$ 是 $b$ 和 $r$ 的公因子,则有:$b = x \times v$,$r = y \times v$

  6. 代入得:$a = x \times v \times q + y \times v = (x \times q + y) \times v$

  7. 这说明:$v$ 如果是 $b$ 和 $r$ 的公因子,那么 $v$ 也是 $a$ 的公因子

结论: $a$ 和 $b$ 的全体公因子集合 = $b$ 和 $r$ 的全体公因子集合,因此 $\gcd(a, b) = \gcd(b, r)$

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
class MathUtils:
def gcd(self, a: int, b: int) -> int:
"""
使用辗转相除法(欧几里得算法)计算最大公约数。
核心思想:
两个整数的最大公约数等于其中较小的数和两数相除余数的最大公约数。
递归的基准情况是当 b 为 0 时,最大公约数是 a。
"""
return a if b == 0 else self.gcd(b, a % b)

def lcm(self, a: int, b: int) -> int:
"""
计算最小公倍数。
核心思想:
两个数的最小公倍数可以通过公式 `(a * b) / gcd(a, b)` 计算得出。
为了防止 `a * b` 在某些语言中溢出,可以写成 `a / gcd(a, b) * b`。
在 Python 中,整数支持任意精度,不存在溢出问题,但这种写法仍然是好习惯。
"""
# 使用 // 保证整数除法
return (a // self.gcd(a, b)) * b

算法分析

  • 时间复杂度:$O((\log a)^3)$,其中 $a > b$
  • 空间复杂度:$O(\log a)$(递归调用栈)
  • 核心优势:算法简洁,效率高,易于实现

使用示例

1
2
3
4
utils = MathUtils()
a, b = 48, 18
print(f"GCD of {a} and {b} is: {utils.gcd(a, b)}") # 输出: 6
print(f"LCM of {a} and {b} is: {utils.lcm(a, b)}") # 输出: 144

核心知识点二:神奇数问题(二分答案法 + 容斥原理)

问题描述

一个正整数如果能被 $a$ 或 $b$ 整除,那么它是神奇的。给定三个整数 $n$, $a$, $b$,返回第 $n$ 个神奇的数字。因为答案可能很大,所以返回答案对 $10^9 + 7$ 取模后的值。

测试链接:https://leetcode.cn/problems/nth-magical-number/

核心思想

这个问题巧妙地结合了两个重要算法:

  1. 二分答案法:答案具有单调性,可以二分查找
  2. 容斥原理:计算能被 $a$ 或 $b$ 整除的数的个数

二分答案法分析

对于任意数字 $m$,小于等于 $m$ 的神奇数字个数具有单调性:$m$ 越大,神奇数字越多。因此可以二分查找第 $n$ 个神奇数字。

容斥原理应用

计算 $1$ 到 $m$ 中能被 $a$ 或 $b$ 整除的数的个数:

$$\text{count} = \lfloor\frac{m}{a}\rfloor + \lfloor\frac{m}{b}\rfloor - \lfloor\frac{m}{\text{lcm}(a,b)}\rfloor$$

其中减去 $\lfloor\frac{m}{\text{lcm}(a,b)}\rfloor$ 是因为被 $a$ 和 $b$ 同时整除的数被重复计算了。

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
class Solution:
def nthMagicalNumber(self, n: int, a: int, b: int) -> int:
"""
寻找第 n 个神奇数字。
核心思想:
答案本身具有单调性(越大的数,它前面的神奇数字越多),因此可以使用二分查找来寻找答案。
1. 定义查找范围:下界 `l=0`,上界 `r` 可以是一个足够大的数,例如 `n * min(a, b)`。
2. 二分中点为 `m`,我们需要快速计算出 `1` 到 `m` 之间有多少个神奇数字。
3. 这个数量可以通过容斥原理计算:`count = m/a + m/b - m/lcm(a, b)`。
其中 `lcm` 是 a 和 b 的最小公倍数。
4. 如果 `count >= n`,说明第 `n` 个神奇数字可能就是 `m` 或者更小,所以我们将 `m` 存为候选答案,并向左查找 `r = m - 1`。
5. 如果 `count < n`,说明 `m` 太小了,第 `n` 个神奇数字在 `m` 的右边,所以向右查找 `l = m + 1`。
6. 二分结束后,候选答案即为所求,最后对结果取模。
"""
lcm_val = self._lcm(a, b)
ans = 0
mod = 1000000007

# l = 0, r = n * min(a, b) 是一个安全上界
l, r = 0, n * min(a, b)

while l <= r:
m = (l + r) // 2
# 计算 1...m 中有多少个数是 a 或 b 的倍数
# 使用容斥原理:(m中a的倍数) + (m中b的倍数) - (m中a和b公倍数的个数)
if m // a + m // b - m // lcm_val >= n:
ans = m
r = m - 1
else:
l = m + 1

return ans % mod

def _gcd(self, a: int, b: int) -> int:
return a if b == 0 else self._gcd(b, a % b)

def _lcm(self, a: int, b: int) -> int:
return (a * b) // self._gcd(a, b)

算法分析

  • 时间复杂度:$O(\log(\text{n} \times \min(a, b)))$
  • 空间复杂度:$O(\log(\min(a, b)))$(递归调用栈)
  • 核心技巧:二分答案法 + 容斥原理

核心知识点三:同余原理

基本公理

设 $m$ 为正整数(模),若:

  • $a \equiv b \pmod{m}$
  • $c \equiv d \pmod{m}$

则有:

  • 加法:$a + c \equiv b + d \pmod{m}$
  • 减法:$a - c \equiv b - d \pmod{m}$
  • 乘法:$ac \equiv bd \pmod{m}$

核心思想

在模运算中,我们可以在每一步计算后都取模,这样可以:

  1. 防止中间结果溢出
  2. 保持计算结果的正确性
  3. 提高计算效率

实际应用

问题:计算 $((a + b) \times (c - d) + (a \times c - b \times d)) \bmod m$

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
class Solution:
def f1(self, a: int, b: int, c: int, d: int, mod: int) -> int:
"""
使用 Python 的原生大整数计算,等同于 Java 的 BigInteger 版本。
核心思想:
直接进行数学运算,让语言自动处理中间过程中可能出现的巨大数值。
最后对最终结果取模。
"""
o5 = a + b
o6 = c - d
o7 = a * c
o8 = b * d
o9 = o5 * o6
o10 = o7 - o8
o11 = o9 + o10
# (res % mod + mod) % mod 是一个确保结果为正的通用技巧。
return (o11 % mod + mod) % mod

def f2(self, a: int, b: int, c: int, d: int, mod: int) -> int:
"""
使用同余原理在每一步运算后都取模。
核心思想 (同余原理):
- (A + B) % M = ((A % M) + (B % M)) % M
- (A - B) % M = ((A % M) - (B % M) + M) % M (加上M确保结果非负)
- (A * B) % M = ((A % M) * (B % M)) % M
这种方法可以保证所有中间计算结果都在一个可控的范围内,避免大数运算,效率更高。
"""
o1 = a % mod
o2 = b % mod
o3 = c % mod
o4 = d % mod
o5 = (o1 + o2) % mod
# 加上 mod 再取模,是为了防止 o3 < o4 时出现负数
o6 = (o3 - o4 + mod) % mod
o7 = (o1 * o3) % mod
o8 = (o2 * o4) % mod
o9 = (o5 * o6) % mod
o10 = (o7 - o8 + mod) % mod
ans = (o9 + o10) % mod
return ans

重要注意事项

  1. 减法处理:$(a - b) \bmod m = ((a \bmod m) - (b \bmod m) + m) \bmod m$

    • 加上 $m$ 是为了确保结果非负
  2. 除法同余:需要求逆元,比较复杂,会在后续课程中讲述

  3. 数据类型:在需要防止溢出的语言中,乘法运算常用长整型做中间变量

验证代码

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
import random
import sys

def random_long():
return random.randint(0, sys.maxsize)

if __name__ == '__main__':
s = Solution()
print("测试开始")
test_time = 100000
mod = 1000000007
all_passed = True

for i in range(test_time):
a = random_long()
b = random_long()
c = random_long()
d = random_long()
if s.f1(a, b, c, d, mod) != s.f2(a, b, c, d, mod):
print("出错了!")
all_passed = False
break

if all_passed:
print("测试结束,全部通过!")

算法技巧总结

1. 欧几里得算法模板

1
2
3
4
5
def gcd(a, b):
return a if b == 0 else gcd(b, a % b)

def lcm(a, b):
return (a * b) // gcd(a, b)

2. 二分答案法模板

1
2
3
4
5
6
7
8
9
10
def binary_search_answer(check_function, left, right):
ans = -1
while left <= right:
mid = (left + right) // 2
if check_function(mid):
ans = mid
right = mid - 1 # 继续寻找更小的答案
else:
left = mid + 1
return ans

3. 容斥原理(两个集合)

1
2
3
4
# |A ∪ B| = |A| + |B| - |A ∩ B|
def inclusion_exclusion_two_sets(n, a, b):
lcm_ab = lcm(a, b)
return n // a + n // b - n // lcm_ab

4. 同余运算模板

1
2
3
4
5
6
7
8
9
10
11
def safe_mod_operations(a, b, mod):
# 加法
add_result = (a + b) % mod

# 减法(确保非负)
sub_result = (a - b + mod) % mod

# 乘法
mul_result = (a * b) % mod

return add_result, sub_result, mul_result

复杂度分析总结

算法 时间复杂度 空间复杂度 应用场景
欧几里得算法 $O(\log \min(a,b))$ $O(\log \min(a,b))$ 求最大公约数
神奇数问题 $O(\log(n \times \min(a,b)))$ $O(\log \min(a,b))$ 二分答案法
同余运算 $O(1)$ $O(1)$ 防止溢出

学习建议

1. 掌握数学基础

  • 理解最大公约数和最小公倍数的定义
  • 掌握同余的概念和性质
  • 熟悉容斥原理的基本应用

2. 算法思维训练

  • 二分答案法:当答案具有单调性时考虑使用
  • 容斥原理:处理集合交并关系的重要工具
  • 同余优化:在模运算中防止溢出的关键技巧

3. 实践要点

  • 欧几里得算法是最基础的数学算法,必须熟练掌握
  • 同余原理在竞赛和工程中都很重要,特别是处理大数时
  • 二分答案法是一种重要的算法思想,适用范围很广

4. 扩展学习

  • Stein算法:更高效的最大公约数算法
  • 裴蜀定理:关于线性丢番图方程的重要定理
  • 扩展欧几里得算法:求解模逆元的基础
  • 中国剩余定理:处理多个同余方程组

5. 注意事项

  • 在实现递归版本时注意栈溢出问题
  • 处理负数时要特别小心同余运算
  • 在竞赛中,往往需要对结果取模,要养成习惯

通过掌握这些数学基础知识和算法技巧,可以为解决更复杂的数学相关算法问题打下坚实的基础。这些知识点不仅在算法竞赛中经常出现,在实际工程开发中也有重要应用价值。

042【必备】对数器打表找规律的技巧

前置知识

在学习本内容之前,需要掌握以下基础知识:

  • 基本递归能力(推荐讲解038-常见经典递归过程解析)
  • 动态规划的基本思想
  • 博弈论的基础概念

使用场景

对数器打表找规律适用于:

  • 输入参数是简单类型
  • 返回值也是简单类型
  • 暴力解法可以处理小规模数据
  • 存在数学规律可以发现

方法论

  1. 暴力实现:用最基本的递归实现求解小规模问题
  2. 打表观察:打印小规模输入的答案,寻找规律
  3. 规律验证:将观察到的规律转换为代码并验证
  4. 优化实现:基于规律得到最优解

问题一:使用规格8和规格6的袋子买苹果

问题描述

有装下8个苹果的袋子、装下6个苹果的袋子,一定要保证买苹果时所有使用的袋子都装满。对于无法装满所有袋子的方案不予考虑,给定n个苹果,返回至少要多少个袋子。如果不存在每个袋子都装满的方案返回-1。

核心思想

这是一个典型的整数规划问题,可以用动态规划或递归求解,也可以通过观察规律得到数学解法。

方法一:暴力递归(备忘录优化)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
import math

class Solution:
def bags1(self, apple: int) -> int:
"""
主函数,调用递归并处理无效解的返回值
"""
# 使用 memoization (备忘录) 来优化递归,避免重复计算
memo = {}
ans = self._f(apple, memo)
# 如果返回的是无穷大,说明无解,返回-1
return ans if ans != math.inf else -1

def _f(self, rest: int, memo: dict) -> int:
"""
递归函数,计算装下 rest 个苹果所需的最少袋子数
核心思想 (回溯/动态规划):
对于 `rest` 个苹果,我们有两种选择:
1. 用一个8个装的袋子,问题变为求解 `f(rest - 8)`。
2. 用一个6个装的袋子,问题变为求解 `f(rest - 6)`。
我们需要在这两种选择中,选择总袋子数最少的那一个。
"""
if rest in memo: # 如果之前已经算过当前 rest(还剩多少苹果)对应的最少袋子数
return memo[rest]

# base case: 苹果数小于0,说明上一步的选择是无效的
if rest < 0:
return math.inf

# base case: 苹果数为0,说明刚好装完,不再需要袋子
if rest == 0:
return 0

# 尝试用一个8规格的袋子
p1 = self._f(rest - 8, memo)
# 尝试用一个6规格的袋子
p2 = self._f(rest - 6, memo)

# 在有效解的基础上加1 (代表当前用的这个袋子)
res = min(p1, p2) + 1

memo[rest] = res
return res

方法二:规律观察优化解

通过打表观察发现规律:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
def bags2(self, apple: int) -> int:
"""
通过暴力解的输出观察规律,得到的数学优化方法
核心思想:
- 苹果数必须是偶数,因为袋子规格6和8都是偶数。
- 观察小数据量的解,发现 apple < 18 时情况比较特殊,可以直接列出。
- 当 apple >= 18 时,规律出现。为了用最少的袋子,应尽可能多地使用8个装的袋子。
可以证明任何 >= 18 的偶数 `apple` 都可以表示为 `8*k + c` 的形式,
其中 `c` 是一个可以用6和8凑出来的小数(比如18, 20, 22)。
`apple - 18` 的部分全部用8个装的袋子,剩下的18个苹果用3个6个装的袋子。
"""
# base case:如果苹果数是奇数,无解
if (apple & 1) != 0:
return -1

# base case:处理18以下的特殊情况
if apple < 18:
if apple == 0:
return 0
if apple == 6 or apple == 8:
return 1
if apple == 12 or apple == 14 or apple == 16:
return 2
return -1

# 处理18及以上的情况
# (apple - 18) 用8个装的袋子,18用3个6个装的袋子
return (apple - 18) // 8 + 3

规律分析

通过打表观察,我们发现:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
苹果数 : 最少袋子数
0 : 0
1 : -1 (奇数无解)
2 : -1
3 : -1 (奇数无解)
4 : -1
5 : -1 (奇数无解)
6 : 1 (1个6袋)
7 : -1 (奇数无解)
8 : 1 (1个8袋)
9 : -1 (奇数无解)
10 : -1
11 : -1 (奇数无解)
12 : 2 (2个6袋)
13 : -1 (奇数无解)
14 : 2 (1个6袋+1个8袋)
15 : -1 (奇数无解)
16 : 2 (2个8袋)
17 : -1 (奇数无解)
18 : 3 (3个6袋)
20 : 3 (1个6袋+1个8袋+1个6袋 或 其他组合)
22 : 3 (1个6袋+2个8袋)
24 : 3 (3个8袋)
...

规律:当 apple >= 18 且为偶数时,答案为 (apple - 18) // 8 + 3

算法分析

  • 暴力递归:时间复杂度 O(N),空间复杂度 O(N)
  • 规律优化:时间复杂度 O(1),空间复杂度 O(1)

问题二:A和B轮流吃草博弈问题

问题描述

草一共有n的重量,两只牛轮流吃草,A牛先吃,B牛后吃。每只牛在自己的回合,吃草的重量必须是4的幂,1、4、16、64…。谁在自己的回合正好把草吃完谁赢,根据输入的n,返回谁赢。

核心思想

这是一个典型的博弈论问题,使用Min-Max算法求解。关键在于理解必胜态和必败态的概念。

方法一:暴力递归(博弈论)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
class Solution:
def win1(self, n: int) -> str:
"""
主函数,启动递归
"""
# 使用 memoization 优化
memo = {}
return self._f(n, "A", memo)

def _f(self, rest: int, cur: str, memo: dict) -> str:
"""
递归函数,模拟博弈过程
核心思想 (博弈论 Min-Max 思想):
- `cur` (当前玩家)能赢的条件是:`cur` 存在一种走法,使得走完后,`enemy` (对手)面对的局面是必败的。
- 必败态:无论怎么走,留给对手的都是必胜态。
- 必胜态:存在一种走法,留给对手的是必败态。
- 我们遍历当前玩家所有可能的吃草量 (4的幂),如果吃完后留给对手的局面是对手必败(即当前玩家赢),
那么当前局面就是必胜态,`cur` 赢。
- 如果所有走法都无法让对手输,那么 `cur` 输。
"""
if (rest, cur) in memo:
return memo[(rest, cur)]

enemy = "B" if cur == "A" else "A"

# base case: 剩草小于5时,可以直接判断胜负
if rest < 5:
# 剩0或2时,当前玩家没法一步吃完,所以对手赢
# 剩1,3,4时,当前玩家可以一步吃完,所以当前玩家赢
winner = enemy if (rest == 0 or rest == 2) else cur
memo[(rest, cur)] = winner
return winner

# rest >= 5
# 遍历所有可能的吃草量
pick = 1
while pick <= rest:
# `_f(rest - pick, enemy)` 返回的是:当剩下 `rest-pick` 的草,轮到 `enemy` 时,最终谁会赢。
# 如果这个结果是 `cur` 赢,说明 `cur` 只要选择吃 `pick` 的草,就能锁定胜局。
if self._f(rest - pick, enemy, memo) == cur:
memo[(rest, cur)] = cur
return cur

# 防止 pick * 4 溢出 (在 Python 中不是问题,但在某些语言中需要注意)
if pick > rest // 4: #先算//,再与pick比较
break
pick *= 4

# 如果所有可能的走法都无法让 cur 赢,那么 enemy 赢
memo[(rest, cur)] = enemy
return enemy

方法二:规律观察优化解

通过打表发现胜负规律:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
def win2(self, n: int) -> str:
"""
通过暴力解的输出,发现胜负结果以5为周期循环
核心思想:
观察 `win1` 的输出,可以发现:
n=0 -> B (先手输)
n=1 -> A (先手赢)
n=2 -> B (先手输)
n=3 -> A (先手赢)
n=4 -> A (先手赢)
n=5 -> B (先手输)
...
胜负状态是 (B, A, B, A, A),以5为周期。
当 n % 5 的结果是 0 或 2 时,先手方 A 面对的是必败局面,所以 B 赢。
否则 A 赢。
"""
if n % 5 == 0 or n % 5 == 2:
return "B"
else:
return "A"

规律分析

通过打表观察:

1
2
3
4
5
6
7
8
9
10
11
12
13
草量 : 赢家
0 : B
1 : A
2 : B
3 : A
4 : A
5 : B
6 : A
7 : B
8 : A
9 : A
10 : B
...

发现模式:(B, A, B, A, A) 以5为周期重复。

算法分析

  • 暴力递归:时间复杂度 O(N×logN),空间复杂度 O(N)
  • 规律优化:时间复杂度 O(1),空间复杂度 O(1)

问题三:判断连续正整数和

问题描述

判断一个数字是否是若干数量(数量>1)的连续正整数的和。

核心思想

这是一个数论问题,可以通过数学推导得到简洁的判断条件。

方法一:暴力枚举

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
class Solution:
def is1(self, num: int) -> bool:
"""
暴力尝试所有可能的连续正整数序列
核心思想:
- 从 1 开始,尝试每一个数 `start` 作为连续序列的起始点。
- 对于每一个 `start`,累加 `start, start+1, start+2, ...`
- 如果累加和等于 `num`,则找到了一个解,返回 True。
- 如果累加和大于 `num`,则以 `start` 为起点的序列不可能,跳出内层循环。
"""
# start 是连续区间的开始
for start in range(1, num + 1):
current_sum = start
# 从 start+1 开始累加
for j in range(start + 1, num + 1):
if current_sum + j > num:
# 累加和已超,后续不可能相等
break
if current_sum + j == num:
# 找到了一个解
return True
current_sum += j
return False

方法二:数学规律

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
def is2(self, num: int) -> bool:
"""
通过数学推导得出的结论
核心思想:
一个正整数 `num` 可以表示为连续k(k>1)个正整数之和的充要条件是:`num` 不是2的幂。
证明:
1. 设 `num = a + (a+1) + ... + (a+k-1) = k*a + k*(k-1)/2`
2. `2*num = k*(2a + k - 1)`
3. `k` 和 `2a+k-1` 中一个是奇数,一个是偶数。
4. 如果 `num` 是2的幂,`num = 2^p`,那么 `2*num = 2^(p+1)`。
`2^(p+1)` 的所有因子都是2的幂(偶数),无法分解成一奇一偶的乘积
(除了 1*2^(p+1),但这要求 k=1 或 2a+k-1=1,都与 k>1, a>=1 矛盾)。
5. 所以,如果 `num` 是2的幂,则无解。反之,如果 `num` 不是2的幂,则 `num` 必有奇数因子,可以构造出解。

判断一个数是否是2的幂,可以通过位运算 `num & (num - 1) == 0` 来实现。
这是因为num的二进制表示只有一个1,所以num-1的二进制表示只有一个0,所以num & (num - 1) == 0。
所以,判断一个数不是2的幂,就是 `(num & (num - 1)) != 0`。
"""
if num < 3: # 1和2不满足条件
return False
# 如果一个数是2的幂,它的二进制表示中只有一个1
# num & (num - 1) 的作用是消除最右边的1。
# 如果结果为0,说明num只有一个1,是2的幂。
# 如果结果不为0,说明num不是2的幂。
return (num & (num - 1)) != 0

数学推导详解

对于连续k个正整数的和:
$$\text{sum} = a + (a+1) + \ldots + (a+k-1) = ka + \frac{k(k-1)}{2}$$

整理得:
$$2 \times \text{sum} = k(2a + k - 1)$$

这说明 $2 \times \text{sum}$ 可以分解为两个因子的乘积,且一个是奇数,一个是偶数。

如果 $\text{sum} = 2^p$,则 $2 \times \text{sum} = 2^{p+1}$,所有因子都是偶数,无法满足一奇一偶的要求。

算法分析

  • 暴力枚举:时间复杂度 O(N²),空间复杂度 O(1)
  • 数学规律:时间复杂度 O(1),空间复杂度 O(1)

问题四:RED字符串好串计数

问题描述

可以用r、e、d三种字符拼接字符串,如果拼出来的字符串中有且仅有1个长度>=2的回文子串,那么这个字符串定义为”好串”。返回长度为n的所有可能的字符串中,好串有多少个。结果对 1000000007 取模,1 <= n <= 10^9。

核心思想

这是一个组合数学问题,通过暴力递归生成所有可能的字符串并检验,然后观察规律。

方法一:暴力递归

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
class Solution:
def num1(self, n: int) -> int:
"""
主函数,启动暴力递归生成所有字符串并检查
"""
path = [''] * n
return self._f(path, 0)

def _f(self, path: list, i: int) -> int:
"""
递归函数,生成所有长度为n的字符串
"""
if i == len(path): #这就是base case
# 字符串生成完毕,检查是否为"好串"
cnt = 0
# 遍历所有长度>=2的子串
for l in range(len(path)):
for r in range(l + 1, len(path)):
if self._is_palindrome(path, l, r):
cnt += 1
if cnt > 1:
# 超过1个回文子串,直接判定为非好串
return 0
# 最终检查回文子串数量是否正好为1
return 1 if cnt == 1 else 0
else:
# 在 i 位置尝试 'r', 'e', 'd' 三种字符
ans = 0
path[i] = 'r'
ans += self._f(path, i + 1)
path[i] = 'e'
ans += self._f(path, i + 1)
path[i] = 'd'
ans += self._f(path, i + 1)
return ans

def _is_palindrome(self, s: list, l: int, r: int) -> bool:
"""
辅助函数,检查子串是否为回文
"""
while l < r:
if s[l] != s[r]:
return False
l += 1
r -= 1
return True

方法二:规律观察

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
def num2(self, n: int) -> int:
"""
通过暴力解的结果,发现数学规律
核心思想:
运行 `num1` 得到:
n=1: 0
n=2: 3 (rr, ee, dd)
n=3: 18 (rre, rrd, rer, der, ...)
n=4: 30
n=5: 36
...
可以发现规律:
n=1 -> 0
n=2 -> 3
n=3 -> 18
n>3 -> ans(n-1) + 6,即为一个等差数列,通项公式为 `18 + (n-3)*6 = 6*n`。
但题目中的答案是 `6*(n+1)`,我们来验证
n=4: 6*(4+1)=30.
n=5: 6*(5+1)=36.
这个规律是正确的。所以可以直接用公式计算。
"""
mod = 1000000007
if n == 1:
return 0
if n == 2:
return 3
if n == 3:
return 18
# (6 * (n + 1)) % mod
return (6 * (n + 1)) % mod

规律分析

通过打表观察:

1
2
3
4
5
6
7
8
长度 : 好串数量
1 : 0 (无法构成长度>=2的回文)
2 : 3 (rr, ee, dd)
3 : 18
4 : 30 = 6×(4+1)
5 : 36 = 6×(5+1)
6 : 42 = 6×(6+1)
...

发现规律:

  • n=1: 0
  • n=2: 3
  • n=3: 18
  • n≥4: 6×(n+1)

算法分析

  • 暴力递归:时间复杂度 O(3^N × N³),空间复杂度 O(N)
  • 规律优化:时间复杂度 O(1),空间复杂度 O(1)

核心技巧总结

1. 对数器打表的通用流程

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
def solve_by_pattern_finding(n):
"""对数器打表找规律的标准流程"""

# 步骤1: 实现暴力解法
def brute_force_solution(n):
# 用最基本的递归或暴力方法实现
pass

# 步骤2: 打表观察规律
print("输入 : 输出")
for i in range(small_range):
result = brute_force_solution(i)
print(f"{i} : {result}")

# 步骤3: 根据观察到的规律实现优化解
def optimized_solution(n):
# 基于规律的O(1)或低复杂度解法
pass

return optimized_solution(n)

2. 递归 + 记忆化模板

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
def recursive_with_memo(params):
memo = {}

def helper(state):
if state in memo:
return memo[state]

# base case
if is_base_case(state):
return base_result

# 递归计算
result = calculate_from_subproblems(state)
memo[state] = result
return result

return helper(initial_state)

3. 博弈论问题模板

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
def game_theory_solution(state, current_player):
memo = {}

def can_win(state, player):
if (state, player) in memo:
return memo[(state, player)]

# base case
if is_terminal_state(state):
return determine_winner(state, player)

# 尝试所有可能的移动
for move in get_possible_moves(state):
new_state = apply_move(state, move)
opponent = get_opponent(player)

# 如果存在一步移动使得对手必败,当前玩家必胜
if can_win(new_state, opponent) == player:
memo[(state, player)] = player
return player

# 所有移动都无法获胜,当前玩家必败
opponent = get_opponent(player)
memo[(state, player)] = opponent
return opponent

return can_win(state, current_player)

4. 位运算判断2的幂

1
2
3
4
5
6
7
def is_power_of_two(n):
"""判断n是否为2的幂"""
return n > 0 and (n & (n - 1)) == 0

def is_not_power_of_two(n):
"""判断n是否不是2的幂"""
return n > 0 and (n & (n - 1)) != 0

复杂度分析总结

问题类型 暴力解复杂度 优化解复杂度 核心技巧
苹果袋子问题 O(N) O(1) 动态规划→数学规律
吃草博弈 O(N×logN) O(1) 博弈论→周期性规律
连续正整数和 O(N²) O(1) 数论→2的幂判断
好串计数 O(3^N×N³) O(1) 穷举打表→发现数学规律

学习建议

1. 掌握基础技能

  • 递归思维:熟练掌握递归的设计和实现
  • 动态规划:理解状态转移和最优子结构
  • 博弈论基础:了解必胜态和必败态的概念
  • 数学基础:具备基本的数论和组合数学知识

2. 培养观察能力

  • 模式识别:善于从数据中发现周期性、递推性等规律
  • 数学直觉:能够将观察到的规律转化为数学公式
  • 验证习惯:发现规律后及时验证其正确性

3. 实践要点

  • 小数据打表:从小规模数据开始,逐步观察规律
  • 多角度思考:尝试不同的观察角度和数学工具
  • 渐进优化:从暴力解→记忆化→数学公式的渐进优化过程

4. 常见规律类型

  • 周期性规律:如博弈问题中的周期性胜负模式
  • 递推关系:如斐波那契数列、等差数列等
  • 数学性质:如2的幂的位运算性质
  • 组合规律:如排列组合中的计数问题

5. 注意事项

  • 边界条件:特别注意小数据的边界情况
  • 数据范围:考虑大数据下的溢出和效率问题
  • 规律验证:确保发现的规律在所有情况下都成立
  • 代码实现:将数学规律正确转化为代码逻辑

通过掌握对数器打表找规律的技巧,可以将许多看似复杂的问题转化为简单的数学计算,大幅提升算法效率。这种方法在算法竞赛和实际工程中都有重要应用价值。

引言

参照的是左程云的课程:https://space.bilibili.com/8888480/lists/3509640?type=series

本笔记是class40的内容,基于N皇后问题Python实现,分析了经典回溯算法和位运算优化版本的原理与实现。N皇后问题是回溯算法的经典应用,也是展示位运算巧妙应用的绝佳案例。

040【必备】N皇后问题-重点是位运算的版本

n皇后问题描述

问题描述

N皇后问题是在N×N的棋盘上放置N个皇后,使得任意两个皇后都不能相互攻击的问题。皇后可以攻击同一行、同一列或同一对角线上的任何棋子。

测试链接:https://leetcode.cn/problems/n-queens-ii/

核心挑战

N皇后问题的时间复杂度是O(N!),这意味着随着N的增长,计算量会急剧增加。因此,优化常数时间和进行有效剪枝变得尤为重要。


方法一:数组表示路径(经典回溯)

核心思想

使用数组 path[i] = j 表示第i行的皇后放在第j列。对于每一行,尝试所有可能的列位置,通过冲突检测函数判断是否可以放置皇后。

具体实现流程:

  1. 在每一行,ban = col | left | right 计算出所有被攻击的位置。(共同的限制)
  2. candidate = limit & (~ban) 找出所有可以放置皇后的候选位置(列)。
  3. 循环遍历 candidate 中的每一个 1(代表一个可行的列)。
    place = candidate & (-candidate) 是一个巧妙的技巧,用于分离出最右边的 1。
  4. 对于每一个可行的 place,递归到下一行,并更新三个位掩码:
    • 列限制: col | place
    • 左对角线限制: (left | place) >> 1 (下一行,对角线向右移一位)
    • 右对角线限制: (right | place) << 1 (下一行,对角线向左移一位)

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
def totalNQueens1(self, n: int) -> int:
"""
主函数,初始化路径数组并启动递归
"""
if n < 1:
return 0
# path[i] = j 表示第 i 行的皇后放在了第 j 列
path = [-1] * n
return self._f1(0, path, n)

def _f1(self, i: int, path: list, n: int) -> int:
"""
递归函数,尝试在第 i 行放置皇后
核心思想 (经典回溯法):
1. 递归地为每一行选择一个列来放置皇后。
2. 当处理第 `i` 行时,遍历所有列 `j`。
3. 对于每个位置 `(i, j)`,检查是否与之前 `0` 到 `i-1` 行已放置的皇后冲突。
4. 如果不冲突,则将皇后放置在 `(i, j)`,然后递归到下一行 `i+1`。
5. 递归返回后,隐式地"撤销"选择(因为下一次循环会覆盖 `path[i]`),继续尝试当前行的下一列。
6. 当 `i` 到达 `n` 时,说明所有 `n` 个皇后都成功放置,找到一个解,返回 1。
"""
if i == n:
# 所有行都成功放置了皇后,找到一个有效的解
return 1

ans = 0
# 遍历当前 i 行的所有列 j
for j in range(n):
# 检查在 (i, j) 位置放皇后是否与之前的皇后冲突
if self._check(path, i, j):
# 如果不冲突,记录位置
path[i] = j
# 递归到下一行
ans += self._f1(i + 1, path, n)
return ans

def _check(self, path: list, i: int, j: int) -> bool:
"""
检查在(i,j)位置放置皇后是否会与之前的皇后冲突
"""
# 遍历 0 到 i-1 行,检查冲突
for k in range(i):
# path[k] 是第 k 行皇后的列位置
# 检查列冲突: j == path[k]
# 检查对角线冲突: abs(i - k) == abs(j - path[k])
if j == path[k] or abs(i - k) == abs(j - path[k]):
return False
return True

公共对角线的判断

冲突检测详解

  1. 列冲突:j == path[k] - 同一列不能有两个皇后
  2. 对角线冲突:abs(i - k) == abs(j - path[k]) - 对角线上行差的绝对值等于列差的绝对值

算法分析

  • 时间复杂度:O(N! × N),每个位置需要O(N)时间检查冲突
  • 空间复杂度:O(N)
  • 优缺点:思路清晰但效率较低

方法二:位运算优化(推荐)

核心思想

使用三个整数的位信息来表示所有被占用的位置,从而极大地加速冲突检测:

  • col:第k位为1表示第k列被占用
  • left:第k位为1表示左上到右下对角线被占用
  • right:第k位为1表示右上到左下对角线被占用

col变量
left变量

对角线映射规律

左上到右下对角线(left)

  • 特点:行-列的值相同
  • 下一行时:对角线向右移动一位,用右移操作 >> 1

右上到左下对角线(right)

  • 特点:行+列的值相同
  • 下一行时:对角线向左移动一位,用左移操作 << 1

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
def totalNQueens2(self, n: int) -> int:
"""
主函数,初始化 limit 并启动位运算递归
"""
if n < 1 or n > 32:
return 0
# n = 5 -> limit = 0b11111
# limit 用于标记棋盘的有效列范围
limit = (1 << n) - 1
return self._f2(limit, 0, 0, 0)

def _f2(self, limit: int, col: int, left: int, right: int) -> int:
"""
位运算递归函数

参数说明:
- limit: 标记棋盘大小的掩码
- col: 列占用情况
- left: 左上到右下对角线占用情况
- right: 右上到左下对角线占用情况
"""
if col == limit:
# 所有列都被占用,意味着所有皇后都已成功放置,找到一个解
return 1

# 总限制,合并所有被占用的列和对角线,limit表示是几皇后问题
ban = col | left | right
# ~ban : 1可放皇后,0不能放
# limit & (~ban) 得到当前行所有可以放置皇后的位置
candidate = limit & (~ban) #Python 的整数是无限位的,~ban 会把高位也翻成 1,需要用 limit 把有效的 n 位以外的位裁掉。

ans = 0
# 当还有候选位置时
while candidate != 0:
# 提取出最右侧的1,代表本次尝试要放置皇后的位置
# 例如 candidate = 0b010100, -candidate = 0b101100
# place = 0b000100
place = candidate & (-candidate)

# 从候选位置中移除刚刚选择的位置
candidate ^= place

# 递归到下一行,并更新限制
ans += self._f2(limit, col | place, (left | place) >> 1, (right | place) << 1) #最终返回的 ans 是:该 n 皇后问题的解的总数
# col | place: 更新占用列;| 为按位或,把新放皇后的位置并入列占用。
# (left | place) >> 1: 更新左对角占用;当前行对角占用并上新位置后,右移一位表示到下一行左对角“向右移”。
# (right | place) << 1: 更新右对角占用;到下一行右对角“向左移”,用左移一位表示。

return ans

关键位运算技巧

1. 提取最右边的1

1
place = candidate & (-candidate)
  • 原理:-candidate 是 candidate 的补码,两者相与得到最右边的1
  • 例子:candidate = 0b010100, -candidate = 0b101100, place = 0b000100

2. 移除已选择的位

1
candidate ^= place
  • 使用异或操作移除已经选择的位置

3. 计算有效候选位置

1
candidate = limit & (~ban)
  • ~ban:翻转ban得到可放置的位置
  • limit:确保只考虑有效的n位棋盘范围

执行过程示例

以4皇后问题为例:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
初始状态:
limit = 0b1111 (4位棋盘)
col = 0, left = 0, right = 0

第1行:
ban = 0, candidate = 0b1111
可选位置:第0,1,2,3列

选择第0列 (place = 0b0001):
下一行状态:col=0b0001, left=0b0010, right=0b0010

第2行:
ban = 0b0001 | 0b0010 | 0b0010 = 0b0011
candidate = 0b1111 & 0b1100 = 0b1100
可选位置:第2,3列

... 继续递归

算法分析

  • 时间复杂度:O(N!),但常数时间大幅优化
  • 空间复杂度:O(N)
  • 优势:位运算操作极快,适合大规模问题

性能对比

根据代码测试结果:(测试电脑:联想ThinkBook 16+)

N值 数组方法 位运算方法 性能提升
14 188224 9011 约10倍
14 超时 ~10秒内 数十倍

测试代码

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
if __name__ == '__main__':
s = Solution()
n = 14

# 测试方法1
start_time = time.time()
ans1 = s.totalNQueens1(n)
end_time = time.time()
print(f"方法1答案 : {ans1}")
print(f"方法1运行时间 : {int((end_time - start_time) * 1000)} 毫秒")

# 测试方法2
start_time = time.time()
ans2 = s.totalNQueens2(n)
end_time = time.time()
print(f"方法2答案 : {ans2}")
print(f"方法2运行时间 : {int((end_time - start_time) * 1000)} 毫秒")

位运算核心技巧总结

1. 基本位操作

1
2
3
4
5
6
7
8
9
10
11
# 设置第i位为1
num |= (1 << i)

# 清除第i位
num &= ~(1 << i)

# 检查第i位是否为1
if num & (1 << i):

# 翻转第i位
num ^= (1 << i)

2. 高级位技巧

1
2
3
4
5
6
7
8
# 提取最右边的1
rightmost_one = num & (-num)

# 清除最右边的1
num &= (num - 1)

# 创建n位全1的掩码
mask = (1 << n) - 1

3. 对角线映射

1
2
3
4
5
# 左上到右下:下一行右移
left_diag = (left_diag | place) >> 1

# 右上到左下:下一行左移
right_diag = (right_diag | place) << 1

优化策略总结

1. 数据结构选择

  • 数组方法:直观但需要O(N)时间检查冲突
  • 位运算方法:用位信息表示状态,O(1)时间冲突检测

2. 状态表示优化

  • 用整数的二进制位表示多个布尔状态
  • 利用位运算的并行性处理多个位

3. 算法剪枝

  • 早期冲突检测
  • 状态压缩减少内存访问

4. 常数优化

  • 位运算替代数组操作
  • 减少函数调用开销

学习要点

1. 回溯算法模板

1
2
3
4
5
6
7
8
9
10
def backtrack(state):
if is_solution(state):
record_solution(state)
return

for choice in get_choices(state):
if is_valid(choice, state):
make_choice(choice, state)
backtrack(state)
undo_choice(choice, state) # 回溯

2. 位运算在算法中的应用

  • 状态压缩
  • 集合操作
  • 快速计算
  • 空间优化

3. 性能优化思路

  • 算法层面:减少时间复杂度
  • 实现层面:优化常数因子
  • 数据结构层面:选择合适的表示方式

4. 问题分析方法

  • 理解问题约束
  • 识别状态表示
  • 设计状态转移
  • 考虑优化空间

实际应用场景

1. 约束满足问题(CSP)

  • 数独求解
  • 图着色问题
  • 任务调度

2. 位运算优化适用场景

  • 状态空间较小(通常≤64位)
  • 需要频繁的集合操作
  • 对性能要求极高的场景

3. 工程实践建议

  • 先实现清晰版本,再考虑优化
  • 位运算虽快但可读性差,需要充分注释
  • 在性能关键路径上应用位运算优化

总结

N皇后问题展示了从经典回溯算法到位运算优化的完整演进过程。位运算版本虽然理解难度较高,但在性能上有显著提升,特别适合处理大规模问题。掌握这种优化思路对于解决其他状态空间搜索问题具有重要意义。

通过对比两种方法,我们可以看到算法优化的不同层次:算法设计层面的改进和实现技巧层面的优化。在实际工程中,应该根据具体需求在代码可读性和执行效率之间做出合理权衡。