参照的是左程云的课程:https://space.bilibili.com/8888480/lists/3509640?type=series
本笔记包括了基数排序的原理与实现,以及重要排序算法的性能总结与选择策略,包括了class028 -> class029的内容
028【必备】基数排序
基数排序概述
基数排序是一种非基于比较的排序算法,它通过对数字的每一位进行排序来实现整体排序。与其他基于比较的排序算法不同,基数排序对数据类型有特定要求。
测试链接:https://www.luogu.com.cn/problem/P1177
基于比较 vs 非基于比较的排序
基于比较的排序:
- 只需要定义好两个对象之间怎么比较即可
- 对象的数据特征并不关心,很通用
- 例如:快速排序、归并排序、堆排序等
非基于比较的排序:
- 和比较无关的排序,对于对象的数据特征有要求
- 并不通用,但在特定条件下效率极高
- 例如:计数排序、桶排序、基数排序
从计数排序到基数排序
计数排序
计数排序是最简单的非比较排序算法:
- 用一个数组或哈希表来记录每个数字出现的次数
- 遍历数组统计,然后按顺序输出
- 限制:数值范围比较大时就不实用了
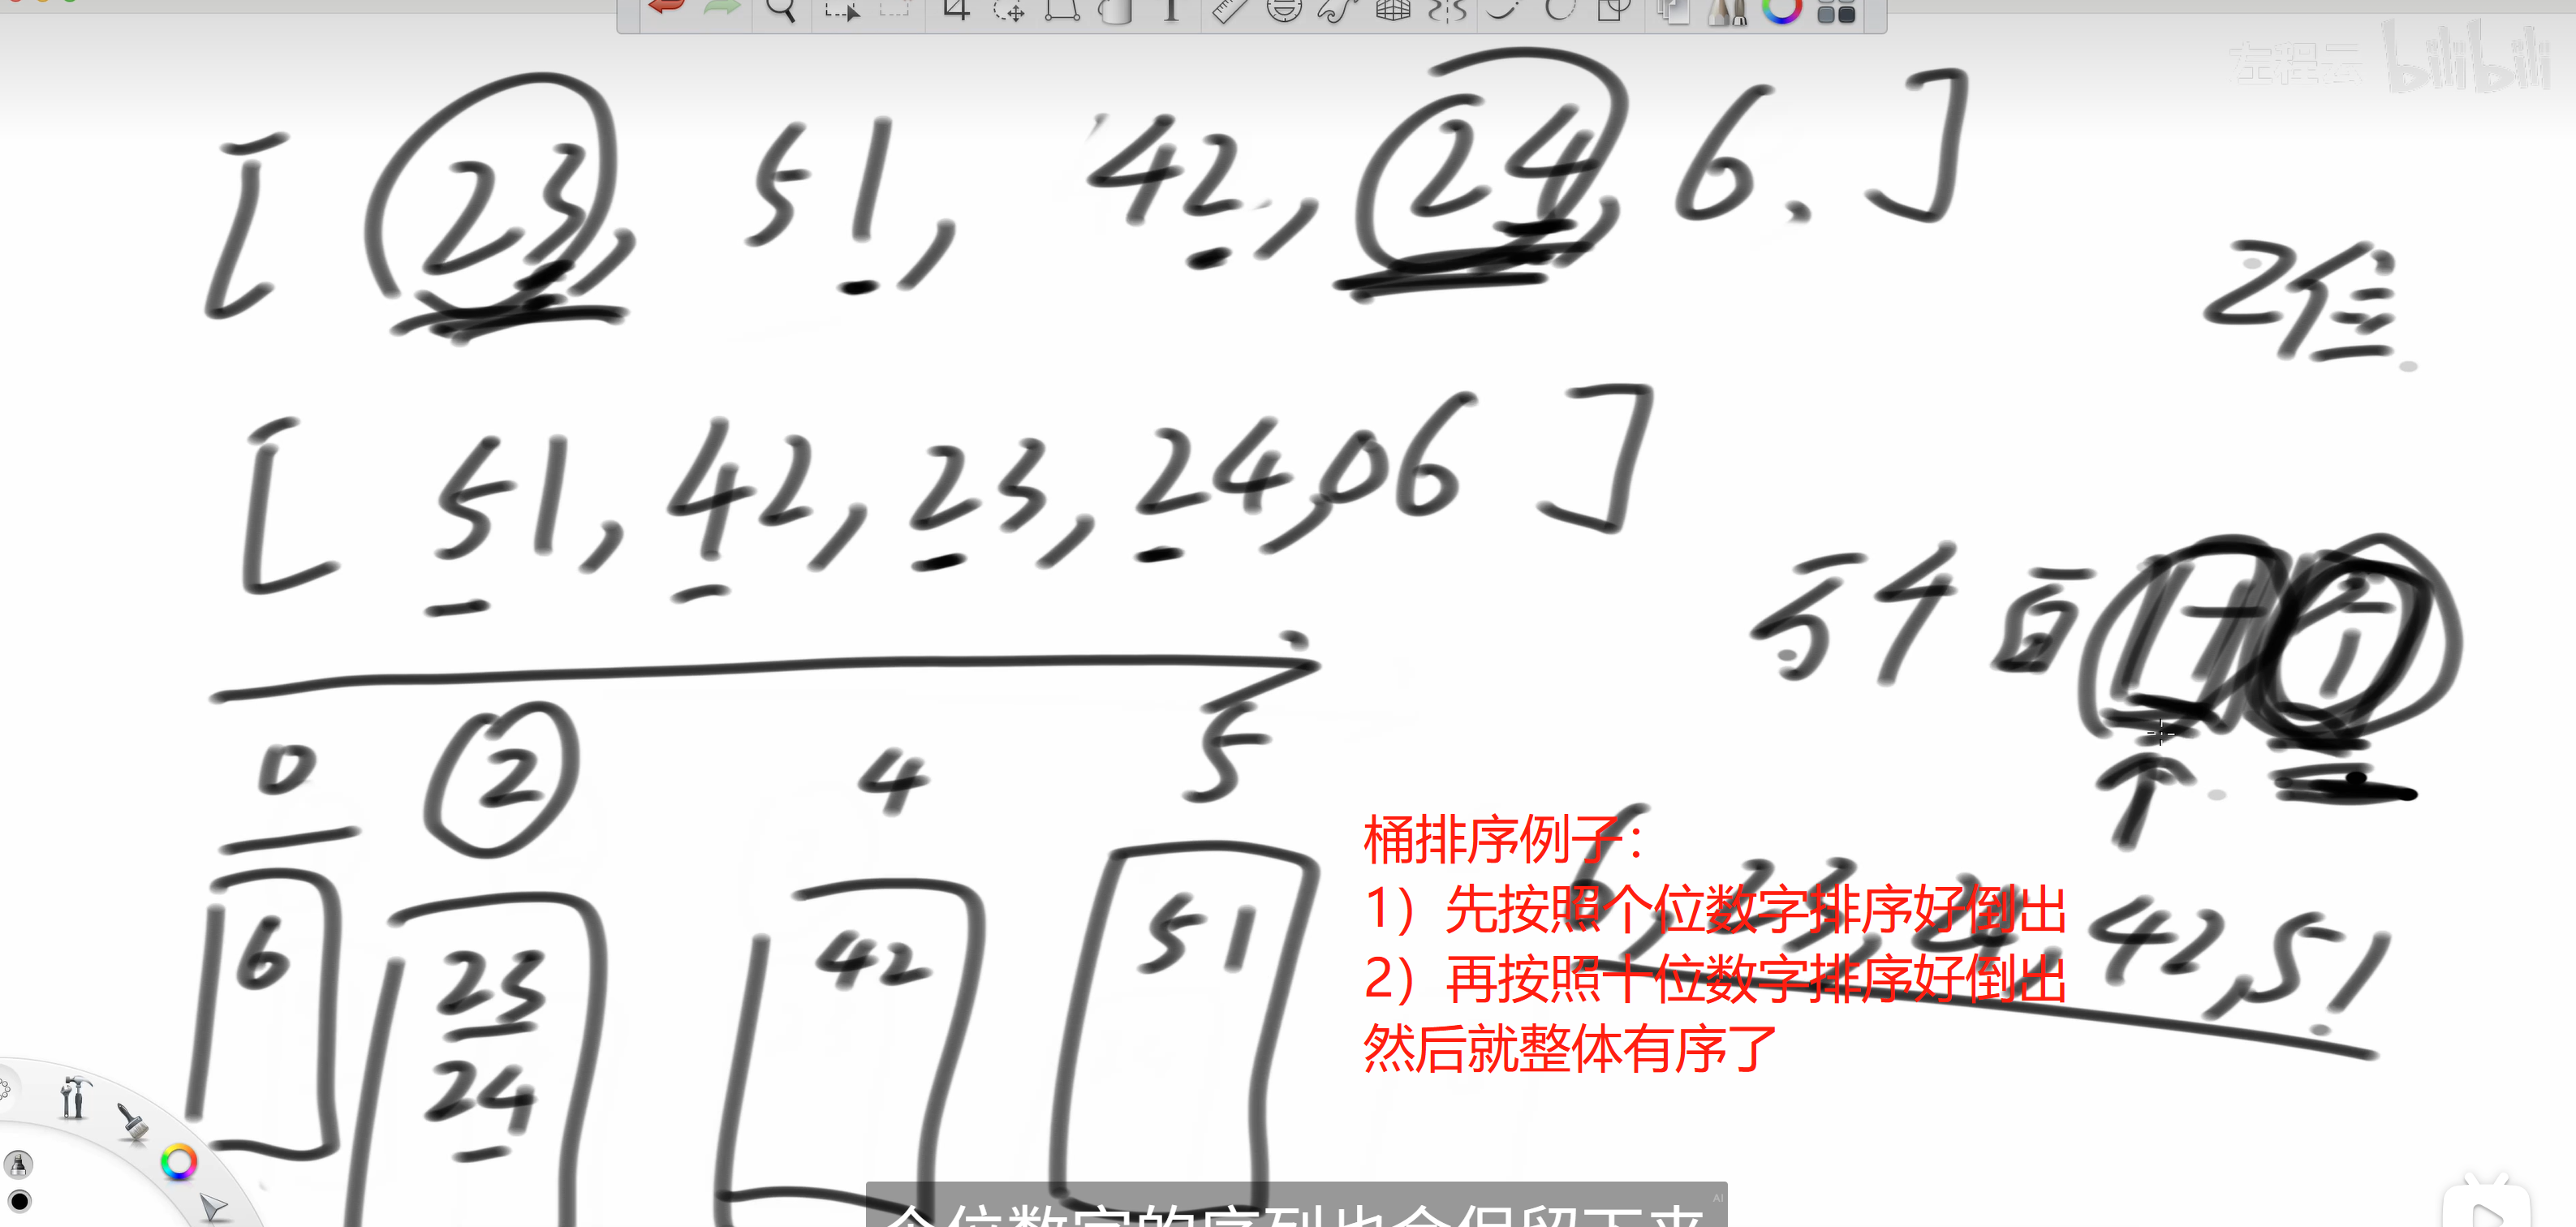
桶排序
桶排序是计数排序的升级版:
- 将数据分到有限数量的桶里,然后对每个桶再分别排序,最后合并
- 计数排序可以看成每个桶只存储相同元素
- 桶排序每个桶存储一定范围的元素
- 需要确定两个信息:桶的数量和每个桶的区间范围
基数排序
基数排序进一步优化了桶的使用:
- 按位进行排序,比如先按个位数字放进桶里再倒出,再按十位数字放进桶里再倒出
- 这样就得到一个有序的序列
基数排序的核心思想
基数排序采用**LSD(Least Significant Digit)**策略,从最低位开始排序:
- 从个位开始:按个位数字进行计数排序
- 依次向高位:按十位、百位、千位…依次排序
- 保持稳定性:每次排序都要保持之前排序的相对顺序
关键点:
- 前缀数量分区的技巧
- 数字提取某一位的技巧
- 时间复杂度O(n),额外空间复杂度O(m)
基数排序实现详解
核心代码结构
1 | # 可以设置进制,不一定10进制 |
处理负数的技巧
由于基数排序要求非负整数,需要特殊处理负数:
1 | def sort(): |
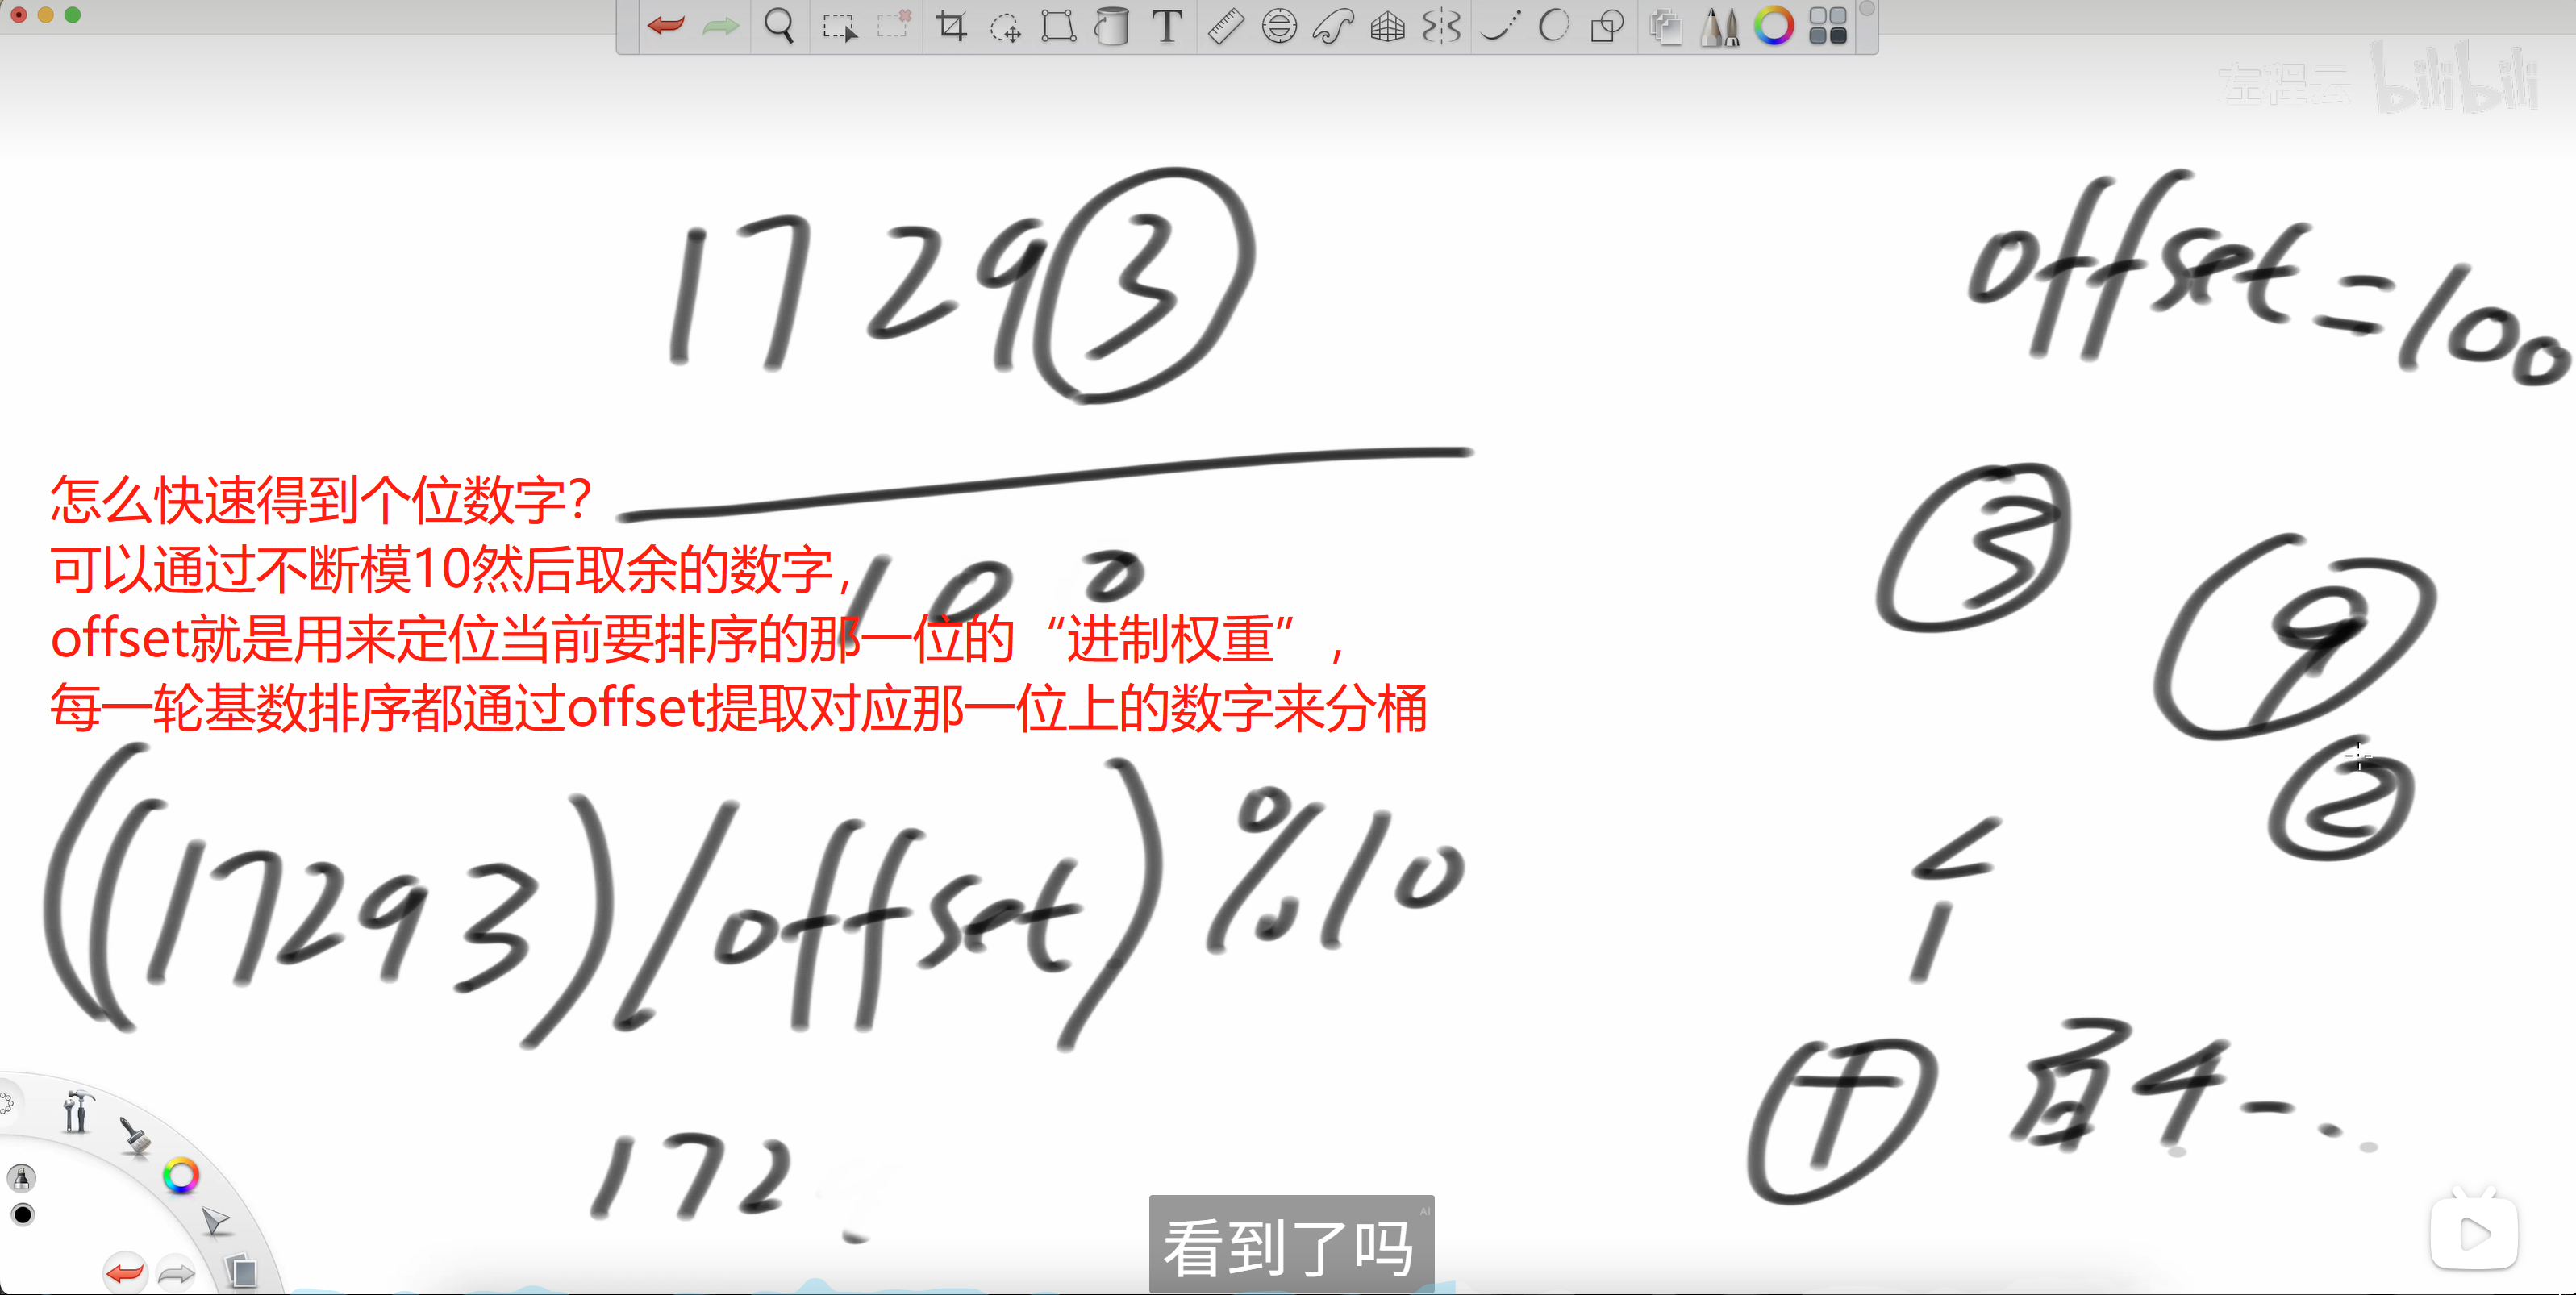
计算位数
1 | def bits(number): |
基数排序核心算法
1 | def radixSort(bits_): |
算法详细步骤演示
以数组 [170, 45, 75, 90, 2, 802, 24, 66] 为例:
初始数组:[170, 45, 75, 90, 2, 802, 24, 66]
第一轮(个位排序)
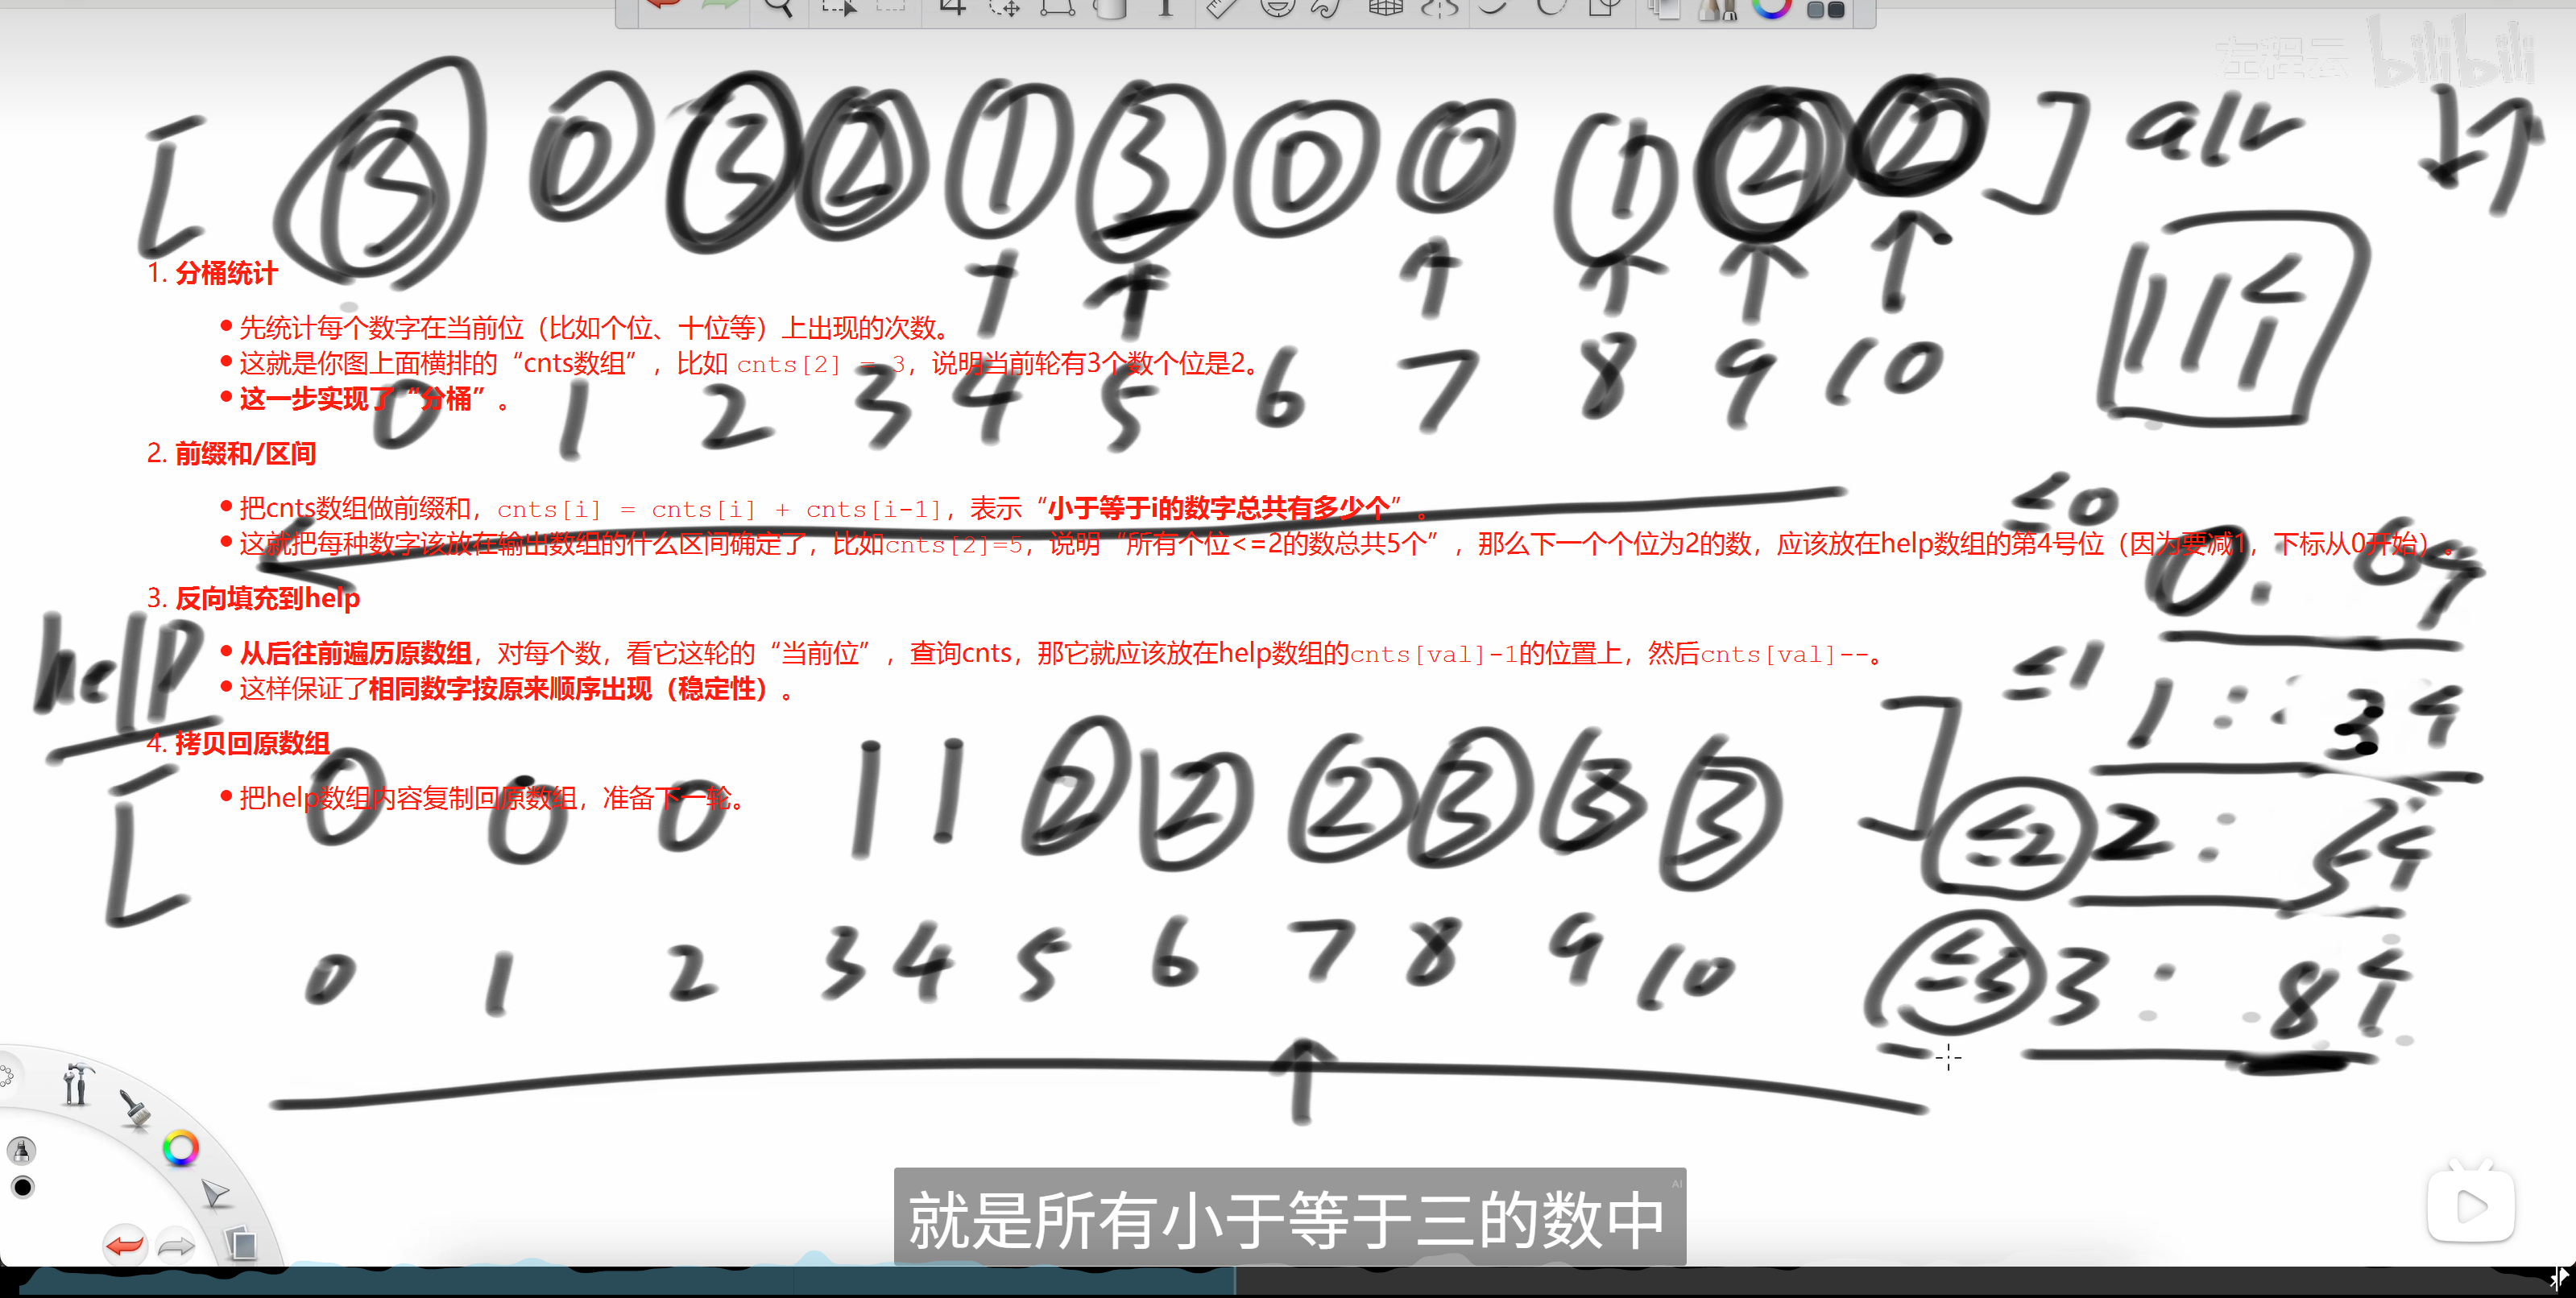
Step 1 - 统计个位数字:
1 | 个位: [0, 5, 5, 0, 2, 2, 4, 6] |
Step 2 - 计算前缀和:
1 | cnts: [2, 2, 4, 4, 5, 7, 8, 8, 8, 8] |
Step 3 - 从后往前放置:
1 | 结果: [170, 90, 2, 802, 24, 45, 75, 66] |
第二轮(十位排序)
Step 1 - 统计十位数字:
1 | 十位: [7, 9, 0, 0, 2, 4, 7, 6] |
Step 2 - 计算前缀和并放置:
1 | 结果: [2, 802, 24, 45, 66, 170, 75, 90] |
第三轮(百位排序)
最终结果:[2, 24, 45, 66, 75, 90, 170, 802]
稳定性保证
基数排序的稳定性通过以下方式保证:
- 从后往前处理:在放入辅助数组时从后往前遍历原数组
- 前缀和技巧:使用前缀和确定每个元素在结果数组中的准确位置
- 逐位处理:每一位的排序都保持前一位排序的相对顺序
1 | # 关键:从后往前,确保稳定性 |
复杂度分析
时间复杂度:O(n)
- 设最大数有d位,需要进行d轮排序
- 每轮排序需要O(n + k)时间,其中k是基数(通常k=10)
- 总时间复杂度:O(d × (n + k)) ≈ O(n)
空间复杂度:O(m)
- m为基数大小,需要辅助空间做类似桶的作用
- 包括辅助数组help_arr和计数数组cnts
应用限制
一般来讲,基数排序要求:
- 样本是10进制的非负整数
- 如果不是就需要转化(如代码中处理负数的方式)
- 可以设置任何进制来进行排序
局限性:
- 一旦比较的对象不再是常规数字,改写代价显著增加
- 不基于比较的排序并不通用
029【必备】重要排序算法的总结
排序算法稳定性
稳定性定义
排序算法的稳定性是指:同样大小的样本在排序之后不会改变原始的相对次序。
重要性:
- 稳定性对基础类型对象来说毫无意义
- 稳定性对非基础类型对象有意义,可以保留之前的相对次序
主要排序算法性能总结
| 排序算法 | 时间复杂度 | 空间复杂度 | 稳定性 | 备注 |
|---|---|---|---|---|
| SelectionSort 选择排序 |
O(N²) | O(1) | ❌ | 因为是随机的交换 |
| BubbleSort 冒泡排序 |
O(N²) | O(1) | ✅ | 数学归纳法可以保证 |
| InsertionSort 插入排序 |
O(N²) | O(1) | ✅ | 相等会直接停,能够保证稳定性 |
| MergeSort 归并排序 |
O(N log N) | O(N) | ✅ | 左右两边的区域满足偏序性 |
| QuickSort 快速排序 |
O(N log N) | O(log N) | ❌ | 普通的是固定选择,随机的随机选择 |
| HeapSort 堆排序 |
O(N log N) | O(1) | ❌ | 建堆的过程根本不在乎稳不稳定 |
| CountSort 计数排序 |
O(N) | O(M) | ✅ | 入桶和出桶的过程是按次序的 |
| RadixSort 基数排序 |
O(N) | O(M) | ✅ | 同计数排序 |
关键说明
随机快速排序的复杂度:
- 一定要按照概率上的期望指标来估计
- 用最差的复杂度估计无意义
- 随机快排的详细说明在之前的视频中已有详细解释
重要结论:
基于比较的排序,时间复杂度O(n log n),空间复杂度低于O(n),还具有稳定性的排序算法目前没有找到
TimSort说明:
- TimSort也不行,虽然在实际应用中通常不需要这么多的额外空间
- 但空间复杂度指标就是O(n)
- 在算法面试、笔试、比赛中都很少用到
希尔排序(ShellSort):
- 也不常用,就是加入步长调整的插入排序
- 有兴趣的同学可以研究一下
排序算法选择策略
排序算法的选择完全取决于你在排序过程中在乎什么:
1. 数据量非常小的情况
推荐:插入排序
- 可以做到非常迅速
- 实现简单,常数项小
- 很多高级排序算法在小数据量时会切换到插入排序
2. 性能优异 + 实现简单 + 不在乎稳定性
推荐:随机快速排序
- 性能优异,期望时间复杂度O(n log n)
- 实现简单且利于改进
- 面对不同业务可以选择不同划分策略
- 空间复杂度较小O(log n)
3. 性能优异 + 需要稳定性 + 不在乎额外空间
推荐:归并排序
- 性能优异,稳定的O(n log n)时间复杂度
- 具有稳定性
- 适合外部排序(大数据量)
- 空间复杂度O(n)
4. 性能优异 + 额外空间要求O(1) + 不在乎稳定性
推荐:堆排序
- 性能优异,稳定的O(n log n)时间复杂度
- 额外空间占用O(1)
- 最坏情况下性能依然稳定
- 不具有稳定性
5. 特定数据特征 + 追求极致性能
推荐:基数排序/计数排序
- 在特定条件下可以达到O(n)时间复杂度
- 对数据类型有严格要求
- 适用于整数排序且范围有限的场景
实际应用建议
编程竞赛/面试
- 快速排序:最常考查,需要熟练掌握
- 归并排序:稳定性要求时的首选
- 堆排序:空间复杂度有严格限制时
工程实践
- 小数组:插入排序
- 大数组:快速排序(随机化)
- 需要稳定性:归并排序
- 内存敏感:堆排序
- 特殊数据:计数排序/基数排序
语言内置排序
大多数编程语言的内置排序算法都是混合算法:
- Python:Timsort(归并+插入的混合)
- Java:双轴快排(小数组时用插入排序)
- C++:通常是内省排序(快排+堆排序+插入排序的混合)
总结
理解各种排序算法的特点和适用场景比单纯记忆算法更重要。在实际应用中,需要根据具体需求(数据规模、稳定性要求、空间限制等)来选择合适的排序算法。基数排序作为非比较排序的代表,在特定场景下能够突破O(n log n)的理论下界,达到线性时间复杂度。