前言 参照的是左程云的课程:https://space.bilibili.com/8888480/lists/3509640?type=series
本笔记涵盖了堆的基本概念与堆排序、哈希表的实现以及堆结构的一些相关习题,包括了class025→027的内容。
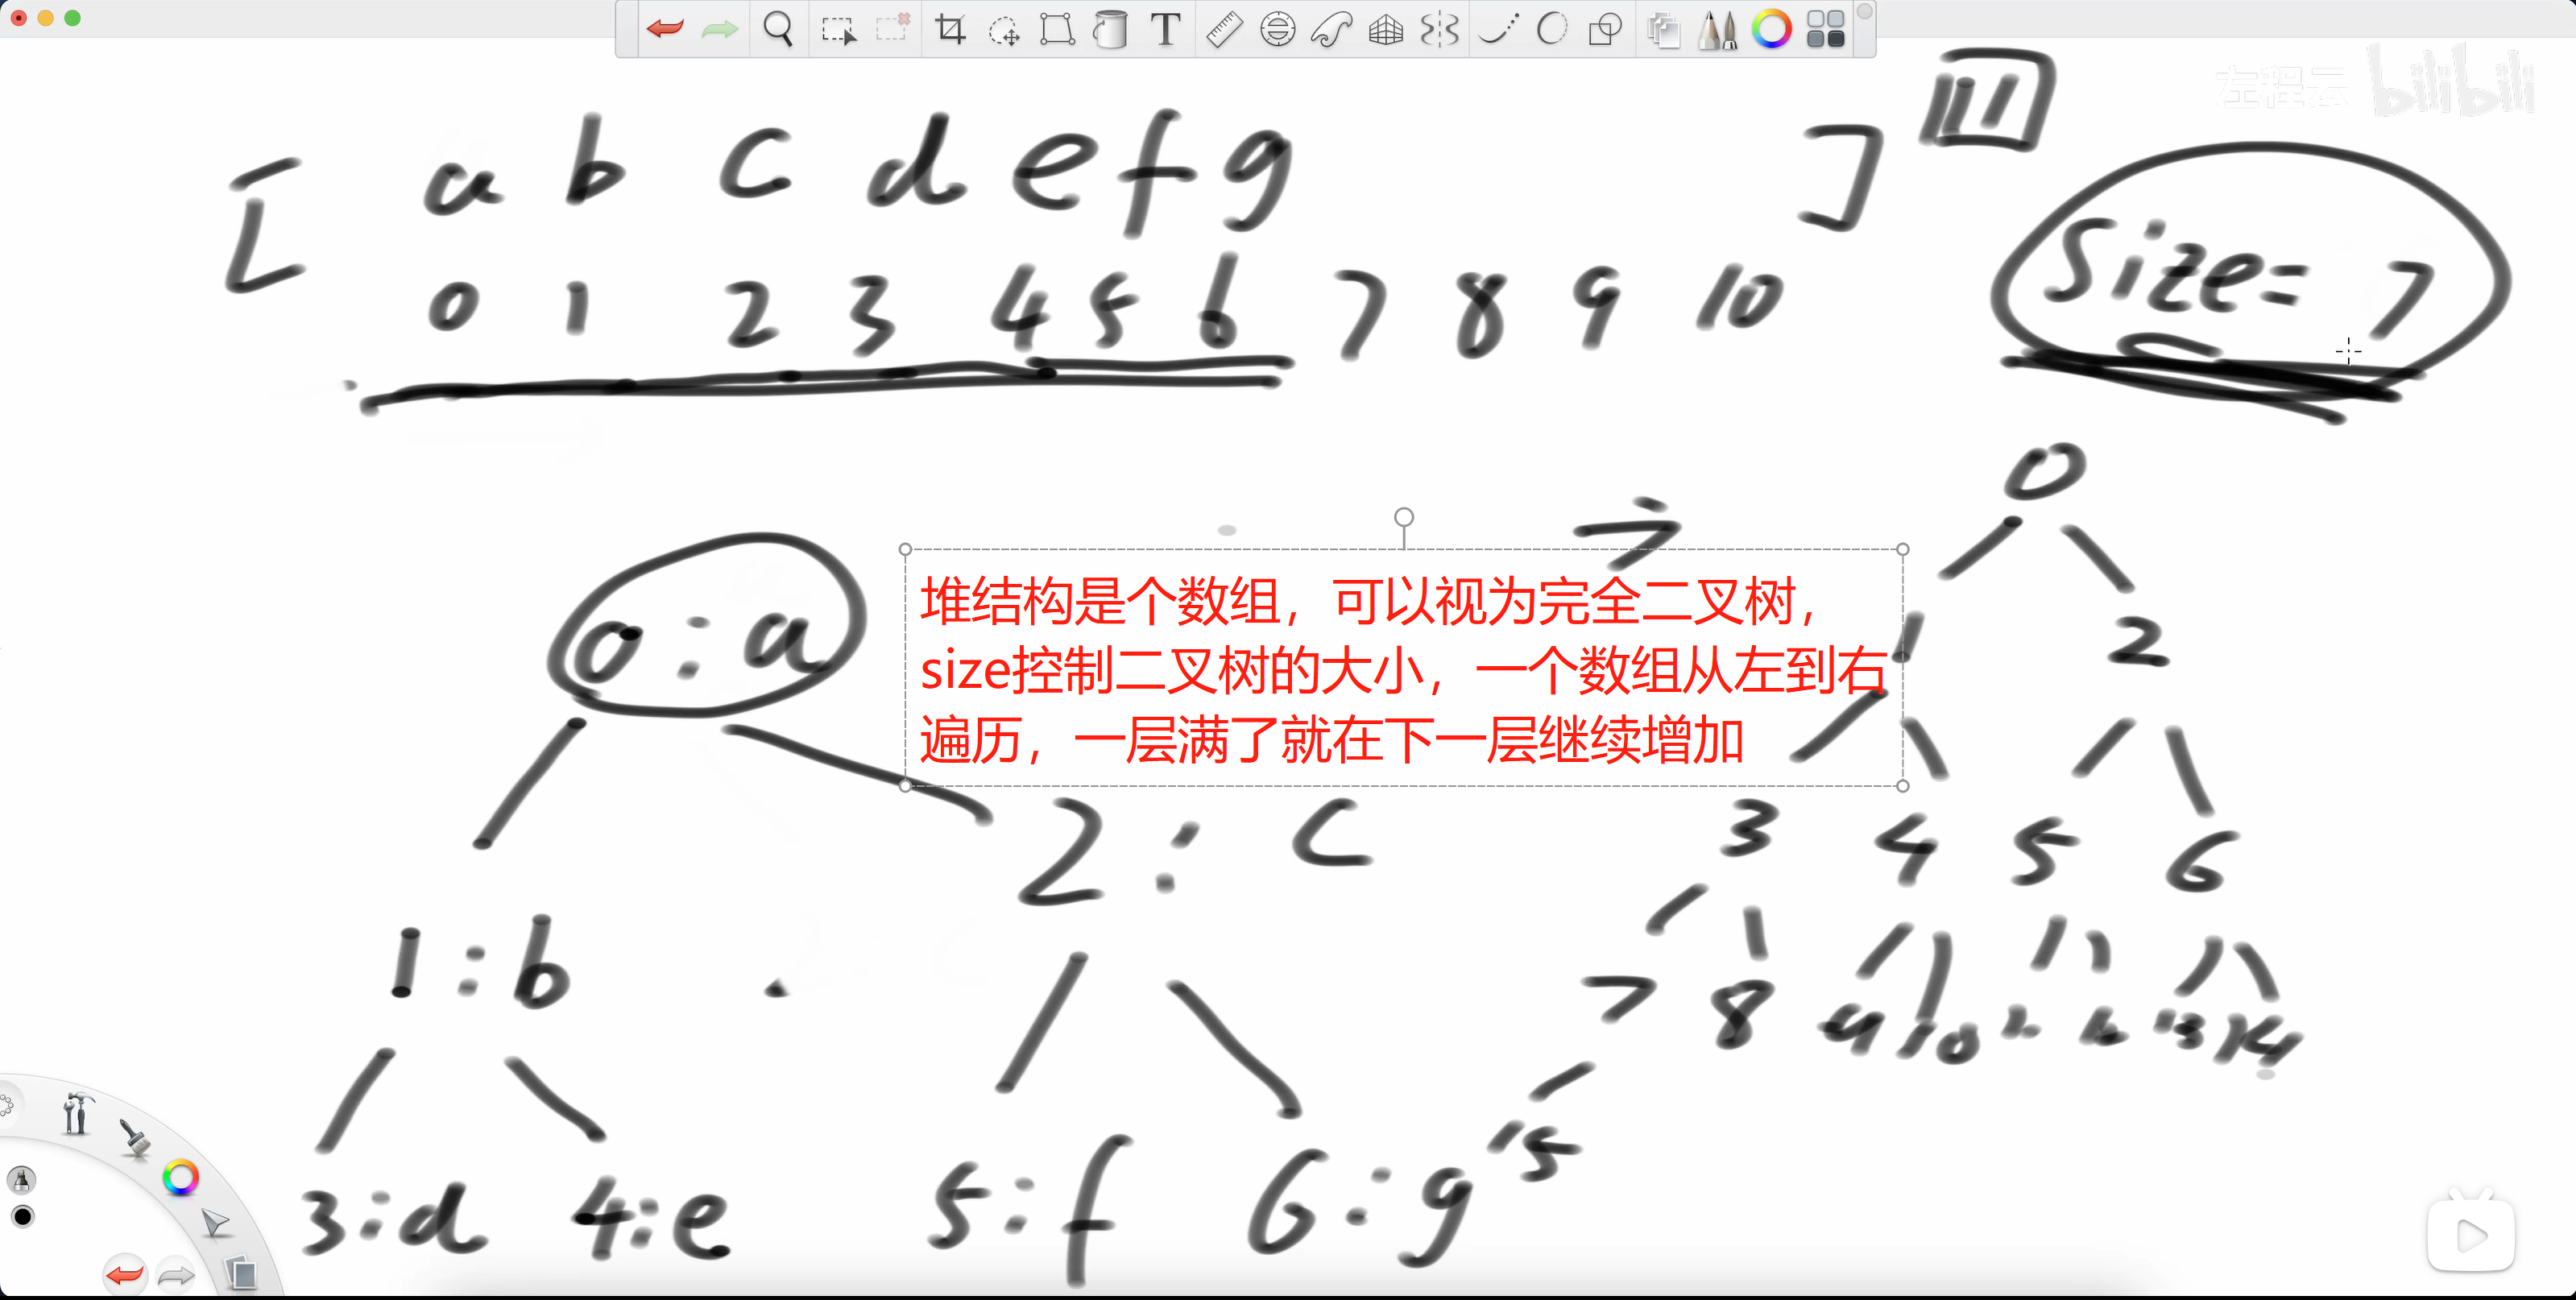
025【必备】堆结构和堆排序 堆的基本概念 什么是堆 堆是一种特殊的完全二叉树 结构,通常用数组来实现存储。堆有以下特性:
结构性质 :堆是完全二叉树,即除了最后一层,其他层都是满的,最后一层从左到右连续填充堆序性质 :
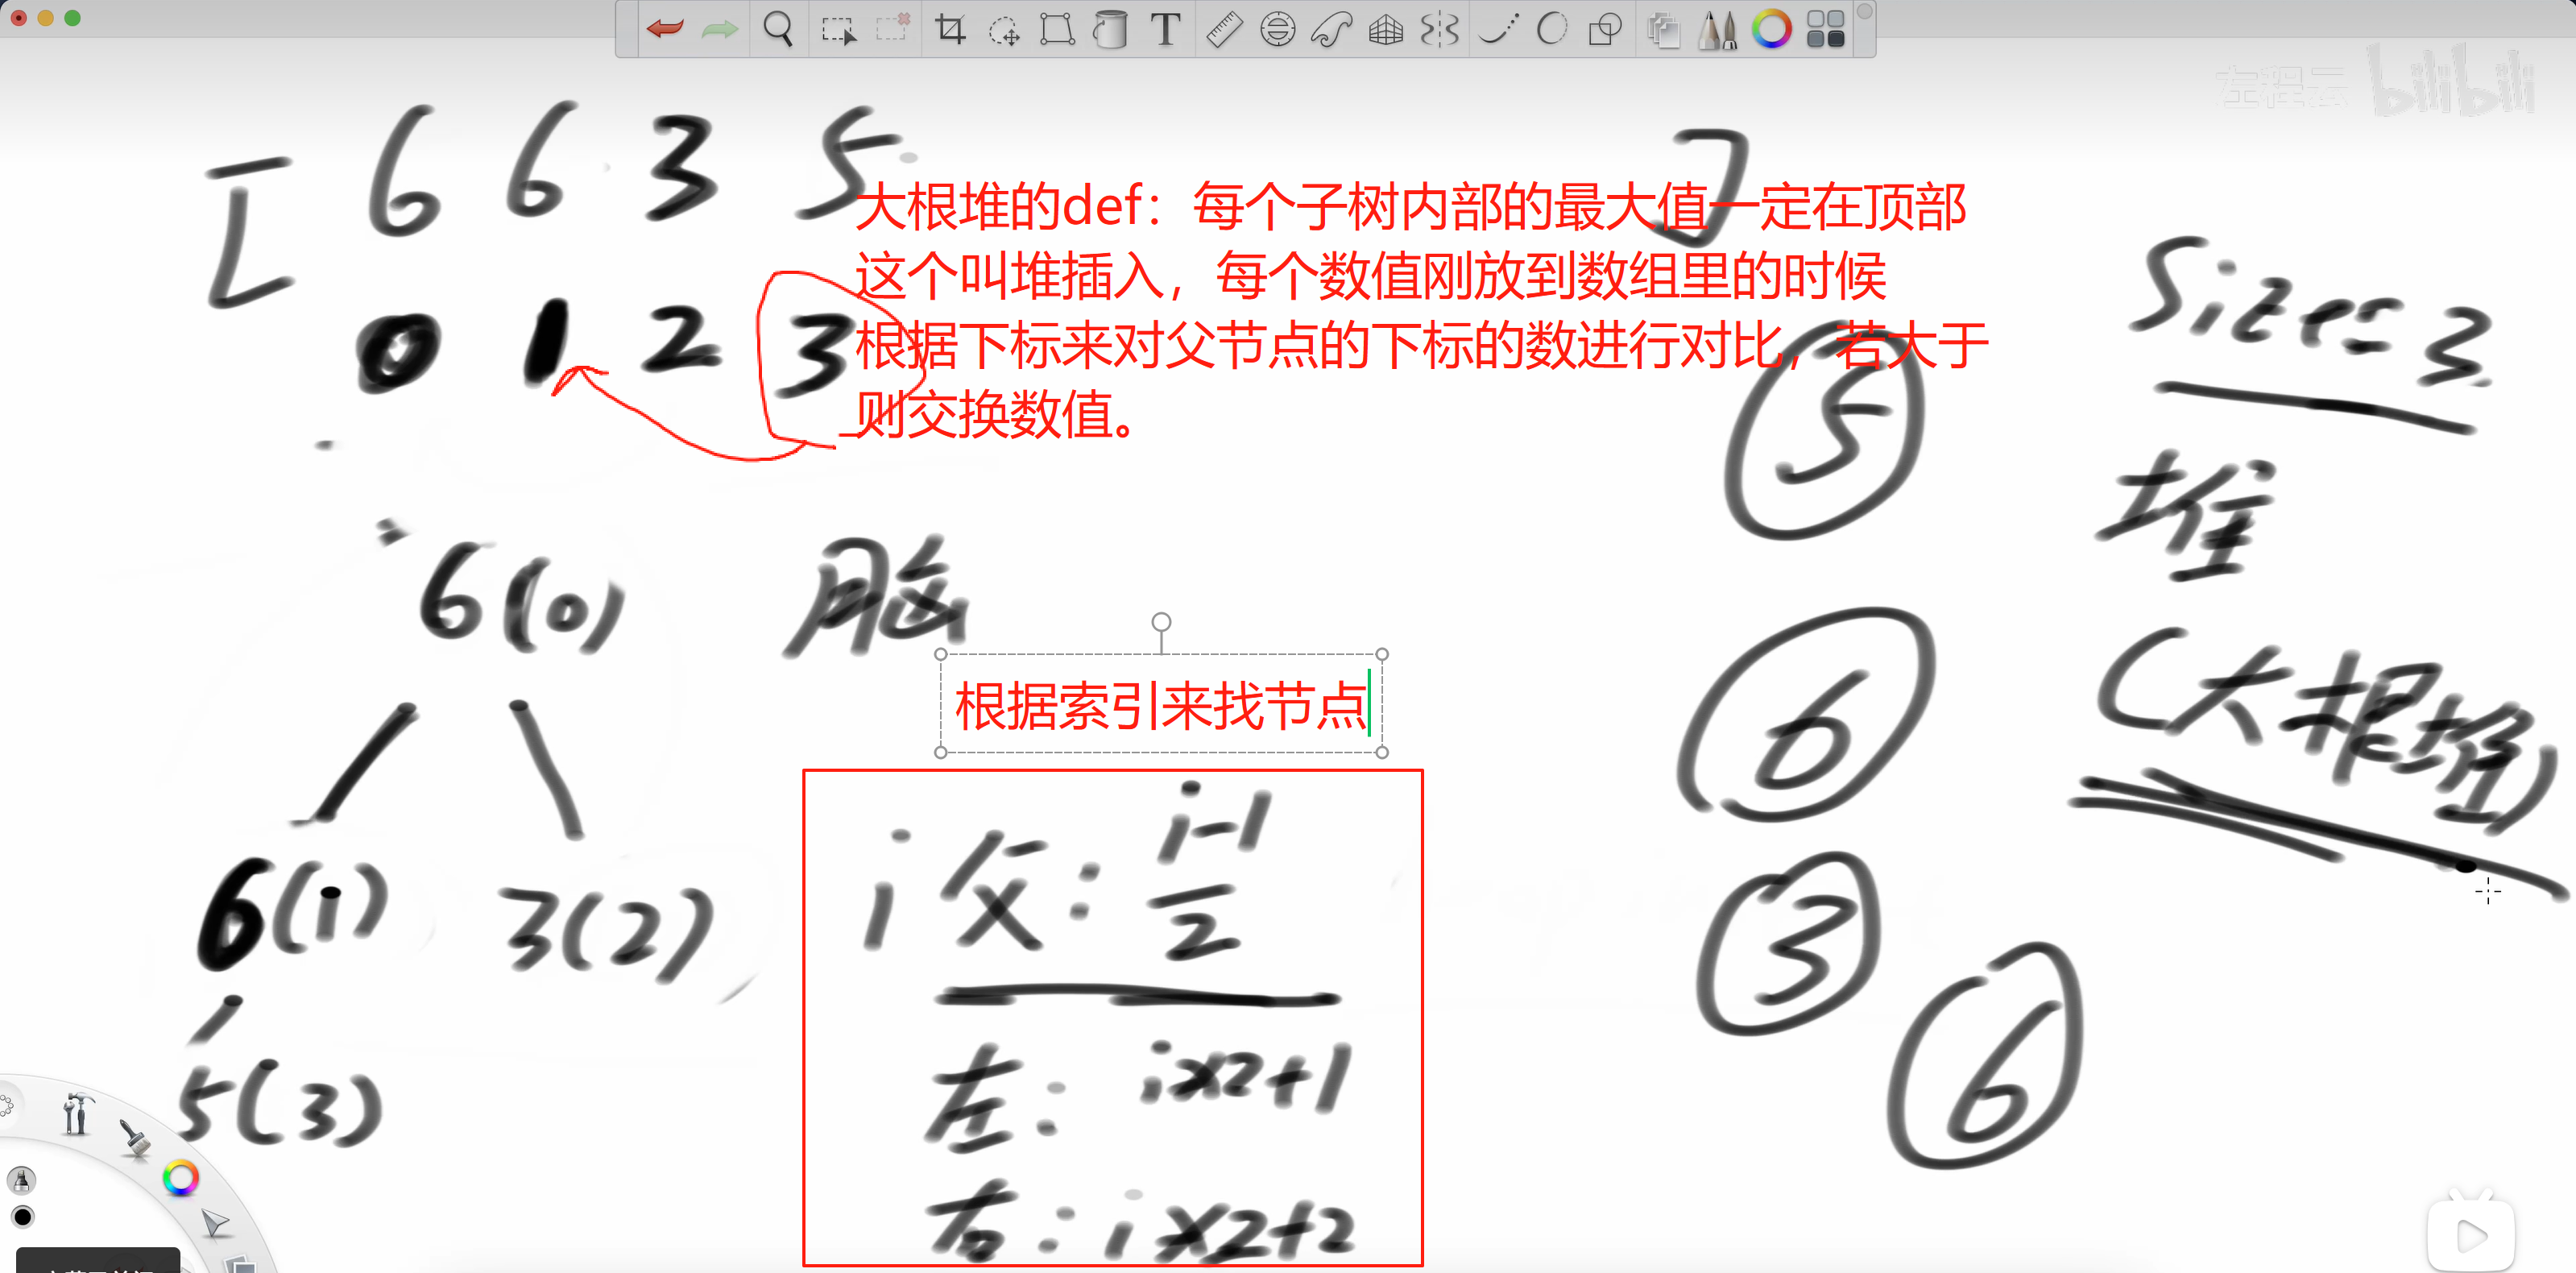
大根堆 :任何一个子树内部的最大值一定在顶部(父节点 ≥ 子节点)小根堆 :任何一个子树内部的最小值一定在顶部(父节点 ≤ 子节点)
堆的数组表示 堆使用数组实现,通过下标关系来表示父子关系:
1 2 3 4 5 6 7 8 parent = (i - 1 ) // 2 left_child = i * 2 + 1 right_child = i * 2 + 2
堆的核心操作 堆有两个核心调整操作,时间复杂度都是 O(log n) :
heapInsert(向上调整) :新元素插入后向上调整维持堆性质heapify(向下调整) :删除堆顶后向下调整维持堆性质
堆的核心算法实现 heapInsert - 向上调整 当在堆的末尾插入新元素时,需要向上调整以维持堆的性质:
1
2
3
4
5
6
7
8
def heapInsert (i ): """ i位置的数,向上调整大根堆 时间复杂度:O(logn) """ while arr[i] > arr[(i - 1 ) // 2 ]: swap(i, (i - 1 ) // 2 ) i = (i - 1 ) // 2
算法流程 :
比较当前节点与其父节点的值
如果当前节点更大(大根堆),则交换
向上移动到父节点位置,重复过程
直到满足堆性质或到达根节点
测试链接 :https://www.luogu.com.cn/problem/P1177
heapify - 向下调整 当删除堆顶元素后,需要向下调整以维持堆的性质:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
def heapify (i, size ): """ i位置的数,向下调整大根堆 当前堆的大小为size 时间复杂度:O(logn) """ l = i * 2 + 1 while l < size: best = l + 1 if (l + 1 < size and arr[l + 1 ] > arr[l]) else l best = best if arr[best] > arr[i] else i if best == i: break swap(best, i) i = best l = i * 2 + 1
算法流程 :
找到更大的子节点:比较左右子节点,选出值更大的那个
与父节点比较:将较大的子节点与当前父节点比较
决定是否交换:如果子节点更大就交换,否则停止调整
继续向下:交换后继续对新位置进行同样的操作
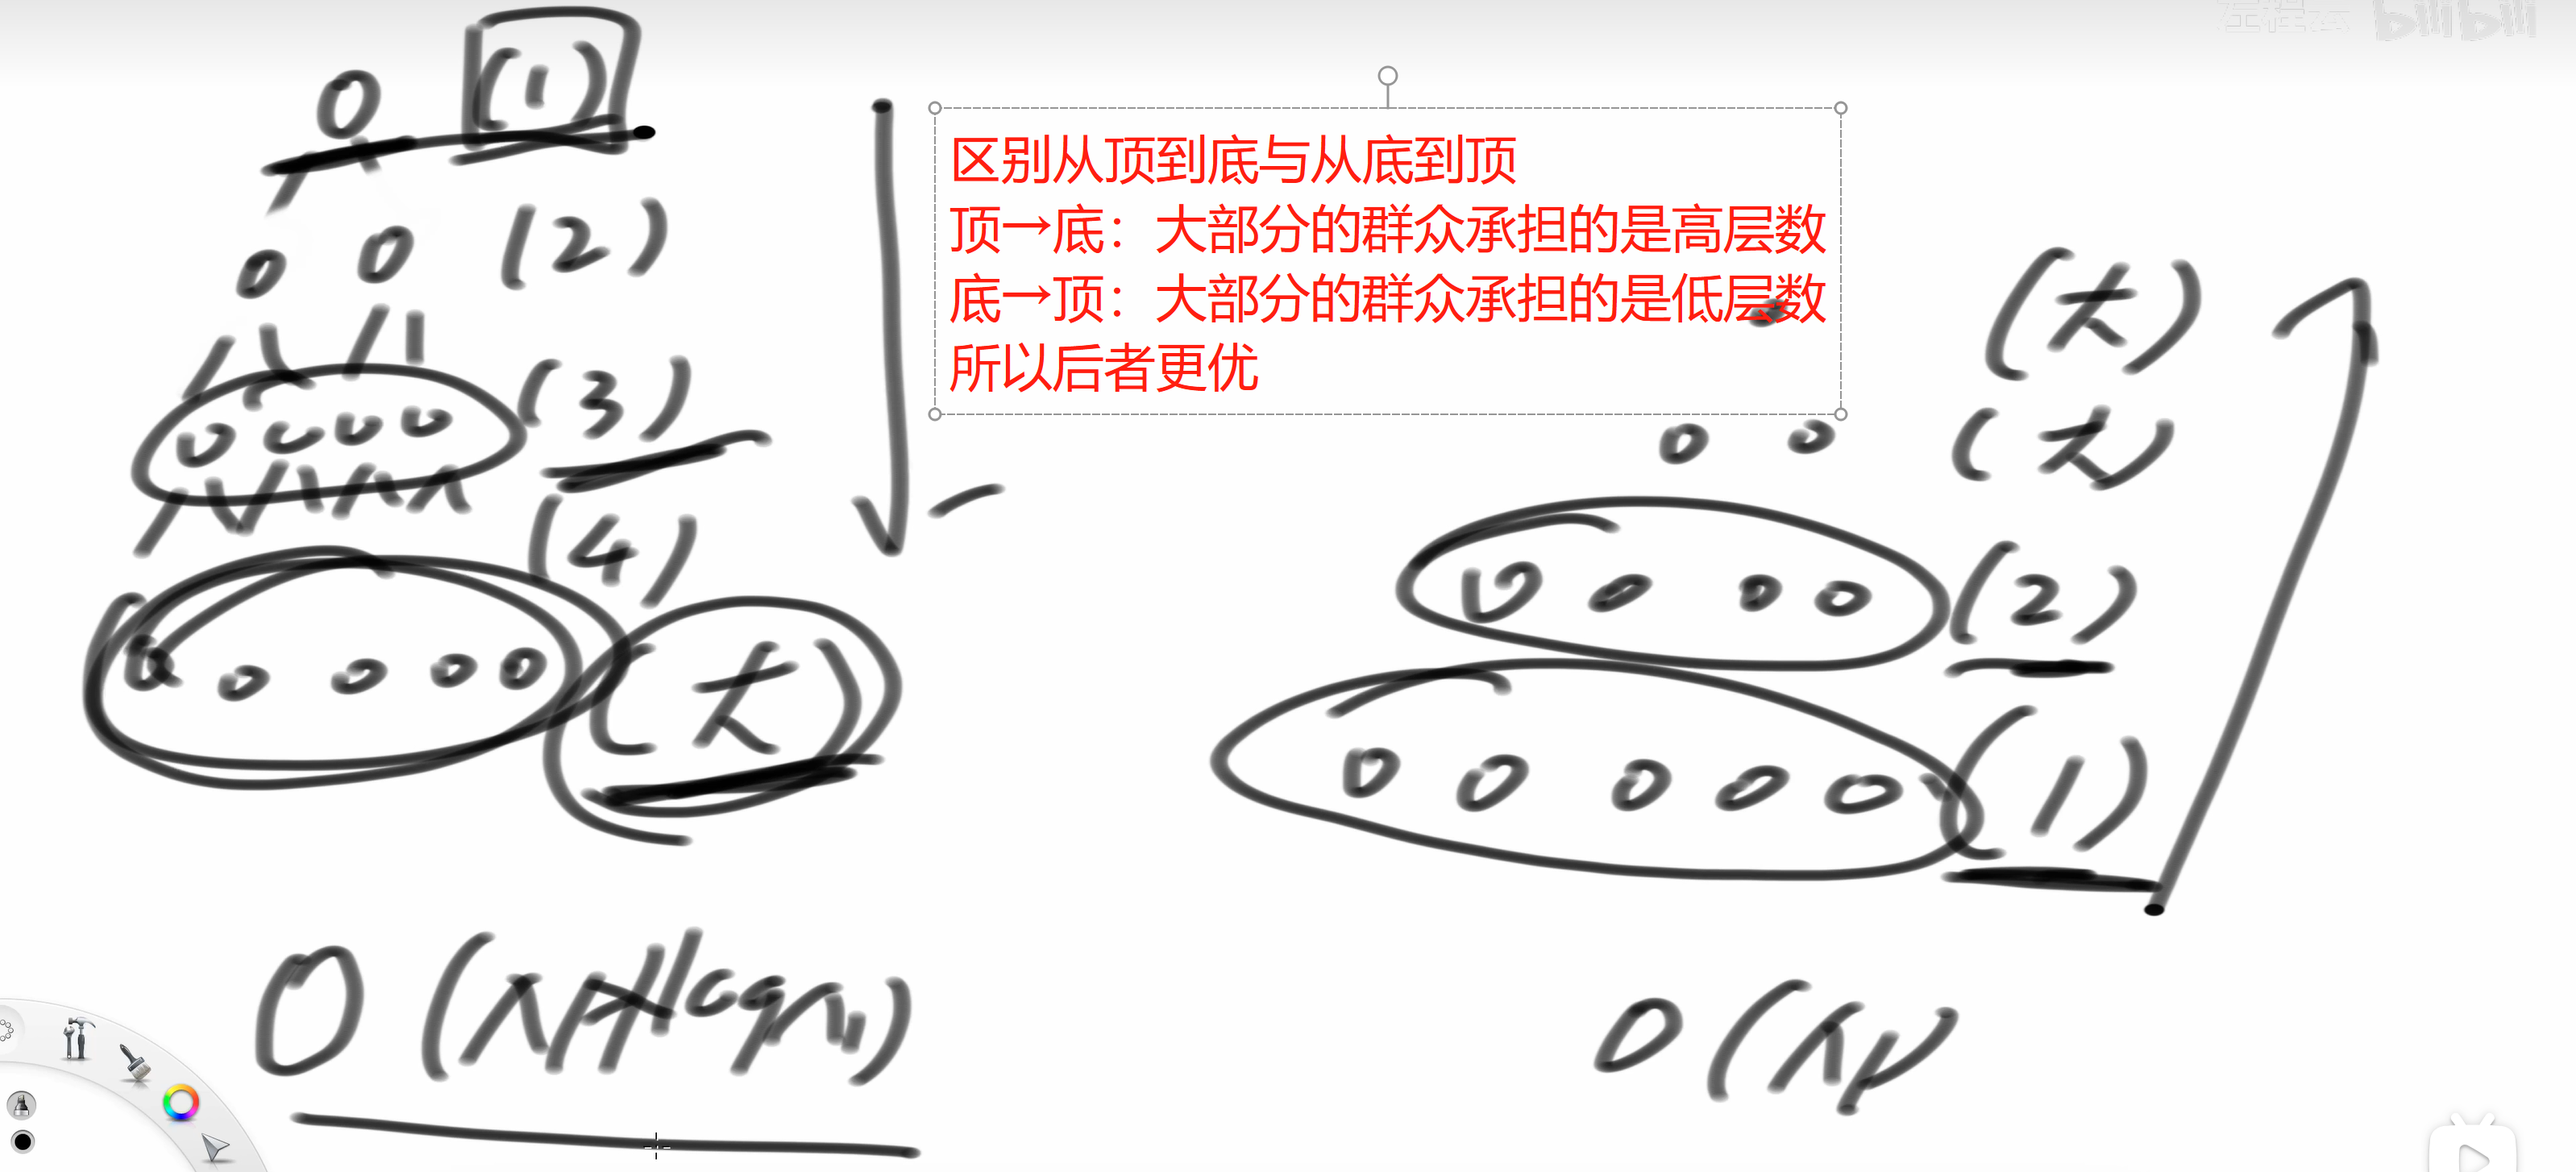
堆排序的两种实现 方法一:从顶到底建堆(经典版本) 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 def heapSort1 (): """ 完全二叉树的节点为N的话,高度是log_2(N)的水平 从顶到底建立大根堆,从顶到底建立大根堆,O(n * logn),每次排好一个数,排n个数要n次,每排一个数时间复杂度是logn,排n个数当然是nlogn 依次弹出堆内最大值并排好序,O(n * logn) 整体时间复杂度O(n * logn) """ for i in range (n): heapInsert(i) size = n while size > 1 : swap(0 , size - 1 ) size -= 1 heapify(0 , size)
时间复杂度分析 :
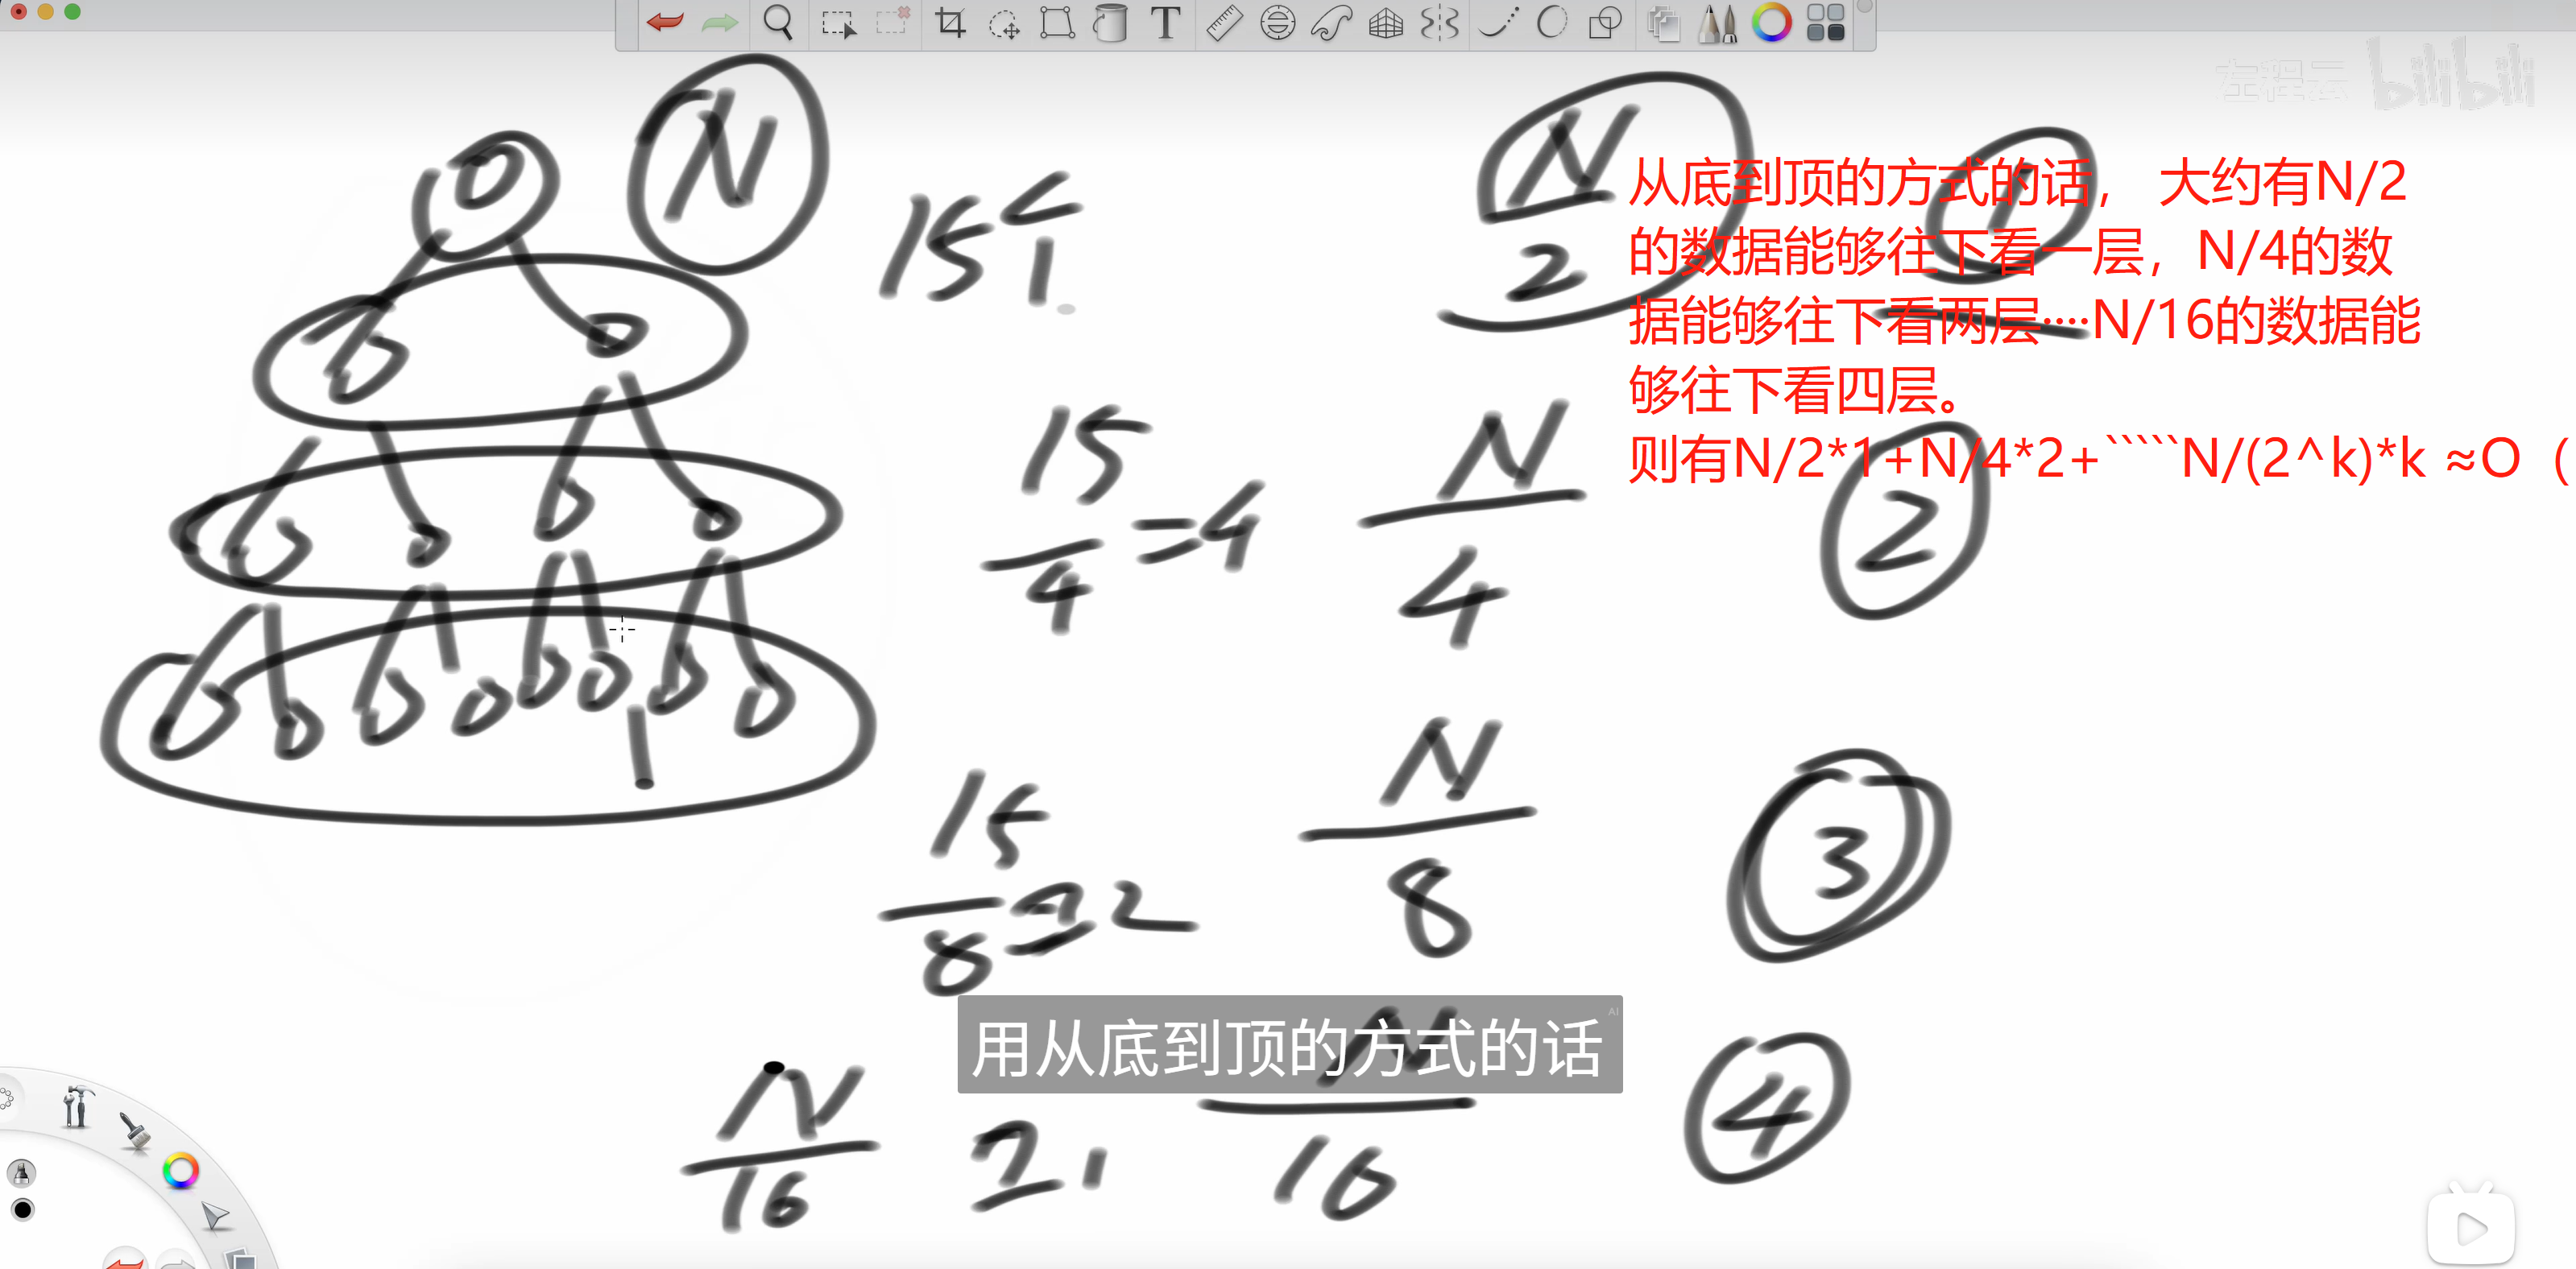
建堆阶段:log₁ + log₂ + log₃ + ... + logₙ =(收敛于) O(n logn)
排序阶段:每次调整 O(log n),共 n-1 次,总计 O(n logn)
总时间复杂度:O(n logn)
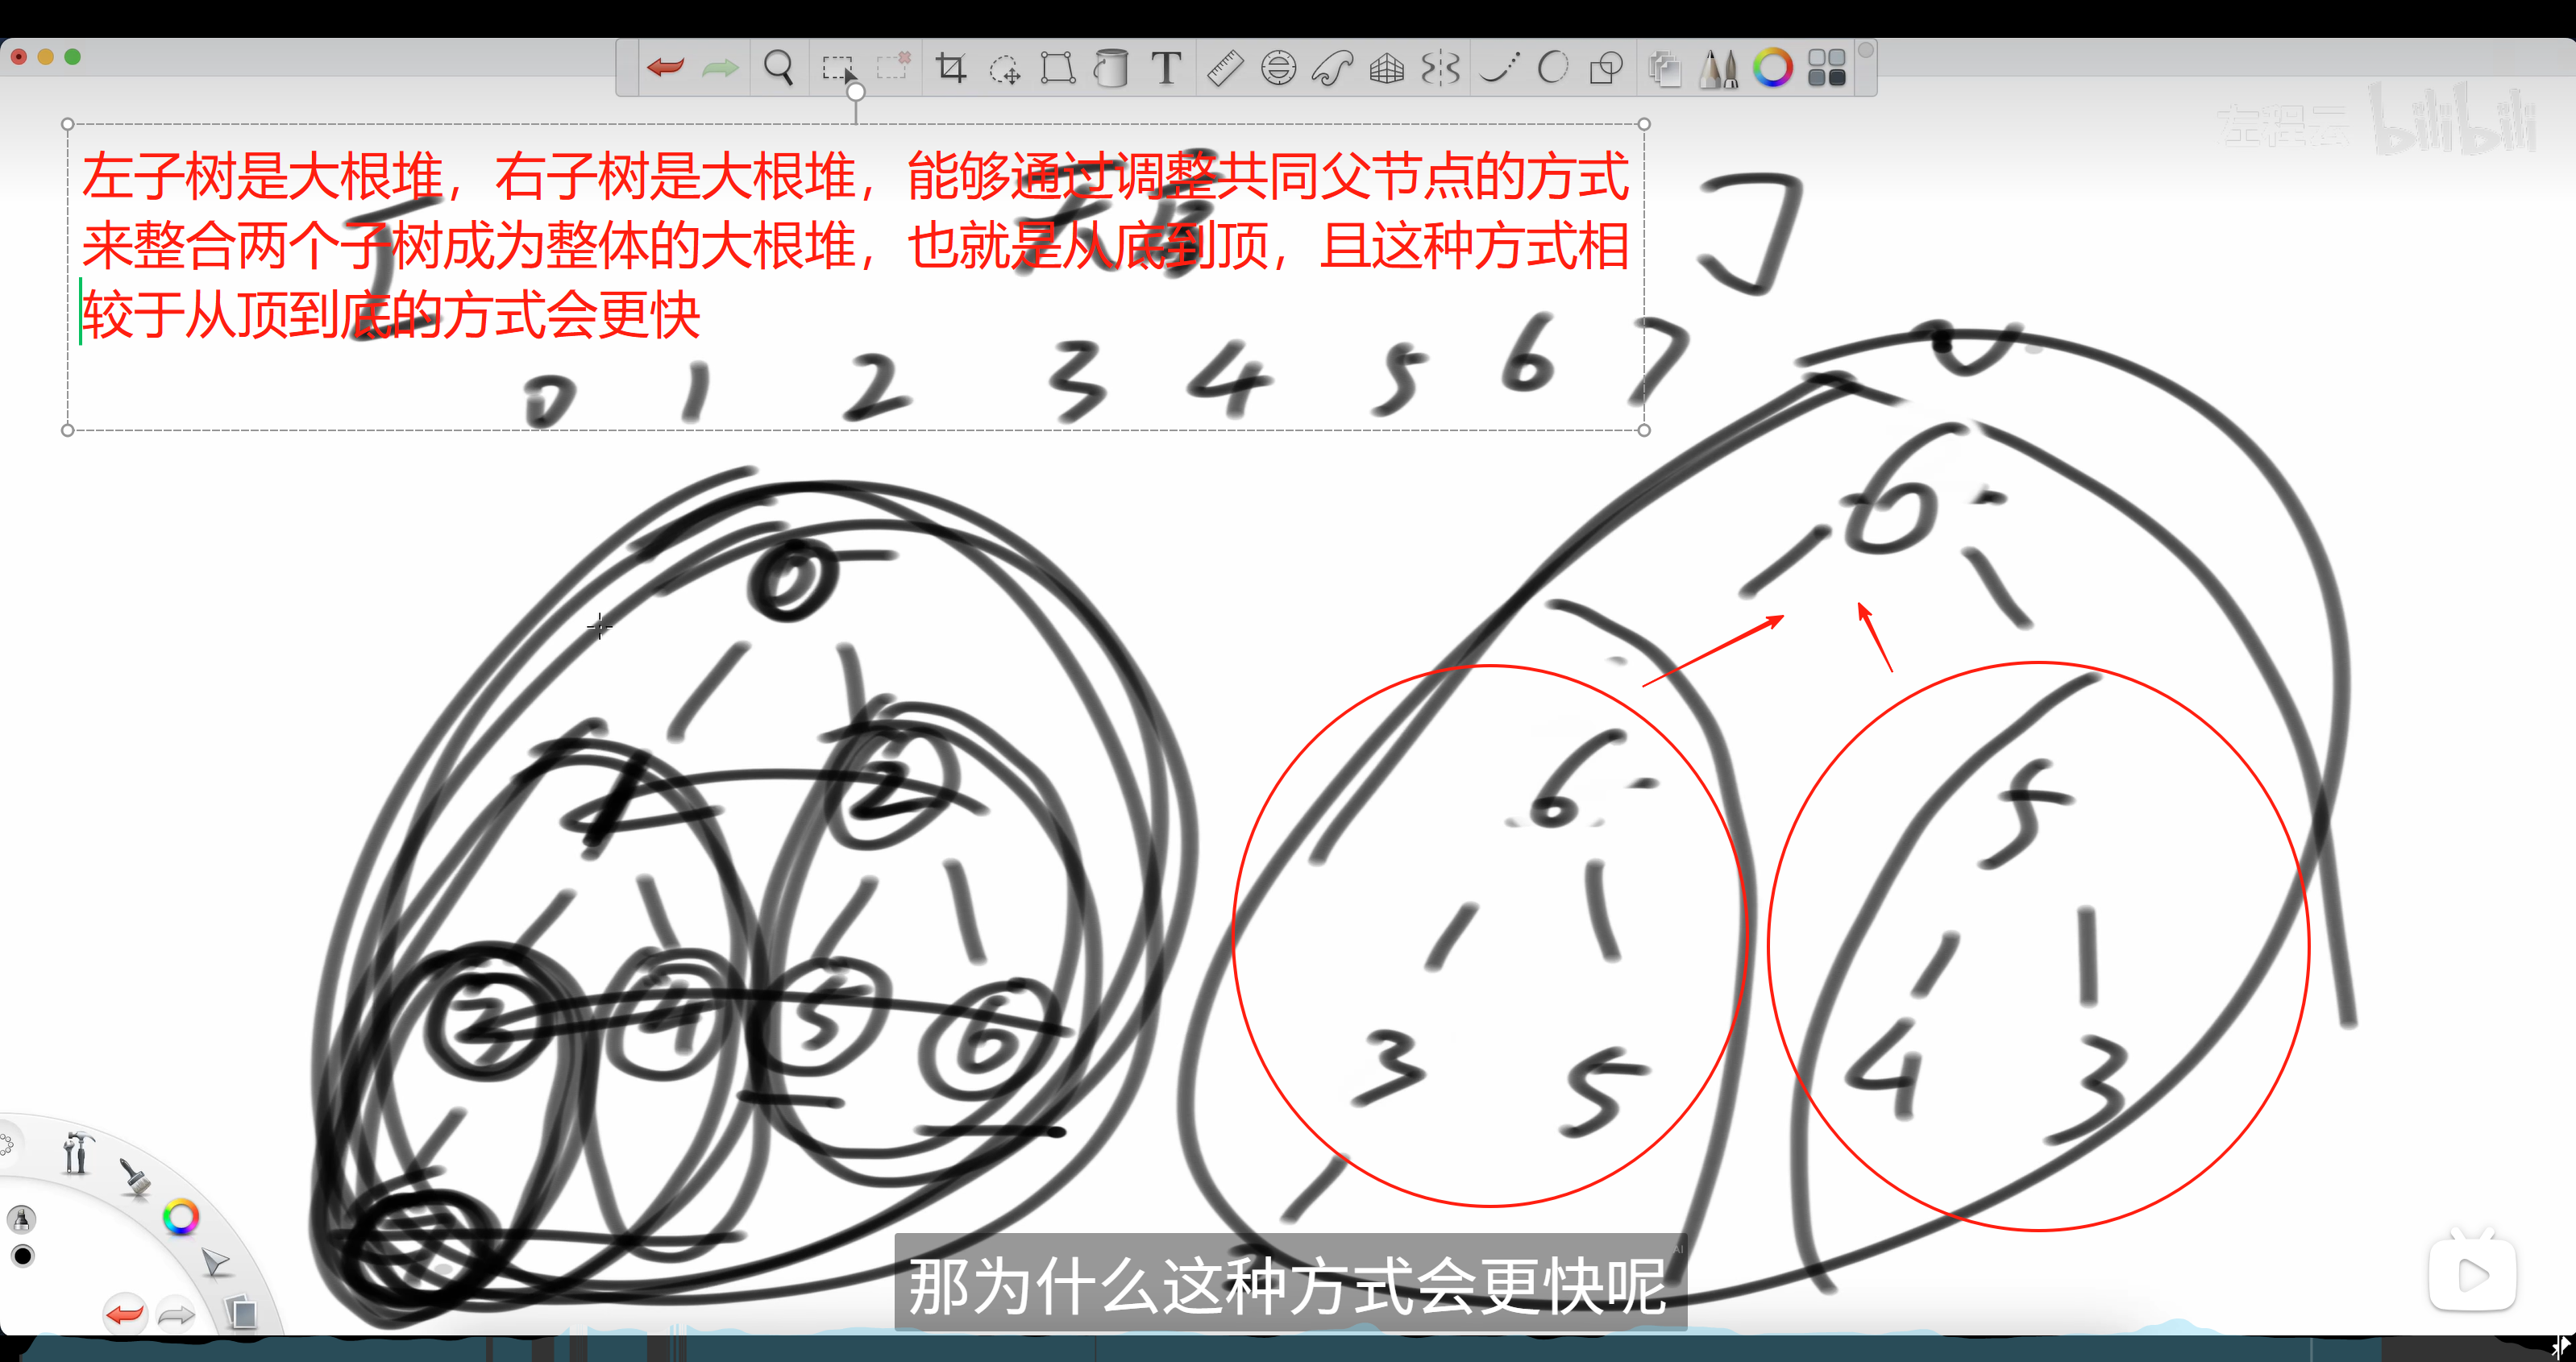
方法二:从底到顶建堆(优化版本) 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 def heapSort2 (): """ 从底到顶建立大根堆,O(n) 依次弹出堆内最大值并排好序,O(n * logn) 整体时间复杂度O(n * logn) """ for i in range (n - 1 , -1 , -1 ): heapify(i, n) size = n while size > 1 : swap(0 , size - 1 ) size -= 1 heapify(0 , size)
为什么从底到顶建堆更快?
从底到顶建堆的时间复杂度是 O(n) ,这是因为:
叶子节点无需调整 :完全二叉树中约有 n/2 个叶子节点,它们天然满足堆性质调整距离递减 :越靠近叶子的节点,需要向下调整的最大距离越小数学分析 :可以证明总的调整代价是一个等比数列,收敛到 O(n)
两种方法的对比 :
建堆方法
建堆复杂度
排序复杂度
总复杂度
特点
从顶到底
O(n logn)
O(n logn)
O(n logn)
逐个插入元素”爬楼梯”
从底到顶
O(n)
O(n logn)
O(n logn)
从下往上”修房子”
完整代码实现 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 import sysimport randomMAXN = 100001 arr = [0 ] * MAXN n = 0 def main (): global n data = sys.stdin.read().split() n = int (data[0 ]) for i in range (n): arr[i] = int (data[i + 1 ]) heapSort2() sys.stdout.write(' ' .join(str (arr[i]) for i in range (n - 1 ))) sys.stdout.write(' ' + str (arr[n - 1 ]) + '\n' ) def heapInsert (i ): while arr[i] > arr[(i - 1 ) // 2 ]: swap(i, (i - 1 ) // 2 ) i = (i - 1 ) // 2 def heapify (i, size ): l = i * 2 + 1 while l < size: best = l + 1 if (l + 1 < size and arr[l + 1 ] > arr[l]) else l best = best if arr[best] > arr[i] else i if best == i: break swap(best, i) i = best l = i * 2 + 1 def swap (i, j ): arr[i], arr[j] = arr[j], arr[i] def heapSort1 (): for i in range (n): heapInsert(i) size = n while size > 1 : swap(0 , size - 1 ) size -= 1 heapify(0 , size) def heapSort2 (): for i in range (n - 1 , -1 , -1 ): heapify(i, n) size = n while size > 1 : swap(0 , size - 1 ) size -= 1 heapify(0 , size) if __name__ == "__main__" : main()
堆排序的特点总结 优点
时间复杂度稳定 :无论什么数据,时间复杂度都是 O(n logn)原地排序 :额外空间复杂度 O(1),直接在原数组上建堆不稳定但可预测 :虽然不是稳定排序,但性能可预测
缺点
不稳定 :相同元素的相对位置可能改变常数因子较大 :虽然渐进复杂度优秀,但实际运行时常数因子比快排大缓存友好性差 :堆调整过程中的访问模式对CPU缓存不太友好
应用场景
优先队列 :堆是实现优先队列的最佳数据结构Top-K 问题 :找出最大或最小的K个元素实时数据流 :需要实时维护最值的场景任务调度 :按优先级处理任务
重要提示 堆结构比堆排序有用得多,尤其是和比较器结合之后 。堆排序只是堆数据结构的一个应用,堆在实际开发中更多用于实现优先队列、解决Top-K问题等场景。
026【必备】哈希表、有序表和比较器的用法 哈希表(Hash Table)的基本概念 什么是哈希表? 哈希表是一种数据结构,它通过键(key)来直接访问存储在值(value)中的数据,实现快速查找、插入和删除操作。
大概约等于python中的字典啦
核心思想
将数据存储在数组中 通过哈希函数将key转换为数组索引 理想情况下,查找、插入、删除的时间复杂度都是O(1)
工作原理 1 Key → 哈希函数 → 数组索引 → 存储位置
哈希表的特点
时间复杂度 :增、删、改、查时间为O(1),但是大常数空间换时间 :用额外的空间来换取时间效率两种形式 :
HashSet :只存储键,用于判断元素是否存在HashMap :存储键值对,根据键快速找到对应的值
Python中的哈希表实现 字符串的比较机制 Python中字符串有特殊的驻留机制,需要注意is和==的区别:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 str1 = str ("Hello" ) str2 = str ("Hello" ) print (str1 is str2) print (str1 == str2) s3 = '' .join(['a' , 'b' , 'c' ]) print (s1 == s3) print (s1 is s3)
重要概念 :
字符串驻留 :Python对于短小、常用的字符串可能会优化,放到同一个内存地址内容比较 vs 身份比较 :==比较内容,is比较内存地址
set操作(HashSet) 1 2 3 4 5 6 7 8 9 10 11 12 13 str1 = str ("Hello" ) str2 = str ("Hello" ) s = set () s.add(str1) print ("Hello" in s) print (str2 in s) s.add(str2) print (len (s)) s.discard(str1) s.clear() print (len (s) == 0 )
dict操作(HashMap) 1 2 3 4 5 6 7 8 9 10 11 12 map1 = dict () map1[str1] = "World" print ("Hello" in map1) print (str2 in map1) print (map1.get(str2)) print (map1.get("你好" ) is None ) if "Hello" in map1: del map1["Hello" ] print (len (map1)) map1.clear() print (len (map1) == 0 )
哈希表的优化策略 数组替代哈希表 当key的范围是固定的、可控的情况下,可以用数组结构替代哈希表结构:
1 2 3 4 5 6 7 8 9 10 11 12 13 map2 = dict () map2[56 ] = 7285 map2[34 ] = 3671263 map2[17 ] = 716311 map2[24 ] = 1263161 arr = [0 ] * 100 arr[56 ] = 7285 arr[34 ] = 3671263 arr[17 ] = 716311 arr[24 ] = 1263161
优势 :
速度更快 :直接数组访问,无需哈希计算空间可控 :预知范围,精确分配空间无哈希冲突 :避免了哈希表的冲突处理
自定义对象作为Key 1 2 3 4 5 6 7 8 9 10 11 12 13 class Student : def __init__ (self, age, name ): self .age = age self .name = name s1 = Student(17 , "张三" ) s2 = Student(17 , "张三" ) map3 = dict () map3[s1] = "这是张三" print (s1 in map3) print (s2 in map3) map3[s2] = "这是另一个张三" print (len (map3))
重要提示 :Python自定义对象没有实现__eq__和__hash__时,默认按对象id判定。
有序表(TreeMap/TreeSet) Python中的有序表模拟 Python没有内置的TreeMap,需要用其他方式模拟:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 import heapqtree_map = dict () tree_map[5 ] = "这是5" tree_map[7 ] = "这是7" tree_map[1 ] = "这是1" tree_map[2 ] = "这是2" tree_map[3 ] = "这是3" tree_map[4 ] = "这是4" tree_map[8 ] = "这是8" print (1 in tree_map) print (10 in tree_map) print (tree_map.get(4 )) tree_map[4 ] = "张三是4" print (tree_map.get(4 )) tree_map.pop(4 , None ) print (tree_map.get(4 ) is None )
有序表的特殊操作 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 keys = sorted (tree_map.keys()) print (keys[0 ]) print (keys[-1 ]) def floor_key (k ): return max ([x for x in tree_map if x <= k], default=None ) def ceiling_key (k ): return min ([x for x in tree_map if x >= k], default=None ) print (floor_key(4 )) print (ceiling_key(4 ))
操作解释 :
删除前 :1, 2, 3, [4], 5, 7, 8删除后 :1, 2, 3, 5, 7, 8floor_key(4) :找到 ≤ 4 的最大值,可选值:[1, 2, 3],最大值:3ceiling_key(4) :找到 ≥ 4 的最小值,可选值:[5, 7, 8],最小值:5
TreeSet模拟 1 2 3 4 5 6 7 8 9 10 11 s = set () s.add(3 ) s.add(3 ) s.add(4 ) s.add(4 ) print ("有序表大小:" , len (s)) for item in sorted (s): print (item)
优先队列(堆) 小根堆 1 2 3 4 5 6 7 8 9 heap1 = [] heapq.heappush(heap1, 3 ) heapq.heappush(heap1, 3 ) heapq.heappush(heap1, 4 ) heapq.heappush(heap1, 4 ) print ("堆大小:" , len (heap1)) while heap1: print (heapq.heappop(heap1))
大根堆实现技巧 1 2 3 4 5 6 7 heap2 = [] for x in [3 , 3 , 4 , 4 ]: heapq.heappush(heap2, -x) print ("堆大小:" , len (heap2)) while heap2: print (-heapq.heappop(heap2))
核心技巧 :Python的heapq只提供小根堆,要实现大根堆可以将所有元素取负数。
比较器的使用 基本比较器概念 任何比较器都有统一的规则:
返回负数 :认为第一个对象优先级更高返回正数 :认为第二个对象优先级更高返回0 :两个对象优先级相等
员工类的排序示例 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 from functools import cmp_to_keyclass Employee : def __init__ (self, company, age ): self .company = company self .age = age def __repr__ (self ): return f"Employee({self.company} , {self.age} )" def employee_comparator (o1, o2 ): return o1.age - o2.age s1 = Employee(2 , 27 ) s2 = Employee(1 , 60 ) s3 = Employee(4 , 19 ) s4 = Employee(3 , 23 ) s5 = Employee(1 , 35 ) s6 = Employee(3 , 55 ) arr = [s1, s2, s3, s4, s5, s6] arr.sort(key=cmp_to_key(employee_comparator)) for e in arr: print (f"{e.company} , {e.age} " )
多种排序方式 1 2 3 4 5 6 7 8 9 arr.sort(key=lambda x: -x.age) for e in arr: print (f"{e.company} , {e.age} " ) arr.sort(key=lambda x: (x.company, x.age)) for e in arr: print (f"{e.company} , {e.age} " )
自定义对象的去重策略 按年龄去重 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 class EmployeeByAge (Employee ): def __eq__ (self, other ): return self .age == other.age def __hash__ (self ): return hash (self .age) treeSet1 = set () for e in arr: treeSet1.add(EmployeeByAge(e.company, e.age)) print (len (treeSet1)) treeSet1.add(EmployeeByAge(2 , 27 )) print (len (treeSet1))
按多个属性去重 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 class EmployeeByAll (Employee ): def __eq__ (self, other ): if not isinstance (other, EmployeeByAll): return False return (self .company == other.company and self .age == other.age and repr (self ) == repr (other)) def __hash__ (self ): return hash ((self .company, self .age, repr (self ))) treeSet2 = set () for e in arr: treeSet2.add(EmployeeByAll(e.company, e.age)) print (len (treeSet2)) treeSet2.add(EmployeeByAll(2 , 27 )) print (len (treeSet2))
重要概念 :
__eq__方法==操作符时调用__hash__方法
字符串的字典序比较 1 2 3 4 5 6 7 8 9 str1 = "abcde" str2 = "ks" print (str1.__lt__(str2) - str1.__gt__(str2)) print (str2.__lt__(str1) - str2.__gt__(str1)) print ((str1 > str2) - (str1 < str2)) print ((str2 > str1) - (str2 < str1))
字典序规则 :按字符的ASCII码逐位比较,先遇到不同字符的位置决定大小关系。
数据结构选择指南 性能对比表
数据结构
查找
插入
删除
有序性
去重
适用场景
set
O(1)
O(1)
O(1)
❌
✅
快速查重、集合运算
dict
O(1)
O(1)
O(1)
❌
✅
键值映射、缓存
数组
O(1)
O(1)
O(1)
❌
❌
key范围可控时替代哈希表
排序列表
O(log n)
O(n)
O(n)
✅
❌
需要有序且查找频繁
heapq
O(1)
O(log n)
O(log n)
部分
❌
优先队列、Top-K问题
使用建议
快速查找、去重 :使用set键值映射 :使用dictkey范围固定 :考虑数组替代哈希表需要有序 :使用排序+二分查找或第三方库优先队列 :使用heapq自定义排序 :实现比较器或使用key参数
实际应用场景 场景1:统计词频 1 2 3 4 5 6 text = "hello world hello python" word_count = {} for word in text.split(): word_count[word] = word_count.get(word, 0 ) + 1 print (word_count)
场景2:去重并保持顺序 1 2 3 4 5 6 7 8 9 10 11 12 def dedupe_keep_order (items ): seen = {} result = [] for item in items: if item not in seen: seen[item] = True result.append(item) return result items = [1 , 2 , 3 , 2 , 4 , 1 , 5 ] print (dedupe_keep_order(items))
场景3:Top-K问题 1 2 3 4 5 6 7 8 9 10 11 12 13 14 import heapqdef find_top_k (nums, k ): heap = [] for num in nums: if len (heap) < k: heapq.heappush(heap, num) elif num > heap[0 ]: heapq.heapreplace(heap, num) return sorted (heap, reverse=True ) nums = [3 , 1 , 4 , 1 , 5 , 9 , 2 , 6 , 5 , 3 , 5 ] print (find_top_k(nums, 3 ))
总结
哈希表 :提供O(1)的查找、插入、删除,但有较大常数因子有序表 :在Python中需要模拟实现,适合需要有序性的场景比较器 :统一的优先级比较规则,负数表示第一个对象优先级更高优化策略 :key范围可控时用数组替代哈希表,性能更好实际应用 :根据具体需求选择合适的数据结构,考虑时间复杂度和空间复杂度的权衡
027【必备】堆结构常见题 Python heapq 模块详解 heapq 基本概念 heapq 是 Python 标准库提供的”二叉堆”实现工具,基于列表实现的最小堆(min-heap) 。它能在 O(log n) 时间内插入与弹出最小元素,heap[0] 永远是当前最小值。
常用 API 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 import heapqheapq.heappush(heap, item) heapq.heappop(heap) heapq.heapify(lst) heapq.heappushpop(heap, item) heapq.heapreplace(heap, item) heapq.nsmallest(n, iterable) heapq.nlargest(n, iterable) heapq.merge(*iterables)
大根堆实现技巧 由于 Python 的 heapq 只提供小根堆,实现大根堆需要使用负数技巧:
1 2 3 4 5 6 heap = [] for x in [3 , 1 , 4 , 1 , 5 ]: heapq.heappush(heap, -x) max_val = -heapq.heappop(heap)
问题一:合并K个有序链表 测试链接 :https://www.nowcoder.com/practice/65cfde9e5b9b4cf2b6bafa5f3ef33fa6
问题描述 给定K个有序链表,将它们合并成一个有序链表。
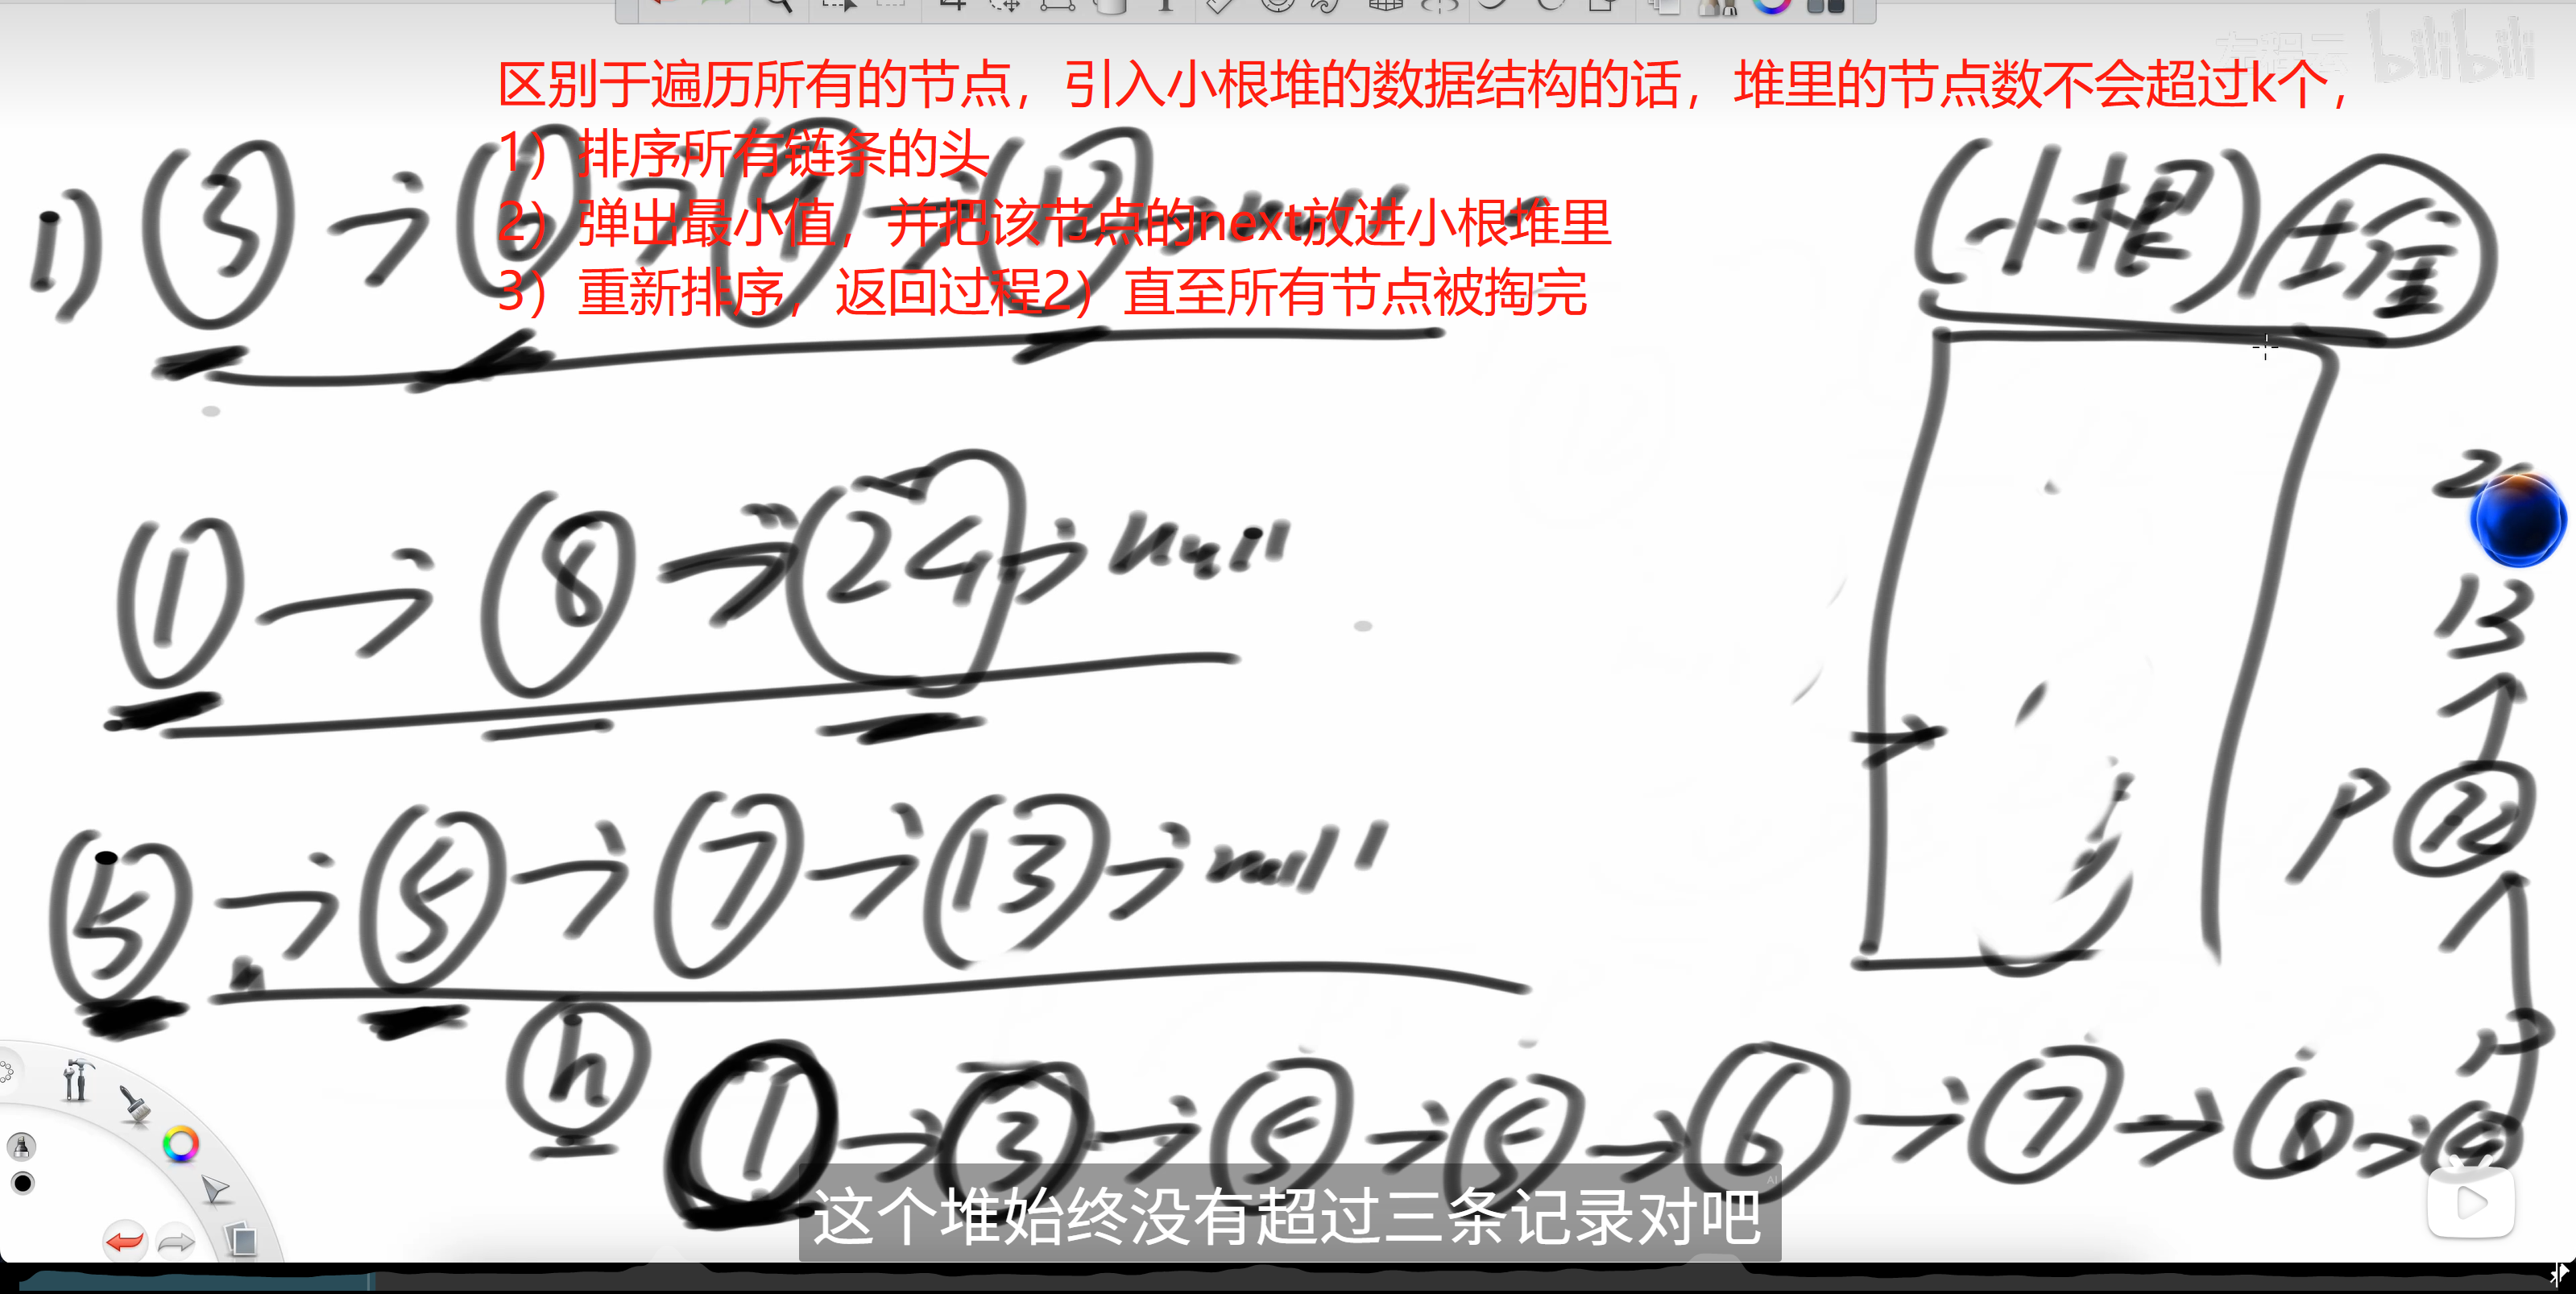
算法思路 使用小根堆 维护所有链表的当前头节点,每次取出值最小的节点:
初始化 :将所有链表的头节点放入堆中合并过程 :
弹出堆顶最小节点,连接到结果链表
如果该节点有下一个节点,将下一个节点入堆
重复直到堆为空
核心实现 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 import heapqfrom typing import List , Optional class ListNode : def __init__ (self, val=0 , next =None ): self .val = val self .next = next def mergeKLists (arr: List [Optional [ListNode]] ) -> Optional [ListNode]: heap = [] for h in arr: if h is not None : heapq.heappush(heap, (h.val, id (h), h)) if not heap: return None _, _, h = heapq.heappop(heap) pre = h if pre.next is not None : heapq.heappush(heap, (pre.next .val, id (pre.next ), pre.next )) while heap: _, _, cur = heapq.heappop(heap) pre.next = cur pre = cur if cur.next is not None : heapq.heappush(heap, (cur.next .val, id (cur.next ), cur.next )) return h
关键技术点 元组比较机制 :
heapq 按元组字典序比较:(val, something, node)
先比较 val,相等时比较第二个元素
加入 id(node) 作为”决胜键”,避免直接比较 ListNode 对象
为什么需要 id(node) :
ListNode 没有定义大小比较,直接比较会抛出 TypeError
id() 返回对象的唯一标识符,可以进行比较保证元组能比较出大小,避免直接比较 ListNode
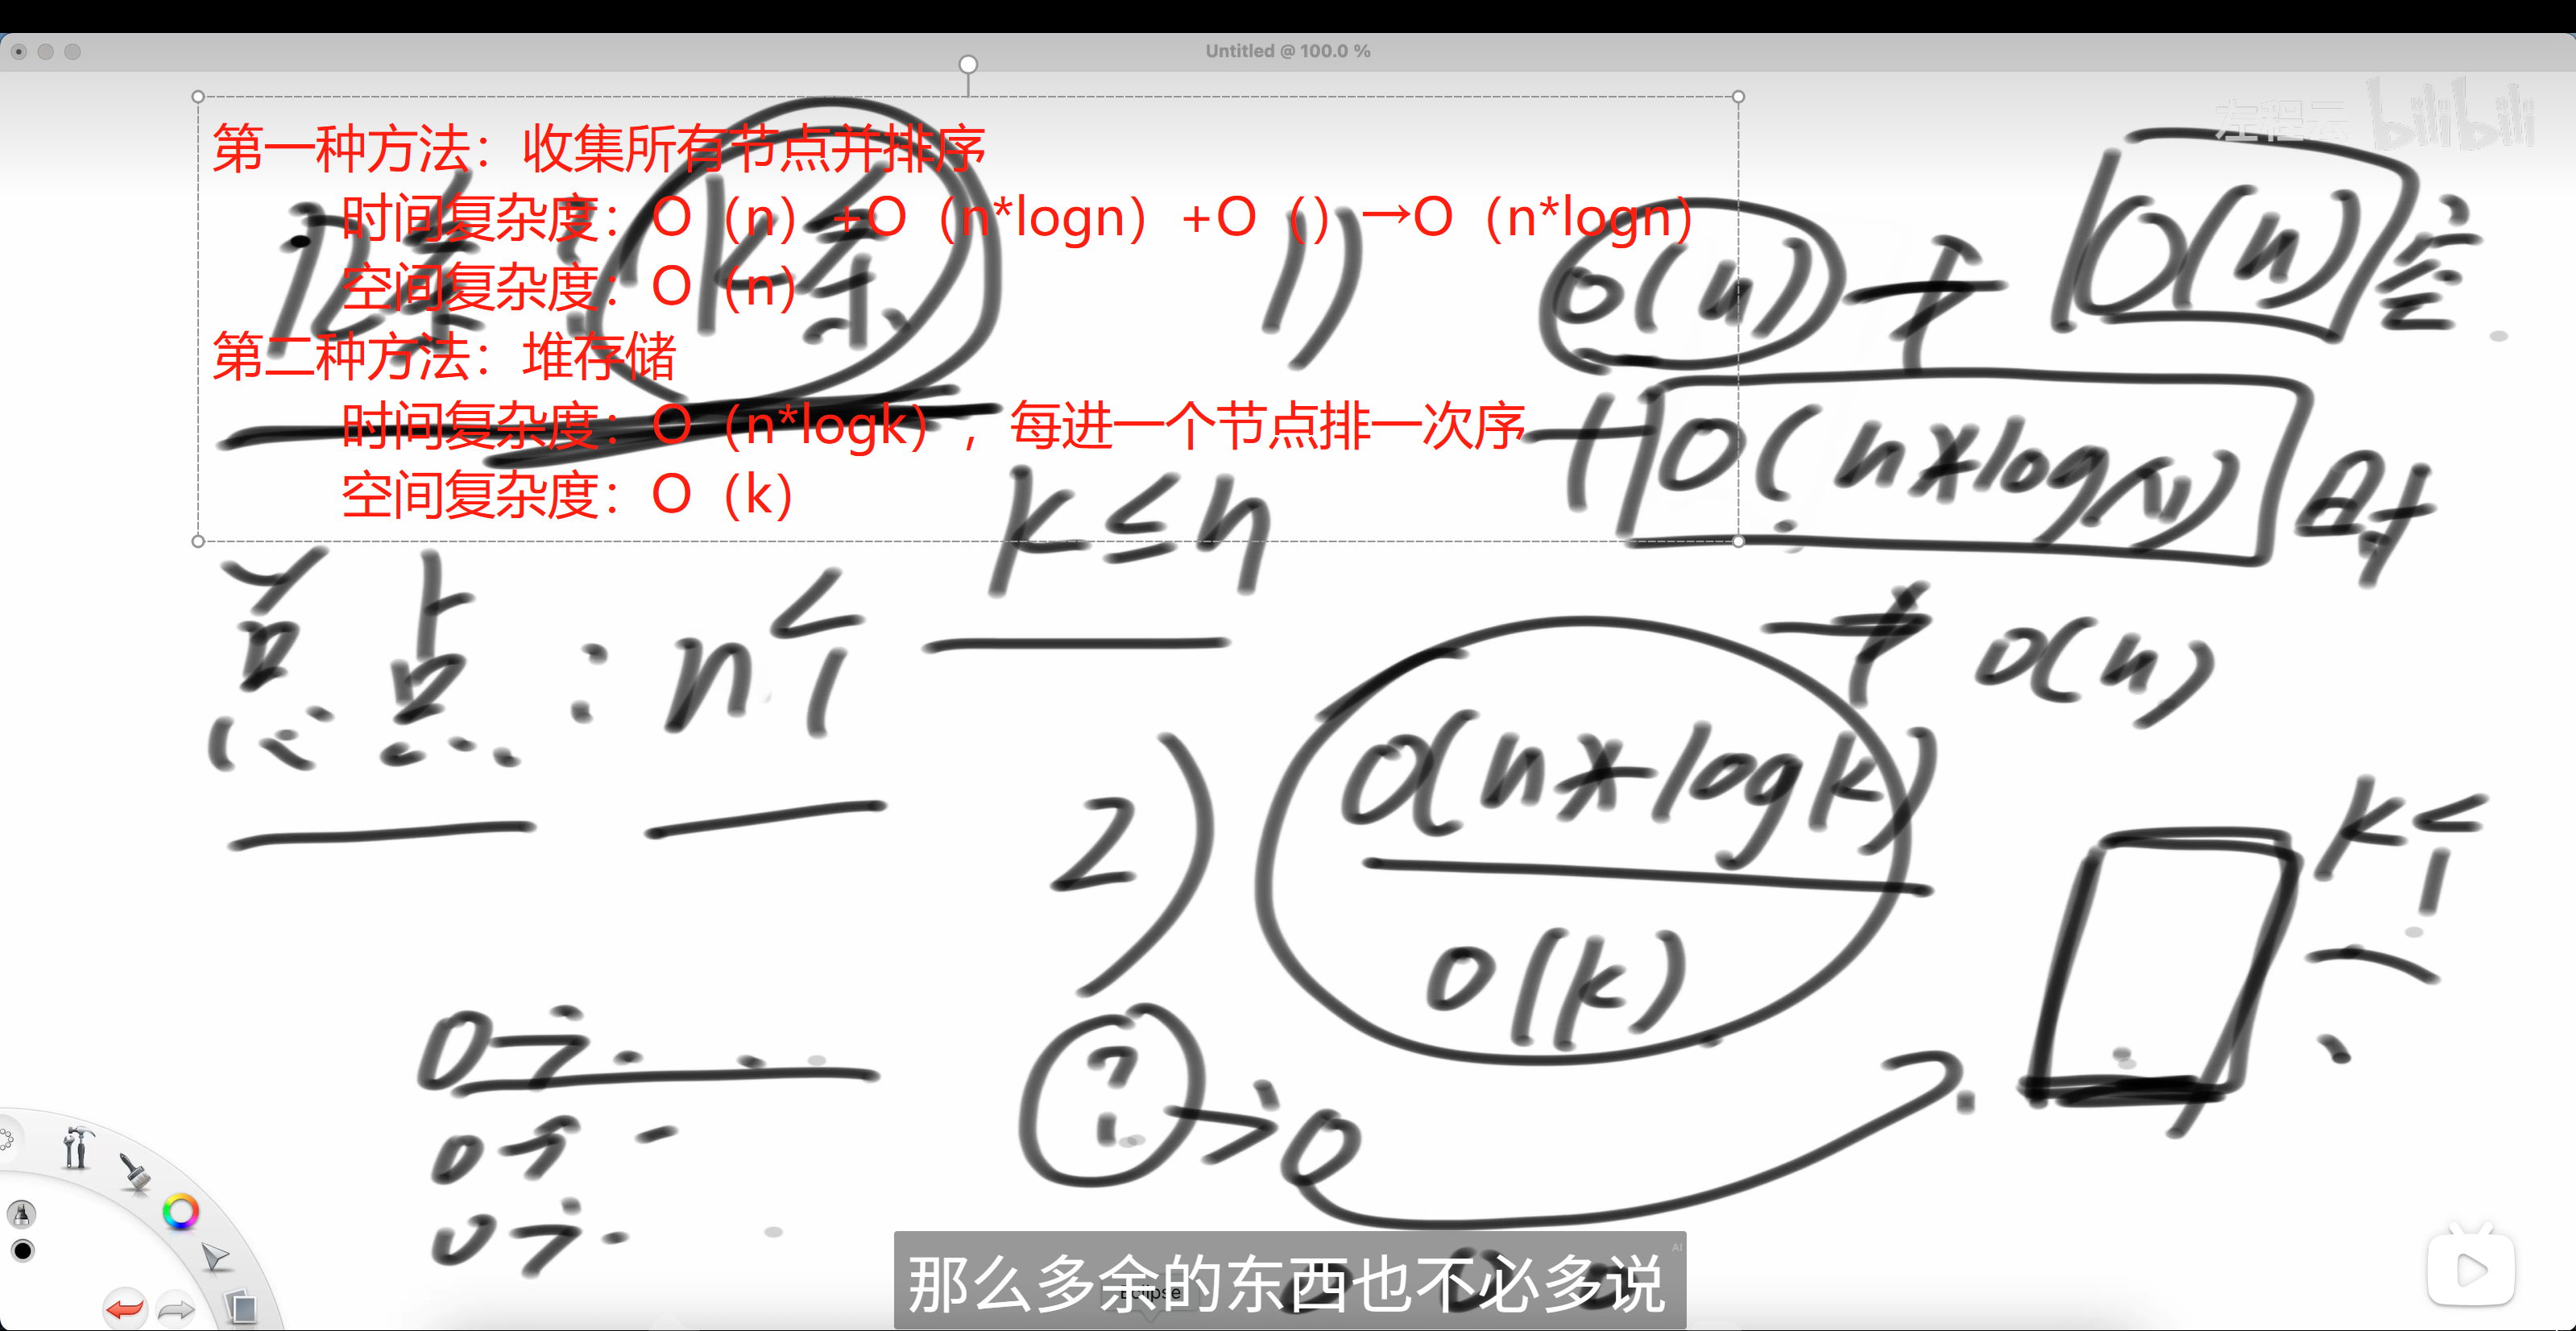
复杂度分析
时间复杂度 :O(N log K),其中 N 是所有节点总数,K 是链表个数空间复杂度 :O(K),堆中最多存储 K 个节点
问题二:最多线段重合问题 测试链接 :
问题描述 给定n条线段,每条线段有起点和终点,求最多同时重合的线段数量。
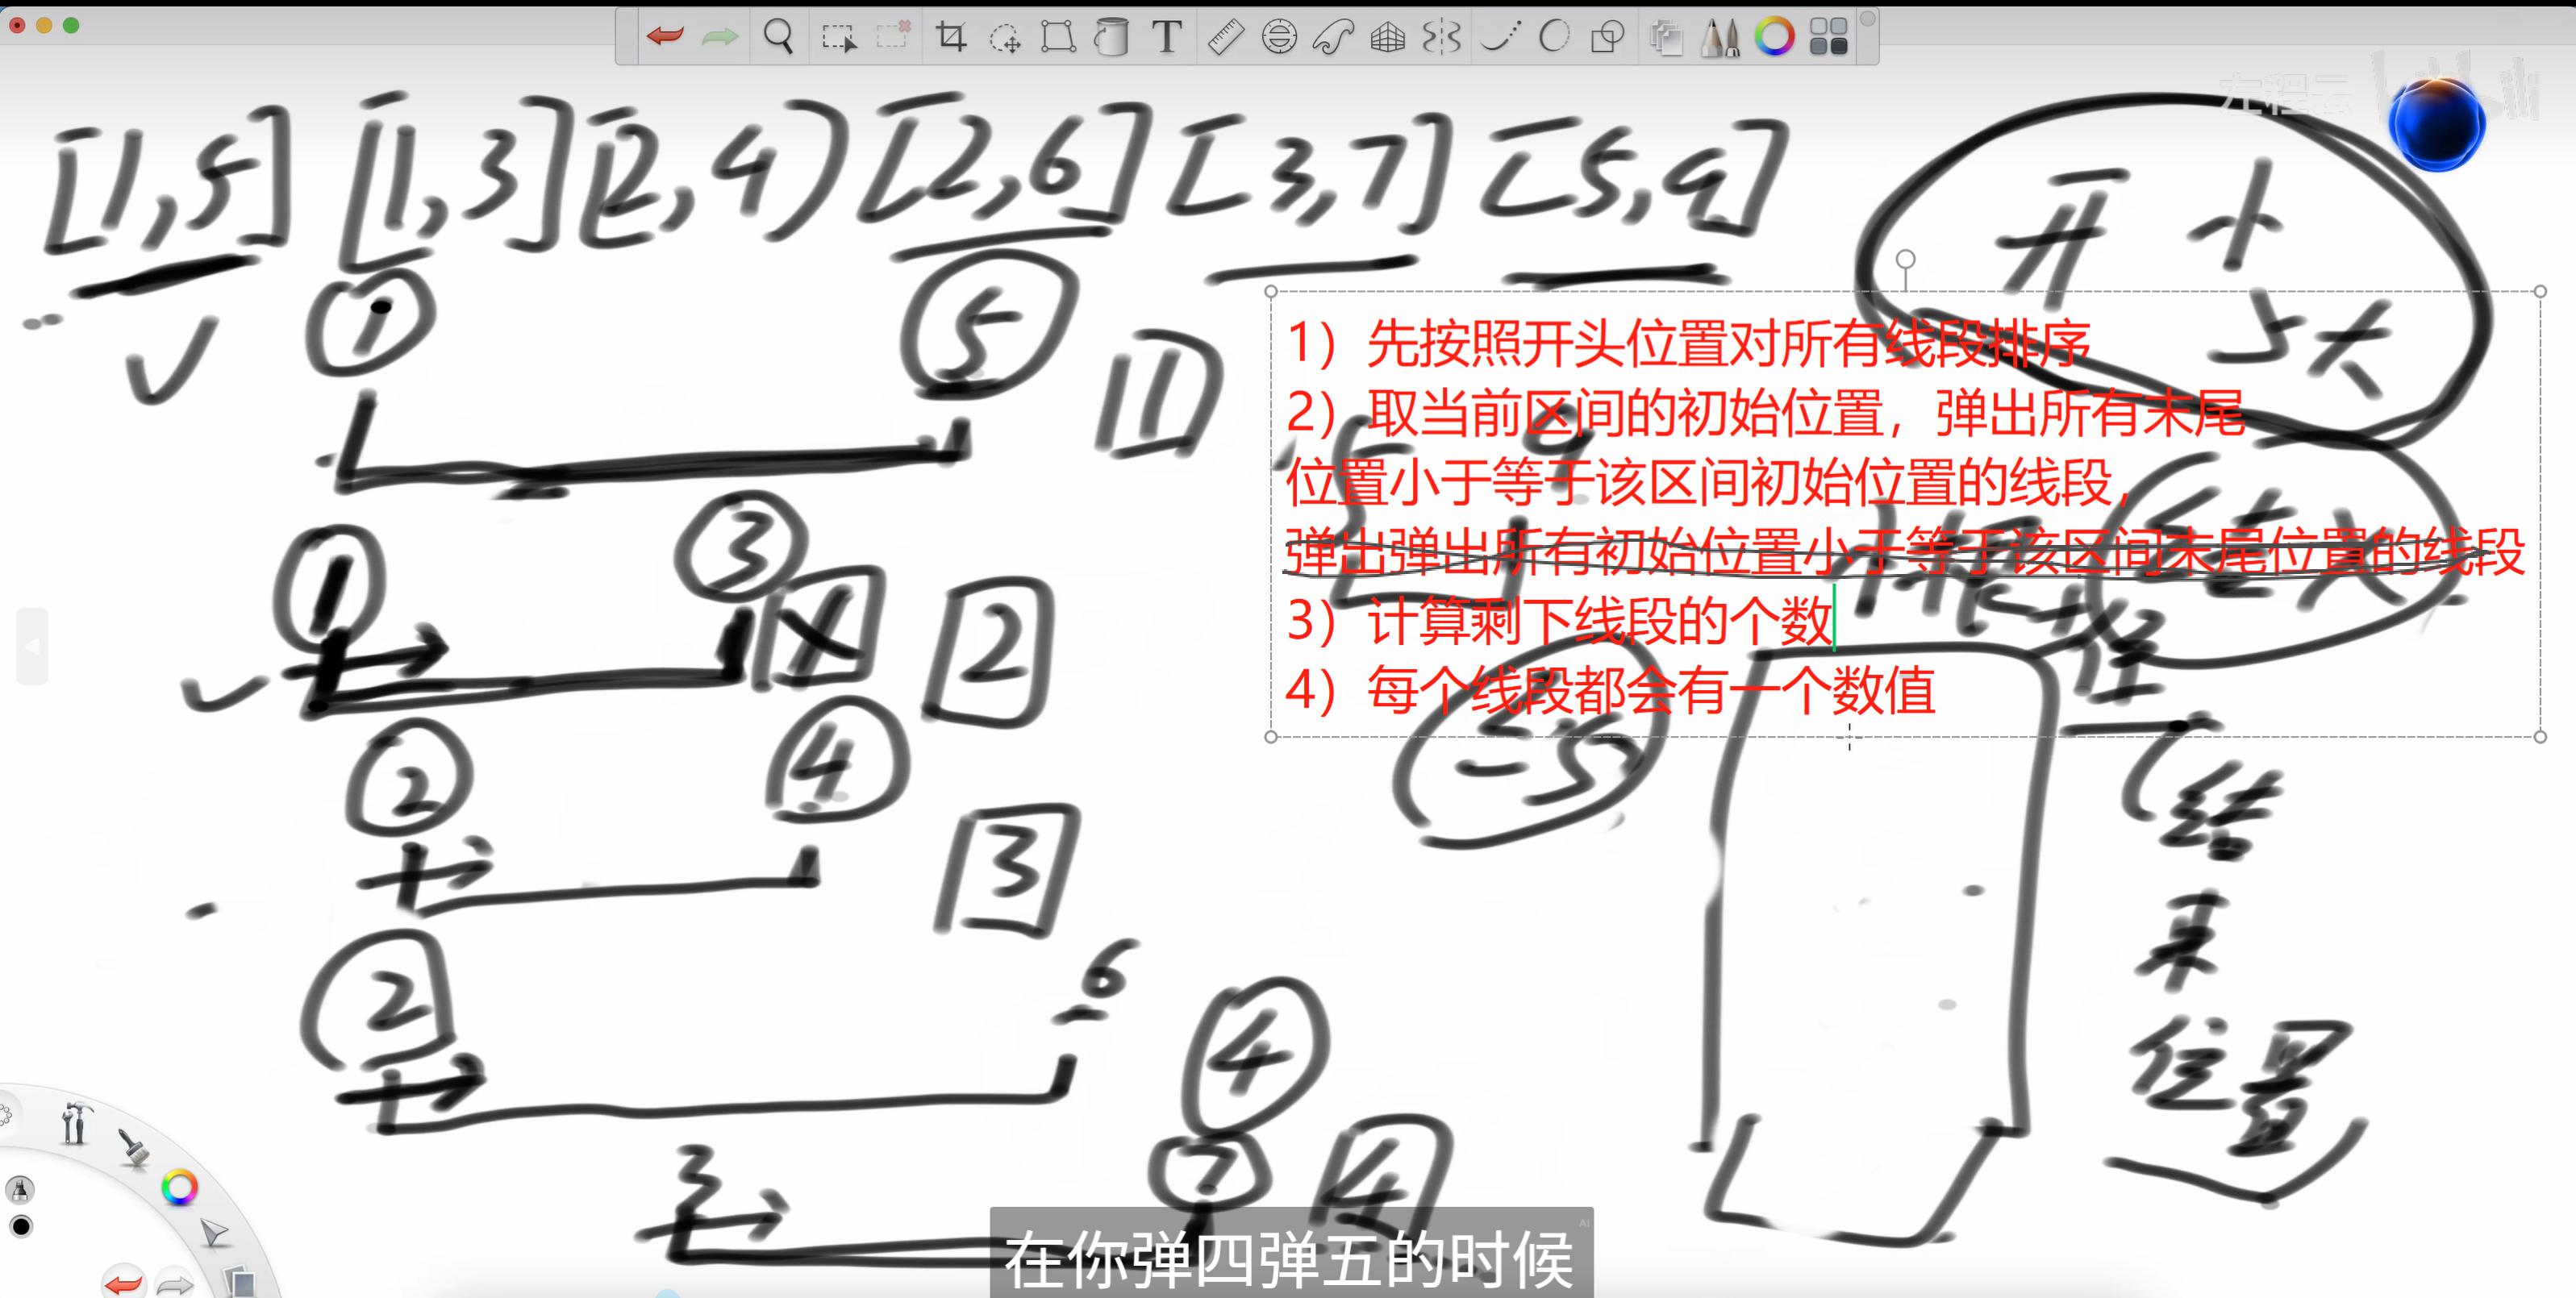
算法思路 使用扫描线算法 + 小根堆 :
排序 :将所有线段按起点排序扫描 :从左到右处理每条线段维护堆 :堆中存储当前重合线段的结束时间清理 :移除已结束的线段(结束点 ≤ 当前起点)更新 :添加当前线段,更新最大重合数
核心实现
想象每条线段根据开始和结束位置,放在x轴上,然后有一根竖线,从左到右划过x轴,竖线压中的线段上的点,就需要把当前点放入到某个组里。
请问,从左到右划的过程,你最多需要准备几个组?最多重合几条线段,就需要几个组。这些组不断复用空间,放入不同的点。但是最大重合了多少,你就需要准备几个组。
重要 :我之前一直在纠结为什么不要考虑后面重复合并, 但是我们这个代码已经考虑了后面重复合并,因为我们是把结束点加入到堆里,而不是把线段加入到堆里。因此即便这条线段的结束点和后面的线段的开始点重合,我们也会把这条线段的结束点加入到堆里,则以这个为标准对数轴进行扫描,又因为小根堆是根据开始点进行从小大排序的,所以能够保证后面的线段初始点严格小于当前线段的初始点,不会忽略到后面的线段重合,这个是个离散的逐点扫描的过程。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 import heapqdef compute (): """ # 时间复杂度:O(NlogN) ,n条线段,平均比较次数是logN,所以是O(NlogN) # 空间复杂度:O(N),因为需要存储每条线段的结束点""" global size size = 0 sorted_lines = sorted (line[:n], key=lambda x: x[0 ]) ans = 0 for i in range (n): while size > 0 and heap[0 ] <= sorted_lines[i][0 ]: pop() add(sorted_lines[i][1 ]) ans = max (ans, size) return ans
算法可视化 想象一根竖线从左到右扫过数轴:
1 2 3 4 5 6 7 8 9 10 线段1: |-------| 线段2: |-----| 线段3: |---| 线段4: |-----| 扫描过程: 时刻1: | 重合数 = 1 时刻2: | 重合数 = 2 时刻3: | 重合数 = 3 (最大值) 时刻4: | 重合数 = 2
手写堆实现 为了提高效率,使用数组实现小根堆:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 MAXN = 10001 heap = [0 ] * MAXN size = 0 def add (x ): global size heap[size] = x i = size size += 1 while i > 0 and heap[i] < heap[(i - 1 ) // 2 ]: swap(i, (i - 1 ) // 2 ) i = (i - 1 ) // 2 def pop (): global size swap(0 , size - 1 ) size -= 1 i = 0 l = 1 while l < size: best = l + 1 if l + 1 < size and heap[l + 1 ] < heap[l] else l best = best if heap[best] < heap[i] else i if best == i: break swap(i, best) i = best l = i * 2 + 1 def swap (i, j ): heap[i], heap[j] = heap[j], heap[i]
变种问题 会议室问题 1 2 3 4 5 6 7 8 9 10 11 12 13 def minMeetingRooms (meeting ): n = len (meeting) meeting.sort(key=lambda x: x[0 ]) heap = [] ans = 0 for i in range (n): while heap and heap[0 ] <= meeting[i][0 ]: heapq.heappop(heap) heapq.heappush(heap, meeting[i][1 ]) ans = max (ans, len (heap)) return ans
分组问题 1 2 3 4 5 6 7 8 9 10 11 12 13 def minGroups (meeting ): n = len (meeting) meeting.sort(key=lambda x: x[0 ]) heap = [] ans = 0 for i in range (n): while heap and heap[0 ] < meeting[i][0 ]: heapq.heappop(heap) heapq.heappush(heap, meeting[i][1 ]) ans = max (ans, len (heap)) return ans
关键区别 :会议室问题用 <=(会议可以无缝衔接),分组问题用 <(需要间隔)。
复杂度分析
时间复杂度 :O(N log N),排序 + 每个元素平均 log N 次堆操作空间复杂度 :O(N),存储线段结束点的堆
问题三:将数组和减半的最少操作次数 测试链接 :https://leetcode.cn/problems/minimum-operations-to-halve-array-sum/
问题描述 给定一个数组,每次操作可以将任意一个元素减半,求使数组总和减少到原来一半所需的最少操作次数。
算法思路 使用贪心策略 + 大根堆 :
贪心原理 :每次选择当前最大的元素进行减半,减少量最大堆维护 :用大根堆维护当前所有元素操作过程 :不断取出最大元素减半,直到总减少量达到目标
方法一:基于 heapq 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 import heapqdef halveArray1 (nums ): heap = [] sum_val = 0 for num in nums: heapq.heappush(heap, -float (num)) sum_val += num sum_val /= 2 ans = 0 minus = 0 while minus < sum_val: cur = -heapq.heappop(heap) / 2 heapq.heappush(heap, -cur) minus += cur ans += 1 return ans
方法二:手写堆 + 精度优化 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 MAXN = 100001 heap_arr = [0 ] * MAXN size = 0 def halveArray2 (nums ): global size size = len (nums) sum_val = 0 for i in range (size - 1 , -1 , -1 ): heap_arr[i] = int (nums[i]) << 20 sum_val += heap_arr[i] heapify(i) sum_val //= 2 ans = 0 minus = 0 while minus < sum_val: heap_arr[0 ] //= 2 minus += heap_arr[0 ] heapify(0 ) ans += 1 return ans def heapify (i ): global size l = i * 2 + 1 while l < size: best = l + 1 if l + 1 < size and heap_arr[l + 1 ] > heap_arr[l] else l best = best if heap_arr[best] > heap_arr[i] else i if best == i: break swap(best, i) i = best l = i * 2 + 1 def swap (i, j ): heap_arr[i], heap_arr[j] = heap_arr[j], heap_arr[i]
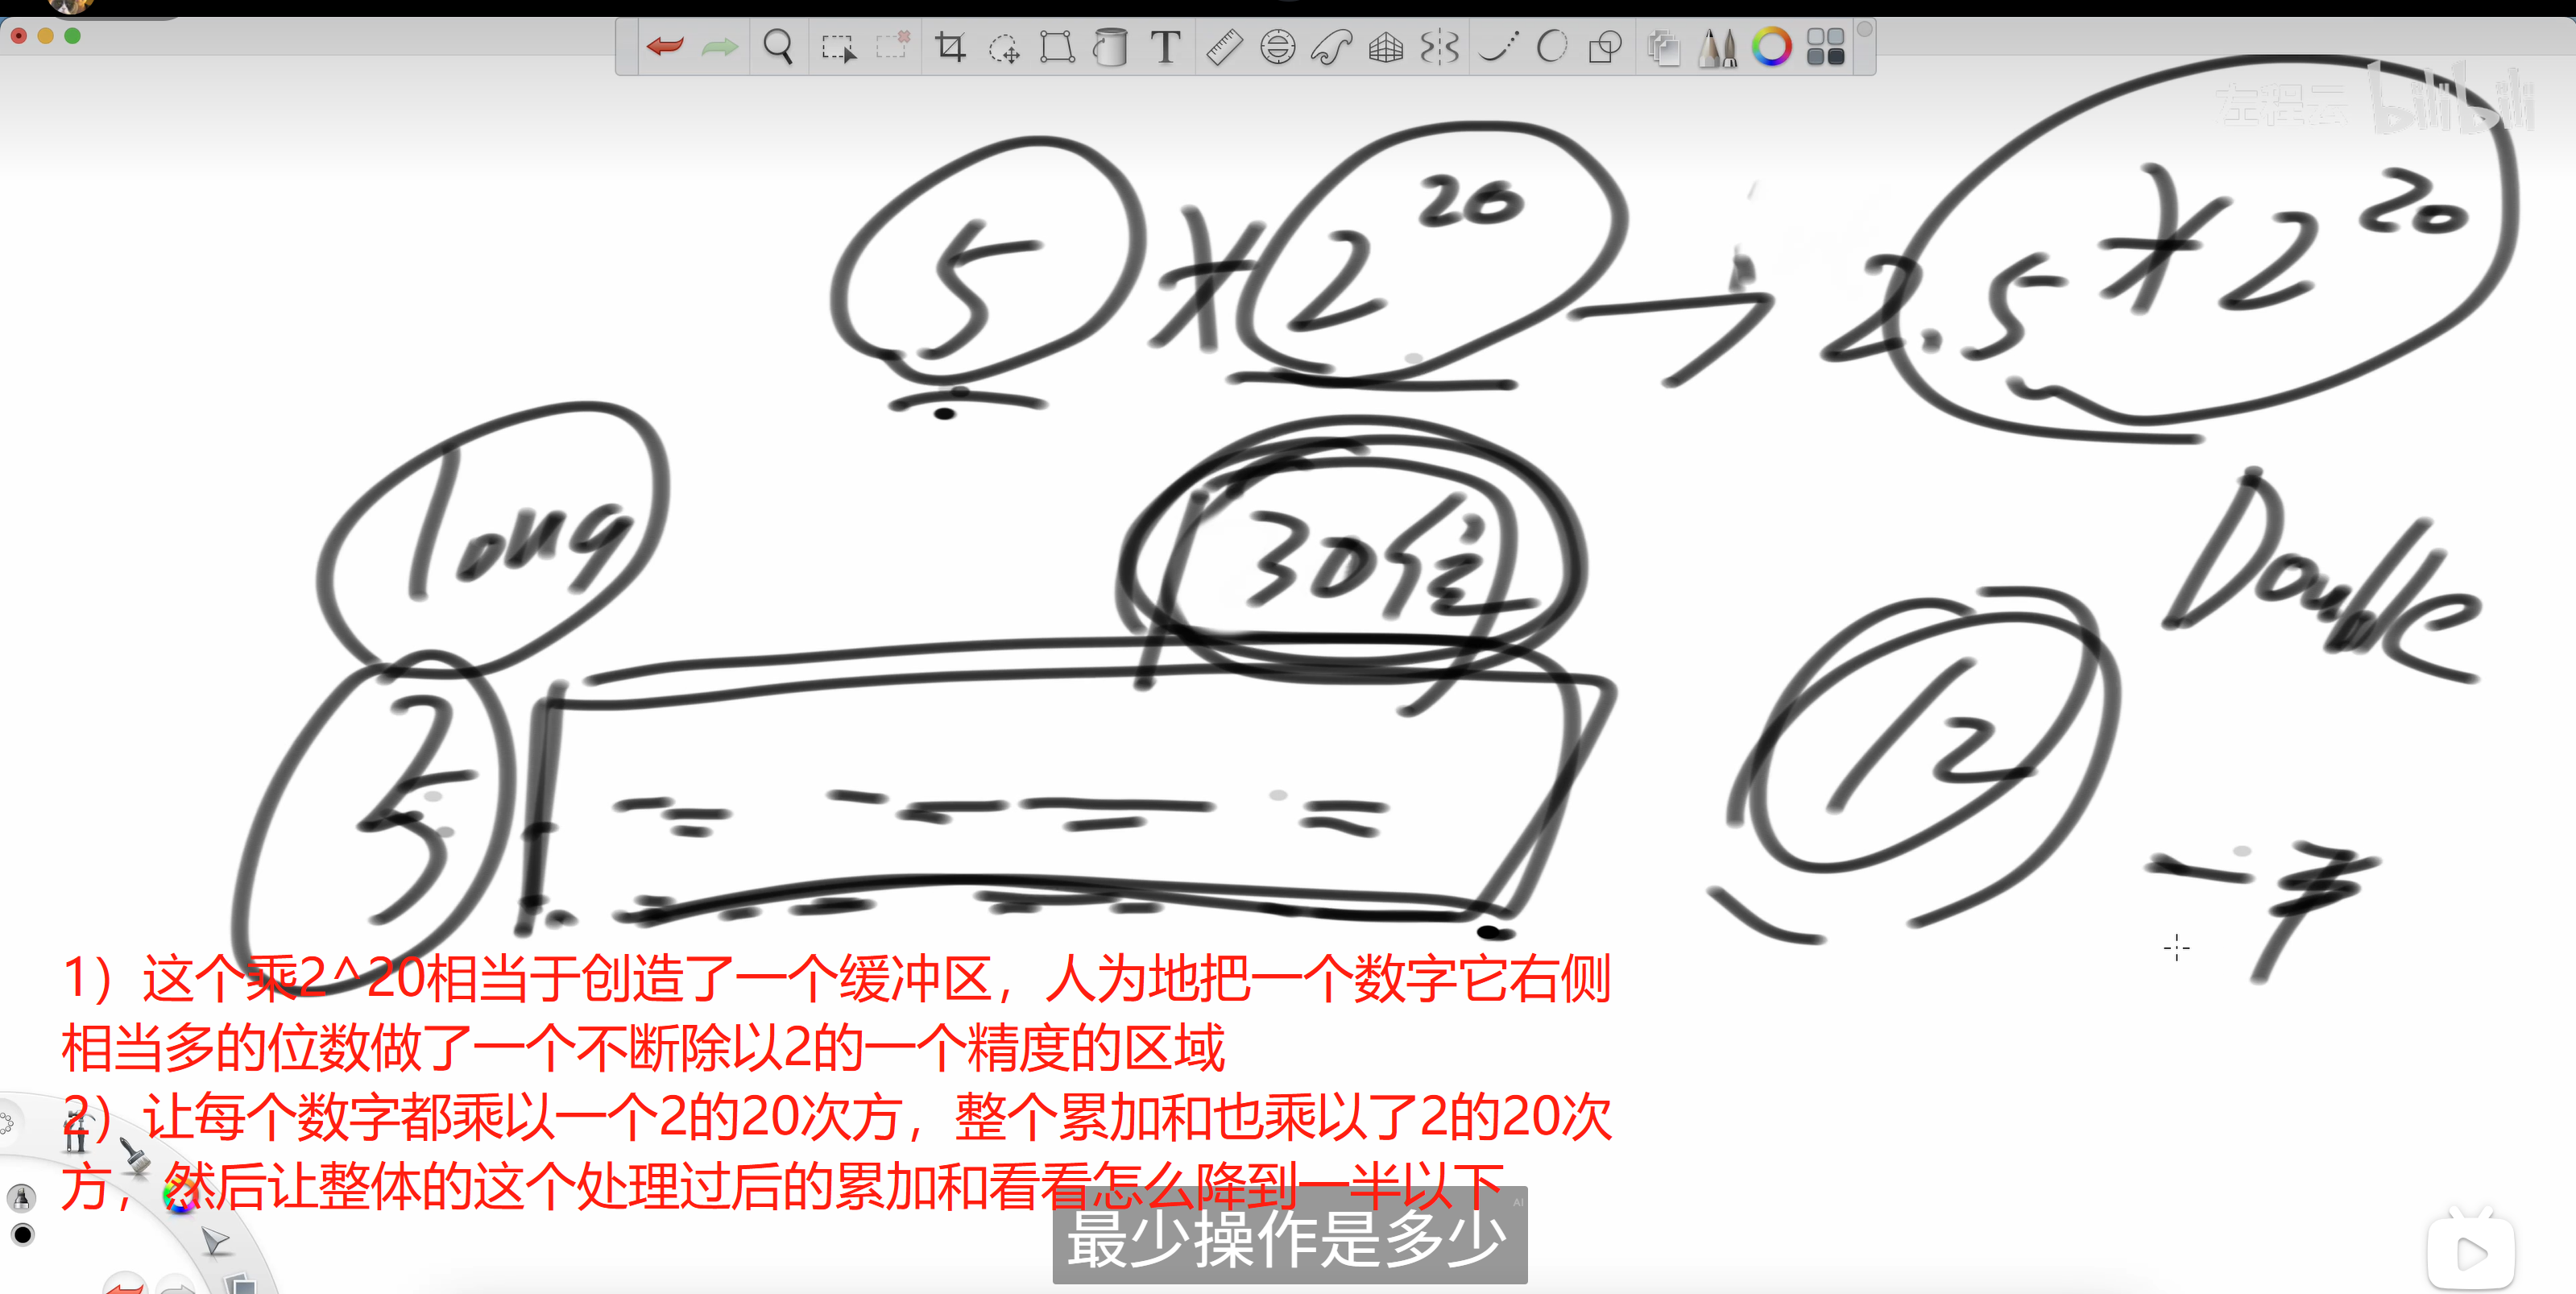
关键优化技术 精度处理 问题 :浮点数运算有精度损失,可能导致结果错误
解决方案 :
将所有数左移20位(乘以 2²⁰)
用整数运算模拟浮点数运算
int(32位) × 2²⁰ < long(64位),不会溢出
性能优化 手写堆 vs heapq :
heapq 基于 Python 列表,有额外开销
手写数组堆效率更高,常数因子更小
算法正确性证明 贪心策略的正确性 :
每次选择最大元素减半,获得的减少量最大
假设最优解不是每次选最大元素,可以证明交换操作不会使结果变差
因此贪心策略能得到最优解
复杂度分析
时间复杂度 :O(N log N),每个元素最多被操作 log(max_value) 次。若傻傻地每个元素都缩1/2,一定能达成目标;显然操作的元素个数一定小于n空间复杂度 :O(N),存储堆的空间
堆结构应用总结 适用场景
问题类型
堆类型
核心思想
典型例题
合并有序序列
小根堆
维护多个序列的当前最小值
合并K个有序链表
区间重合问题
小根堆
扫描线 + 维护结束时间
最多线段重合
贪心选择
大根堆
每次选择当前最值进行操作
数组和减半
Top-K问题
小根堆
维护K个最大值
第K大元素
任务调度
小根堆
按优先级处理任务
CPU任务调度
实现选择
情况
推荐实现
原因
原型开发
heapq
简单易用,标准库
性能要求高
手写堆
效率更高,常数因子小
需要大根堆
负数技巧
Python只有小根堆
精度要求高
整数模拟
避免浮点数误差
常见陷阱
对象比较问题 :自定义对象作为堆元素时,需要实现比较方法或使用包装精度问题 :浮点数运算可能有误差,关键场合使用整数堆类型混淆 :Python默认小根堆,大根堆需要取负数边界条件 :空堆操作、单元素情况需要特殊处理
性能优化技巧
预分配空间 :手写堆时预分配数组空间避免频繁内存操作 :使用数组而非动态列表批量操作 :heapify 比逐个插入效率高精度与性能平衡 :根据需求选择合适的数据类型
堆结构是解决很多算法问题的重要工具,在实际使用中,要根据具体问题选择合适的实现方式和优化策略。