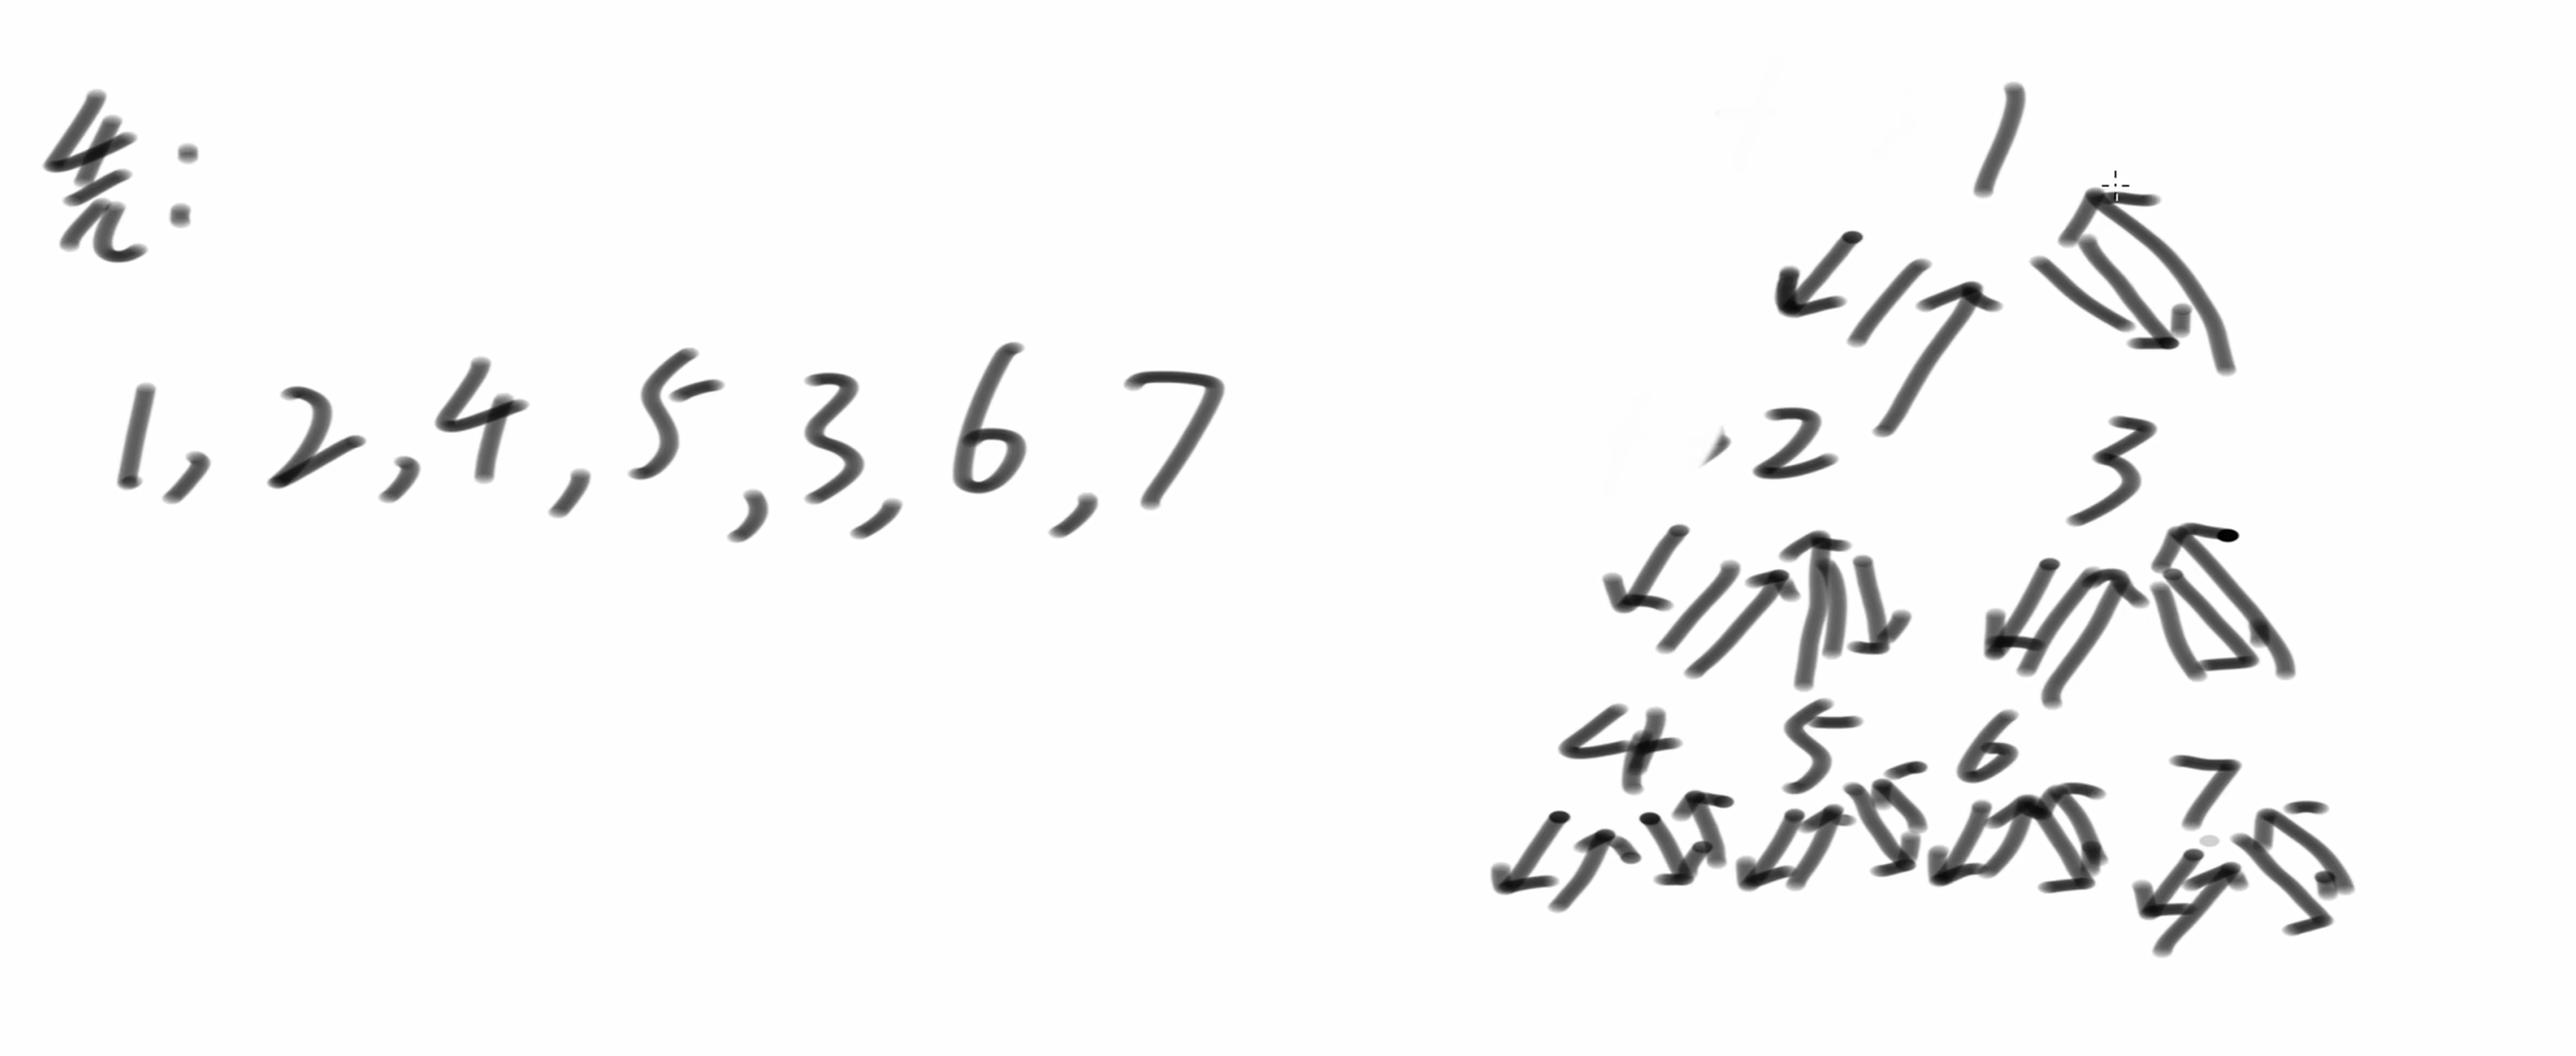0%

参照的是左程云的课程:https://space.bilibili.com/8888480/lists/3509640?type=series

记录的是class020→class022,包括了递归的本质理解、Master公式的应用、归并排序的递归与非递归实现,以及归并分治思想在解决小和问题和翻转对问题中的应用。

020【必备】递归和Master公式

递归的本质理解

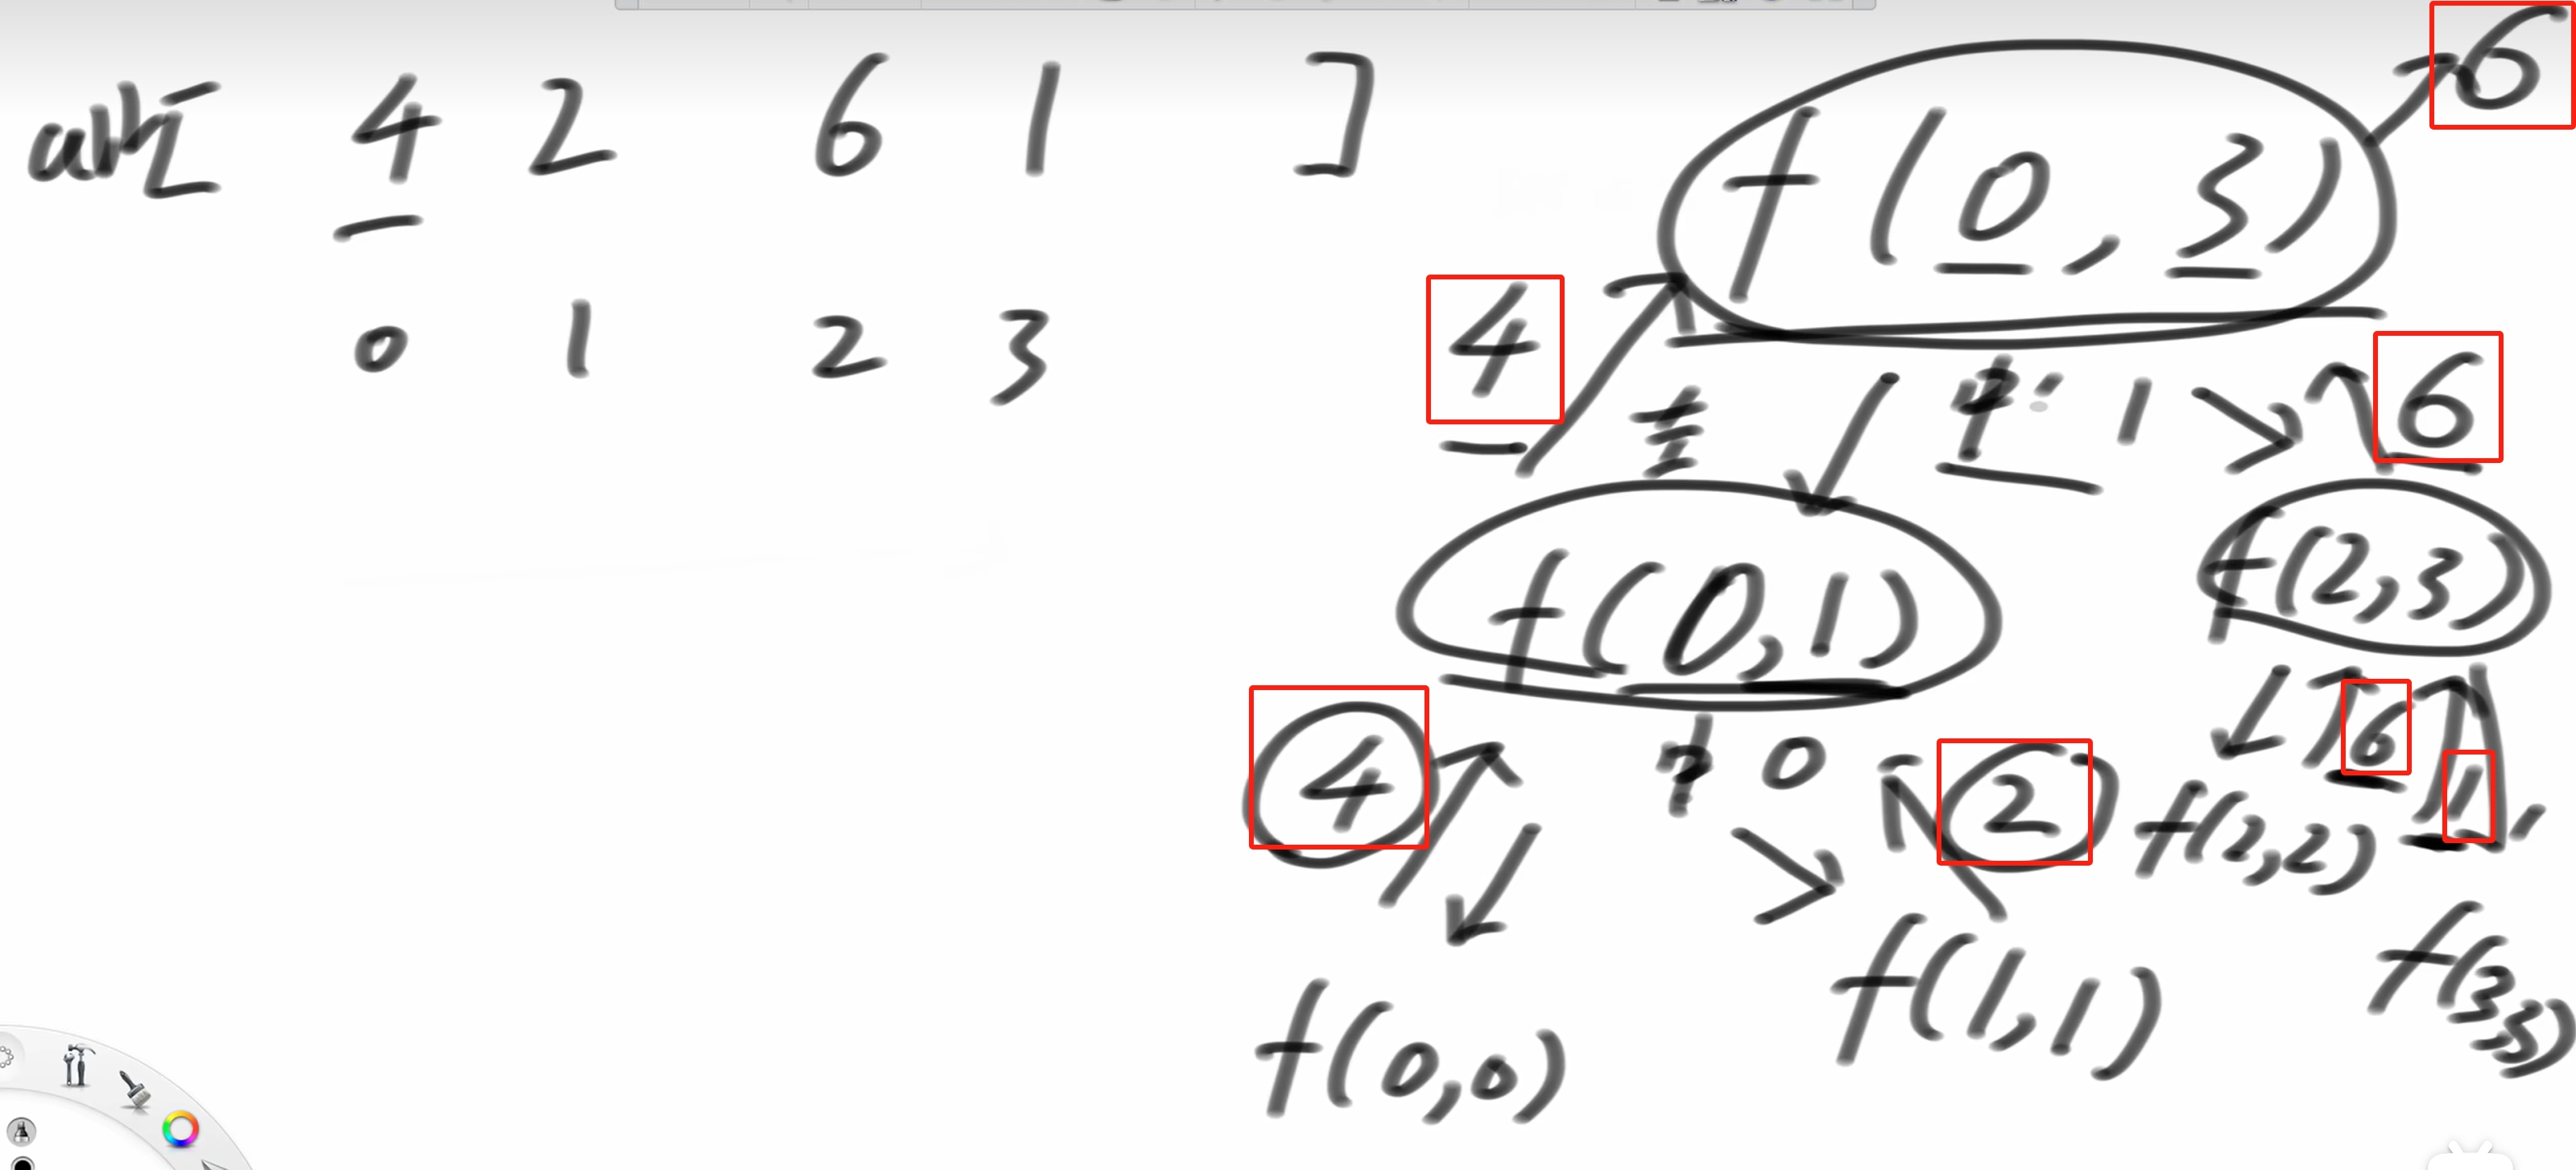
思想层面的递归

递归不是玄学,它是一种**”大事化小”**的思维方式。对于新手来说,画调用图是理解递归的关键。

1
2
3
4
5
6
7
8
9
10
11
12
13
def max_value(arr):
'''给定一个数组,在arr[l...r]范围上,返回最大值'''
return f(arr, 0, len(arr) - 1)

def f(arr, l, r):
# arr[l...r] 范围上的最大值
if l == r:
# 递归基:当左右下标相等时,区间只有一个数,直接返回
return arr[l]
m = (l + r) // 2 # 找到中点
lmax = f(arr, l, m) # 递归求左半部分最大值
rmax = f(arr, m + 1, r) # 递归求右半部分最大值
return max(lmax, rmax) # 返回左右部分的最大值

递归的三个关键点:

  1. 明确递归要干什么:这里是”返回 arr[l…r] 的最大值”
  2. 找递归的终止条件:这里是”l == r”,即区间只有一个数
  3. 思考如何缩小规模:这里是分别递归处理左区间和右区间

实际层面的递归

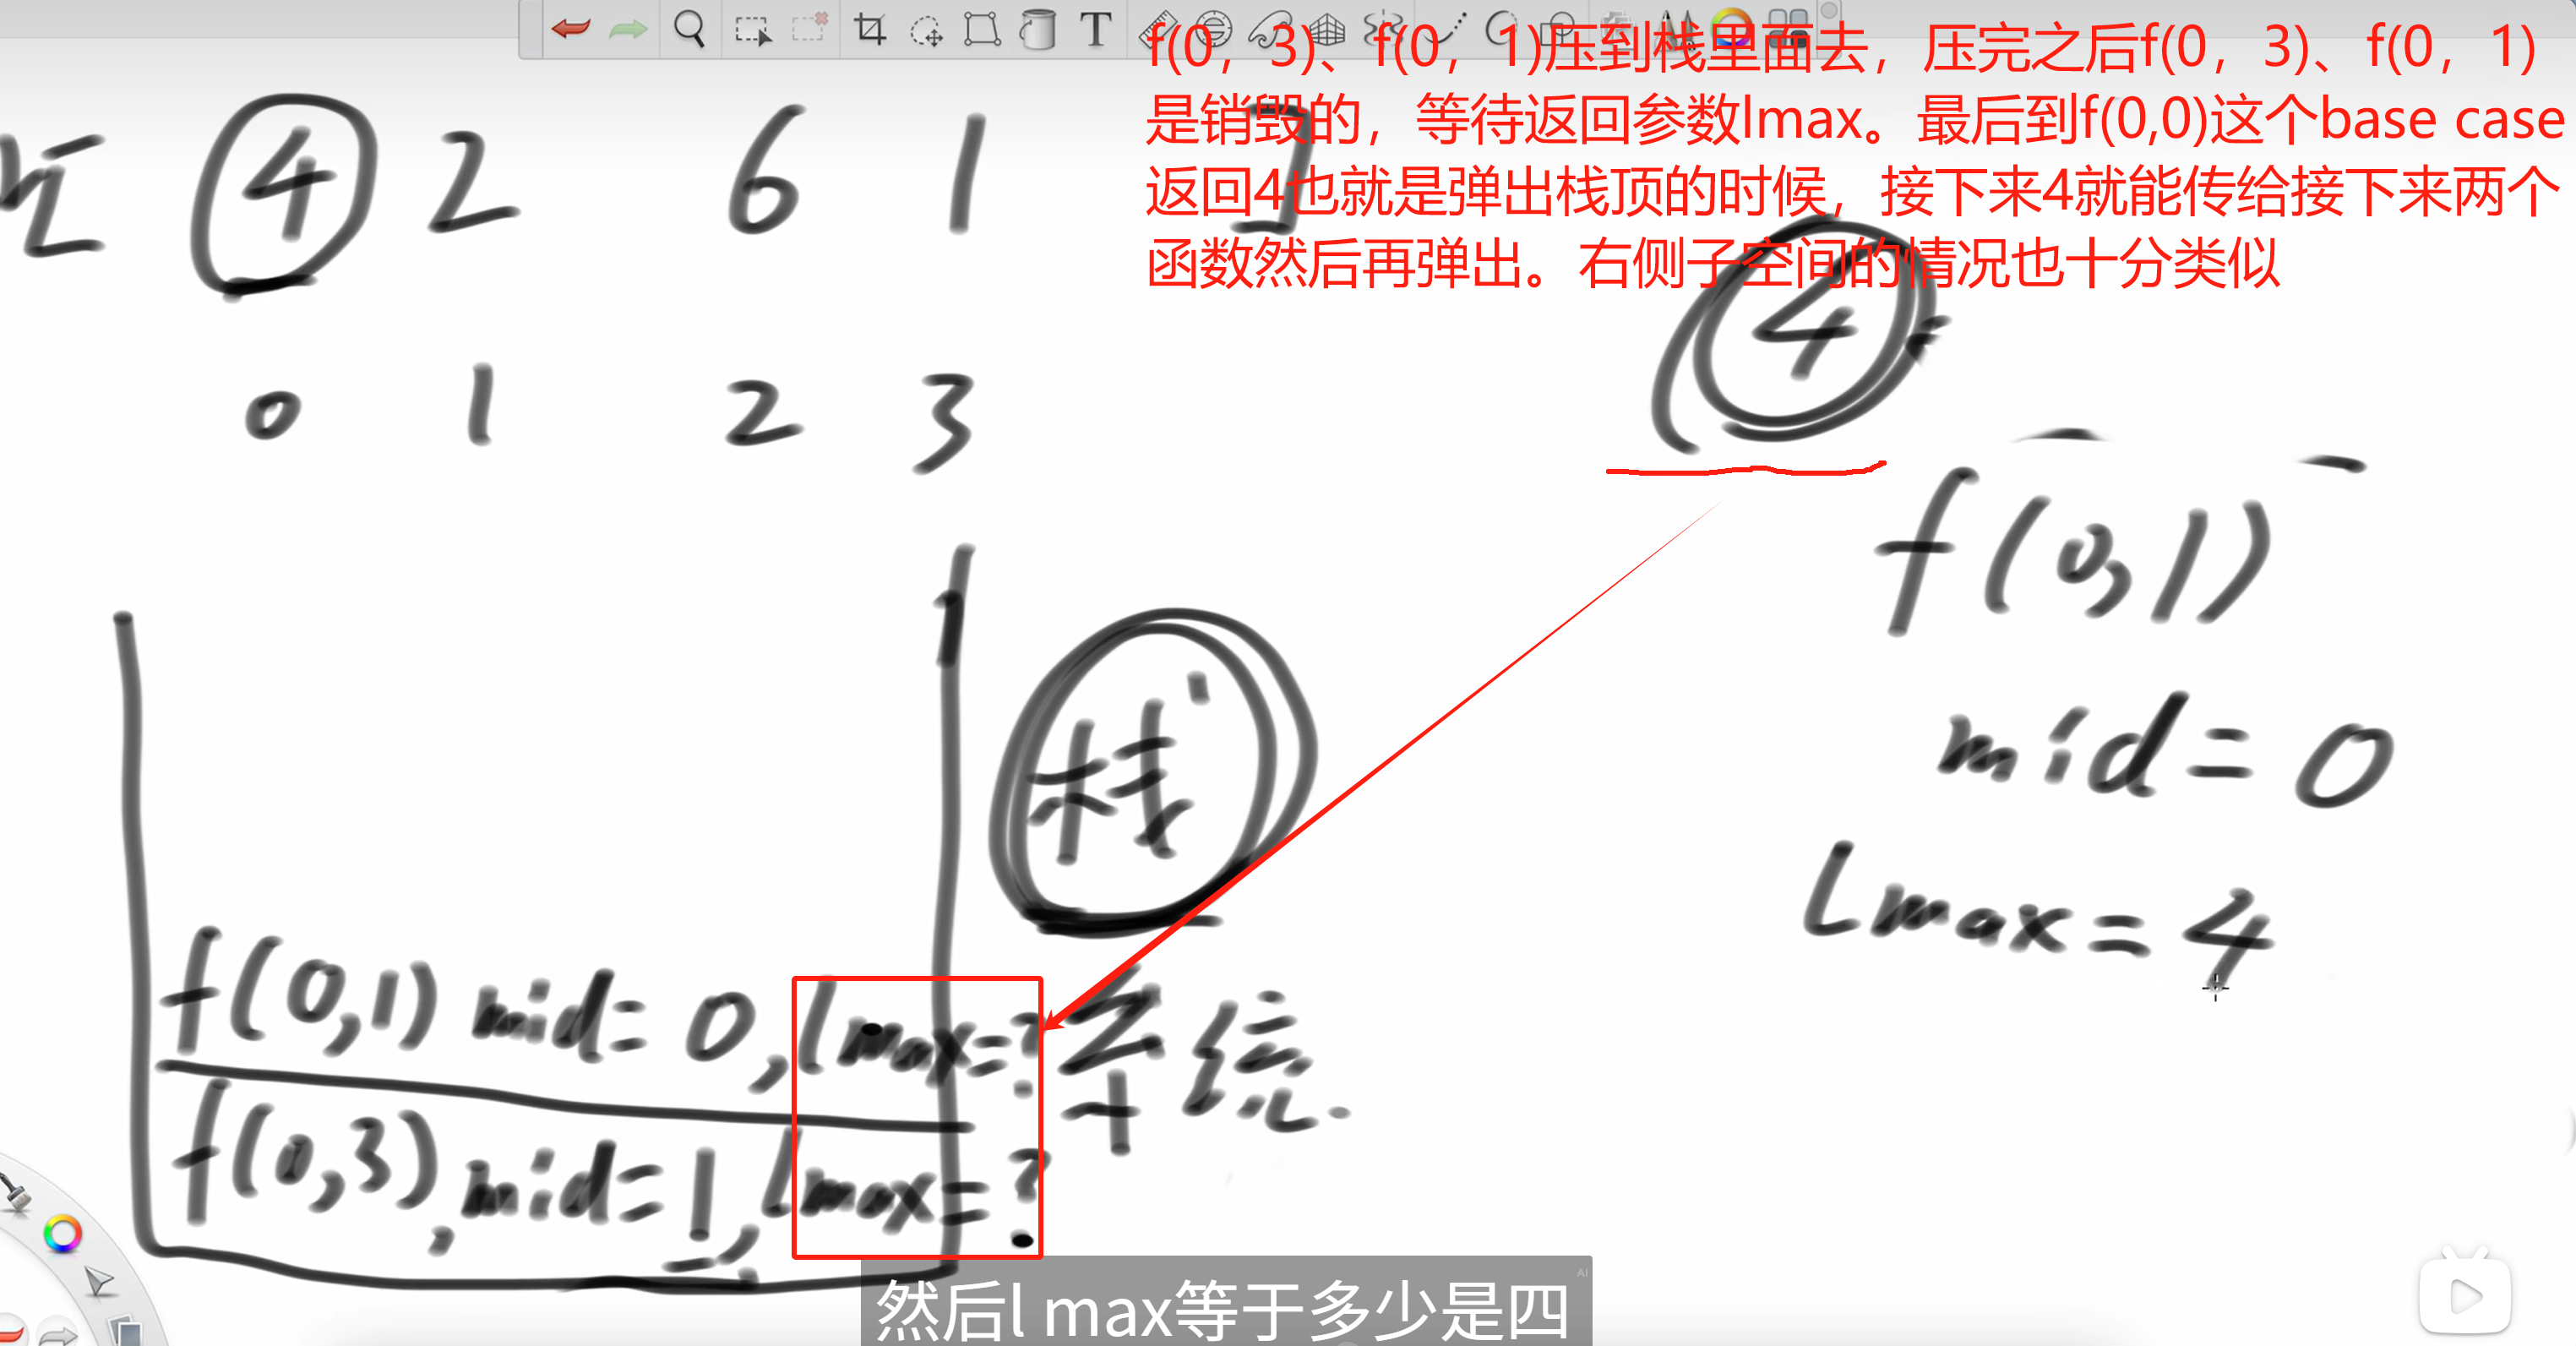
递归底层利用系统栈来实现:

  • 当函数调用发生时,系统会将函数的状态(参数、局部变量、返回地址)压入栈中
  • 当函数返回时,系统从栈中弹出状态,恢复到调用点继续执行
  • 这个过程是可视化的,所以所有递归函数都可以改成非递归

递归改非递归的必要性:

  • 工程实践:几乎一定要改,除非确定递归深度不会太大
  • 算法竞赛:能通过就不改,时间紧迫时优先保证正确性

形象比喻:

  • 迭代像是擂台赛:一个个来,逐步解决
  • 递归像是季后赛:分组对战,逐层淘汰
    递归过程分步
    递归时的数据结构

Master公式详解

Master公式用于分析分治算法的时间复杂度,适用于所有子问题规模相同的递归。

公式形式

$$T(n) = a \times T(\frac{n}{b}) + O(n^c)$$

其中:

  • a:子问题被调用的次数
  • b:子问题规模(数据量变为原来的1/b)
  • c:除去子问题之外的时间复杂度指数

判断标准

设 $\log_b(a) = d$,则:

条件 时间复杂度 说明
$d < c$ $O(n^c)$ 合并工作量占主导
$d > c$ $O(n^d)$ 递归调用占主导
$d = c$ $O(n^c \log n)$ 两者平衡

经典例子分析

1
2
3
4
5
6
7
8
9
10
# 归并排序:T(n) = 2*T(n/2) + O(n)
# a=2, b=2, c=1
# log₂(2) = 1 = c,所以复杂度为 O(n*logn)

# 二分查找:T(n) = 1*T(n/2) + O(1)
# a=1, b=2, c=0
# log₂(1) = 0 = c,所以复杂度为 O(logn)

# 快速排序最好情况:T(n) = 2*T(n/2) + O(n)
# 结果同归并排序:O(n*logn)

特殊情况

对于 $T(n) = 2 \times T(\frac{n}{2}) + O(n \log n)$:

  • 这不符合标准Master公式形式,结果是 $O(n \times (\log n)^2)$,需要特殊记忆,证明过程较复杂,这种递归式常见于“分治 + 合并时需要二分/复杂统计”的问题,比如“翻转对”、“区间对统计”,主定理告知其复杂度为 $O(n \log^2 n)$

021【必备】归并排序

归并排序原理

核心思想

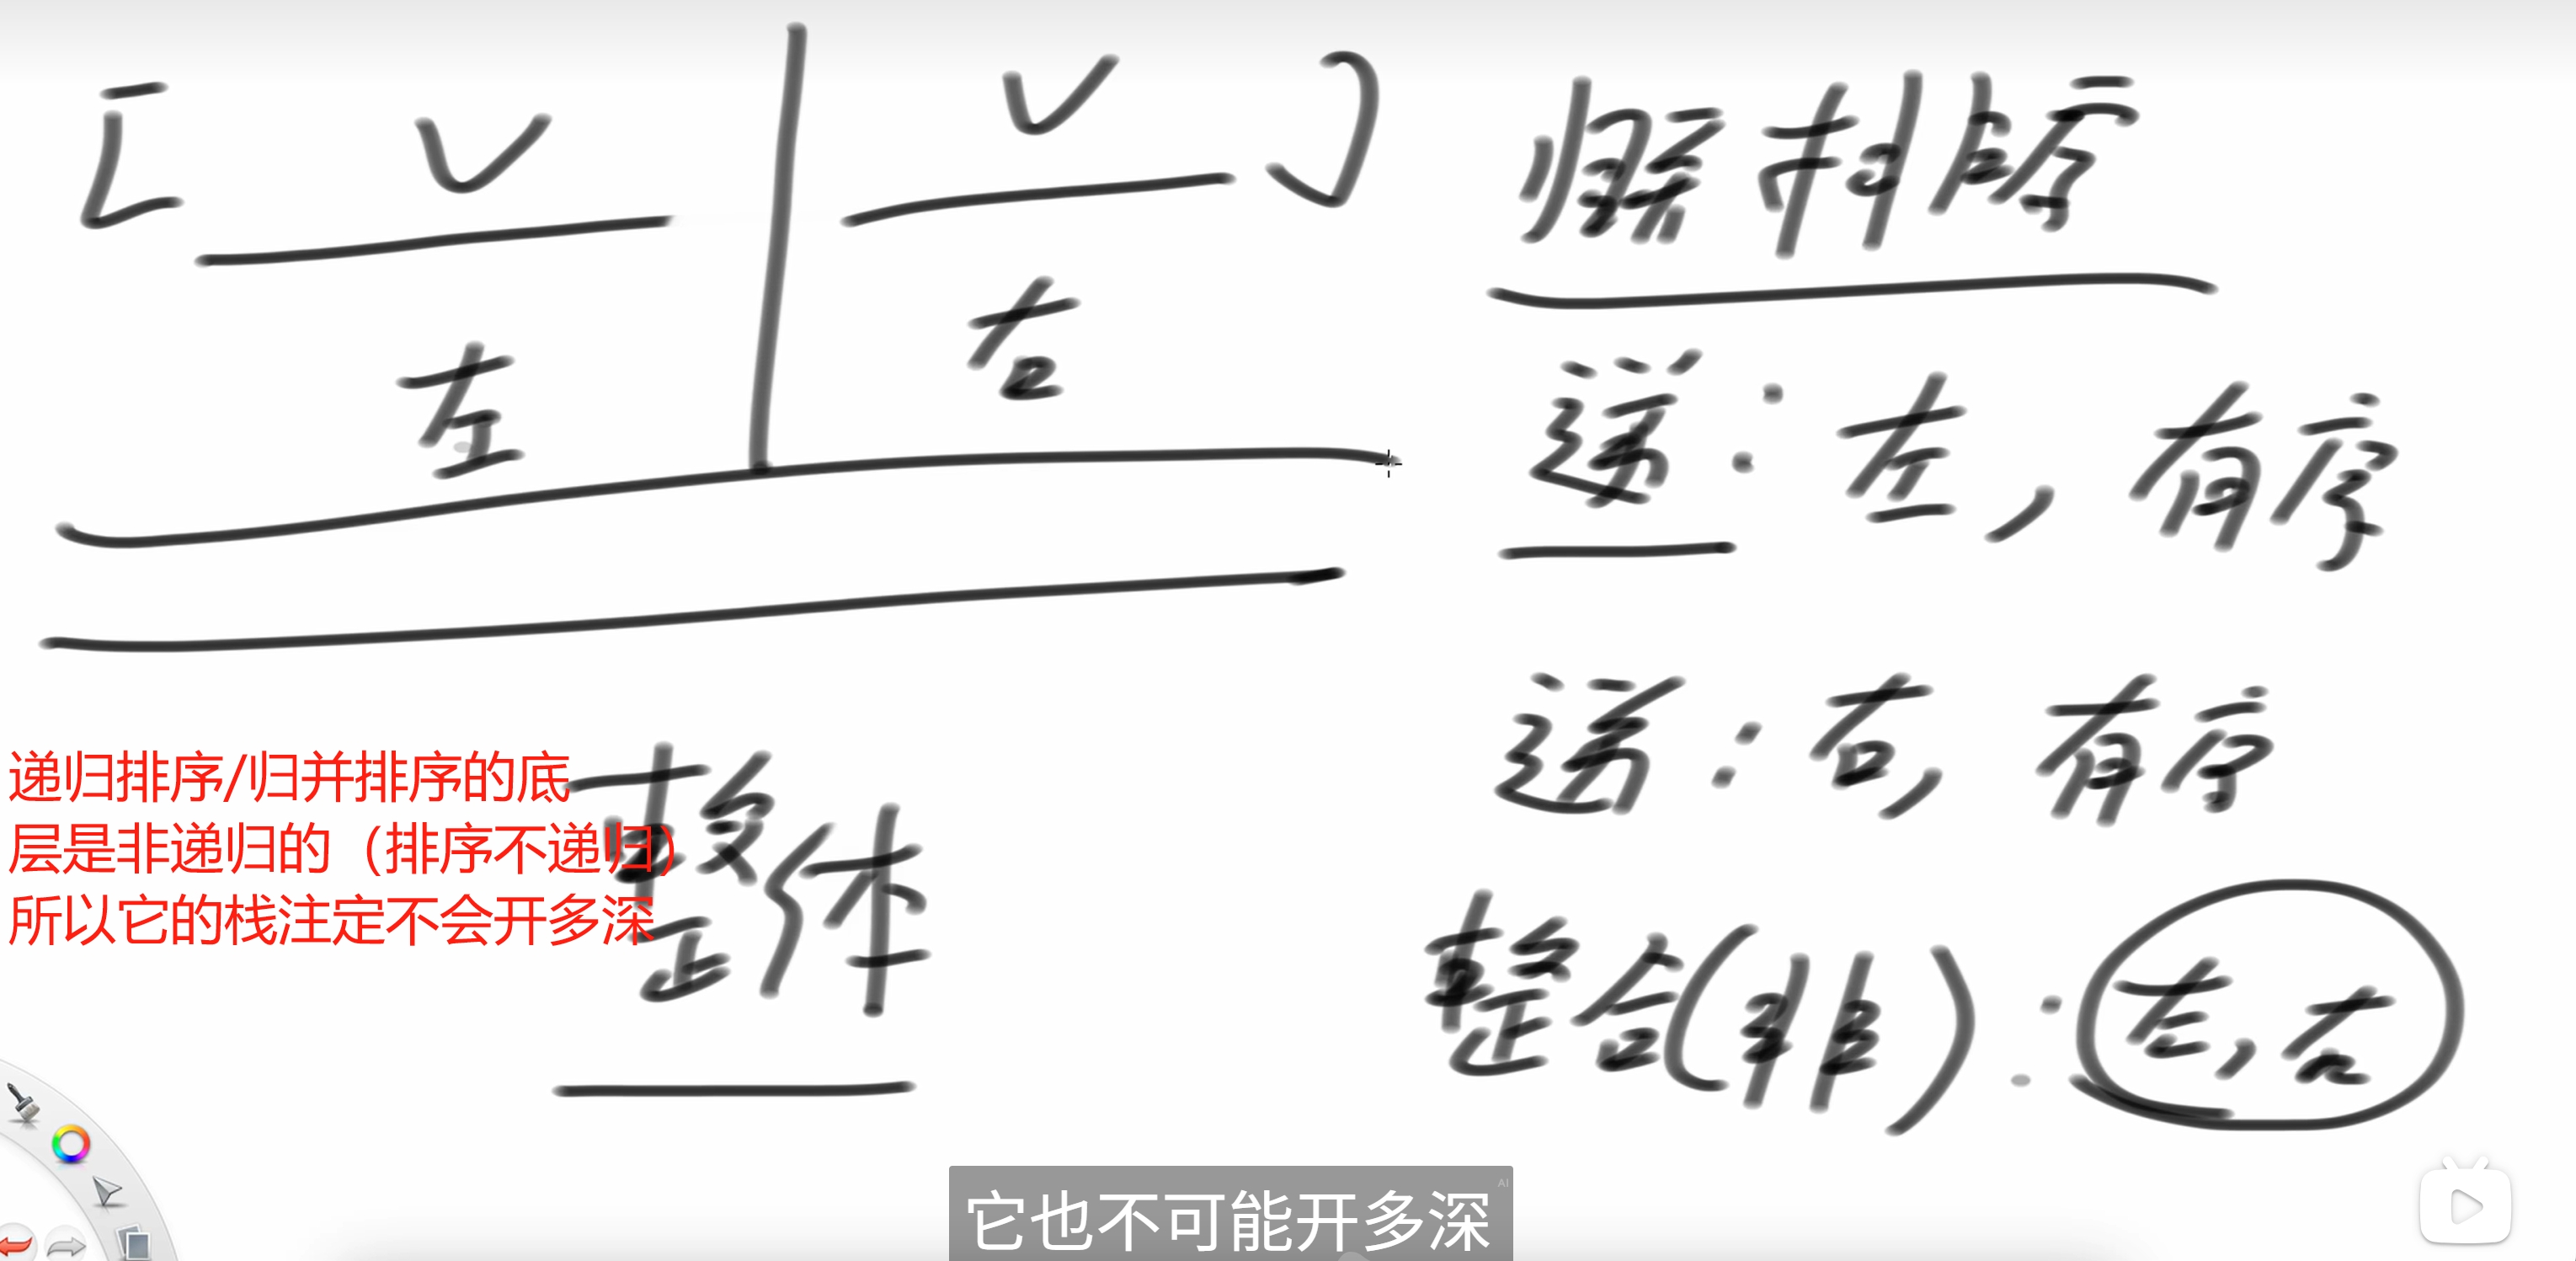
  1. 左部分排好序、右部分排好序
  2. 利用merge过程让左右整体有序
  3. merge过程:谁小拷贝谁,直到左右两部分数字耗尽,拷贝回原数组

为什么归并排序比O(n²)排序快?

比较行为没有浪费!

对比三种原始排序(选择、冒泡、插入):

  • 每次1到N-1次比较只能确定一个位置
  • 大量比较工作被浪费,效率低下

归并排序中:

  • 每次比较都有意义,用于合并两个有序序列
  • 比较结果被充分利用,没有浪费
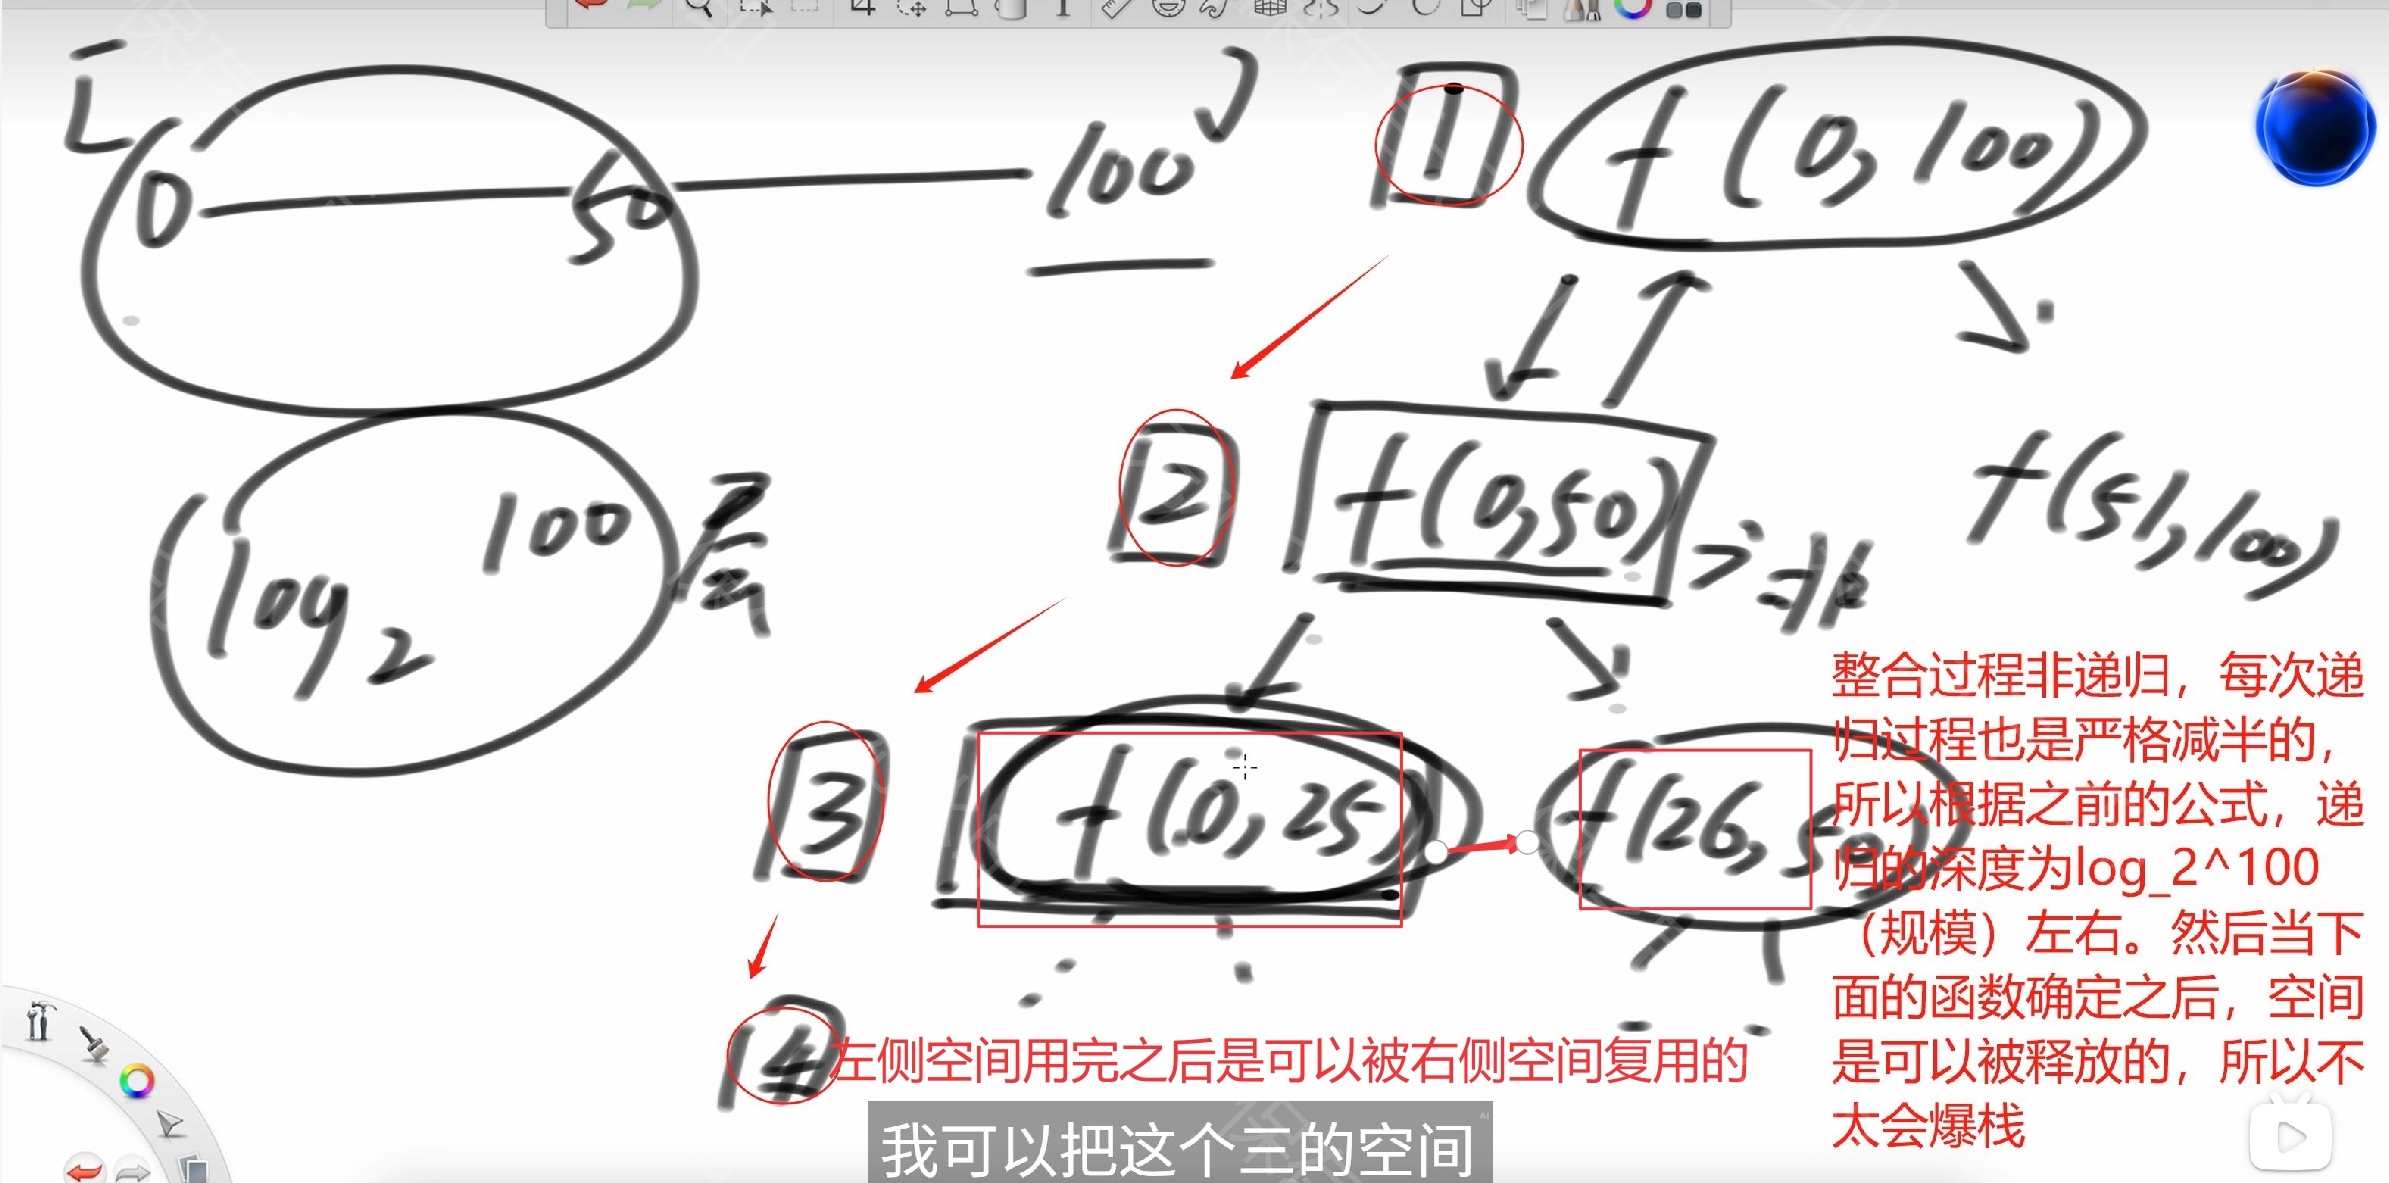
  • 系统栈不会太深

归并排序的栈不会深
归并排序的栈不会深2

测试链接 :https://www.luogu.com.cn/problem/P1177

递归实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
MAXN = 100001
arr = [0] * MAXN # 原数组
help_arr = [0] * MAXN # 辅助数组
n = 0 # 数组长度

def mergeSort1(l, r):
"""
归并排序递归版
T(n) = 2 * T(n/2) + O(n)
根据master公式,时间复杂度O(n * logn)
空间复杂度O(n)
"""
if l == r: # 递归终止条件:只剩一个元素
return
m = (l + r) // 2 # 计算中点
mergeSort1(l, m) # 递归排序左半部分
mergeSort1(m + 1, r) # 递归排序右半部分
merge(l, m, r) # 合并

def merge(l, m, r):
"""
合并两个有序区间 arr[l...m] 和 arr[m+1...r]
时间复杂度O(n),其中n = r - l + 1
"""
i = l # help数组写指针
a = l # 左侧起始指针
b = m + 1 # 右侧起始指针

# 双指针合并过程
while a <= m and b <= r:
if arr[a] <= arr[b]:
help_arr[i] = arr[a]
a += 1
else:
help_arr[i] = arr[b]
b += 1
i += 1

# 处理剩余元素
while a <= m:
help_arr[i] = arr[a]
a += 1
i += 1
while b <= r:
help_arr[i] = arr[b]
b += 1
i += 1

# 写回原数组
for i in range(l, r + 1):
arr[i] = help_arr[i]

非递归实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
def mergeSort2():
"""
归并排序非递归版
时间复杂度O(n * logn):外层循环O(logn),内层归并O(n)
空间复杂度O(n)
"""
global n
step = 1 # 步长初始化为1

while step < n: # 外层控制步长,共O(logn)次
l = 0 # 每轮从左端开始

while l < n: # 内层处理每一组
m = l + step - 1 # 计算中点
if m + 1 >= n: # 右半部分越界,跳出
break
r = min(l + (step << 1) - 1, n - 1) # 计算右边界
merge(l, m, r) # 合并
l = r + 1 # 移动到下一组

step <<= 1 # 步长翻倍

非递归实现的核心思路

  1. step表示每次要合并的有序段长度,初始为1(每个元素自己是有序段)
  2. 每一轮成对合并长度为step的有序段,合并成长度为2*step的有序段
  3. 下一轮step翻倍,继续两两合并
  4. 重复直到step >= n,整个数组有序

过程示例:

1
2
3
4
5
原数组: [3, 8, 7, 6, 4, 5, 1, 2]

step=1: [3,8] [6,7] [4,5] [1,2] → [3,8,6,7,4,5,1,2]
step=2: [3,6,7,8] [1,2,4,5] → [3,6,7,8,1,2,4,5]
step=4: [1,2,3,4,5,6,7,8] → [1,2,3,4,5,6,7,8]

merge过程详解

双指针合并策略

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
def merge(l, m, r):
"""
合并过程详解:
1. 双指针扫描:a指向左部分,b指向右部分
2. 比较合并:较小值写入help_arr,对应指针右移
3. 剩余处理:一边扫完后,另一边直接复制
4. 写回原数组:完成排序合并
"""
i = l # help_arr写入位置
a = l # 左部分起点
b = m + 1 # 右部分起点

# 两两比较,选择较小值
while a <= m and b <= r:
if arr[a] <= arr[b]:
help_arr[i] = arr[a]
a += 1
else:
help_arr[i] = arr[b]
b += 1
i += 1

# 处理剩余元素(必有一边先结束)
while a <= m:
help_arr[i] = arr[a]
a += 1
i += 1
while b <= r:
help_arr[i] = arr[b]
b += 1
i += 1

# 拷贝回原数组
for idx in range(l, r + 1):
arr[idx] = help_arr[idx]

复杂度分析

时间复杂度:O(n log n)

  • 递归层数:log₂(n)层,每次将问题规模减半
  • 每层工作量:O(n),所有元素都要参与一次合并
  • 总复杂度:O(n) × O(log n) = O(n log n)

空间复杂度:O(n)

  • 辅助数组:需要与原数组等长的help_arr
  • 递归栈:最大深度O(log n),但主要空间开销是辅助数组
  • 原地归并:理论上可以做到O(1)空间,但时间复杂度会退化到O(n²)

022【必备】归并分治

归并分治的核心思想

归并分治是在归并排序基础上的拓展,用来解决更复杂的问题。

应用条件判断

一个问题能用归并分治解决,需要满足:

  1. 大范围答案 = 左部分答案 + 右部分答案 + 跨越左右产生的答案
  2. 计算”跨越左右产生的答案”时,左右各自有序能带来计算便利性
  3. 如果以上两点成立,该问题很可能被归并分治解决

求解过程:在归并排序过程中加入统计逻辑,利用左右有序的特性获得计算便利性。

小和问题

问题描述

给定数组arr,对于每个位置i,求出其左边所有小于等于arr[i]的数的累加和,所有位置的累加和即为数组的”小和”。

例子:

1
2
3
4
5
6
7
8
9
10
数组: [1, 3, 5, 2, 4, 6]

位置0(1): 左边小于等于1的数 → 0
位置1(3): 左边小于等于3的数 → 1
位置2(5): 左边小于等于5的数 → 1+3 = 4
位置3(2): 左边小于等于2的数 → 1
位置4(4): 左边小于等于4的数 → 1+3+2 = 6
位置5(6): 左边小于等于6的数 → 1+3+5+2+4 = 15

小和 = 0+1+4+1+6+15 = 27

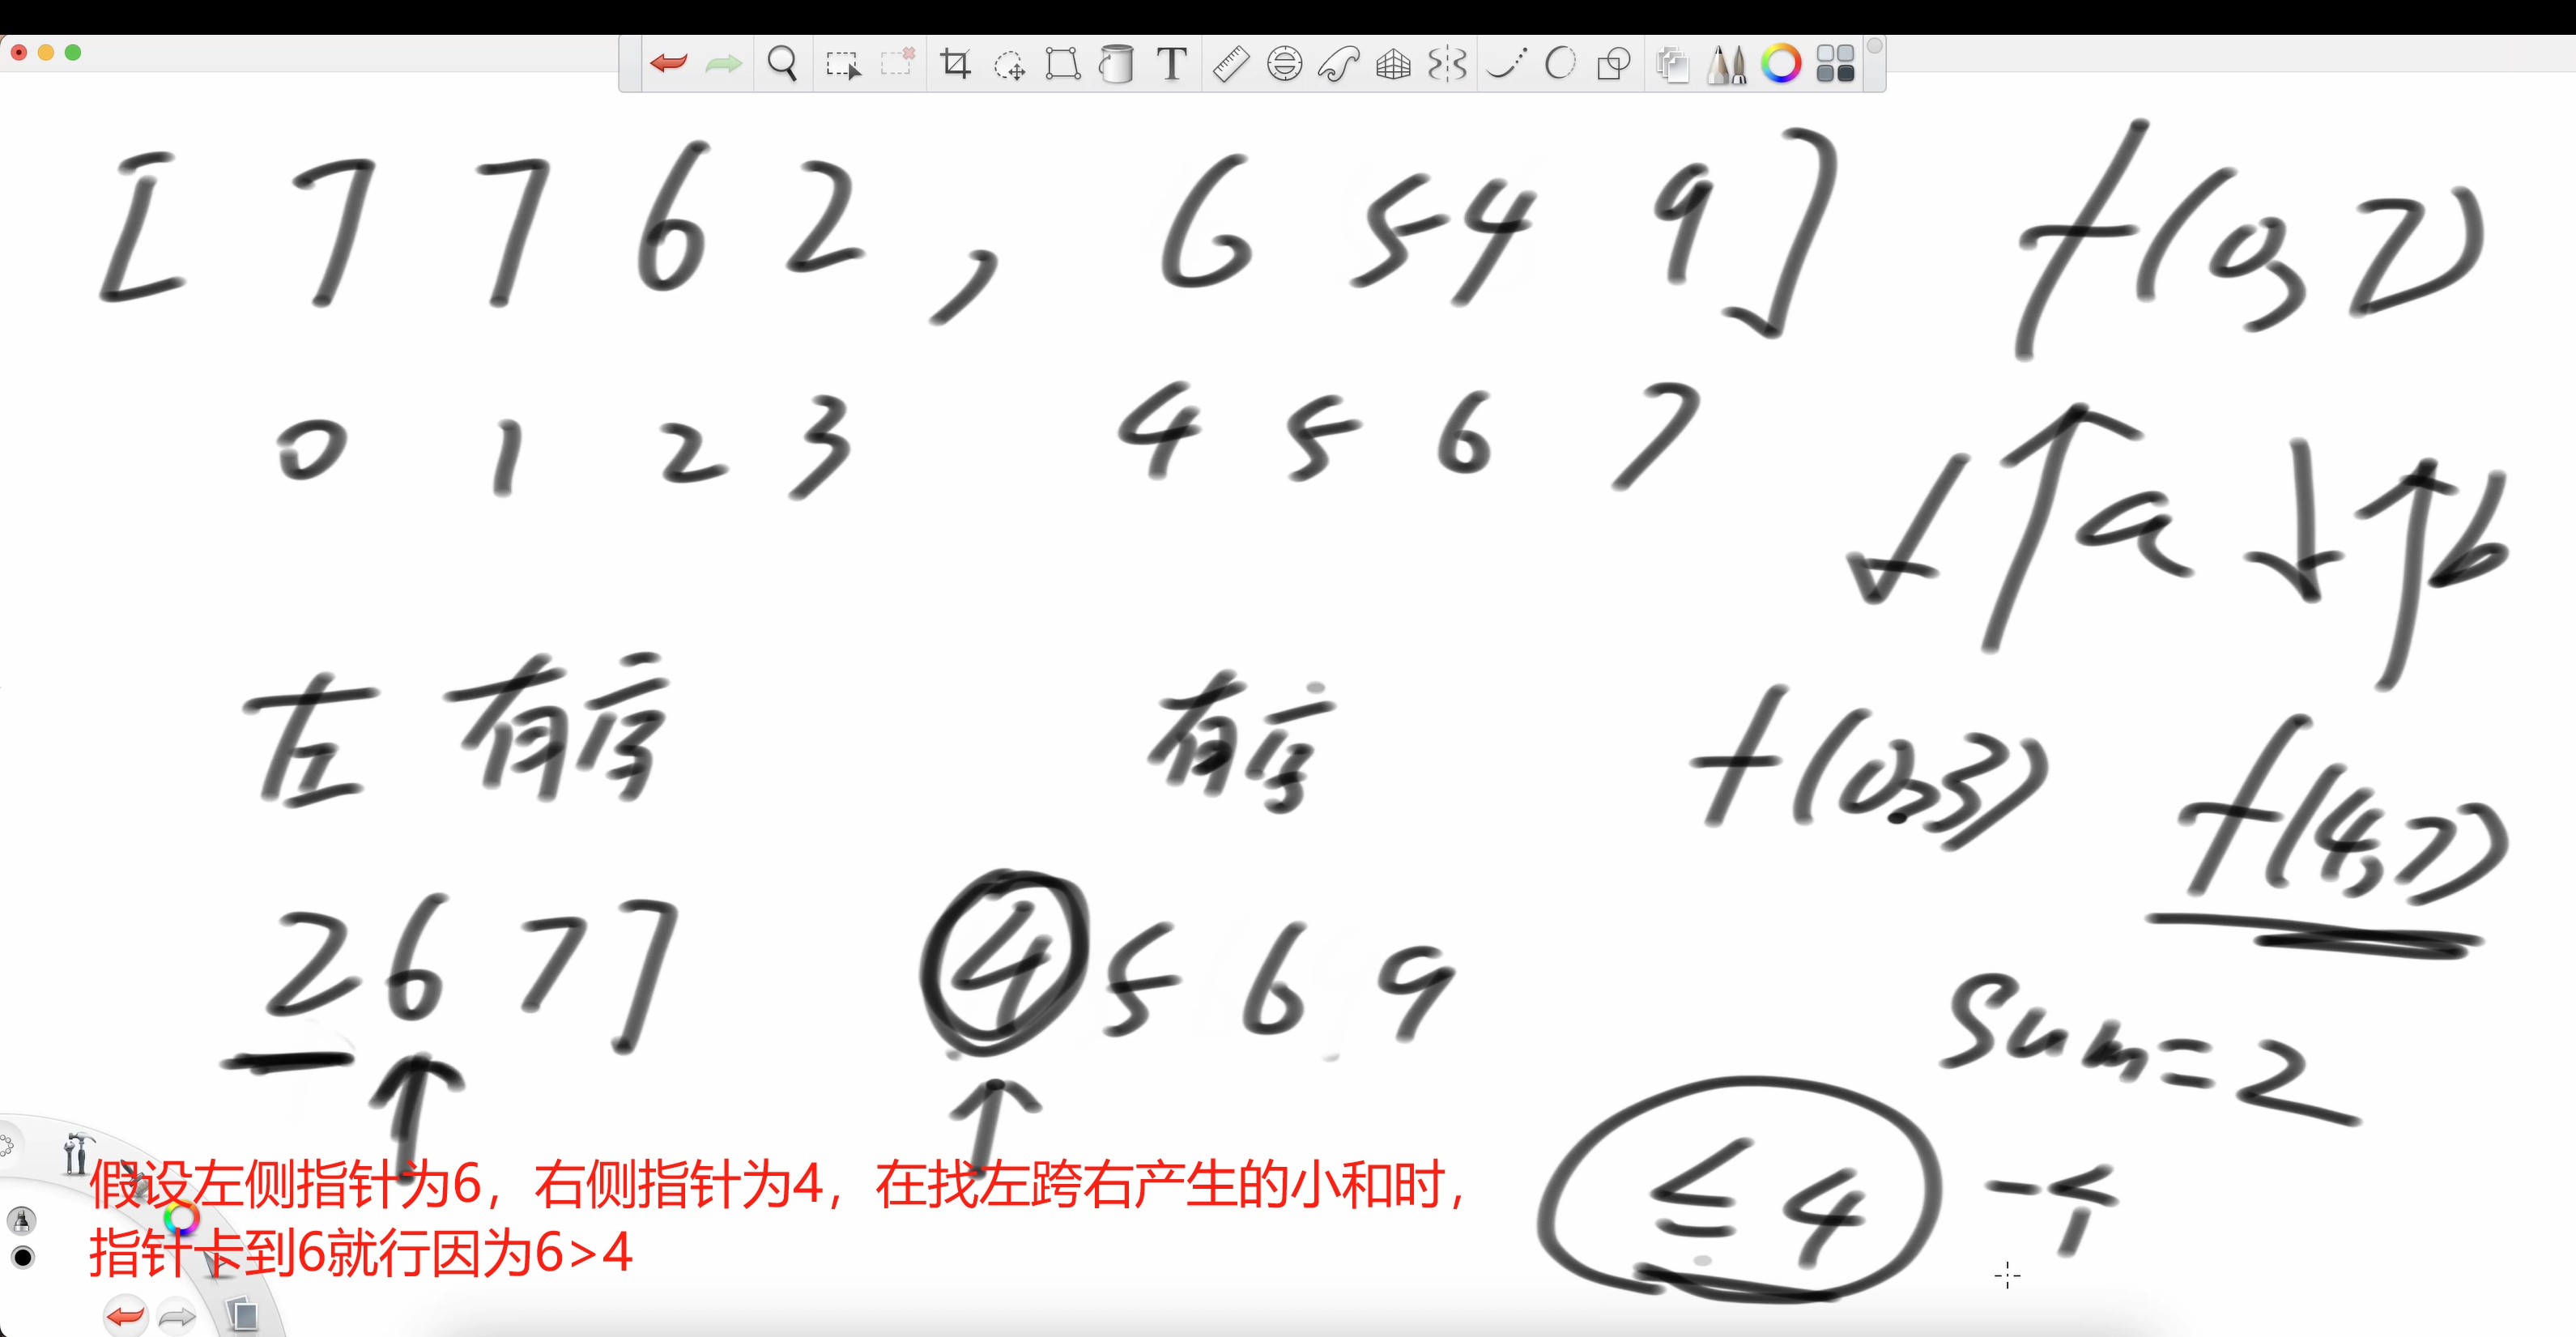
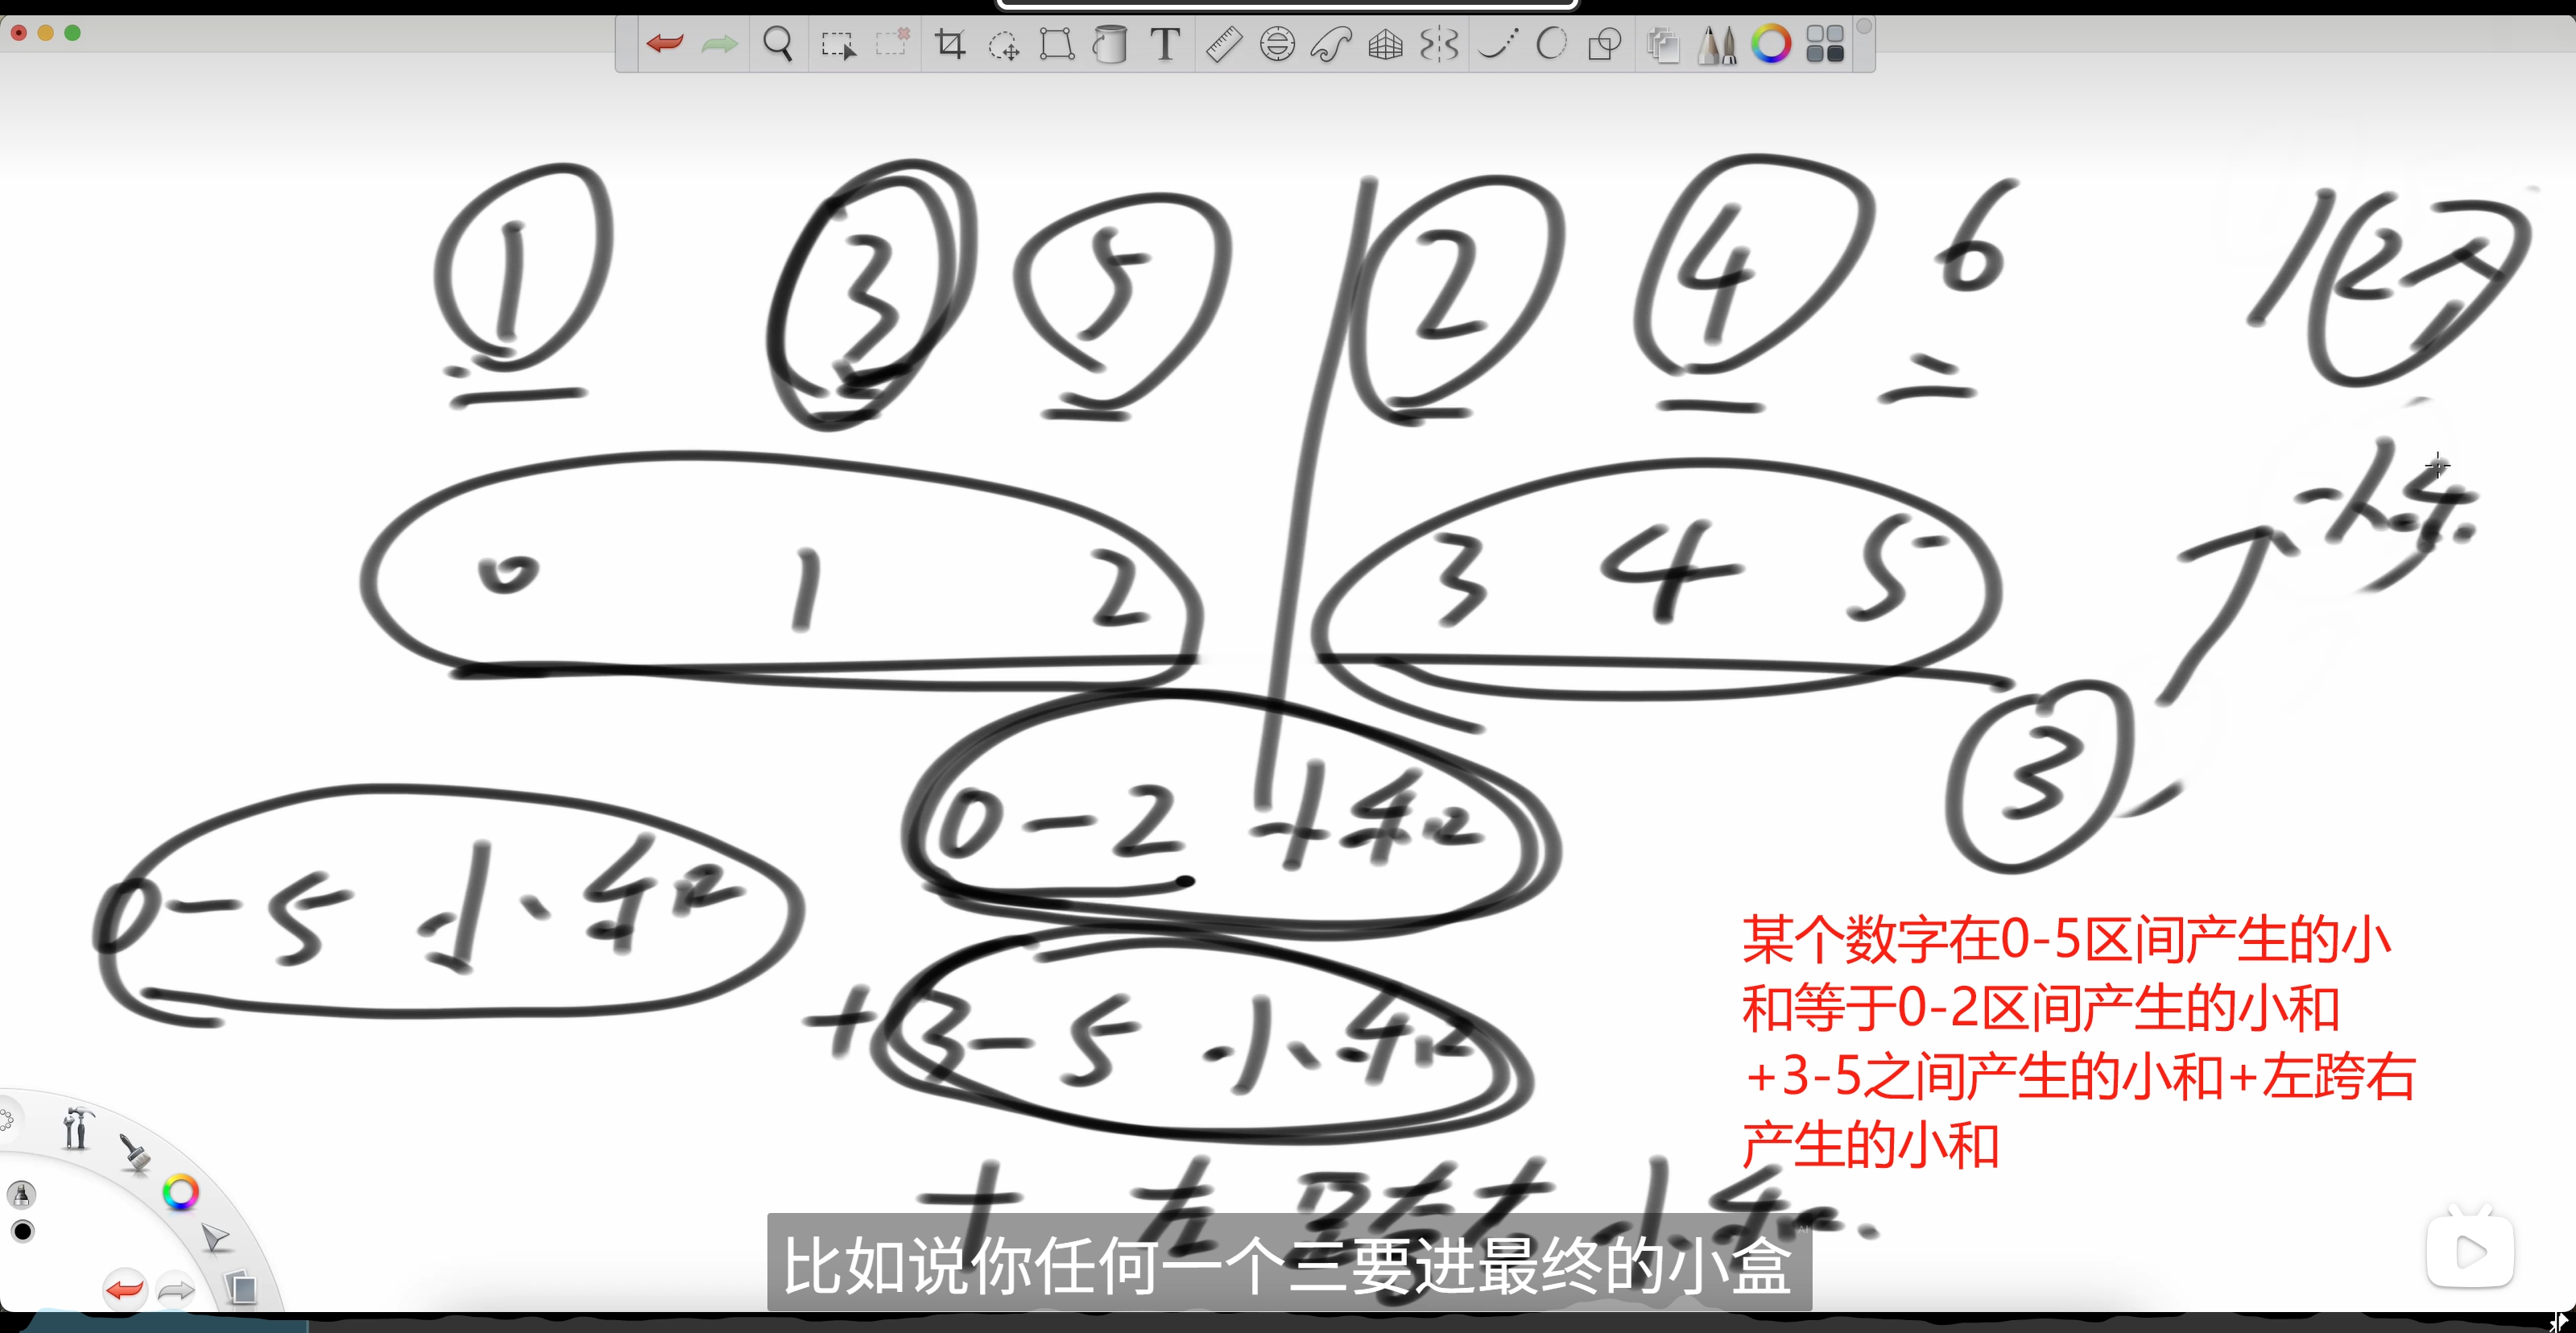
分治指针滑动
小和问题拆分成子问题

测试链接 :https://www.nowcoder.com/practice/edfe05a1d45c4ea89101d936cac32469

归并分治解法

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
def smallSum(l, r):
"""
返回arr[l...r]范围上小和的累加和,同时让arr[l..r]变有序
时间复杂度O(n * logn)
"""
if l == r:
return 0
m = (l + r) // 2
# 递归统计左右部分和跨区部分的小和
return smallSum(l, m) + smallSum(m + 1, r) + merge(l, m, r)

def merge(l, m, r):
"""
统计跨左右产生的小和,同时完成合并
"""
ans = 0 # 累计小和
i = l # 左侧指针
sum_left = 0 # 累计左侧小于等于当前右侧元素的和

# 统计跨区贡献:对每个右侧元素,统计左侧贡献
for j in range(m + 1, r + 1):
# 左侧所有 <= arr[j] 的元素都对arr[j]有贡献
while i <= m and arr[i] <= arr[j]:
sum_left += arr[i] # 累加左侧贡献
i += 1
ans += sum_left # arr[j]的左侧贡献总和

# 正常归并过程
i = l
a = l
b = m + 1
while a <= m and b <= r:
if arr[a] <= arr[b]:
help_arr[i] = arr[a]
a += 1
else:
help_arr[i] = arr[b]
b += 1
i += 1
while a <= m:
help_arr[i] = arr[a]
a += 1
i += 1
while b <= r:
help_arr[i] = arr[b]
b += 1
i += 1
for idx in range(l, r + 1):
arr[idx] = help_arr[idx]

return ans

算法关键思路

为什么要在merge过程中统计?

  1. 左右有序的便利性:因为左右都有序,可以用双指针线性扫描
  2. 避免重复计算:每个跨区的小和贡献只需要计算一次
  3. 时间复杂度优势:总体保持O(n log n),而暴力解法是O(n²)

核心技巧:

  • 对于右半部分的每个元素arr[j],左半部分所有 ≤ arr[j] 的元素都会对小和产生贡献
  • 由于左半部分有序,可以用指针i从左向右扫描,累加贡献值
  • 指针i只会前进不会后退,总的扫描时间为O(n)

翻转对问题

问题描述

给定数组nums,如果i<j且nums[i]>2*nums[j],我们就将(i,j)称作一个重要翻转对。求数组中翻转对的总数量。

例子:

1
2
3
数组: [1,3,2,3,1]
翻转对: (1,4)→3>2*1, (3,4)→3>2*1
答案: 2

测试链接 :https://leetcode.cn/problems/reverse-pairs/

归并分治解法

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
def reversePairs(arr):
"""统计翻转对的主函数"""
return counts(arr, 0, len(arr) - 1)

def counts(arr, l, r):
"""
统计l...r范围上翻转对的数量,同时让l...r范围变有序
时间复杂度O(n * logn)
"""
if l == r:
return 0
m = (l + r) // 2
# 递归统计左右两边和跨区部分的翻转对数量
return counts(arr, l, m) + counts(arr, m + 1, r) + merge(arr, l, m, r)

def merge(arr, l, m, r):
"""统计跨区翻转对并完成合并"""
ans = 0 # 翻转对计数
j = m + 1 # 右边数组起点

# 统计跨区翻转对
for i in range(l, m + 1):
# 找到右侧第一个不满足 arr[i] > 2*arr[j] 的位置
while j <= r and arr[i] > 2 * arr[j]:
j += 1
# 当前i能形成的翻转对数量 = j - (m+1)
ans += j - m - 1

# 正常merge过程(与归并排序相同)
i = l
a = l
b = m + 1
while a <= m and b <= r:
if arr[a] <= arr[b]:
help_arr[i] = arr[a]
a += 1
else:
help_arr[i] = arr[b]
b += 1
i += 1
while a <= m:
help_arr[i] = arr[a]
a += 1
i += 1
while b <= r:
help_arr[i] = arr[b]
b += 1
i += 1
for idx in range(l, r + 1):
arr[idx] = help_arr[idx]

return ans

算法关键思路

统计策略:

  1. 利用左右部分独立有序:对于左半部分的每个元素arr[i],在右半部分找到满足arr[i] > 2*arr[j]的所有j
  2. 指针单向移动:左右部分都是有序的,指针j只需要前进,不需要回退
  3. 计数技巧:当找到第一个不满足条件的j时,说明j前面的所有元素都满足条件

时间复杂度分析:

  • 每个元素只会被访问一次,总的统计时间:O(n),符合归并分治的要求

归并分治总结

适用问题特征

  1. 可分解性:问题可以分解为左部分 + 右部分 + 跨区部分
  2. 有序性便利:跨区部分的计算在左右有序时能够优化
  3. 线性合并:跨区计算的时间复杂度为O(n)

解题模板

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
def divide_conquer(l, r):
if l == r:
return base_case

m = (l + r) // 2
left_ans = divide_conquer(l, m)
right_ans = divide_conquer(m + 1, r)
cross_ans = merge_and_count(l, m, r) # 关键:统计跨区答案

return left_ans + right_ans + cross_ans

def merge_and_count(l, m, r):
# 1. 利用左右有序性,统计跨区答案
cross_count = 0
# ... 统计逻辑

# 2. 正常的归并排序merge过程
# ... 合并逻辑

return cross_count

常见应用

  1. 小和问题:统计左侧小于等于当前元素的累加和
  2. 翻转对问题:统计满足特定大小关系的数对
  3. 最近点对问题:二维空间中最近两点距离(高难度)
  4. 逆序对问题:统计数组中的逆序对数量

与其他算法的关系

  • 线段树:也可以解决类似问题,但常数因子可能更大
  • 树状数组:适合在线查询修改,离线场景下归并分治更简洁
  • 分块算法:另一种分治思想,将在后续课程中介绍

归并分治是一种优雅而强大的算法思想,它将复杂问题通过分治和有序性的结合,优雅地降低了时间复杂度。掌握这种思想对于解决许多看似困难的问题都有很大帮助。

引言

参照的是左程云的课程:https://space.bilibili.com/8888480/lists/3509640?type=series

是class019的内容,本笔记重点介绍Python在算法竞赛和笔试中的高效输入输出处理技巧,包含子矩阵最大累加和问题的完整实现,以及与Java的性能对比分析。

019【必备】算法笔试中处理输入和输出

概述

在算法竞赛和大厂笔试中,输入输出的处理效率往往是程序性能的关键瓶颈。Python虽然在执行速度上不如C++和Java,但通过合理的IO优化技巧,同样可以在大多数场景下取得良好的性能表现。

Python vs Java IO性能对比

特性 Python Java
默认IO input()、print() 较慢 Scanner、System.out 较慢
高效IO sys.stdin.read()、批量输出 BufferedReader、PrintWriter
内存管理 自动垃圾回收,相对简单 需要考虑静态空间分配
大整数 原生支持任意精度 需要BigInteger类
编程复杂度 语法简洁,容易上手 类型安全,但代码较长

Python编程风格选择

填函数风格(OJ平台推荐)

适用于LeetCode、牛客网等在线判题平台,平台会自动处理输入输出。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
class Solution:
def sumOfSubMatrix(self, mat, n):
"""
只需实现核心算法逻辑
平台自动调用并验证结果
"""
return self.maxSumSubmatrix(mat, n, n)

def maxSumSubmatrix(self, mat, rows, cols):
max_sum = float('-inf')
for i in range(rows):
arr = [0] * cols # 辅助数组
for j in range(i, rows):
for k in range(cols):
arr[k] += mat[j][k]
max_sum = max(max_sum, self.maxSumSubarray(arr))
return max_sum

def maxSumSubarray(self, arr):
max_sum = float('-inf')
cur = 0
for num in arr:
cur += num
max_sum = max(max_sum, cur)
cur = max(cur, 0) # 负数时重置为0
return max_sum

ACM风格(竞赛笔试推荐)

适用于ACM竞赛、大厂笔试等需要自己处理输入输出的场景。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
import sys

def main():
"""
完整的输入输出处理
需要自己解析数据格式
"""
lines = sys.stdin.read().split()
ptr = 0
output = []

while ptr < len(lines):
n = int(lines[ptr])
ptr += 1
m = int(lines[ptr])
ptr += 1

# 构建矩阵
mat = []
for i in range(n):
row = []
for j in range(m):
row.append(int(lines[ptr]))
ptr += 1
mat.append(row)

# 计算结果
result = maxSumSubmatrix(mat, n, m)
output.append(str(result))

# 批量输出
print('\n'.join(output))

if __name__ == '__main__':
main()

高效输入输出技巧

输入优化策略

推荐:一次性读取大数据

1
2
3
4
5
6
7
8
9
10
11
import sys

# 最高效:适用于已知数据量的场景
lines = sys.stdin.read().split()
ptr = 0

# 逐个解析数据
while ptr < len(lines):
n = int(lines[ptr])
ptr += 1
# 处理数据...

优点:

  • IO次数最少,效率最高
  • 相当于Java的BufferedReader一次性读取
  • 适合大数据量场景

可选:按行读取

1
2
3
4
5
# 适用:需要按行处理不同格式数据
for line in sys.stdin:
parts = line.strip().split()
total = sum(int(num) for num in parts)
print(total)

适用场景:

  • 每行数据格式不同
  • 无法提前确定数据量
  • 相当于Java的逐行readLine()

不推荐:频繁调用input()

1
2
3
4
# 效率低:类似Java的Scanner
n = int(input()) # 大数据时很慢
for i in range(n):
x = int(input()) # 每次都要系统调用

输出优化策略

推荐:批量输出

1
2
3
4
5
6
7
# 收集所有结果,最后一次性输出
output = []
for i in range(n):
result = solve(data[i])
output.append(str(result))

print('\n'.join(output)) # 一次性输出

不推荐:频繁print()

1
2
3
# 每次print都会刷新缓冲区,效率低
for i in range(n):
print(solve(data[i])) # 大数据时很慢

内存优化:静态空间vs动态空间

推荐:静态空间分配

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
# 全局预分配,避免频繁内存分配
MAXN = 201
MAXM = 201
mat = [[0] * MAXM for _ in range(MAXN)] # 静态矩阵
arr = [0] * MAXM # 静态辅助数组

def solve():
global n, m
# 复用已分配的空间
for i in range(n):
for j in range(m):
mat[i][j] = read_next_int()

# 使用前先清空
for i in range(m):
arr[i] = 0

不推荐:频繁动态分配

1
2
3
4
5
6
7
8
def solve():
# 每次都重新分配内存
mat = [] # 动态创建
for i in range(n):
row = [] # 每行都新建
for j in range(m):
row.append(read_next_int())
mat.append(row)

子矩阵最大累加和问题详解

问题描述与算法思路

问题:给定包含正数、负数、零的矩阵,求累加和最大的子矩阵。

核心思想:将二维问题转化为一维最大子数组和问题

  1. 枚举子矩阵的上下边界(第i行到第j行)
  2. 将每列在这个范围内的元素累加,得到一维数组
  3. 对一维数组使用Kadane算法求最大子数组和

完整实现(填函数风格)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
class Code01_FillFunction:
def sumOfSubMatrix(self, mat, n):
"""主方法,求n×n矩阵的最大子矩阵和"""
return self.maxSumSubmatrix(mat, n, n)

@staticmethod
def maxSumSubmatrix(mat, n, m):
"""求子矩阵的最大累加和"""
max_sum = float('-inf')

# 枚举上边界
for i in range(n):
arr = [0] * m # 辅助数组,每次重置

# 枚举下边界(从i到n-1)
for j in range(i, n):
# 将第j行累加到辅助数组
for k in range(m):
arr[k] += mat[j][k]

# 求当前辅助数组的最大子数组和
max_sum = max(max_sum, Code01_FillFunction.maxSumSubarray(arr, m))

return max_sum

@staticmethod
def maxSumSubarray(arr, m):
"""Kadane算法求最大子数组和"""
max_sum = float('-inf')
cur = 0

for i in range(m):
cur += arr[i]
max_sum = max(max_sum, cur)
cur = 0 if cur < 0 else cur # 负数时重置

return max_sum

算法复杂度:

  • 时间复杂度:O(n² × m)
  • 空间复杂度:O(m)

ACM风格实现(静态空间优化)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
import sys

# 静态空间分配,避免频繁内存分配
MAXN = 201
MAXM = 201
mat = [[0] * MAXM for _ in range(MAXN)]
arr = [0] * MAXM
n = m = 0

def main():
global n, m
tokens = sys.stdin.read().split()
idx = 0
output = []

while idx < len(tokens):
n = int(tokens[idx])
idx += 1
m = int(tokens[idx])
idx += 1

# 读取矩阵数据到静态空间
for i in range(n):
for j in range(m):
mat[i][j] = int(tokens[idx])
idx += 1

# 计算结果并收集输出
output.append(str(maxSumSubmatrix()))

# 批量输出所有结果
print('\n'.join(output))

def maxSumSubmatrix():
"""使用静态空间的子矩阵最大和算法"""
max_sum = float('-inf')

for i in range(n):
# 清空辅助数组(复用静态空间)
for x in range(m):
arr[x] = 0

for j in range(i, n):
# 累加第j行到辅助数组
for k in range(m):
arr[k] += mat[j][k]
max_sum = max(max_sum, maxSumSubarray())

return max_sum

def maxSumSubarray():
"""一维最大子数组和"""
max_sum = float('-inf')
cur = 0

for i in range(m):
cur += arr[i]
max_sum = max(max_sum, cur)
cur = 0 if cur < 0 else cur

return max_sum

if __name__ == '__main__':
main()

执行过程示例

以矩阵为例:

1
2
3
[[-90, 48, 78],
[ 64,-40, 64],
[-81, -7, 66]]

枚举过程:

  1. i=0, j=0(第0行):arr=[-90, 48, 78] → 最大子数组和=126
  2. i=0, j=1(第0-1行):arr=[-26, 8, 142] → 最大子数组和=150
  3. i=0, j=2(第0-2行):arr=[-107, 1, 208] → 最大子数组和=209
  4. i=1, j=1(第1行):arr=[64, -40, 64] → 最大子数组和=88
  5. i=1, j=2(第1-2行):arr=[-17, -47, 130] → 最大子数组和=130
  6. i=2, j=2(第2行):arr=[-81, -7, 66] → 最大子数组和=66

最终结果:209(来自第0-2行,第2-2列的子矩阵)

Python高级IO优化

FastReader快读类

FastReader 是一个极致追求输入速度的工具,适用于数据量极大的算法竞赛场景。

主要作用

  • 极速读取输入,尤其是大量数字(如百万级数据)。
  • 通过 一次性读取大块数据(8KB) 到内存,减少系统I/O调用次数。
  • 按字节处理并手动解析数字,比标准 input() 或 sys.stdin.readline() 更快。

工作原理

  • 缓冲区:用 self.buffer 存储从输入流一次性读取的大块数据。
  • 按字节解析:用 readByte 方法逐字节读取,跳过非数字字符,自己实现整数解析(包括负数)。
  • 高效:只处理数字和符号,省略 split、strip 等高层方法,极致优化输入。

典型用法
适合极端大数据输入、对时间卡得很紧的OJ平台。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
import sys

class FastReader:
def __init__(self, file=sys.stdin):
self.file = file
self.buffer = ""
self.idx = 0

def _read(self):
"""一次性读取8KB数据到缓冲区"""
self.buffer = self.file.read(8192)
self.idx = 0

def readByte(self):
"""读取下一个字节"""
if self.idx >= len(self.buffer):
self._read()
if self.buffer == "":
return -1
byte = self.buffer[self.idx]
self.idx += 1
return ord(byte)

def readInt(self):
"""快速读取整数"""
num = 0
minus = False
b = self.readByte()

# 跳过非数字字符
while b != -1 and (b < ord('0') or b > ord('9')) and b != ord('-'):
b = self.readByte()

if b == ord('-'):
minus = True
b = self.readByte()

# 读取数字
while b != -1 and (ord('0') <= b <= ord('9')):
num = num * 10 + (b - ord('0'))
b = self.readByte()

return -num if minus else num

def readLong(self):
"""读取长整数(Python中与int相同)"""
return self.readInt()

FastWriter快写类

FastWriter 是一个高效输出工具,适用于需要频繁输出、输出量大的场合。

主要作用

  • 减少输出次数:把所有输出内容先缓存在内存里,最后统一输出,减少系统调用。
  • 链式调用和兼容Java风格,用起来很方便。

工作原理

  • 缓冲区:所有待输出内容先存入 self.buffer 列表。
  • 批量输出:调用 flush() 时,一次性将所有内容写入输出流。
  • 兼容性:支持 write(写字符串)、writeln/println(写一行),用法灵活。

典型用法

适合数据量大、频繁输出的算法题/竞赛场景,防止 print() 太慢导致超时。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
import sys

class FastWriter:
def __init__(self, file=sys.stdout):
self.file = file
self.buffer = []

def write(self, s):
"""写入字符串到缓冲区"""
self.buffer.append(str(s))
return self # 支持链式调用

def writeln(self, s=""):
"""写入一行"""
self.buffer.append(str(s) + "\n")
return self

def println(self, s=""):
"""兼容Java习惯的方法名"""
return self.writeln(s)

def flush(self):
"""刷新缓冲区,实际写入文件"""
if self.buffer:
self.file.write("".join(self.buffer))
self.file.flush()
self.buffer = []

def close(self):
"""关闭写入器"""
self.flush()
if self.file != sys.stdout:
self.file.close()

Kattio类(Python版)

Kattio 类是一个高效的输入输出(I/O)工具类,最初流行于 Java 的竞赛编程圈。它的 Python 版本(如你上面给出的代码)主要是用来简化和加快处理标准输入输出,尤其适合数据量较大、输入格式“特殊”或需要频繁读取单个数据的场景,比如各类算法竞赛、OJ(Online Judge)平台等。

主要作用

  • 高效读取输入:普通的 input() 在数据量大时会变慢,Kattio 通过缓冲和一次性读取一行数据,提升了读取效率。
  • 简化输入格式处理:常见的输入格式如多行多列、混合类型(int、float、str)都能方便读取,不用每次都写 split、map 一大堆。
  • 输出简便:带有封装的 println 方法,输出不再需要手动 print(…, file=…)。

工作原理

  • 维护一个缓冲区(self.buffer),每次读取一整行并分割成单词。
  • 提供 next() 方法按顺序读取下一个字符串,nextInt() 读取下一个整数,nextDouble() 读取下一个浮点数等。
  • 适配输入和输出流(默认为标准输入输出,但也可以重定向到文件),并提供 close 方法在需要时关闭流。

参考Java版Kattio的Python实现,处理特殊输入格式:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
import sys
from typing import Optional

class Kattio:
"""
高效IO类,适用于特殊格式输入
效率略低于FastReader,但兼容性更好
"""
def __init__(self, input_stream=sys.stdin, output_stream=sys.stdout):
self.input = input_stream
self.output = output_stream
self.buffer = []
self.idx = 0

def _fill_buffer(self):
"""填充缓冲区"""
line = self.input.readline()
if line == '':
return
self.buffer = line.strip().split()
self.idx = 0

def next(self) -> Optional[str]:
"""读取下一个字符串"""
while self.idx >= len(self.buffer):
self._fill_buffer()
if not self.buffer:
return None
result = self.buffer[self.idx]
self.idx += 1
return result

def nextInt(self) -> int:
"""读取下一个整数"""
return int(self.next())

def nextLong(self) -> int:
"""读取下一个长整数"""
return int(self.next())

def nextDouble(self) -> float:
"""读取下一个浮点数"""
return float(self.next())

def println(self, s):
"""输出一行"""
print(s, file=self.output)

def close(self):
"""关闭IO流"""
if self.input != sys.stdin:
self.input.close()
if self.output != sys.stdout:
self.output.close()

Python常用数据结构快速参考

基础容器操作

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
from collections import deque, defaultdict
import bisect

# 列表(动态数组)
arr = [1, 2, 3]
arr.append(4) # O(1) 尾部添加
arr.insert(0, 0) # O(n) 头部插入
arr.pop() # O(1) 尾部删除
arr.pop(0) # O(n) 头部删除
print(arr[1]) # O(1) 随机访问

# 双端队列(可当栈或队列)
dq = deque()
dq.append(1) # 队尾入队
dq.appendleft(2) # 队首入队
dq.pop() # 队尾出队
dq.popleft() # 队首出队

# 集合操作
s1 = {1, 2, 3}
s2 = {2, 3, 4}
print(s1 | s2) # 并集
print(s1 & s2) # 交集
print(s1 - s2) # 差集

# 字典操作
d = defaultdict(int) # 默认值为0
d["key"] += 1 # 自动初始化并自增

排序与查找

1
2
3
4
5
6
7
8
9
10
11
# 排序
arr = [3, 1, 4, 1, 5]
arr.sort() # 原地升序排序
arr.sort(reverse=True) # 原地降序排序
sorted_arr = sorted(arr) # 返回新的排序数组
custom_sorted = sorted(arr, key=lambda x: -x) # 自定义排序

# 二分查找
arr = [1, 2, 4, 7, 9] # 必须有序
idx = bisect.bisect_left(arr, 4) # 查找插入位置
idx = bisect.bisect_right(arr, 4) # 查找插入位置(右侧)

大整数与高精度

1
2
3
4
5
6
7
8
# Python原生支持任意精度整数
big_num = 10**100 # 10的100次方
result = big_num * big_num # 自动处理大整数运算

# 高精度除法
import decimal
decimal.getcontext().prec = 50 # 设置精度
a = decimal.Decimal('1') / decimal.Decimal('3')

实战技巧与注意事项

性能优化技巧

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
# 1. 避免在循环中重复计算
# 错误写法
for i in range(n):
for j in range(len(arr)): # 每次都计算len(arr)
pass

# 正确写法
arr_len = len(arr)
for i in range(n):
for j in range(arr_len):
pass

# 2. 使用局部变量访问全局数据
# 错误写法
def process():
for i in range(n):
result += global_data[i] # 每次都查找全局变量

# 正确写法
def process():
local_data = global_data # 本地化全局变量
for i in range(n):
result += local_data[i]

# 3. 字符串拼接优化
# 错误写法
s = ""
for i in range(n):
s += str(i) # 每次都创建新字符串

# 正确写法
parts = []
for i in range(n):
parts.append(str(i))
s = "".join(parts)

常见陷阱与解决方案

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
# 1. 递归深度限制
import sys
sys.setrecursionlimit(10000) # 设置递归深度限制

# 2. 浮点数精度问题
import math
def is_equal(a, b, eps=1e-9):
return abs(a - b) < eps

# 3. 列表初始化陷阱
# 错误:所有行共享同一个列表
matrix = [[0] * m] * n

# 正确:每行都是独立的列表
matrix = [[0] * m for _ in range(n)]

# 4. 字典默认值
from collections import defaultdict
# 使用defaultdict避免KeyError
count = defaultdict(int)
count[key] += 1 # 自动初始化为0

调试技巧

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
# 条件编译式调试
DEBUG = False

def debug_print(*args):
if DEBUG:
print("DEBUG:", *args)

# 输入输出重定向(本地测试)
import sys
if DEBUG:
sys.stdin = open('input.txt', 'r')
sys.stdout = open('output.txt', 'w')

# 计时器
import time
start_time = time.time()
# ... 算法代码 ...
print(f"执行时间: {time.time() - start_time:.3f}秒")

参照的是左程云的课程:https://space.bilibili.com/8888480/lists/3509640?type=series
本笔记包括了二叉树的基础概念、三种遍历方式的递归实现和非递归实现,涵盖了先序、中序、后序遍历的原理与代码实现,包括了class017 -> class018的内容

017【入门】二叉树及其三种序的递归实现

二叉树的基本概念

二叉树是一种重要的树形数据结构,每个节点最多有两个子节点,分别称为左子节点和右子节点。二叉树是许多高级数据结构和算法的基础。

二叉树节点定义

1
2
3
4
5
class TreeNode:
def __init__(self, v):
self.val = v # 节点的值
self.left = None # 左子节点
self.right = None # 右子节点

递归序的概念

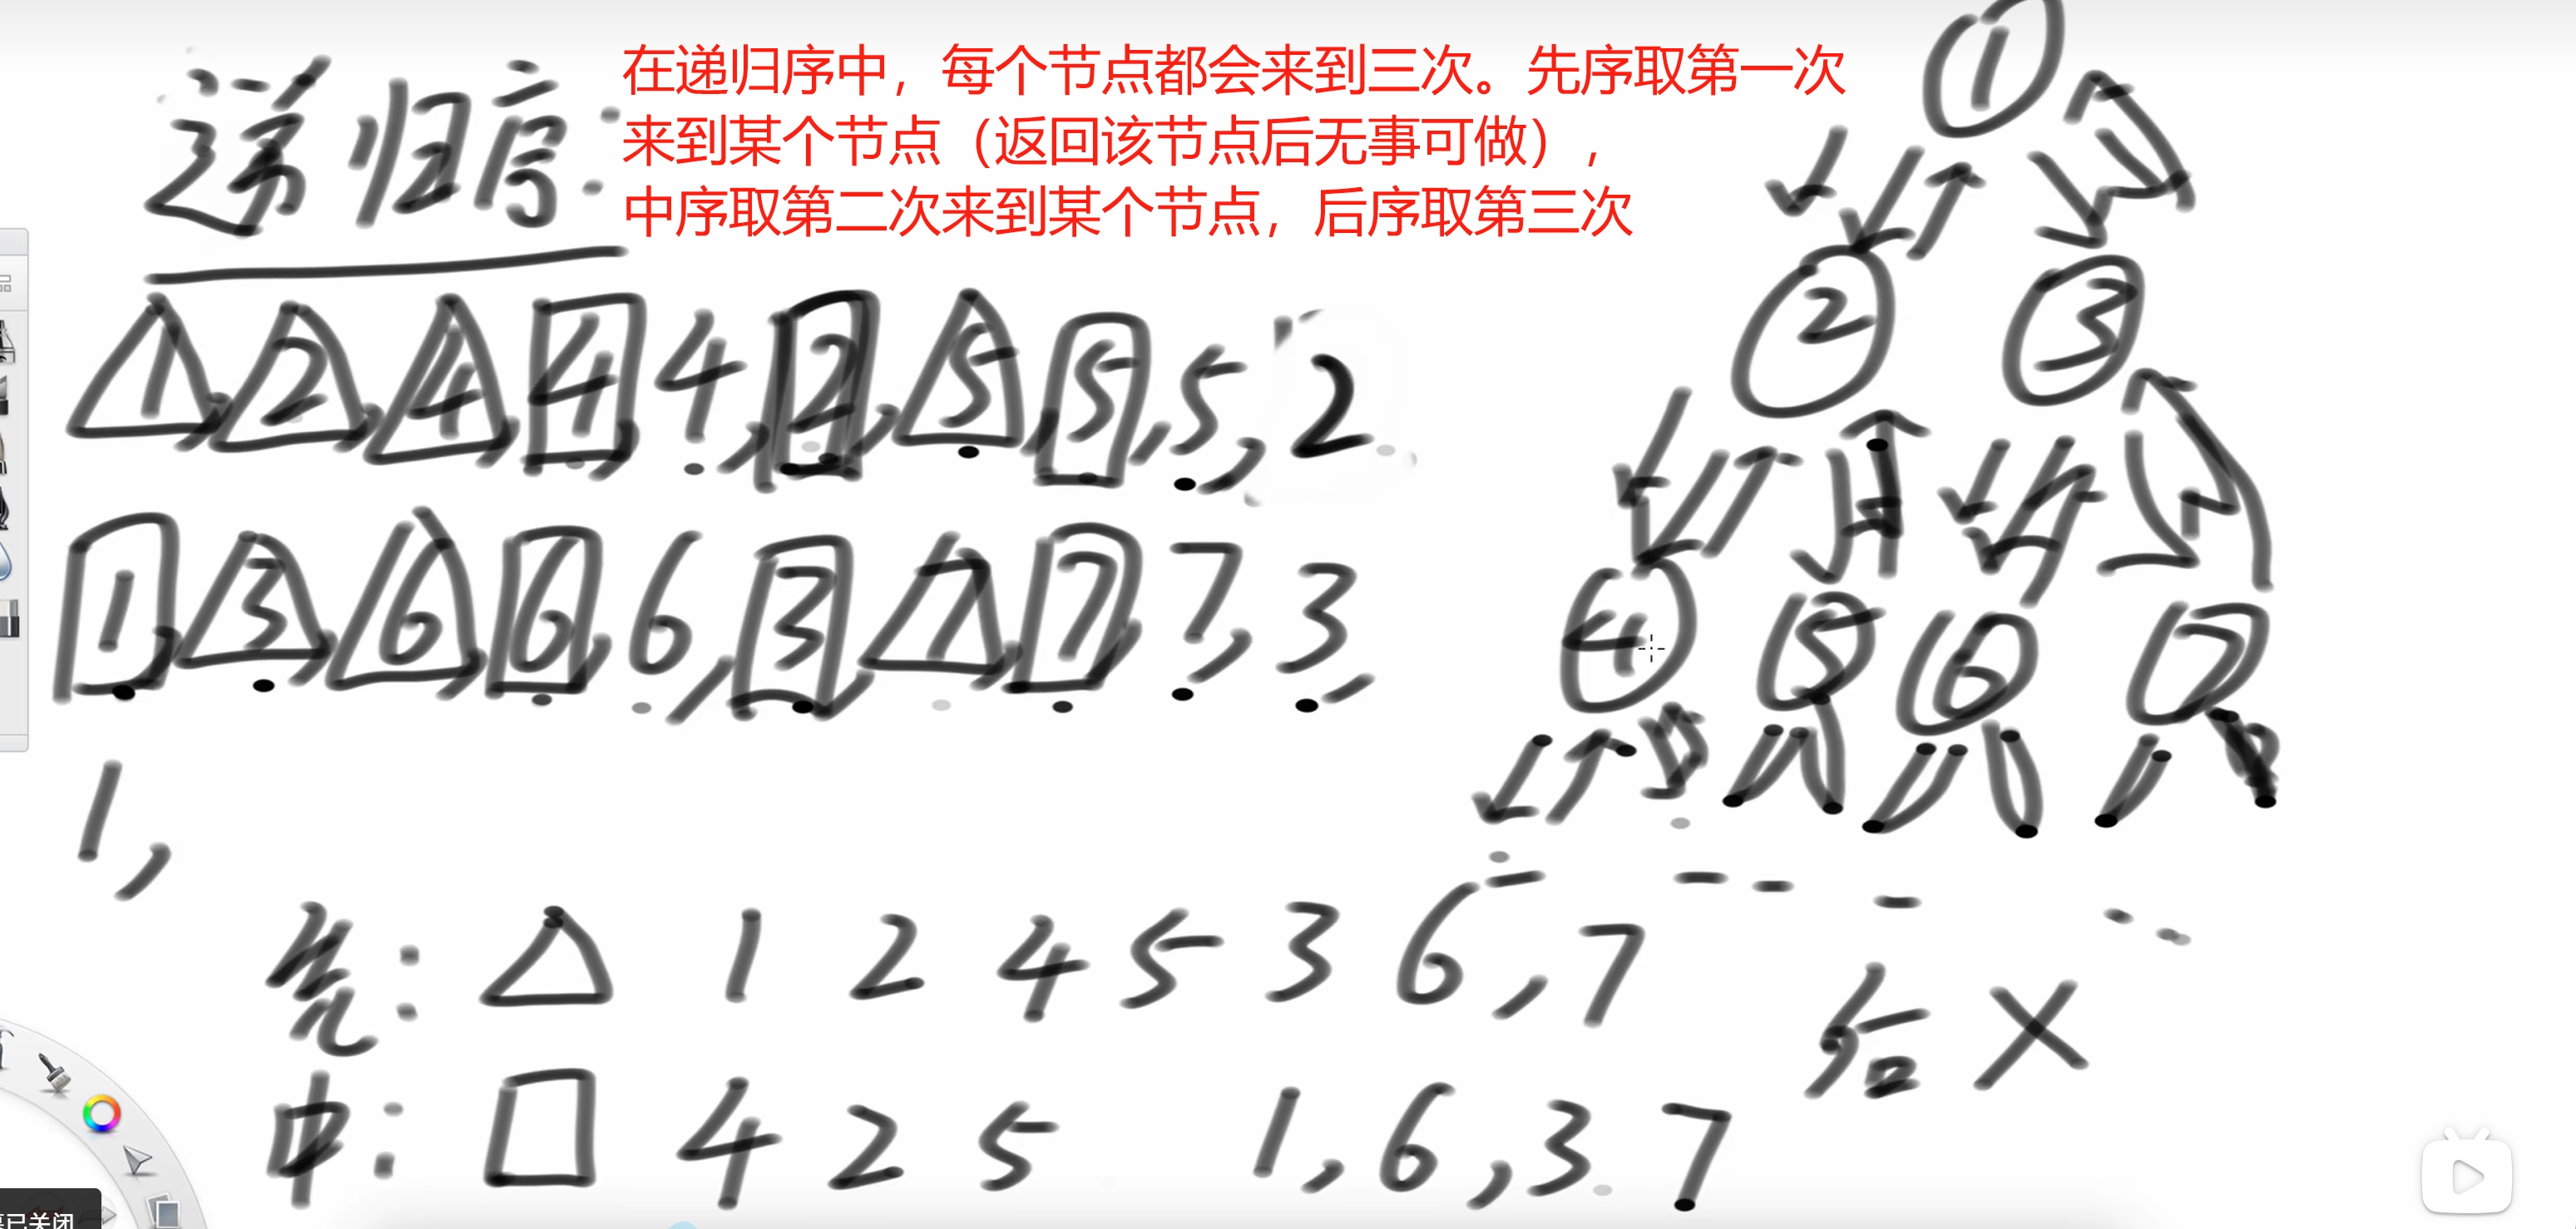
递归序是理解二叉树遍历的关键概念。对于任意二叉树节点,递归过程会经过该节点三次:

1
2
3
4
5
6
7
8
def f(head):
if head is None:
return
# 第1次到达该节点 - 刚进入该节点
f(head.left) # 递归处理左子树
# 第2次到达该节点 - 左子树处理完毕
f(head.right) # 递归处理右子树
# 第3次到达该节点 - 右子树处理完毕

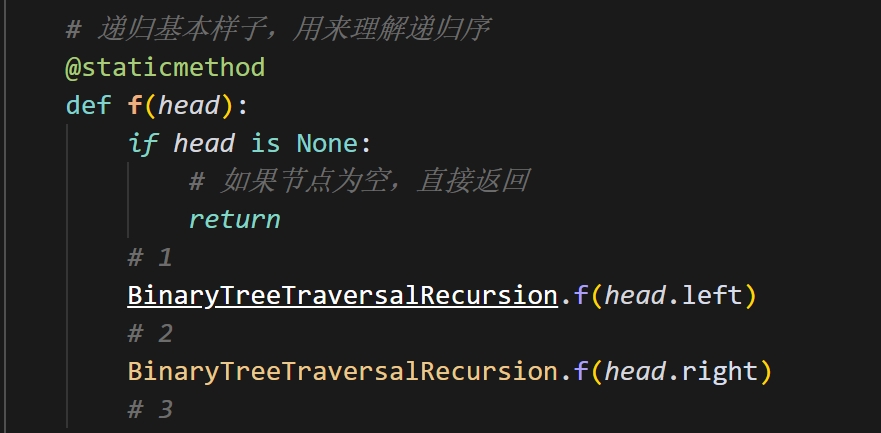
f函数
理解f函数

根据在这三个时机中选择处理节点的时机不同,就形成了三种不同的遍历方式。

二叉树的三种递归遍历

先序遍历(Pre-order Traversal)

先序遍历的顺序是:根节点 → 左子树 → 右子树

1
2
3
4
5
6
7
8
9
10
11
12
@staticmethod
def preOrder(head):
"""
先序遍历:在第1次到达节点时处理
应用场景:复制二叉树、表达式树求值、目录树打印
测试链接LeetCode 144. 二叉树的前序遍历https://leetcode.cn/problems/binary-tree-preorder-traversal/
"""
if head is None:
return
print(head.val, end=" ") # 先处理当前节点
BinaryTreeTraversalRecursion.preOrder(head.left) # 再遍历左子树
BinaryTreeTraversalRecursion.preOrder(head.right) # 最后遍历右子树

先序

中序遍历(In-order Traversal)

中序遍历的顺序是:左子树 → 根节点 → 右子树

1
2
3
4
5
6
7
8
9
10
11
12
@staticmethod
def inOrder(head):
"""
中序遍历:在第2次到达节点时处理
应用场景:二叉搜索树排序(得到有序序列)、表达式树转中缀表达式
测试链接LeetCode 94. 二叉树的中序遍历:https://leetcode.cn/problems/binary-tree-inorder-traversal/
"""
if head is None:
return
BinaryTreeTraversalRecursion.inOrder(head.left) # 先遍历左子树
print(head.val, end=" ") # 再处理当前节点
BinaryTreeTraversalRecursion.inOrder(head.right) # 最后遍历右子树

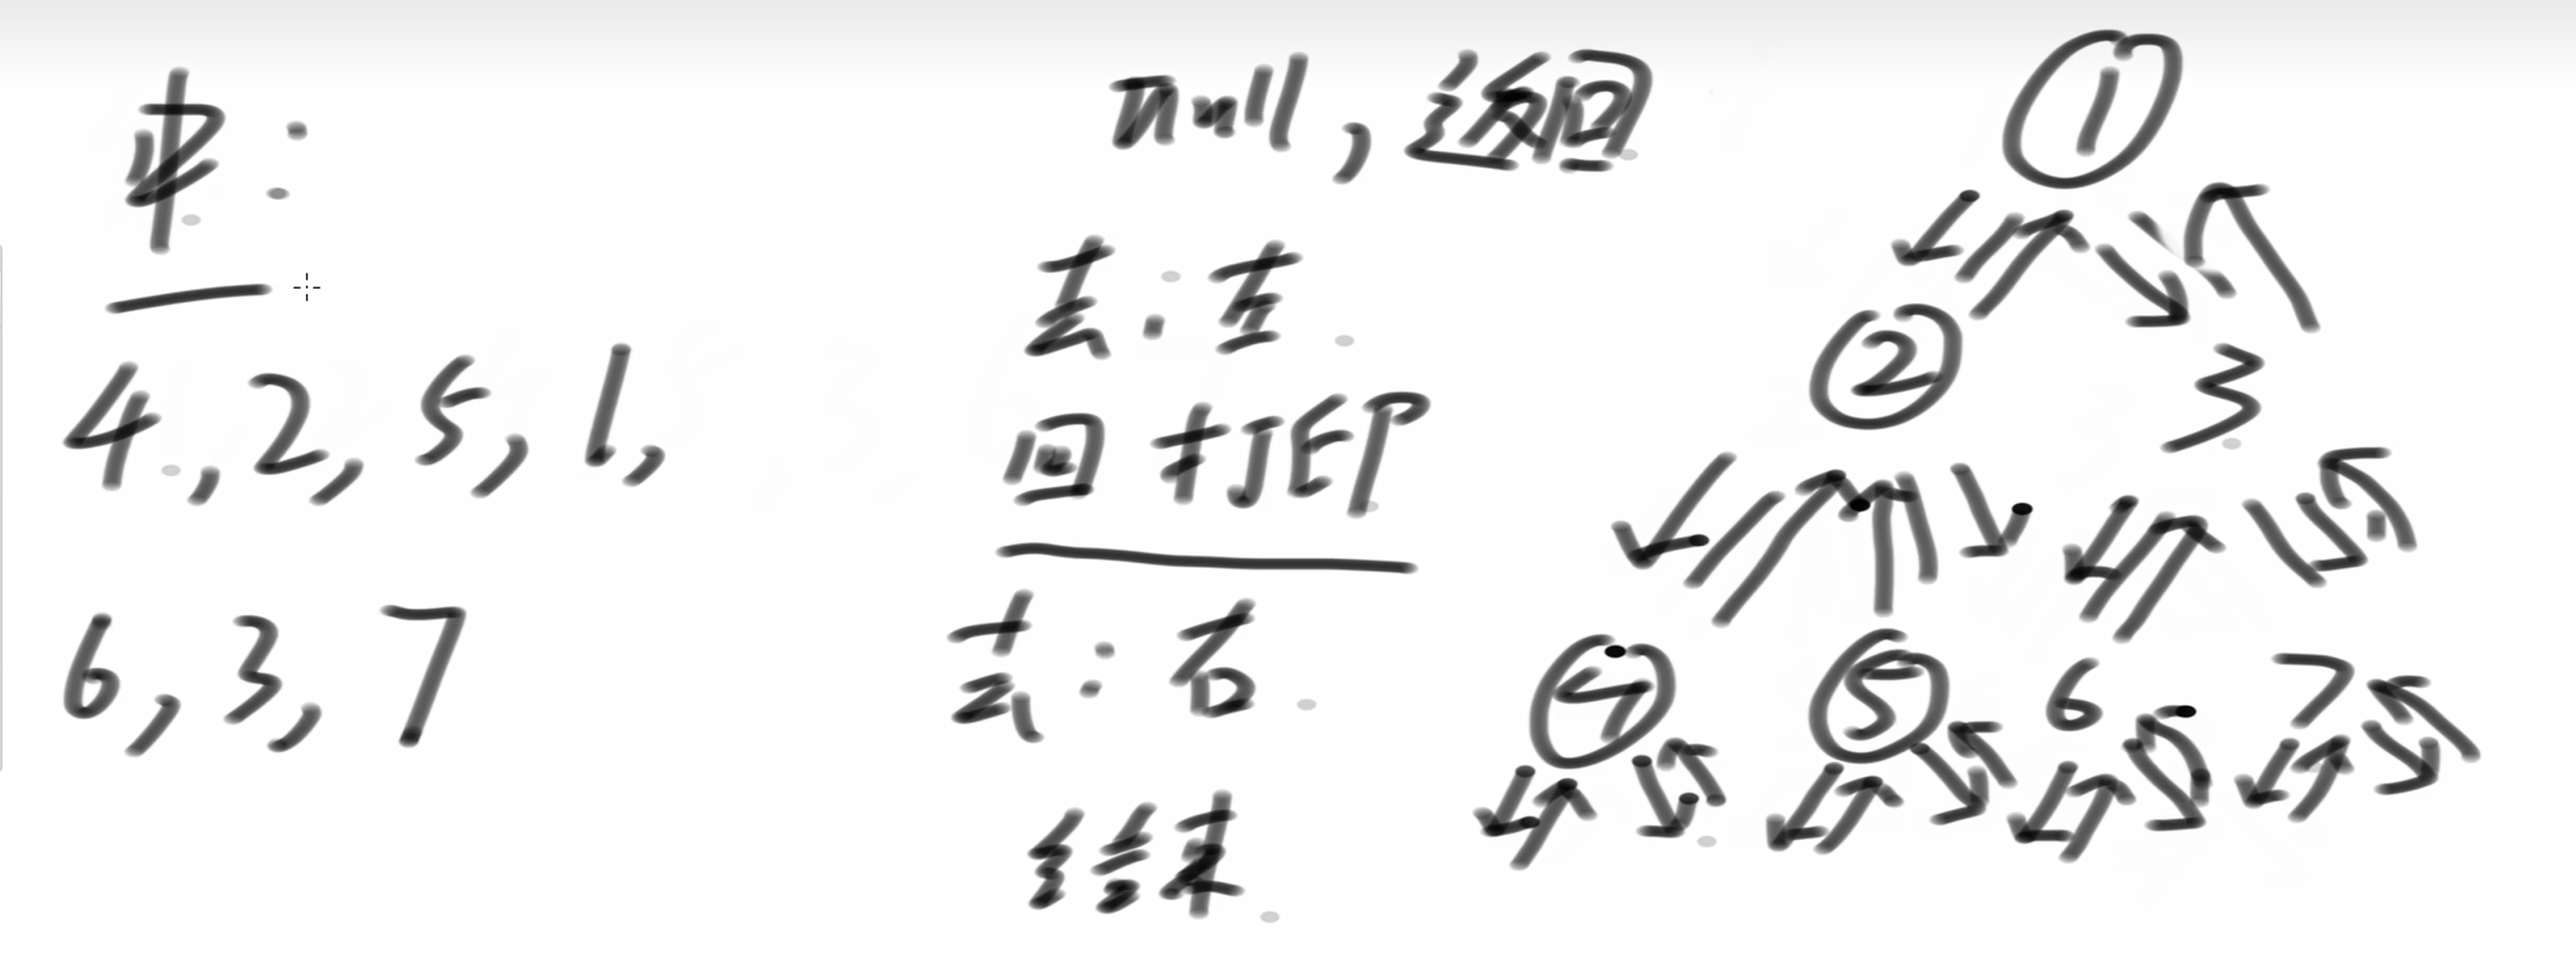
中序

后序遍历(Post-order Traversal)

后序遍历的顺序是:左子树 → 右子树 → 根节点

1
2
3
4
5
6
7
8
9
10
11
12
@staticmethod
def posOrder(head):
"""
后序遍历:在第3次到达节点时处理
应用场景:计算目录大小、删除二叉树、表达式树计算
测试链接LeetCode 145. 二叉树的后序遍历:https://leetcode.cn/problems/binary-tree-postorder-traversal/
"""
if head is None:
return
BinaryTreeTraversalRecursion.posOrder(head.left) # 先遍历左子树
BinaryTreeTraversalRecursion.posOrder(head.right) # 再遍历右子树
print(head.val, end=" ") # 最后处理当前节点

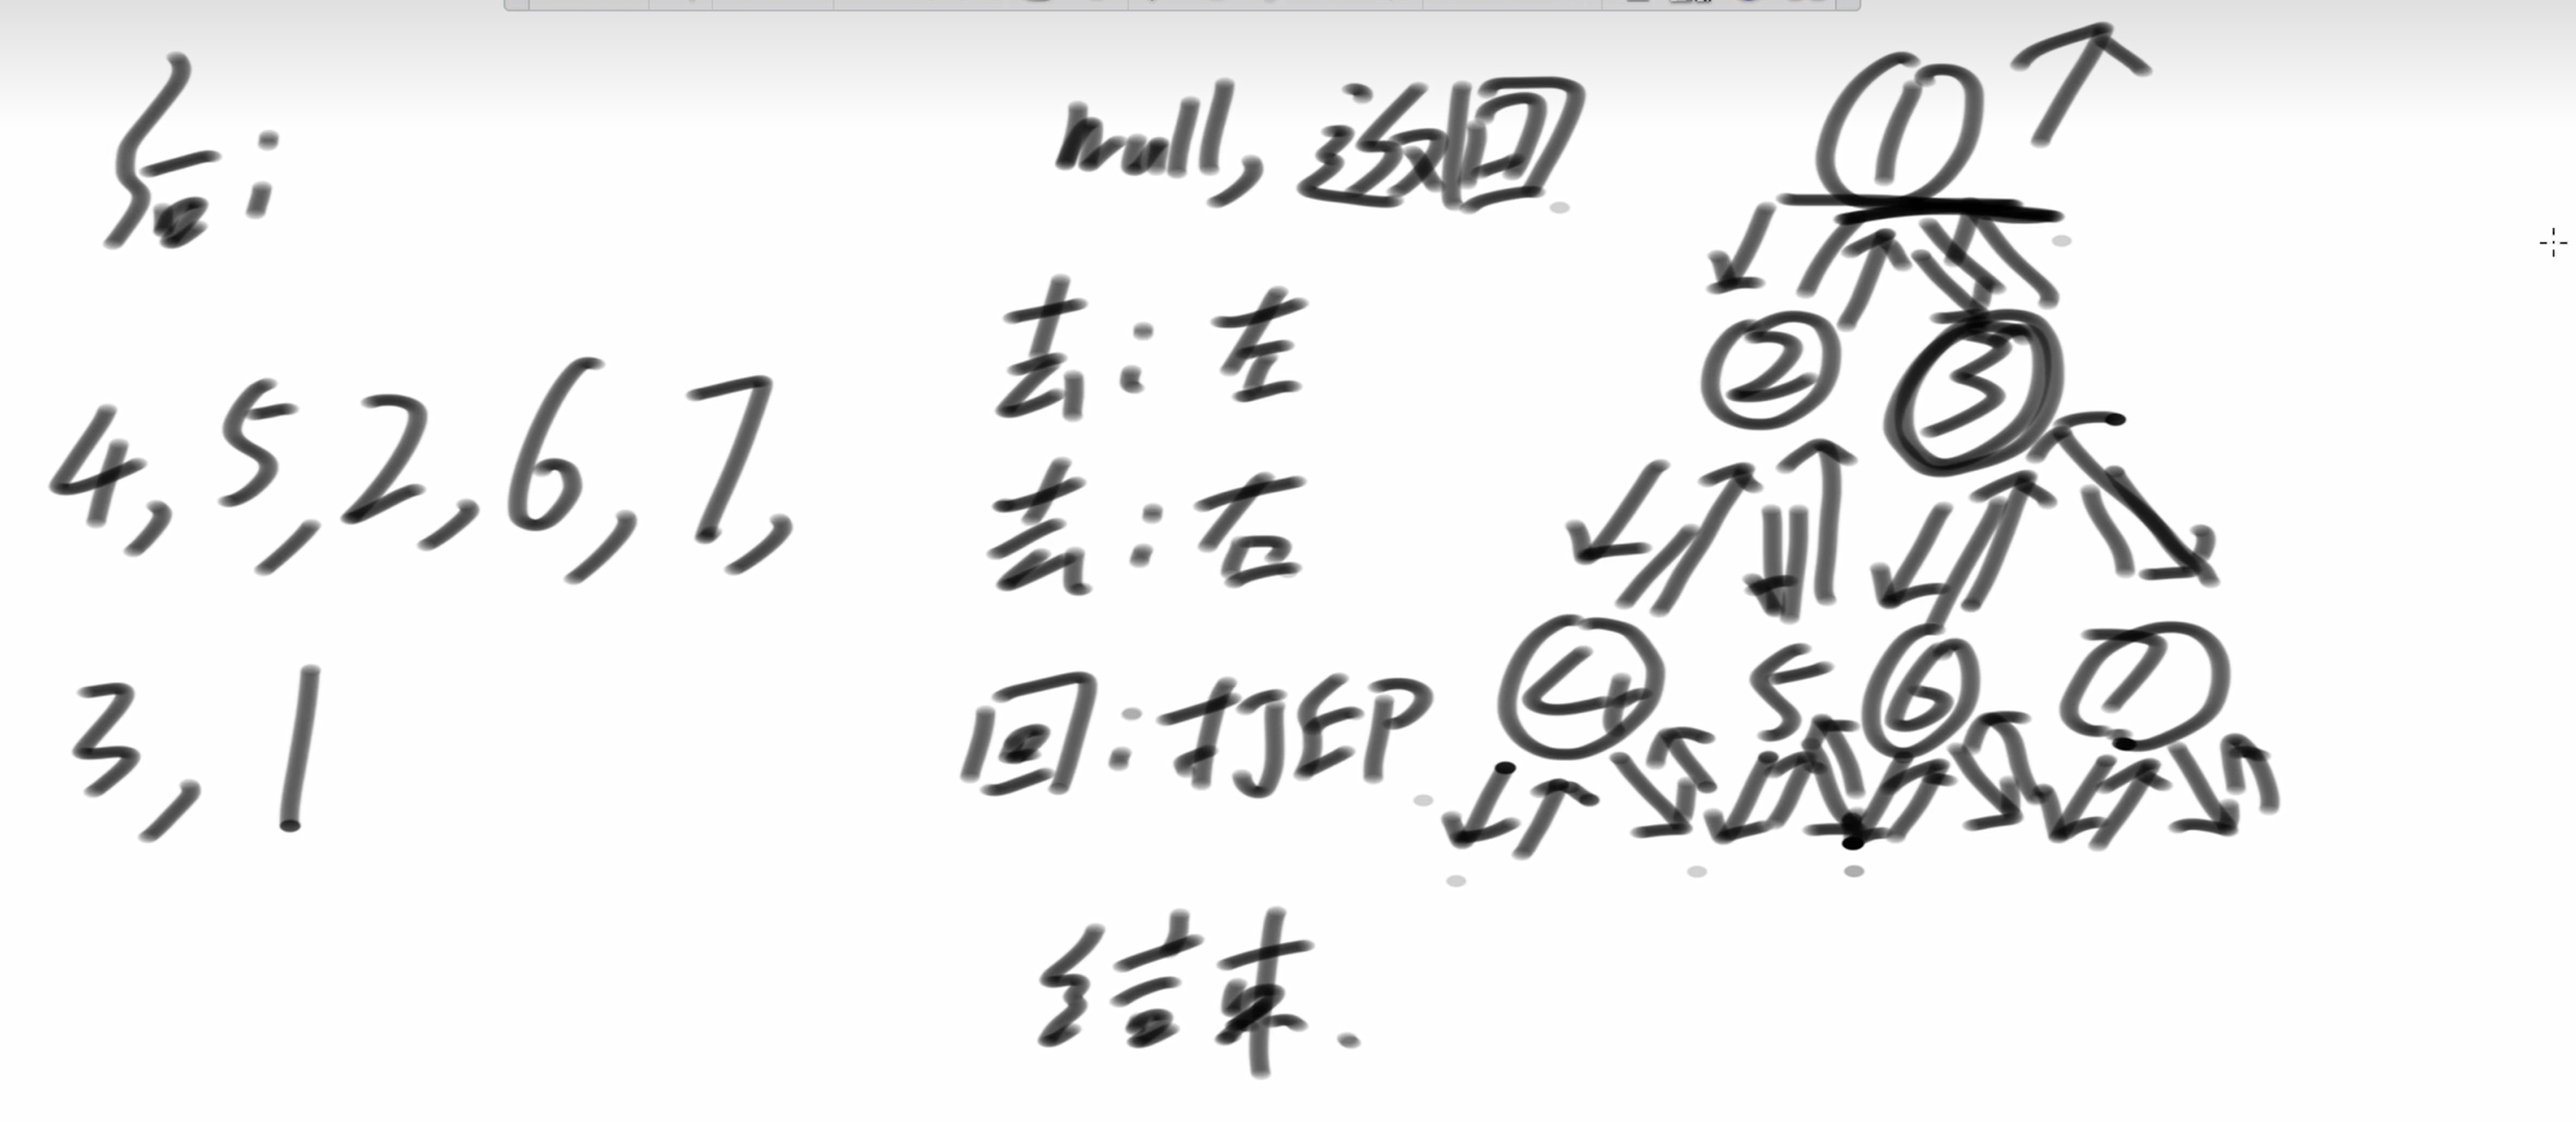
后序

递归遍历的示例执行

以下面的二叉树为例:

1
2
3
4
5
    1
/ \
2 3
/ \ / \
4 5 6 7

执行结果对比

  • 先序遍历结果:1 2 4 5 3 6 7
  • 中序遍历结果:4 2 5 1 6 3 7
  • 后序遍历结果:4 5 2 6 7 3 1

递归调用过程分析

以先序遍历为例,递归调用的过程:

  1. 访问节点1,打印1
  2. 递归进入左子树(节点2)
    • 访问节点2,打印2
    • 递归进入左子树(节点4)
      • 访问节点4,打印4
      • 左右子树为空,返回
    • 递归进入右子树(节点5)
      • 访问节点5,打印5
      • 左右子树为空,返回
  3. 递归进入右子树(节点3)
    • 类似过程…

复杂度分析

时间复杂度

所有递归遍历算法的时间复杂度都是 O(n),其中n是二叉树的节点数。每个节点都会被访问恰好一次。

空间复杂度

额外空间复杂度:O(h),其中h是树的高度。

  • 最好情况(完全平衡的二叉树):h = ⌊log₂n⌋,空间复杂度为O(log n)
  • 最坏情况(完全不平衡的树,退化为链表):h = n,空间复杂度为O(n)
  • 平均情况:对于随机二叉树,h = O(log n)

空间消耗主要来自递归调用栈,栈的最大深度等于树的高度。

三种遍历方式的应用场景

先序遍历的典型应用

  1. 复制二叉树:先创建根节点,再递归复制左右子树
  2. 表达式树求值:先处理操作符,再处理操作数
  3. 目录树打印:先打印目录名,再打印子目录内容
  4. 序列化二叉树:将树结构转换为字符串格式
1
2
3
4
5
6
7
8
9
# 复制二叉树示例
def copyTree(root):
if root is None:
return None
# 先创建新节点(先序特点)
newNode = TreeNode(root.val)
newNode.left = copyTree(root.left) # 递归复制左子树
newNode.right = copyTree(root.right) # 递归复制右子树
return newNode

中序遍历的典型应用

  1. 二叉搜索树排序:中序遍历BST得到有序序列
  2. 表达式树转中缀表达式:按照运算符优先级添加括号
  3. 验证二叉搜索树:检查中序遍历结果是否为递增序列
1
2
3
4
5
6
7
8
9
10
11
12
13
# 验证二叉搜索树示例
def isValidBST(root):
def inorder(node, values):
if node is None:
return
inorder(node.left, values)
values.append(node.val) # 中序收集值
inorder(node.right, values)

values = []
inorder(root, values)
# 检查是否严格递增
return all(values[i] < values[i+1] for i in range(len(values)-1))

后序遍历的典型应用

  1. 计算目录大小:先计算子目录大小,再计算当前目录
  2. 删除二叉树:先删除子节点,再删除父节点
  3. 表达式树计算:先计算子表达式,再计算根表达式
  4. 计算树的高度:先计算子树高度,再计算当前树高度
1
2
3
4
5
6
7
8
9
# 计算二叉树高度示例
def maxDepth(root):
if root is None:
return 0
# 先计算左右子树高度(后序特点)
leftHeight = maxDepth(root.left)
rightHeight = maxDepth(root.right)
# 再计算当前树高度
return max(leftHeight, rightHeight) + 1

遍历方式选择指南

需求场景 推荐遍历方式 理由
复制/构建树结构 先序遍历 需要先创建根节点
获取有序数据 中序遍历 BST的中序遍历有序
释放/计算资源 后序遍历 需要先处理子节点
树的序列化 先序遍历 便于重建树结构
表达式求值 后序遍历 需要先计算子表达式

递归实现的优缺点

优点

  1. 代码简洁:逻辑清晰,易于理解和实现
  2. 自然表达:完美匹配树的递归定义
  3. 易于扩展:容易添加额外的处理逻辑

缺点

  1. 栈溢出风险:深度递归可能导致栈溢出
  2. 性能开销:函数调用的开销相对较大
  3. 难以控制:无法方便地暂停或恢复遍历过程

在实际应用中,对于一般规模的二叉树,递归实现是首选方案。当树的深度可能很大时,需要考虑使用非递归实现来避免栈溢出问题。


018【入门】二叉树遍历的非递归实现和复杂度分析

非递归实现的必要性

递归实现虽然简洁易懂,但在处理大型树时可能导致栈溢出。非递归实现使用显式栈来模拟递归过程,提供了更好的控制性和避免栈溢出的优势。

核心思想

用显式的栈数据结构来模拟系统递归调用栈的行为,手动管理遍历过程中的状态信息。

先序遍历的非递归实现

实现原理

先序遍历要求”根-左-右”的访问顺序。使用栈时,由于栈是LIFO(后进先出)结构,需要先压入右子节点,再压入左子节点,这样弹栈时就是先处理左子树。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
@staticmethod
def preOrder(head):
"""
先序遍历非递归实现
核心思路:使用一个栈。每次先访问节点本身,再依次压入右、左子节点(注意顺序,先右后左),这样弹栈时总是优先处理左子树,实现“中-左-右”顺序
时间复杂度:O(n),每个节点进栈出栈各一次
空间复杂度:O(h),h为树的高度
测试链接LeetCode 144. 二叉树的前序遍历https://leetcode.cn/problems/binary-tree-preorder-traversal/
"""
if head is not None:
stack = []
stack.append(head)
while stack:
head = stack.pop() # 弹出栈顶节点
print(head.val, end=" ") # 立即打印(先序特点)
# 关键:先压右子节点,再压左子节点
# 这样弹栈时就是先处理左子树,再处理右子树
if head.right is not None:
stack.append(head.right)
if head.left is not None:
stack.append(head.left)
print()

先序2

执行过程示例

以树 1(2(4,5),3(6,7)) 为例:

步骤 栈状态 弹出节点 打印 压入节点
初始 [1] - - -
1 [3,2] 1 1 3,2
2 [3,5,4] 2 2 5,4
3 [3,5] 4 4 -
4 [3] 5 5 -
5 [7,6] 3 3 7,6
6 [7] 6 6 -
7 [] 7 7 -

输出结果:1 2 4 5 3 6 7

中序遍历的非递归实现

实现原理

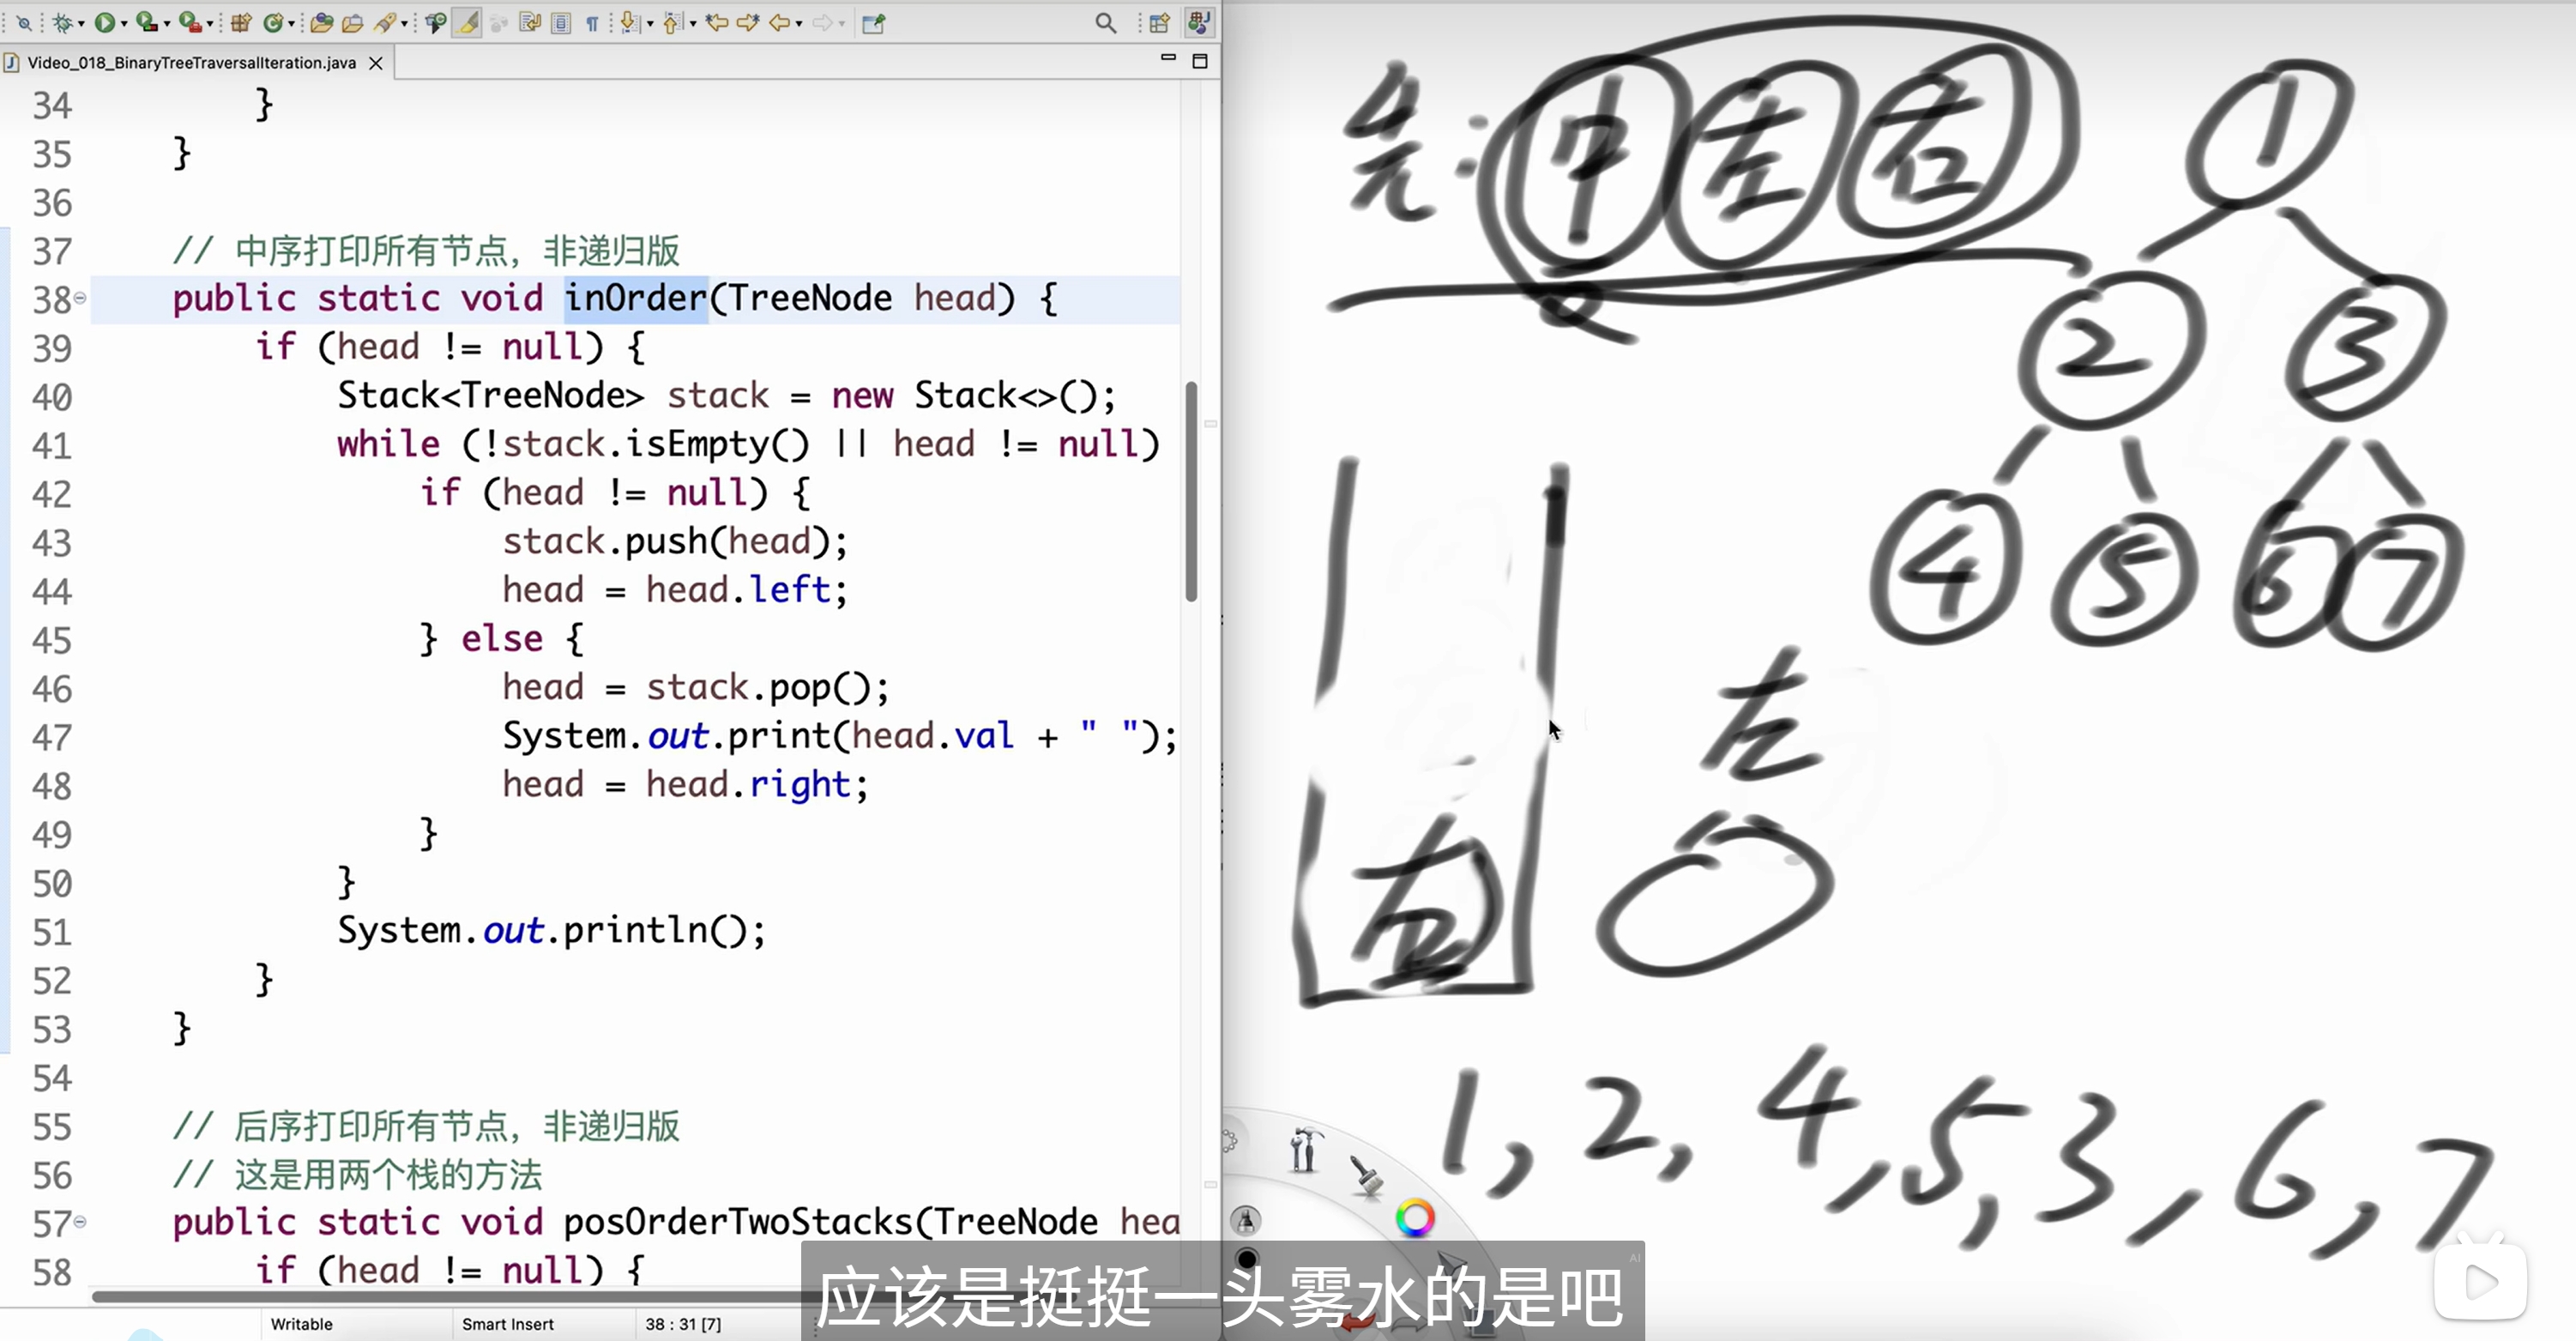
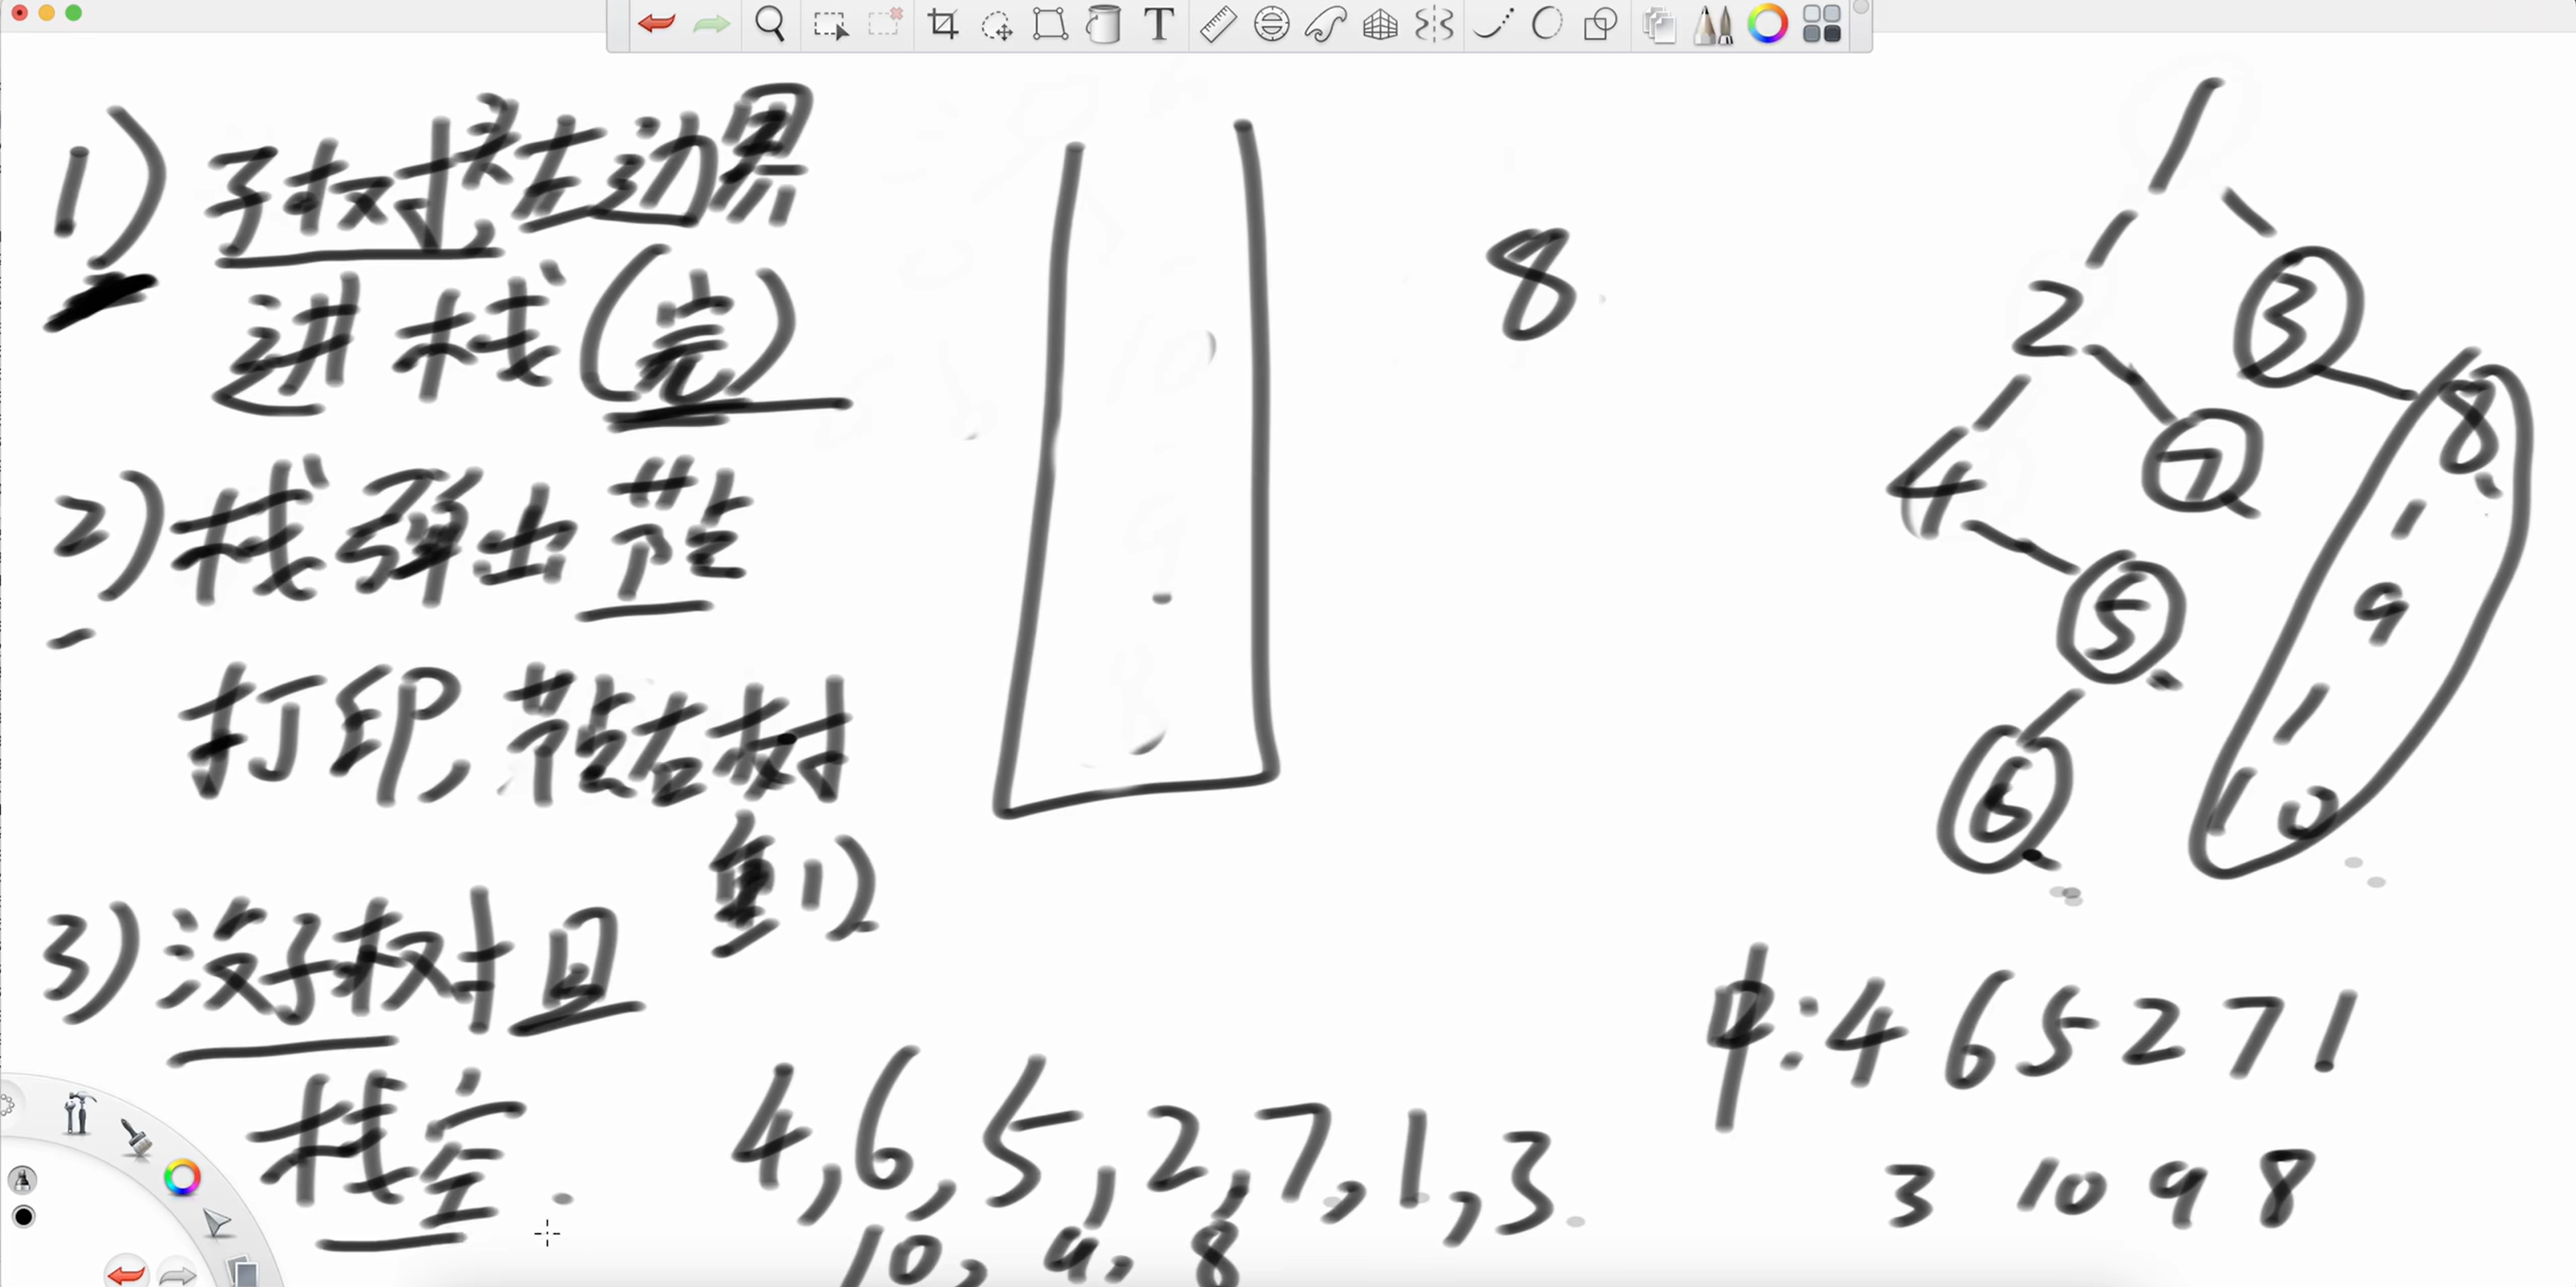
中序遍历要求”左-根-右”的访问顺序。需要先沿着左子树走到底,将路径上的所有节点压栈,然后开始弹栈处理节点,并转向右子树。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
@staticmethod
def inOrder(head):
"""
中序遍历非递归实现
核心思路:用一个栈模拟递归。每次不断沿左子树走到底,并将沿途所有节点入栈;遇到空节点就弹出栈顶节点,访问它,然后转向其右子树。如此反复,完整地实现“左-中-右”顺序。
测试链接LeetCode 94. 二叉树的中序遍历:https://leetcode.cn/problems/binary-tree-inorder-traversal/
"""
if head is not None:
stack = []
while stack or head is not None:
if head is not None:
# 当前节点不为空,压栈并继续向左
stack.append(head)
head = head.left
else:
# 当前节点为空,说明左子树遍历完毕
head = stack.pop() # 弹出栈顶节点
print(head.val, end=" ") # 打印节点值(中序特点)
head = head.right # 转向右子树
print()

算法状态分析

中序遍历的非递归实现有两种状态:

  1. 下降状态:head != None,沿左子树向下走并压栈
  2. 上升状态:head == None,弹栈处理节点并转向右子树

中序2

执行过程示例

以树 1(2(4,5),3(6,7)) 为例:

步骤 head 栈状态 操作 打印
初始 1 [] - -
1 2 [1] 压栈1,左移 -
2 4 [1,2] 压栈2,左移 -
3 None [1,2,4] 压栈4,左移 -
4 4 [1,2] 弹栈4 4
5 None [1,2] 4右移(None) -
6 2 [1] 弹栈2 2
7 5 [1] 2右移到5 -
8 None [1,5] 压栈5,左移 -
… … … … …

输出结果:4 2 5 1 6 3 7

后序遍历的非递归实现

后序遍历是最复杂的,因为需要确保在访问根节点之前,左右子树都已经被完全访问。提供两种实现方法:

方法一:使用两个栈

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
@staticmethod
def posOrderTwoStacks(head):
"""
后序遍历非递归实现 - 双栈法
核心思路:第一个栈实现"中-右-左"遍历,结果压入第二个栈
最后弹出第二个栈得到"左-右-中"的后序遍历结果
即:用一个栈模拟递归。每次不断沿左子树走到底,并将沿途所有节点入栈;遇到空节点就弹出栈顶节点,访问它,然后转向其右子树。如此反复,完整地实现“左-中-右”顺序。
测试链接LeetCode 145. 二叉树的后序遍历:https://leetcode.cn/problems/binary-tree-postorder-traversal/
"""
if head is not None:
stack = [] # 主栈:用于遍历
collect = [] # 收集栈:用于收集结果
stack.append(head)

while stack:
head = stack.pop()
collect.append(head) # 收集节点到第二个栈
# 注意:这里先压左子节点,再压右子节点
# 这样遍历顺序就是"中-右-左"
if head.left is not None:
stack.append(head.left)
if head.right is not None:
stack.append(head.right)

# 反向弹出收集栈,得到"左-右-中"顺序
while collect:
print(collect.pop().val, end=" ")
print()

双栈法原理解析

  1. 第一阶段:用第一个栈实现”中-右-左”遍历,类似先序遍历但左右子节点入栈顺序相反
  2. 第二阶段:将第一阶段的结果压入第二个栈
  3. 第三阶段:弹出第二个栈,得到”左-右-中”的后序遍历结果

关键洞察:”中-右-左”的逆序正好是”左-右-中”

方法二:使用一个栈

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
@staticmethod
def posOrderOneStack(h):
"""
后序遍历非递归实现 - 单栈法
核心思路:通过记录最近访问的节点,确保每个节点在其左右子树都被访问后才访问自己,从而严格实现“左-右-中”的后序遍历。
每个节点最多入栈两次,效率更高
测试链接LeetCode 145. 二叉树的后序遍历:https://leetcode.cn/problems/binary-tree-postorder-traversal/
"""
if h is not None:
stack = []
stack.append(h)
# h的含义:最近一次处理(打印)的节点

while stack:
cur = stack[-1] # 查看栈顶元素但不弹出

# 情况1:有左子树且左子树未被处理过
if cur.left is not None and h != cur.left and h != cur.right:
stack.append(cur.left)
# 情况2:有右子树且右子树未被处理过
elif cur.right is not None and h != cur.right:
stack.append(cur.right)
# 情况3:左右子树都没有或都已处理完毕
else:
print(cur.val, end=" ")
h = stack.pop() # 更新h为刚刚处理的节点
print()

单栈法状态管理

核心变量h的含义变化:

  • 初始时:h指向根节点(但实际表示”还没有处理过任何节点”)
  • 处理过程中:h始终指向最近一次处理(打印)的节点
  • 判断逻辑:通过比较当前节点的子节点与h的关系,判断子树是否已被处理

三种处理情况:

  1. 有左子树且未处理:cur.left != None and h != cur.left and h != cur.right
  2. 有右子树且未处理:cur.right != None and h != cur.right
  3. 可以处理当前节点:左右子树都不存在或都已处理完毕

复杂度分析对比

时间复杂度

所有非递归遍历算法的时间复杂度都是 O(n):

  • 先序和中序:每个节点进栈出栈各一次
  • 后序双栈法:每个节点进栈出栈总共两次(每个栈一次)
  • 后序单栈法:每个节点最多进栈两次,出栈一次

空间复杂度

额外空间复杂度对比:

实现方法 空间复杂度 说明
先序非递归 O(h) 一个栈,最大深度为树高
中序非递归 O(h) 一个栈,最大深度为树高
后序双栈法 O(n) 收集栈最坏情况存储所有节点
后序单栈法 O(h) 一个栈,最大深度为树高
递归实现 O(h) 系统调用栈,深度为树高

其中h为树的高度:

  • 最好情况:h = O(log n)(平衡树)
  • 最坏情况:h = O(n)(退化为链表)

实现方法选择建议

性能对比

方法 时间复杂度 空间复杂度 实现难度 推荐场景
先序非递归 O(n) O(h) 简单 通用推荐
中序非递归 O(n) O(h) 中等 BST相关问题
后序双栈法 O(n) O(n) 简单 理解后序遍历逻辑
后序单栈法 O(n) O(h) 困难 空间要求严格的场景

选择建议

  1. 实际应用:根据具体需求选择,一般情况下递归实现更简洁
  2. 性能要求高:选择非递归实现,避免函数调用开销
  3. 内存受限:后序遍历优选单栈法,其他遍历方式空间复杂度相当

非递归实现的优势

  1. 避免栈溢出:可以处理任意深度的树
  2. 更好控制:可以方便地暂停、恢复遍历过程
  3. 性能优化:减少函数调用开销
  4. 状态保存:便于在遍历过程中保存额外信息

非递归实现虽然代码复杂度较高,但在处理大规模数据或有特殊要求的场景中具有重要意义。

引言

本文档用于记录自己读过的学术论文和亲自翻译的论文内容。每篇论文包含简要说明和个人理解,部分论文附有飞书文档或doi链接


翻译论文记录

P´olya’s Random Walk Theorem

当时是为了随机过程的pre,然后翻译并推了一遍polya随机游走定理,记录一下。

原文标题:P´olya’s Random Walk Theorem
作者:Jonathan Novak
出处:The American Mathematical Monthly, 2014•Taylor & Francis
doi号:点此查看全文
飞书链接:点此查看翻译版

MDS/TSNE/UMAP

longlongago之前把生物信息里比较常用的三种降维算法都学和推了一遍,分别是MDS(multidimensional scaling)多维尺度分析、t-SNE(t-distributed Stochastic Neighbor Embedding)和UMAP(Uniform Manifold Approximation and Projection),记录一下翻译版。

飞书链接:点此查看整合的笔记

MDS

Multidimensional scaling,简称MDS,中文翻译成多维尺度分析。其原理是利用成对样本间的相似性,去构建合适的低维空间,使得样本在此空间的距离和在高维空间中的样本间的相似性尽可能的保持一致。我们可以用这种方式来可视化数据分布,PCA是MDS中特殊的一种。

感觉有点像层次分析法,比较早用于心理学&社会科学上的一些相似性分析。以下公式为简单的优化思想,理论上可以从欧式距离推广到各种距离如曼哈顿、马氏等等。

原始文献有点太古老了,所以看的是csdn上的专栏:https://blog.csdn.net/u010705209/article/details/53518772?utm_source=itdadao&utm_medium=referral

  • Kruskal, J. B. (1964). “Multidimensional Scaling by Optimizing Goodness of Fit to a Nonmetric Hypothesis.” Psychometrika, 29(1), 1-27.
  • Shepard, R. N. (1962). “The Analysis of Proximities: Multidimensional Scaling with an Unknown Distance Function.” Psychometrika, 27(2), 125-140.

TSNE

t-sne感觉是比较fashion的概率方法,很有意思。找了一篇论文https://www.jmlr.org/papers/volume9/vandermaaten08a/vandermaaten08a.pdf

原文标题:Visualizing Data using t-SNE
作者:Laurens van der Maaten, Geoffrey Hinton
出处:Journal of Machine Learning Research 9 (2008) 2579-2605
doi号:点此查看全文

UMAP

UMAP没有看太懂,主要是我没学过拓扑,但是其中模糊数学的部分很有意思,这篇论文刚刚发预印本的时候模糊数学还挺火的,现在不行了。

原文标题:Uniform manifold approximation and projection
作者:John Healy, Leland McInnes
出处:Nature Reviews Methods Primers volume 4, Article number: 82 (2024)
doi号:点此查看全文

注意力机制相关

包括注意力机制到transformer的自注意力及其后续的变体,还有ESM3几何注意力机制、rfdiffusion的IGSO3等等。

注意力机制的发展

longlongago之前学深度学习补的:

飞书链接:点此查看整合的笔记

几何注意力机制

ESM3有用到,ESM3模型处理蛋白质结构信息的两种主要方法:几何注意力(Geometric Attention)和结构标记(Structure Tokens)。

飞书链接:点此查看整合的笔记

IGSO3

当时看rfdiffusion被吓坏了,这个证明真的很吓人

飞书链接:点此查看整合的笔记

倾向性得分在观察性研究中因果效应分析的核心作用

文理学院统计系汇报的pre,看完了之后连统计学都不想学了,数学和统计完全是两个学科啊!感觉自己喜欢的是统计计算而不是数理统计和传统的统计inference,润了润了润去计算了

原文标题:The central role of the propensity score in observational studies for causal effect
作者:PAUL R. ROSENBAUM, DONALD B. RUBIN
出处:Biometrilca (1083), 70, 1, pp. 41-55
doi号:点此查看全文
飞书链接:点此查看翻译版

大概是24年暑假期间一周速通学完了吴恩达的机器学习,真真真是深入浅出,言简意赅, 记录一下吴恩达机器学习课程相关的PDF资料、讲义、笔记等,方便日后复习与查阅。

课程链接

吴恩达机器学习(B站全套)

课堂上的PDF笔记

网盘整体的文件

通过网盘分享的文件:A最新版 吴恩达机器学习Deeplearning.ai
链接: https://pan.baidu.com/s/1RGHnExutISizVeFNNR4OnQ?pwd=ue7m 提取码: ue7m

引言

参照的是左程云的课程:https://space.bilibili.com/8888480/lists/3509640?type=series
本笔记包括了栈和队列的基础实现、相互转换以及最小栈等核心内容,涵盖了链表实现、数组实现、循环队列等多种实现方式,包括了class013 -> class016的内容。


013【入门】队列和栈-链表、数组实现

队列的基本概念

队列(Queue)是一种先进先出(FIFO, First In First Out)的线性数据结构。元素从队尾(rear)插入,从队首(front)删除。

队列的基本操作

  • enqueue/offer: 入队,将元素添加到队尾
  • dequeue/poll: 出队,从队首移除元素
  • front/peek: 查看队首元素,但不移除
  • isEmpty: 判断队列是否为空
  • size: 获取队列中元素个数

队列的实现方式

方式一:基于双端队列(deque)实现

Python内置的collections.deque提供了高效的双端操作,但常数时间较慢。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
from collections import deque

class Queue1:
"""
基于Python内置deque实现的队列
内部使用双向链表,常数操作较慢但使用简单
"""
def __init__(self):
self.queue = deque() # 内部存储使用deque(双端队列)

def is_empty(self):
"""判断队列是否为空"""
return not self.queue

def offer(self, num):
"""向队列中加入元素,加到队尾"""
self.queue.append(num)

def poll(self):
"""从队列头部弹出元素"""
return self.queue.popleft()

def peek(self):
"""返回队列头的元素但不弹出"""
return self.queue[0]

def size(self):
"""返回队列中元素个数"""
return len(self.queue)

方式二:基于固定数组实现

在已知操作次数上限的情况下,使用固定数组实现具有更好的常数时间性能。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
class Queue2:
"""
基于固定数组实现的队列
适用于已知加入操作总次数上限的场景
常数时间性能更好,是实际刷题中最常用的方式
"""
def __init__(self, n):
"""
初始化队列
参数: n - 加入操作的总次数上限
"""
self.queue = [0] * n # 固定大小数组
self.l = 0 # 队首指针
self.r = 0 # 队尾指针

def is_empty(self):
"""判断队列是否为空"""
return self.l == self.r

def offer(self, num):
"""入队操作"""
self.queue[self.r] = num # 在队尾位置插入元素
self.r += 1 # 队尾指针后移

def poll(self):
"""出队操作"""
num = self.queue[self.l] # 取队首元素
self.l += 1 # 队首指针后移
return num

def head(self):
"""返回队首元素"""
return self.queue[self.l]

def tail(self):
"""返回队尾元素"""
return self.queue[self.r - 1]

def size(self):
"""队列当前元素个数,区间[l, r)"""
return self.r - self.l

栈的基本概念

栈(Stack)是一种后进先出(LIFO, Last In First Out)的线性数据结构。元素只能从栈顶插入和删除。

栈的基本操作

  • push: 压栈,将元素添加到栈顶
  • pop: 弹栈,从栈顶移除元素
  • peek/top: 查看栈顶元素,但不移除
  • isEmpty: 判断栈是否为空
  • size: 获取栈中元素个数

栈的实现方式

方式一:基于动态数组实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
class Stack1:
"""
基于Python内置列表实现的栈
使用动态数组,常数时间不是最优但使用简单
"""
def __init__(self):
self.stack = [] # 用列表模拟栈

def is_empty(self):
"""判断栈是否为空"""
return len(self.stack) == 0

def push(self, num):
"""压栈操作"""
self.stack.append(num)

def pop(self):
"""弹栈操作"""
return self.stack.pop()

def peek(self):
"""返回栈顶元素但不弹出"""
return self.stack[-1]

def size(self):
"""返回栈的大小"""
return len(self.stack)

方式二:基于固定数组实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
class Stack2:
"""
基于固定数组实现的栈
适用于已知同时在栈里元素个数上限的场景
常数时间性能更好,空间可以复用
"""
def __init__(self, n):
"""
初始化栈
参数: n - 同时在栈里的元素个数上限
"""
self.stack = [0] * n # 固定大小数组
self.size_ = 0 # 当前栈元素个数

def is_empty(self):
"""判断栈是否为空"""
return self.size_ == 0

def push(self, num):
"""压栈操作"""
self.stack[self.size_] = num # 在当前size位置插入
self.size_ += 1 # 元素个数+1

def pop(self):
"""弹栈操作"""
self.size_ -= 1 # 元素个数-1,先减后取值
return self.stack[self.size_] # 返回弹出的元素

def peek(self):
"""返回栈顶元素但不弹出"""
return self.stack[self.size_ - 1]

def size(self):
"""返回栈大小"""
return self.size_

循环队列

循环队列是队列的一种特殊实现,通过循环使用固定大小的数组来避免空间浪费。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
class MyCircularQueue:
"""
循环队列实现
测试链接: https://leetcode.cn/problems/design-circular-queue/
"""
def __init__(self, k):
"""
初始化循环队列
参数: k - 队列容量上限
"""
self.queue = [0] * k # 固定大小数组
self.l = 0 # 队首指针
self.r = 0 # 队尾指针
self.size = 0 # 当前元素个数
self.limit = k # 容量上限

def enQueue(self, value):
"""
入队操作
返回: 成功返回True,队列满返回False
"""
if self.isFull():
return False # 队列已满
else:
self.queue[self.r] = value # 队尾插入元素
# 队尾指针循环移动
self.r = 0 if self.r == self.limit - 1 else self.r + 1
self.size += 1 # 元素个数+1
return True

def deQueue(self):
"""
出队操作
返回: 成功返回True,队列空返回False
"""
if self.isEmpty():
return False # 队列为空
else:
# 队首指针循环移动
self.l = 0 if self.l == self.limit - 1 else self.l + 1
self.size -= 1 # 元素个数-1
return True

def Front(self):
"""返回队首元素,队列为空返回-1"""
if self.isEmpty():
return -1
else:
return self.queue[self.l]

def Rear(self):
"""返回队尾元素,队列为空返回-1"""
if self.isEmpty():
return -1
else:
# 计算队尾指针的实际位置
last = self.limit - 1 if self.r == 0 else self.r - 1
return self.queue[last]

def isEmpty(self):
"""判断队列是否为空"""
return self.size == 0

def isFull(self):
"""判断队列是否已满"""
return self.size == self.limit

014【入门】队列和栈入门题目-栈和队列相互实现

用栈实现队列

队列是先进先出(FIFO),而栈是后进先出(LIFO)。要用栈实现队列,需要使用两个栈来模拟队列的行为。

算法思想

使用两个栈:

  • 输入栈(in_stack):负责接收新元素的push操作
  • 输出栈(out_stack):负责输出元素的pop和peek操作

关键规则

  1. 倒数据条件:只有当输出栈为空时,才能从输入栈倒数据
  2. 倒数据原则:如果要倒数据,必须将输入栈的数据全部倒完
  3. 时间复杂度:虽然单次操作可能是O(n),但均摊时间复杂度是O(1)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
class MyQueue:
"""
用栈实现队列
测试链接: https://leetcode.cn/problems/implement-queue-using-stacks/
时间复杂度: 均摊O(1)
"""
def __init__(self):
self.in_stack = [] # 输入栈,负责push
self.out_stack = [] # 输出栈,负责pop/peek

def inToOut(self):
"""
倒数据操作:从输入栈将数据倒入输出栈
核心规则:
1) 输出栈空了,才能倒数据
2) 如果倒数据,输入栈必须倒完
"""
if not self.out_stack: # 只有输出栈为空才能倒
while self.in_stack: # 输入栈必须倒完
self.out_stack.append(self.in_stack.pop())

def push(self, x: int):
"""入队操作:新元素加入输入栈"""
self.in_stack.append(x) # 新元素压入输入栈
self.inToOut() # 检查是否需要倒数据

def pop(self) -> int:
"""出队操作:从输出栈弹出元素"""
self.inToOut() # 确保输出栈有数据
return self.out_stack.pop() # 弹出队首元素

def peek(self) -> int:
"""查看队首元素:不移除,只查看"""
self.inToOut() # 确保输出栈有数据
return self.out_stack[-1] # 返回栈顶即队首

def empty(self) -> bool:
"""判断队列是否为空"""
return not self.in_stack and not self.out_stack # 两个栈都空才是空队列

时间复杂度分析

虽然inToOut()操作在最坏情况下需要O(n)时间,但通过均摊分析:

  • 每个元素最多被移动两次(输入栈→输出栈→出队列)
  • n次操作的总时间复杂度为O(n)
  • 均摊时间复杂度为O(1)

用队列实现栈

栈是后进先出(LIFO),队列是先进先出(FIFO)。要用队列实现栈,需要在每次push操作后重新排列队列中的元素。

算法思想

使用一个双端队列(deque),在每次push新元素后,将队列中原有的元素依次移动到新元素后面,确保新元素总是在队首位置。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
from collections import deque

class MyStack:
"""
用双端队列实现栈
测试链接: https://leetcode.cn/problems/implement-stack-using-queues/
"""
def __init__(self):
self.queue = deque() # 用deque实现队列

def push(self, x: int):
"""
压栈操作
时间复杂度: O(n)
核心思想: 新元素入队后,将前面所有元素重新排列到新元素后面
"""
n = len(self.queue) # 记录当前队列长度
self.queue.append(x) # 新元素加入队尾

# 将前面的n个元素依次移动到队尾
for _ in range(n):
self.queue.append(self.queue.popleft())

def pop(self) -> int:
"""弹栈操作:弹出队首元素,即栈顶元素"""
return self.queue.popleft()

def top(self) -> int:
"""查看栈顶元素:返回队首元素"""
return self.queue[0]

def empty(self) -> bool:
"""判断栈是否为空"""
return not self.queue

操作示例

假设依次push元素1, 2, 3:

1
2
3
4
5
6
7
初始状态: []

push(1): [1]

push(2): [2] -> [2,1] (将1移动到2后面)

push(3): [3,2,1] -> [3,2,1] (将2,1依次移动到3后面)

最终队列状态为[3,2,1],队首元素3就是栈顶元素,符合LIFO特性。


015【入门】栈的入门题目-最小栈

最小栈问题

最小栈要求实现一个栈,除了基本的栈操作外,还要能够在O(1)时间内获取栈中的最小元素。

问题分析

核心挑战是如何在保持基本栈操作O(1)时间复杂度的同时,追踪当前栈中的最小值。当栈顶元素(恰好是最小值)被弹出时,需要快速知道剩余元素中的最小值。

解决方案:辅助栈法

使用两个栈:

  • 数据栈(data):存储实际数据
  • 最小值栈(min):存储对应位置的最小值

实现方法一:基于列表

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
class MinStack1:
"""
最小栈实现方法一:使用Python列表
测试链接: https://leetcode.cn/problems/min-stack/
时间复杂度: 所有操作均为O(1)
"""
def __init__(self):
self.data = [] # 数据栈,存储实际元素
self.min = [] # 最小值栈,存储对应位置的最小值

def push(self, val):
"""
压栈操作
核心思想: 每次压栈时,同时在最小值栈中记录当前的最小值
"""
self.data.append(val) # 将val压入数据栈

if not self.min or val <= self.min[-1]: # 如果最小栈为空或val是新的最小值
self.min.append(val) # 将val压入最小栈
else: # 否则val不是最小值
self.min.append(self.min[-1]) # 将当前最小值再次压入最小栈

def pop(self):
"""弹栈操作:同时弹出两个栈的栈顶元素"""
self.data.pop() # 弹出数据栈栈顶
self.min.pop() # 弹出最小栈栈顶

def top(self):
"""获取栈顶元素"""
return self.data[-1] # 返回数据栈栈顶元素

def getMin(self):
"""获取栈中最小元素"""
return self.min[-1] # 返回最小栈栈顶元素

工作原理示例

假设依次压入元素:5, 2, 7, 1, 3

操作 数据栈 最小栈 说明
push(5) [5] [5] 5是第一个元素,也是最小值
push(2) [5,2] [5,2] 2比5小,成为新的最小值
push(7) [5,2,7] [5,2,2] 7比2大,最小值仍是2
push(1) [5,2,7,1] [5,2,2,1] 1比2小,成为新的最小值
push(3) [5,2,7,1,3] [5,2,2,1,1] 3比1大,最小值仍是1

实现方法二:基于固定数组

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
class MinStack2:
"""
最小栈实现方法二:使用固定大小数组
适用于已知最大容量的场景,常数时间性能更好
"""
def __init__(self):
# 根据leetcode测试数据实验得出的容量上限
# 如果测试数据增加导致溢出,需要调大此值
self.MAXN = 8001

self.data = [0] * self.MAXN # 数据数组
self.min = [0] * self.MAXN # 最小值数组
self.size = 0 # 当前栈大小

def push(self, val):
"""压栈操作"""
self.data[self.size] = val # 在size位置存储val

if self.size == 0 or val <= self.min[self.size - 1]: # 第一个元素或新的最小值
self.min[self.size] = val # 存储val作为最小值
else: # val不是最小值
self.min[self.size] = self.min[self.size - 1] # 复制前一个最小值

self.size += 1 # 栈大小加1

def pop(self):
"""弹栈操作:只需将size减1,不需要实际删除数据"""
self.size -= 1

def top(self):
"""获取栈顶元素"""
return self.data[self.size - 1]

def getMin(self):
"""获取栈中最小元素"""
return self.min[self.size - 1]

复杂度分析

时间复杂度

  • push操作:O(1) - 只需要常数次比较和赋值
  • pop操作:O(1) - 只需要移动指针或减少计数
  • top操作:O(1) - 直接访问数组元素
  • getMin操作:O(1) - 直接访问最小值栈顶

空间复杂度

  • 总空间复杂度:O(n) - 需要两个栈存储数据
  • 额外空间:O(n) - 最小值栈的空间开销

优化思考

虽然辅助栈法简单易懂,但存在空间冗余。可以考虑以下优化:

  1. 稀疏存储:最小值栈只在最小值更新时才压入新值
  2. 差值存储:存储与最小值的差值而非绝对值
  3. 链表实现:在节点中直接存储当前最小值

数据结构选择指南

性能对比

实现方式 时间复杂度 空间复杂度 常数因子 适用场景
Python内置容器 O(1)均摊 O(n) 较大 快速原型,不追求极致性能
固定数组 O(1) O(n) 较小 已知容量上限,追求性能
双栈/双队列 O(1)均摊 O(n) 中等 功能转换,教学示例

016【入门】双端队列-双链表和固定数组实现

双端队列的基本概念

双端队列(Deque,Double-ended Queue)是一种特殊的线性数据结构,允许在队列的两端进行插入和删除操作。与普通队列只能在一端插入、另一端删除不同,双端队列提供了更大的灵活性。

双端队列的基本操作

  • insertFront: 在队首插入元素
  • insertLast: 在队尾插入元素
  • deleteFront: 删除队首元素
  • deleteLast: 删除队尾元素
  • getFront: 获取队首元素
  • getRear: 获取队尾元素
  • isEmpty: 判断队列是否为空
  • isFull: 判断队列是否已满

循环双端队列的实现

循环双端队列是双端队列的一种特殊实现,使用固定大小的数组并通过循环索引来管理队列的边界。

实现方式一:基于Python列表

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
class MyCircularDeque1:
"""
基于Python列表实现的循环双端队列
内部使用动态数组,操作简单但常数时间较慢
测试链接: https://leetcode.cn/problems/design-circular-deque/
"""
def __init__(self, k):
"""
初始化循环双端队列
参数: k - 队列容量上限
"""
self.deque = [] # 用列表模拟双端队列
self.size = 0 # 当前队列大小
self.limit = k # 队列容量

def insertFront(self, value):
"""
在队首插入元素
时间复杂度: O(n) - 需要移动所有现有元素
"""
if self.isFull():
return False
else:
self.deque.insert(0, value) # 在索引0位置插入,其他元素后移
self.size += 1
return True

def insertLast(self, value):
"""
在队尾插入元素
时间复杂度: O(1)均摊
"""
if self.isFull():
return False
else:
self.deque.append(value) # 直接添加到列表末尾
self.size += 1
return True

def deleteFront(self):
"""
删除队首元素
时间复杂度: O(n) - 需要移动所有剩余元素
"""
if self.isEmpty():
return False
else:
self.size -= 1
self.deque.pop(0) # 删除索引0的元素,其他元素前移
return True

def deleteLast(self):
"""
删除队尾元素
时间复杂度: O(1)
"""
if self.isEmpty():
return False
else:
self.size -= 1
self.deque.pop() # 删除列表末尾元素
return True

def getFront(self):
"""获取队首元素,队列为空返回-1"""
if self.isEmpty():
return -1
else:
return self.deque[0]

def getRear(self):
"""获取队尾元素,队列为空返回-1"""
if self.isEmpty():
return -1
else:
return self.deque[-1]

def isEmpty(self):
"""判断队列是否为空"""
return self.size == 0

def isFull(self):
"""判断队列是否已满"""
return self.size == self.limit

实现方式二:基于固定数组

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
class MyCircularDeque2:
"""
基于固定数组实现的循环双端队列
使用循环索引管理队列边界,常数时间性能更好
适用于已知容量上限的场景
"""
def __init__(self, k):
"""
初始化循环双端队列
参数: k - 队列容量上限
"""
self.deque = [0] * k # 固定长度数组
self.l = 0 # 队首指针
self.r = 0 # 队尾指针
self.size = 0 # 当前队列大小
self.limit = k # 队列容量

def insertFront(self, value):
"""
在队首插入元素
时间复杂度: O(1)
"""
if self.isFull():
return False
else:
if self.isEmpty():
# 空队列情况,队首和队尾指针都指向同一位置
self.l = self.r = 0
self.deque[0] = value
else:
# 队首指针向前移动(循环)
self.l = self.l - 1 if self.l != 0 else self.limit - 1
self.deque[self.l] = value
self.size += 1
return True

def insertLast(self, value):
"""
在队尾插入元素
时间复杂度: O(1)
"""
if self.isFull():
return False
else:
if self.isEmpty():
# 空队列情况
self.l = self.r = 0
self.deque[0] = value
else:
# 队尾指针向后移动(循环)
self.r = 0 if self.r == self.limit - 1 else self.r + 1
self.deque[self.r] = value
self.size += 1
return True

def deleteFront(self):
"""
删除队首元素
时间复杂度: O(1)
"""
if self.isEmpty():
return False
else:
if self.size == 1:
# 删除后队列变空,可选择重置指针
pass # 这里不重置l和r,因为逻辑上没有影响
# 队首指针向后移动(循环)
self.l = 0 if self.l == self.limit - 1 else self.l + 1
self.size -= 1
return True

def deleteLast(self):
"""
删除队尾元素
时间复杂度: O(1)
"""
if self.isEmpty():
return False
else:
if self.size == 1:
# 删除后队列变空
pass # 不重置指针
# 队尾指针向前移动(循环)
self.r = self.limit - 1 if self.r == 0 else self.r - 1
self.size -= 1
return True

def getFront(self):
"""获取队首元素"""
if self.isEmpty():
return -1
else:
return self.deque[self.l]

def getRear(self):
"""获取队尾元素"""
if self.isEmpty():
return -1
else:
return self.deque[self.r]

def isEmpty(self):
"""判断队列是否为空"""
return self.size == 0

def isFull(self):
"""判断队列是否已满"""
return self.size == self.limit

循环索引的关键理解

指针移动规律

在固定数组实现中,关键是理解循环索引的移动:

1
2
3
4
5
# 向后移动(队尾插入,队首删除)
next_index = 0 if current_index == limit - 1 else current_index + 1

# 向前移动(队首插入,队尾删除)
prev_index = limit - 1 if current_index == 0 else current_index - 1

边界情况处理

  1. 空队列插入:第一个元素插入时,队首和队尾指针都指向同一位置
  2. 单元素删除:删除唯一元素后队列变空,但指针位置不需要重置
  3. 满队列检测:通过size变量而非指针位置来判断队列是否已满

性能分析

时间复杂度对比

操作 列表实现 数组实现 说明
insertFront O(n) O(1) 列表需要移动所有元素
insertLast O(1)均摊 O(1) 列表可能需要扩容
deleteFront O(n) O(1) 列表需要移动所有元素
deleteLast O(1) O(1) 两种实现都是常数时间
getFront/getRear O(1) O(1) 直接索引访问

空间复杂度

  • 列表实现:O(k),但可能因为动态扩容导致额外开销
  • 数组实现:O(k),固定空间,无额外开销

应用场景

双端队列的典型应用

  1. 滑动窗口问题:需要在窗口两端进行操作
  2. 回文检测:从两端向中间检查字符
  3. 撤销/重做功能:需要在两端添加和删除操作记录
  4. 广度优先搜索变种:某些图算法需要双向扩展

与其他数据结构的对比

数据结构 队首操作 队尾操作 适用场景
普通队列 删除O(1) 插入O(1) FIFO场景
栈 插入/删除O(1) 无操作 LIFO场景
双端队列 插入/删除O(1) 插入/删除O(1) 需要两端操作
动态数组 插入O(n),删除O(n) 插入O(1)均摊,删除O(1) 随机访问

双端队列提供了比普通队列和栈更大的灵活性,在需要两端操作的算法中具有重要作用。固定数组的循环实现虽然代码复杂度稍高,但提供了最优的时间和空间性能。刷题中优先选择固定数组实现,性能更好,实际工程中如果容量不确定,可以考虑列表实现或者动态扩容的数组;此外,固定数据能使得内存使用更可控。

引言

参照的是左程云的课程:https://space.bilibili.com/8888480/lists/3509640?type=series
本笔记包括了class009 -> class012,涵盖了链表的基础概念、反转操作、合并算法、链表运算以及分割技巧等内容。


009【入门】单双链表及其反转

链表的基本概念

链表是一种线性数据结构,其中元素存储在节点中,每个节点包含数据和指向下一个节点的指针。与数组不同,链表的元素在内存中不必连续存储。

单链表节点定义

1
2
3
4
5
6
7
class ListNode:
"""
单链表节点类
"""
def __init__(self, val=0, next=None):
self.val = val # 节点存储的数据值
self.next = next # 指向下一个节点的指针

双链表节点定义

1
2
3
4
5
6
7
8
9
class DoubleListNode:
"""
双链表节点类
每个节点有两个指针:指向前驱和后继
"""
def __init__(self, value):
self.value = value # 节点存储的数据值
self.last = None # 指向前一个节点的指针
self.next = None # 指向下一个节点的指针

单链表反转算法

反转单链表测试链接 : https://leetcode.cn/problems/reverse-linked-list/

迭代方法实现

单链表反转是链表操作中的经典问题,核心思想是改变节点间的指针方向。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
class ListReverseOperations:
@staticmethod
def reverse_linked_list(head):
"""
反转单链表 - 迭代实现
时间复杂度: O(n), 空间复杂度: O(1)

参数: head - 链表头节点
返回: 反转后链表的头节点
"""
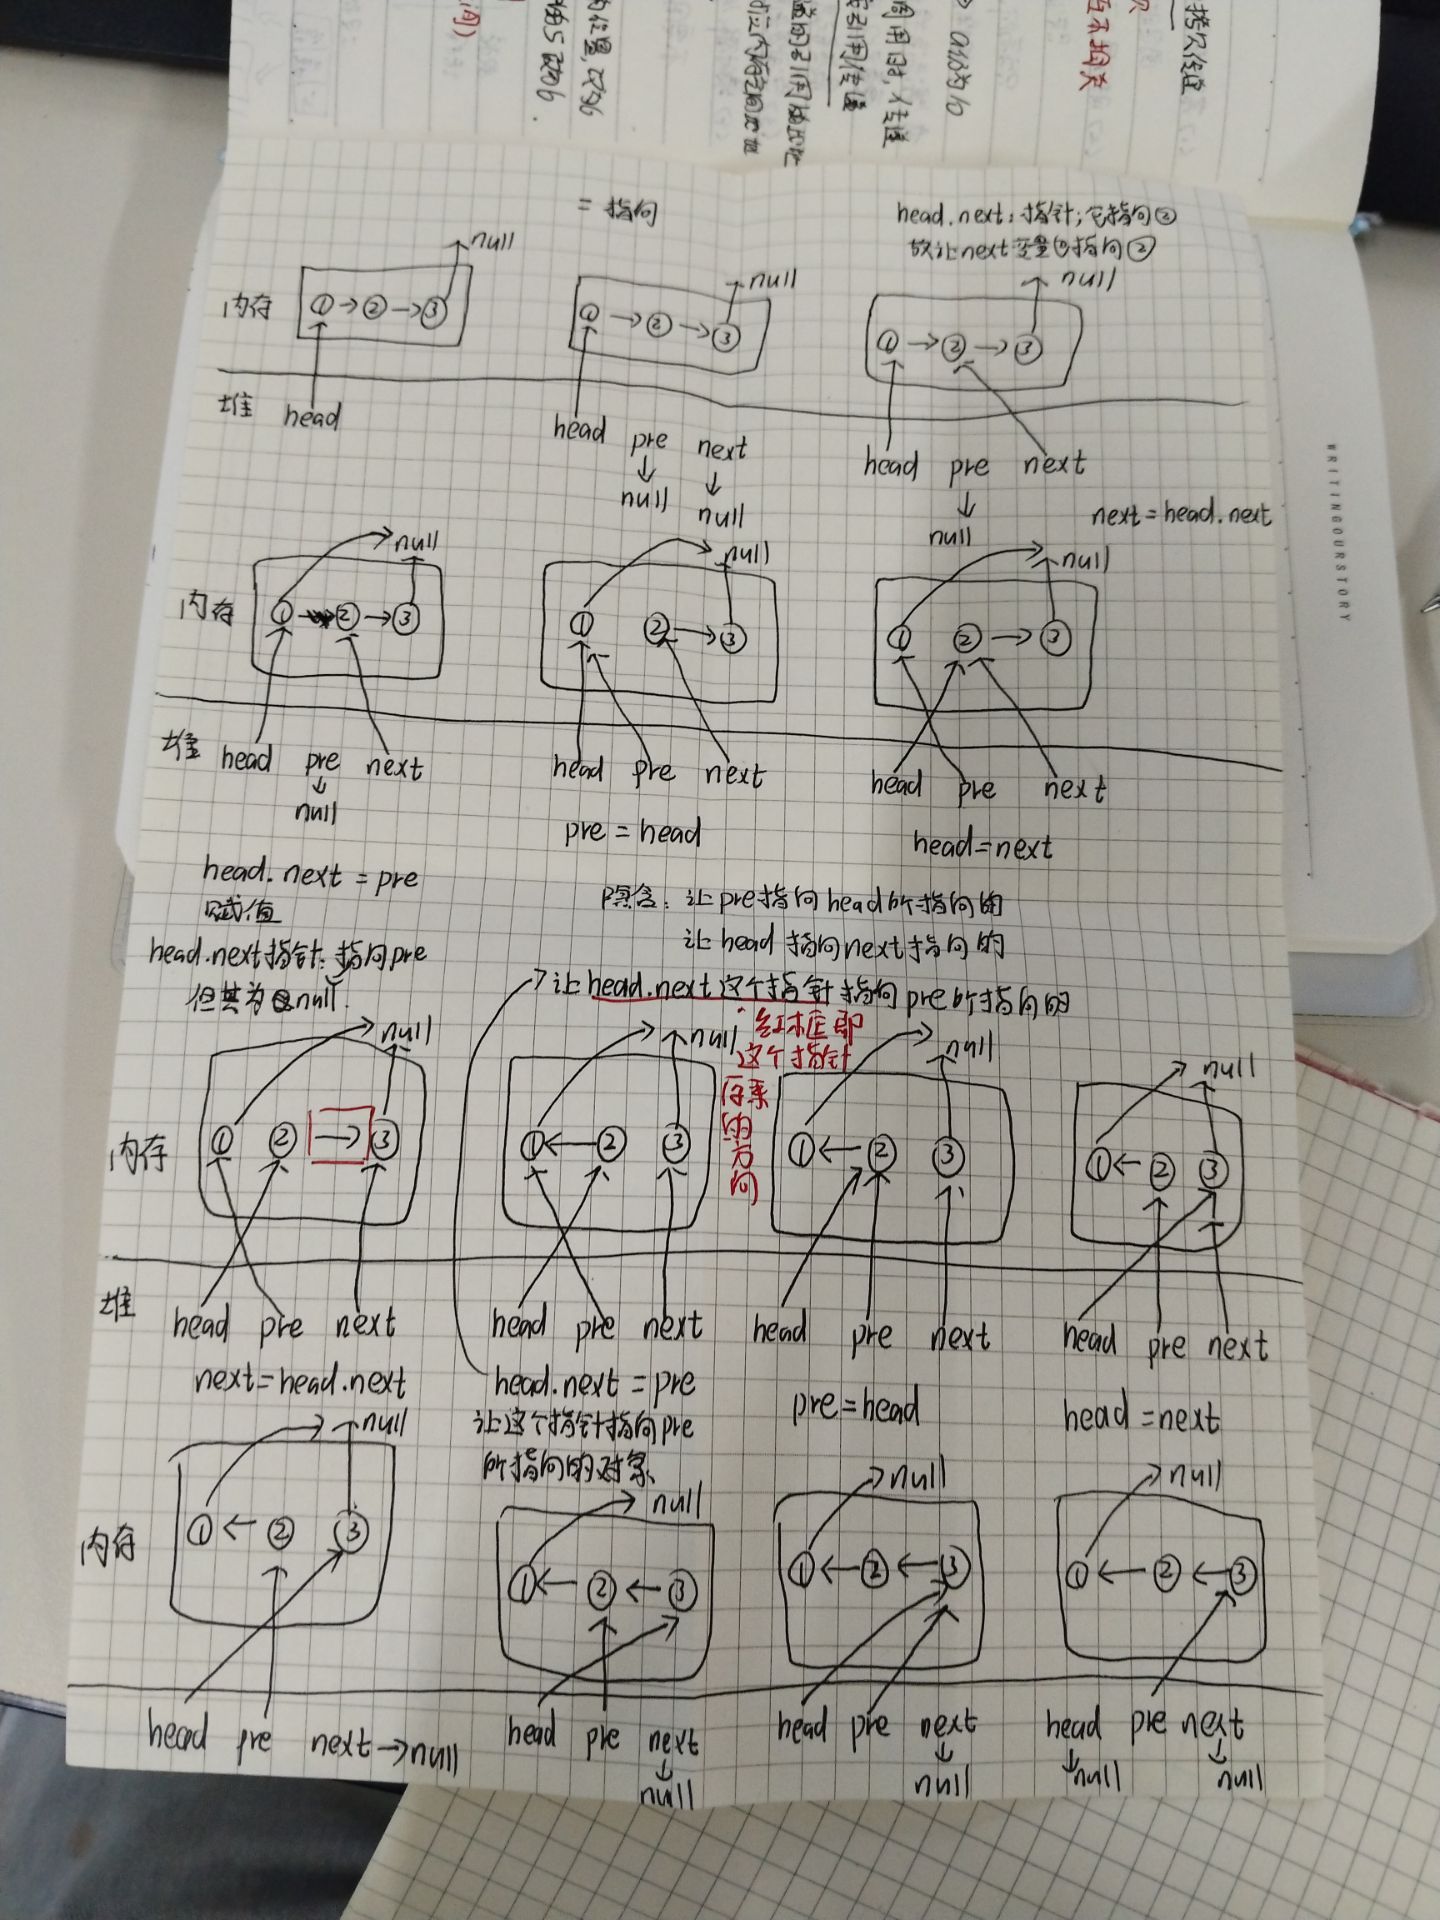
pre = None # 前驱节点指针,初始为None
next_node = None # 临时保存下一个节点

while head is not None: # 遍历整个链表
next_node = head.next # 保存下一个节点,防止链表断裂
head.next = pre # 当前节点指向前驱(反转指针)
pre = head # 前驱指针前进到当前节点
head = next_node # 头指针前进到下一个节点

return pre # pre此时指向原链表的尾节点,即新链表的头节点

反转过程图解

反转图解

具体在上面的实现中,是利用next向后移动 利用pre改变方指针向

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
原链表: 1 -> 2 -> 3 -> 4 -> 5 -> NULL

第1步: pre=NULL, head=1, next=2
NULL <- 1 2 -> 3 -> 4 -> 5 -> NULL
pre head

第2步: pre=1, head=2, next=3
NULL <- 1 <- 2 3 -> 4 -> 5 -> NULL
pre head

第3步: pre=2, head=3, next=4
NULL <- 1 <- 2 <- 3 4 -> 5 -> NULL
pre head

最终: NULL <- 1 <- 2 <- 3 <- 4 <- 5
pre

递归方法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
@staticmethod
def reverse_linked_list_recursive(head):
"""
反转单链表 - 递归实现
时间复杂度: O(n), 空间复杂度: O(n) - 递归栈空间

参数: head - 链表头节点
返回: 反转后链表的头节点
"""
# 基础情况:空链表或单节点链表
if head is None or head.next is None:
return head

# 递归反转剩余部分
new_head = ListReverseOperations.reverse_linked_list_recursive(head.next)

# 反转当前节点与下一个节点的连接
head.next.next = head # 下一个节点指回当前节点
head.next = None # 当前节点的next置空

return new_head # 返回新的头节点

双链表反转算法

双链表的反转需要同时处理前驱和后继两个指针,相比单链表更加复杂。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
@staticmethod
def reverse_double_list(head):
"""
反转双链表
时间复杂度: O(n), 空间复杂度: O(1)

参数: head - 双链表头节点
返回: 反转后双链表的头节点
"""
pre = None # 前驱节点指针
next_node = None # 临时保存下一个节点

while head is not None: # 遍历整个双链表
next_node = head.next # 保存下一个节点

# 交换当前节点的前驱和后继指针
head.next = pre # next指向前驱
head.last = next_node # last指向后继

pre = head # 前驱指针前进
head = next_node # 头指针前进

return pre # 返回新的头节点

双链表反转的关键点

  1. 指针交换:每个节点的next和last指针需要互换方向
  2. 边界处理:正确处理链表两端的NULL指针
  3. 遍历顺序:确保在修改指针前保存必要的信息

010【入门】合并两个有序链表

测试链接 : https://leetcode.cn/problems/merge-two-sorted-lists/

问题描述

给定两个已排序的链表,将它们合并成一个新的有序链表。新链表应该通过拼接给定的两个链表的所有节点组成。

算法思想

采用双指针技术,比较两个链表当前节点的值,选择较小的节点添加到结果链表中,然后移动对应的指针。

实现方案

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
class Solution:
@staticmethod
def merge_two_lists(head1, head2):
"""
合并两个有序链表
时间复杂度: O(m + n), 空间复杂度: O(1)

参数: head1, head2 - 两个有序链表的头节点
返回: 合并后有序链表的头节点
"""
# 边界情况处理:其中一个链表为空
if head1 is None or head2 is None:
return head2 if head1 is None else head1

# 确定合并后链表的头节点
if head1.val <= head2.val:
head = head1 # head1的值更小,作为头节点
cur1 = head1.next # cur1指向head1的下一个节点
cur2 = head2 # cur2指向head2的当前节点
else:
head = head2 # head2的值更小,作为头节点
cur1 = head1 # cur1指向head1的当前节点
cur2 = head2.next # cur2指向head2的下一个节点

pre = head # pre用于构建结果链表

# 双指针遍历两个链表
while cur1 is not None and cur2 is not None:
if cur1.val <= cur2.val: # cur1的值更小或相等
pre.next = cur1 # 将cur1连接到结果链表
cur1 = cur1.next # cur1指针后移
else: # cur2的值更小
pre.next = cur2 # 将cur2连接到结果链表
cur2 = cur2.next # cur2指针后移
pre = pre.next # 结果链表指针后移

# 处理剩余节点:将未遍历完的链表直接连接到结果链表末尾
pre.next = cur1 if cur1 is not None else cur2

return head # 返回合并后链表的头节点

算法优化版本

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
@staticmethod
def merge_two_lists_optimized(head1, head2):
"""
合并两个有序链表 - 优化版本
使用虚拟头节点简化边界处理
"""
dummy = ListNode(0) # 创建虚拟头节点
current = dummy # 当前指针指向虚拟头节点

# 双指针遍历两个链表
while head1 is not None and head2 is not None:
if head1.val <= head2.val:
current.next = head1 # 连接较小节点
head1 = head1.next # 移动head1指针
else:
current.next = head2 # 连接较小节点
head2 = head2.next # 移动head2指针
current = current.next # 移动结果链表指针

# 连接剩余节点
current.next = head1 if head1 is not None else head2

return dummy.next # 返回真正的头节点

合并过程示例

1
2
3
4
5
6
7
8
9
10
链表1: 1 -> 2 -> 4
链表2: 1 -> 3 -> 4

合并过程:
step1: 比较1和1,选择链表1的1 结果: 1
step2: 比较2和1,选择链表2的1 结果: 1 -> 1
step3: 比较2和3,选择链表1的2 结果: 1 -> 1 -> 2
step4: 比较4和3,选择链表2的3 结果: 1 -> 1 -> 2 -> 3
step5: 比较4和4,选择链表1的4 结果: 1 -> 1 -> 2 -> 3 -> 4
step6: 连接剩余的4 结果: 1 -> 1 -> 2 -> 3 -> 4 -> 4

011【入门】两个链表相加

测试链接:https://leetcode.cn/problems/add-two-numbers/

问题描述

给定两个非空链表来表示两个非负整数,数字最高位位于链表开始位置。它们的每个节点只存储一位数字,计算两个数的和并以相同形式返回一个表示和的链表。

核心思想

模拟手工加法运算,从链表尾部开始逐位相加,处理进位问题。

算法实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
class Solution:
@staticmethod
def add_two_numbers(h1, h2):
"""
两个链表数字相加
时间复杂度: O(max(m,n)), 空间复杂度: O(max(m,n))

参数: h1, h2 - 两个表示数字的链表头节点
返回: 表示和的链表头节点
"""
ans = None # 结果链表头节点
cur = None # 当前构建位置指针
carry = 0 # 进位标志

# 遍历两个链表,直到都为空
while h1 is not None or h2 is not None:
# 获取当前位的数字,如果链表已结束则为0
val1 = h1.val if h1 is not None else 0
val2 = h2.val if h2 is not None else 0

# 计算当前位的和(包括进位)
total = val1 + val2 + carry
carry = total // 10 # 计算新的进位
digit = total % 10 # 当前位的数字

# 构建结果链表
if ans is None: # 第一个节点
ans = ListNode(digit)
cur = ans
else: # 后续节点
cur.next = ListNode(digit)
cur = cur.next

# 移动链表指针
h1 = h1.next if h1 is not None else None
h2 = h2.next if h2 is not None else None

# 处理最后的进位
if carry == 1:
cur.next = ListNode(1)

return ans # 返回结果链表头节点

代码修正与优化

优化了源代码最后的进位问题

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
@staticmethod
def add_two_numbers_corrected(h1, h2):
"""
两个链表数字相加 - 优化版本,更加通用
"""
ans = None # 结果链表头节点
cur = None # 当前构建位置指针
carry = 0 # 进位标志

while h1 is not None or h2 is not None:
# 安全获取节点值,避免空指针异常
val1 = h1.val if h1 is not None else 0
val2 = h2.val if h2 is not None else 0

# 计算当前位的和
total = val1 + val2 + carry
carry = total // 10 # 新进位
digit = total % 10 # 当前位数字

# 构建结果链表节点
new_node = ListNode(digit)
if ans is None: # 初始化头节点
ans = cur = new_node
else: # 连接新节点
cur.next = new_node
cur = new_node

# 安全移动指针
h1 = h1.next if h1 is not None else None
h2 = h2.next if h2 is not None else None

# 处理最终进位
if carry > 0:
cur.next = ListNode(carry)

return ans

算法示例

1
2
3
4
5
6
7
8
9
10
链表1: 2 -> 4 -> 3  (表示数字342)
链表2: 5 -> 6 -> 4 (表示数字465)

相加过程:
位置0: 2 + 5 + 0(进位) = 7, 进位=0 结果: 7
位置1: 4 + 6 + 0(进位) = 10, 进位=1 结果: 7 -> 0
位置2: 3 + 4 + 1(进位) = 8, 进位=0 结果: 7 -> 0 -> 8

最终结果: 7 -> 0 -> 8 (表示数字807)
验证: 342 + 465 = 807 ✓

边界情况处理

  1. 不同长度链表:短链表结束后,继续处理长链表的剩余位
  2. 最高位进位:最后可能产生新的最高位
  3. 空链表:输入验证,确保链表非空
  4. 单位数:正确处理个位数相加的情况

012【入门】划分链表

测试链接 : https://leetcode.cn/problems/partition-list/

问题描述

给定一个链表和一个特定值x,对链表进行分隔,使得所有小于x的节点都在大于或等于x的节点之前。保持两个分区中每个节点的初始相对位置。

算法思想

使用双链表分离的思想:

  1. 创建两个独立的链表:小于x的节点链表和大于等于x的节点链表
  2. 遍历原链表,将节点分别添加到对应的链表中
  3. 最后将两个链表连接起来

实现方案

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
class Solution:
@staticmethod
def partition(head, x):
"""
划分链表
时间复杂度: O(n), 空间复杂度: O(1)

参数: head - 链表头节点, x - 划分值
返回: 划分后链表的头节点
"""
# 初始化两个链表的头尾指针
left_head = None # 小于x的链表头指针
left_tail = None # 小于x的链表尾指针
right_head = None # 大于等于x的链表头指针
right_tail = None # 大于等于x的链表尾指针

next_node = None # 临时保存下一个节点

# 遍历原链表,分离节点
while head is not None:
next_node = head.next # 保存下一个节点
head.next = None # 断开当前节点的连接

if head.val < x: # 当前节点值小于x
if left_head is None: # 左链表为空
left_head = head # 设置左链表头节点
else: # 左链表非空
left_tail.next = head # 连接到左链表尾部
left_tail = head # 更新左链表尾指针
else: # 当前节点值大于等于x
if right_head is None: # 右链表为空
right_head = head # 设置右链表头节点
else: # 右链表非空
right_tail.next = head # 连接到右链表尾部
right_tail = head # 更新右链表尾指针

head = next_node # 移动到下一个节点

# 连接两个链表
if left_head is None: # 如果左链表为空
return right_head # 直接返回右链表
else: # 左链表非空
left_tail.next = right_head # 连接左右链表
return left_head # 返回左链表头节点

代码修正与完善

优化了原代码在遍历阶段的指针指代可能不清晰的问题,修改了if else后的指定

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
class Solution:
@staticmethod
def partition_corrected(head, x):
"""
划分链表 - 修正版本
修复了原代码的语法错误和逻辑问题
"""
# 初始化四个指针
left_head = left_tail = None # 小于x的链表头尾指针
right_head = right_tail = None # 大于等于x的链表头尾指针

# 遍历原链表
while head is not None:
next_node = head.next # 保存下一个节点
head.next = None # 断开当前节点

if head.val < x: # 节点值小于x
if left_head is None: # 第一个小于x的节点
left_head = left_tail = head
else: # 后续小于x的节点
left_tail.next = head
left_tail = head
else: # 节点值大于等于x
if right_head is None: # 第一个大于等于x的节点
right_head = right_tail = head
else: # 后续大于等于x的节点
right_tail.next = head
right_tail = head

head = next_node # 移动到下一个节点

# 合并两个链表
if left_head is None: # 只有大于等于x的节点
return right_head

left_tail.next = right_head # 连接两个链表
return left_head # 返回结果链表头节点

优化版本:使用虚拟头节点

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
@staticmethod
def partition_optimized(head, x):
"""
划分链表 - 优化版本
使用虚拟头节点简化代码逻辑,简化了边界处理
"""
# 创建虚拟头节点
left_dummy = ListNode(0) # 小于x链表的虚拟头节点
right_dummy = ListNode(0) # 大于等于x链表的虚拟头节点

left = left_dummy # 小于x链表的当前指针
right = right_dummy # 大于等于x链表的当前指针

# 遍历原链表,分配节点
while head is not None:
if head.val < x:
left.next = head # 连接到左链表
left = left.next # 移动左指针
else:
right.next = head # 连接到右链表
right = right.next # 移动右指针
head = head.next # 移动原链表指针

# 断开右链表的尾部连接,防止环
right.next = None

# 连接两个链表
left.next = right_dummy.next

return left_dummy.next # 返回真正的头节点

算法示例

1
2
3
4
5
6
7
8
9
10
11
12
原链表: 1 -> 4 -> 3 -> 2 -> 5 -> 2
划分值: x = 3

分离过程:
节点1 < 3: 左链表 = 1
节点4 >= 3: 右链表 = 4
节点3 >= 3: 右链表 = 4 -> 3
节点2 < 3: 左链表 = 1 -> 2
节点5 >= 3: 右链表 = 4 -> 3 -> 5
节点2 < 3: 左链表 = 1 -> 2 -> 2

最终结果: 1 -> 2 -> 2 -> 4 -> 3 -> 5

算法特点

  1. 稳定性:保持原有的相对顺序
  2. 原地操作:只调整指针,不创建新节点
  3. 时间效率:单次遍历,O(n)时间复杂度
  4. 空间效率:只使用常数额外空间

应用场景

  1. 链表排序的预处理:快速排序的分区操作
  2. 数据分类:按条件将数据分为两组
  3. 链表重组:根据特定规则重新排列链表节点

链表操作技巧拓展

核心技巧与模式

1. 双指针技术

1
2
3
4
5
6
7
8
9
10
def two_pointer_pattern(head):
"""
双指针模式:快慢指针、左右指针等
常用于链表中点查找、环检测、倒数第k个节点等
"""
slow = fast = head # 快慢指针初始化
while fast and fast.next:
slow = slow.next # 慢指针每次移动1步
fast = fast.next.next # 快指针每次移动2步
return slow # 返回中点或其他目标位置

2. 虚拟头节点

1
2
3
4
5
6
7
8
9
10
11
12
def dummy_head_pattern(head):
"""
虚拟头节点模式:简化头节点的特殊处理
特别适用于可能删除头节点或构建新链表的场景
"""
dummy = ListNode(0) # 创建虚拟头节点
dummy.next = head # 连接原链表

# 在这里进行各种操作
# ...

return dummy.next # 返回真正的头节点

3. 递归模式

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
def recursive_pattern(head):
"""
递归模式:将复杂问题分解为子问题
适用于链表反转、删除节点、合并等操作
"""
# 基础情况
if head is None or head.next is None:
return head

# 递归处理子问题
result = recursive_pattern(head.next)

# 处理当前层
# ...

return result

4. 节点分离与重组

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
def separate_and_merge_pattern(head):
"""
分离重组模式:将链表按条件分离后重新组合
适用于链表划分、奇偶分离、按值分组等
"""
# 创建多个子链表的头尾指针
list1_head = list1_tail = None
list2_head = list2_tail = None

while head:
next_node = head.next
head.next = None # 断开连接

if condition(head): # 根据条件分配
# 添加到list1
if list1_head is None:
list1_head = list1_tail = head
else:
list1_tail.next = head
list1_tail = head
else:
# 添加到list2
if list2_head is None:
list2_head = list2_tail = head
else:
list2_tail.next = head
list2_tail = head

head = next_node

# 重新组合链表
if list1_tail:
list1_tail.next = list2_head
return list1_head if list1_head else list2_head

常见错误与注意事项

1. 空指针处理

1
2
3
4
5
6
7
8
9
# 错误示例
def wrong_example(head):
return head.next.val # 可能导致空指针异常

# 正确示例
def correct_example(head):
if head and head.next: # 先检查再访问
return head.next.val
return None

2. 内存泄漏防止

1
2
3
4
5
6
7
8
def prevent_memory_leak(head):
"""
防止内存泄漏:及时断开不需要的连接
"""
while head:
next_node = head.next
head.next = None # 断开连接,防止环
head = next_node

3. 边界情况处理

1
2
3
4
5
6
7
8
9
10
11
12
13
14
def handle_edge_cases(head):
"""
处理边界情况:空链表、单节点链表等
"""
# 空链表
if head is None:
return None

# 单节点链表
if head.next is None:
return head

# 正常处理逻辑
# ...

性能分析与优化

时间复杂度分析

  • 单次遍历操作:O(n) - 反转、合并、查找等
  • 嵌套遍历操作:O(n²) - 某些复杂的链表操作
  • 递归操作:O(n) - 但需要考虑递归栈空间

空间复杂度优化

  • 原地操作:优先使用指针操作而非创建新节点
  • 迭代替代递归:在可能的情况下避免递归栈开销
  • 临时变量最小化:只保存必要的指针变量

实际性能考虑

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
def performance_optimized_merge(h1, h2):
"""
性能优化的链表合并
减少条件判断和指针操作
"""
dummy = ListNode(0)
tail = dummy

while h1 and h2:
if h1.val <= h2.val:
tail.next, h1 = h1, h1.next
else:
tail.next, h2 = h2, h2.next
tail = tail.next

# 直接连接剩余部分,无需循环
tail.next = h1 or h2
return dummy.next

引言

参照的是左程云的课程:https://space.bilibili.com/8888480/lists/3509640?type=series
本笔记包括了class002 -> class 007的内容,涵盖了社会实验模拟、位运算、基础排序算法、算法验证方法、二分搜索以及复杂度分析等核心内容。

原代码是java版,我改成了python


002【入门】从社会实验到入门提醒

基尼系数的理论基础

基尼系数是经济学中衡量收入分配不平等程度的重要指标,其数学定义为:

$$
G = \frac{\sum_{i=1}^{n}\sum_{j=1}^{n}|x_i - x_j|}{2n\sum_{i=1}^{n}x_i}
$$

其中 $x_i$ 表示第 $i$ 个个体的财富值,$n$ 为总人数。

基尼系数的经济学意义

  • G = 0:完全平等,所有人财富相同
  • G = 1:完全不平等,一人拥有全部财富
  • G = 0.4-0.5:国际公认的贫富差距警戒线
  • G > 0.5:社会可能面临动荡风险

财富分配模拟实验

通过计算机模拟研究在完全随机的财富转移过程中,社会财富分配的自然演化规律。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
import numpy as np
import random

def calculate_gini(wealth):
"""
计算基尼系数的函数
参数: wealth - 财富分布列表
返回: 基尼系数值
"""
n = len(wealth) # 获取人数
sum_of_wealth = sum(wealth) # 计算总财富
sum_of_absolute_differences = 0 # 初始化财富差异总和

# 计算所有个体间财富差异的绝对值之和
for i in range(n):
for j in range(n):
sum_of_absolute_differences += abs(wealth[i] - wealth[j])

# 根据基尼系数公式计算并返回结果
return sum_of_absolute_differences / (2 * n * sum_of_wealth)

def experiment(n, t):
"""
财富分配模拟实验
参数: n - 人数, t - 模拟轮数
"""
wealth = [100] * n # 初始化每人财富为100

for _ in range(t): # 进行t轮模拟
has_money = [w > 0 for w in wealth] # 判断每个人是否有钱可转
transfers = [] # 记录本轮转账列表

for j in range(n): # 遍历每个人
if has_money[j]: # 如果该人有钱
other = j # 初始化接收者为自己
while other == j: # 确保接收者不是自己
other = random.randint(0, n - 1) # 随机选择其他人
transfers.append((j, other)) # 记录转账关系

# 统一执行所有转账,避免执行顺序影响结果
for giver, receiver in transfers:
wealth[giver] -= 1 # 转出者财富减1
wealth[receiver] += 1 # 接收者财富加1

wealth.sort() # 按财富排序便于观察分布

# 输出结果分析
print("财富分布(从贫穷到富有):")
for idx, w in enumerate(wealth):
print(int(w), end=' ')
if idx % 10 == 9: # 每10个数换行
print()
print()
print("社会基尼系数:", calculate_gini(wealth))

实验意义与启示

  1. 随机性中的必然性:即使在完全公平的随机转移规则下,财富差距仍会自然产生
  2. 马太效应:财富分配存在自然的分化趋势
  3. 社会政策启示:需要主动的调节机制来维护社会公平

003【入门】二进制和位运算

计算机数值表示系统

正数的二进制表示

正数采用标准的二进制表示法,最高位为符号位(0表示正数)。

负数的补码表示

负数采用补码(Two’s Complement)表示:

  • 原码按位取反
  • 结果加1

$$
\text{负数补码} = \sim(\text{原码}) + 1
$$

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
def print_binary(num):
"""
打印32位二进制表示
参数: num - 要打印的整数
"""
s = '' # 初始化二进制字符串
for i in range(31, -1, -1): # 从最高位到最低位遍历
# 通过位与运算判断第i位是否为1
s += '1' if (num & (1 << i)) != 0 else '0'
print(s) # 输出32位二进制表示

# 演示正负数的二进制表示
if __name__ == "__main__":
a = 78 # 正数示例
print(f"正数{a}的二进制表示:")
print_binary(a)

b = -6 # 负数示例
print(f"负数{b}的二进制表示:")
print_binary(b)

# 验证补码计算
print(f"~{a} + 1 = {~a + 1}") # 计算a的相反数
print_binary(~a + 1)

核心位运算操作

基本位运算符详解

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
def bitwise_operations_demo():
"""位运算操作演示"""
'''0b 是Python中表示二进制数字的前缀。'''
g = 0b0001010 # 二进制字面量:10
h = 0b0001100 # 二进制字面量:12

print("操作数g:", bin(g))
print("操作数h:", bin(h))

# 按位或运算:有1则1
print("g | h =", bin(g | h)) # 0b1110 = 14

# 按位与运算:全1则1
print("g & h =", bin(g & h)) # 0b1000 = 8

# 按位异或运算:不同则1
print("g ^ h =", bin(g ^ h)) # 0b0110 = 6

def shift_operations_demo():
"""移位运算演示"""
i = 0b0011010 # 二进制:26
print(f"原数: {i}, 二进制: {bin(i)}")

# 左移运算:相当于乘以2的幂次
print(f"{i} << 1 = {i << 1}") # 26 * 2 = 52
print(f"{i} << 2 = {i << 2}") # 26 * 4 = 104
print(f"{i} << 3 = {i << 3}") # 26 * 8 = 208

# 右移运算:相当于除以2的幂次(向下取整)
k = 10
print(f"{k} >> 1 = {k >> 1}") # 10 / 2 = 5
print(f"{k} >> 2 = {k >> 2}") # 10 / 4 = 2
print(f"{k} >> 3 = {k >> 3}") # 10 / 8 = 1

逻辑运算与位运算的重要区别

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
def return_true():
print("执行了return_true函数")
return True

def return_false():
print("执行了return_false函数")
return False

def logical_vs_bitwise():
"""演示逻辑运算与位运算的区别"""
print("=== 位运算测试 ===")
# 位运算:两个函数都会被调用
test1 = return_true() | return_false()
print(f"位运算结果: {test1}")

print("=== 逻辑运算测试 ===")
# 逻辑运算:存在短路求值,第二个函数可能不被调用
test2 = return_true() or return_false()
print(f"逻辑运算结果: {test2}")

位运算的实际应用

  1. 快速乘除法:左移代替乘法,右移代替除法
  2. 奇偶性判断:num & 1 == 0 判断偶数。这是因为:num & 1 只保留 num 的二进制最低位,其余全部变成0。
  3. 集合操作:用位掩码表示集合的并、交、差运算
  4. 状态压缩:在动态规划中压缩状态空间

004【入门】选择、冒泡、插入排序

理解python中的class:什么是“实例化类”?

  • 类(class):可以理解为一个“模具”或者“模板”,描述一类对象应该有哪些属性和行为。
  • 实例(instance):就是根据这个“模具”制造出来的一个具体的“物品”。
  • 实例化:把类变成实例(对象)的过程,叫做实例化。

选择排序(Selection Sort)

算法思想

每次从未排序部分选择最小(或最大)元素,将其放置到已排序部分的末尾。

时间复杂度分析

  • 比较次数:$\sum_{i=0}^{n-2}(n-1-i) = \frac{n(n-1)}{2} = O(n^2)$
  • 交换次数:$O(n)$
  • 总体复杂度:$O(n^2)$
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
class SortingAlgorithms:

@staticmethod
def swap(arr, i, j):
"""
交换数组中两个位置的元素
参数: arr - 数组, i,j - 要交换的索引
"""
arr[i], arr[j] = arr[j], arr[i] # Python的元组赋值交换

@staticmethod
def selection_sort(arr):
"""
选择排序实现
时间复杂度: O(n²), 空间复杂度: O(1)
不稳定排序
"""
if arr is None or len(arr) < 2: # 边界条件检查
return

# 外层循环控制已排序部分的边界
for i in range(len(arr) - 1):
min_index = i # 假设当前位置为最小值

# 内层循环在未排序部分寻找真正的最小值
for j in range(i + 1, len(arr)):
if arr[j] < arr[min_index]: # 找到更小的元素
min_index = j # 更新最小值索引

# 将找到的最小值与当前位置交换
SortingAlgorithms.swap(arr, i, min_index)

冒泡排序(Bubble Sort)

算法思想

重复遍历数组,比较相邻元素并在必要时交换,使得大元素逐渐”冒泡”到数组末尾。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
@staticmethod
def bubble_sort(arr):
"""
冒泡排序实现
时间复杂度: O(n²), 空间复杂度: O(1)
稳定排序
"""
if arr is None or len(arr) < 2: # 边界条件检查
return

# 外层循环控制未排序部分的右边界
for end in range(len(arr) - 1, 0, -1):
# 内层循环进行相邻元素比较和交换
for i in range(end):
if arr[i] > arr[i + 1]: # 如果前面元素大于后面元素
SortingAlgorithms.swap(arr, i, i + 1) # 交换位置
# 经过一轮后,最大元素"冒泡"到末尾

冒泡排序的优化

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
@staticmethod  
def bubble_sort_optimized(arr):
"""
优化版冒泡排序:添加提前终止条件
如果某轮遍历中没有发生交换,说明数组已有序
"""
if arr is None or len(arr) < 2:
return

for end in range(len(arr) - 1, 0, -1):
swapped = False # 标记本轮是否发生交换
for i in range(end):
if arr[i] > arr[i + 1]:
SortingAlgorithms.swap(arr, i, i + 1)
swapped = True # 发生了交换

if not swapped: # 如果本轮没有交换
break # 数组已有序,提前结束

插入排序(Insertion Sort)

算法思想

将数组分为已排序和未排序两部分,依次将未排序元素插入到已排序部分的正确位置。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
@staticmethod
def insertion_sort(arr):
"""
插入排序实现
时间复杂度: 最坏O(n²), 最好O(n), 平均O(n²)
空间复杂度: O(1)
稳定排序,对小规模或近似有序数据效率高
"""
if arr is None or len(arr) < 2: # 边界条件检查
return

# 从第二个元素开始,逐个插入到已排序部分
for i in range(1, len(arr)):
# 从当前位置向前比较,寻找插入位置
for j in range(i - 1, -1, -1):
if arr[j] > arr[j + 1]: # 如果前面元素大于后面元素
SortingAlgorithms.swap(arr, j, j + 1) # 交换位置
else:
break # 找到正确位置,提前结束内层循环

插入排序的另一种实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
@staticmethod
def insertion_sort_v2(arr):
"""
插入排序的另一种实现:先保存要插入的元素,然后移动其他元素
减少交换次数,提高效率
"""
if arr is None or len(arr) < 2:
return

for i in range(1, len(arr)):
key = arr[i] # 保存要插入的元素
j = i - 1 # 从已排序部分的末尾开始

# 向右移动大于key的元素
while j >= 0 and arr[j] > key:
arr[j + 1] = arr[j] # 元素后移
j -= 1

arr[j + 1] = key # 插入key到正确位置

排序算法性能对比

算法 时间复杂度(最好) 时间复杂度(平均) 时间复杂度(最坏) 空间复杂度 稳定性
选择排序 $O(n^2)$ $O(n^2)$ $O(n^2)$ $O(1)$ 不稳定
冒泡排序 $O(n)$ $O(n^2)$ $O(n^2)$ $O(1)$ 稳定
插入排序 $O(n)$ $O(n^2)$ $O(n^2)$ $O(1)$ 稳定

005【入门】对数器-验证的重要手段

对数器的理论基础

对数器(Logarithmic Validator)是一种系统性验证算法正确性的重要工具,通过大量随机测试用例来检验算法实现的可靠性。

对数器设计的六个核心原则

  1. 确定待测算法a:需要验证正确性的高效算法
  2. 实现简单算法b:复杂度可能不优但逻辑简单、容易验证正确的算法
  3. 构建随机样本生成器:能够产生各种边界情况的测试数据
  4. 对比验证:在相同输入下比较两种算法的输出结果
  5. 错误定位:当发现不一致时,人工分析并修正错误
  6. 大规模验证:通过大量测试建立对算法正确性的信心

对数器实现框架(以上节课的三种排序方法为例)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
import random

class AlgorithmValidator:
"""算法验证器类"""

@staticmethod
def random_array(n, v):
"""
生成随机数组
参数: n - 数组长度, v - 元素值域[1,v]
返回: 长度为n的随机数组
"""
# 使用列表推导式生成随机数组
return [random.randint(1, v) for _ in range(n)]

@staticmethod
def copy_array(arr):
"""
数组深拷贝
参数: arr - 原数组
返回: 原数组的副本
"""
return arr[:] # 切片操作创建新列表

@staticmethod
def arrays_equal(arr1, arr2):
"""
比较两个数组是否相等
参数: arr1, arr2 - 待比较的数组
返回: 布尔值表示是否相等
"""
if len(arr1) != len(arr2): # 长度不等直接返回False
return False

# 逐元素比较
for a, b in zip(arr1, arr2):
if a != b:
return False
return True

@staticmethod
def comprehensive_sort_test():
"""
排序算法综合测试
使用对数器方法验证多种排序算法的正确性
"""
# 测试参数配置
N = 200 # 数组最大长度
V = 1000 # 元素最大值
test_times = 50000 # 测试次数

print("算法验证开始...")

for test_round in range(test_times):
# 生成随机测试用例
n = random.randint(0, N - 1) # 随机数组长度
arr = AlgorithmValidator.random_array(n, V)

# 创建多个数组副本用于不同算法测试
arr_selection = AlgorithmValidator.copy_array(arr)
arr_bubble = AlgorithmValidator.copy_array(arr)
arr_insertion = AlgorithmValidator.copy_array(arr)
arr_builtin = AlgorithmValidator.copy_array(arr)

# 应用不同排序算法
SortingAlgorithms.selection_sort(arr_selection)
SortingAlgorithms.bubble_sort(arr_bubble)
SortingAlgorithms.insertion_sort(arr_insertion)
arr_builtin.sort() # Python内置排序作为标准答案

# 结果一致性验证
if not (AlgorithmValidator.arrays_equal(arr_selection, arr_builtin) and
AlgorithmValidator.arrays_equal(arr_bubble, arr_builtin) and
AlgorithmValidator.arrays_equal(arr_insertion, arr_builtin)):

# 发现错误时输出详细信息
print("发现算法错误!")
print(f"测试轮次: {test_round + 1}")
print(f"原始数组: {arr}")
print(f"选择排序: {arr_selection}")
print(f"冒泡排序: {arr_bubble}")
print(f"插入排序: {arr_insertion}")
print(f"内置排序: {arr_builtin}")
return False

# 每完成1000次测试输出进度
if (test_round + 1) % 1000 == 0:
print(f"已完成 {test_round + 1} 次测试...")

print("所有测试通过!算法实现正确。")
return True

对数器方法的优势

  1. 自动化验证:减少人工测试的工作量和错误率
  2. 覆盖边界情况:随机生成能够触及各种极端情况
  3. 置信度建立:大量测试通过后可以高度确信算法正确性
  4. 错误定位:一旦发现问题能够提供具体的错误样例

006【入门】二分搜索

二分搜索的数学基础

二分搜索基于分治思想,每次将搜索空间减半,时间复杂度为 $O(\log n)$。

设数组长度为 $n$,经过 $k$ 次二分后搜索空间大小为 $\frac{n}{2^k}$,当搜索空间减小到1时:

$$\frac{n}{2^k} = 1 \Rightarrow k = \log_2 n$$

基础二分搜索

问题:判断有序数组中是否存在目标值

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
def binary_search_exist(arr, target):
"""
在有序数组中查找目标值是否存在
参数: arr - 有序数组, target - 目标值
返回: True/False 表示是否存在
时间复杂度: O(log n), 空间复杂度: O(1)
"""
if arr is None or len(arr) == 0: # 边界条件:空数组
return False

left, right = 0, len(arr) - 1 # 初始化搜索边界[left, right]

while left <= right: # 搜索空间非空时继续
# 防止整数溢出的中点计算方法
mid = left + (right - left) // 2 # 等价于 (left + right) // 2

if arr[mid] == target: # 找到目标值
return True
elif arr[mid] > target: # 目标值在左半部分
right = mid - 1 # 收缩右边界
else: # 目标值在右半部分
left = mid + 1 # 收缩左边界

return False # 搜索完毕未找到

暴力验证方法

1
2
3
4
5
6
7
8
9
def linear_search_exist(arr, target):
"""
线性搜索验证方法
用于对数器验证二分搜索的正确性
"""
for element in arr: # 遍历数组每个元素
if element == target: # 找到目标值
return True
return False # 未找到目标值

二分搜索的边界查找变种

查找左边界:>=target的最左位置

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
def binary_search_left_bound(arr, target):
"""
在有序数组中查找 >= target 的最左位置
参数: arr - 有序数组, target - 目标值
返回: 满足条件的最左索引,不存在返回-1
"""
if arr is None or len(arr) == 0:
return -1

left, right = 0, len(arr) - 1
ans = -1 # 记录答案,初始化为-1表示未找到

while left <= right:
mid = left + (right - left) // 2

if arr[mid] >= target: # 当前元素满足条件
ans = mid # 更新答案
right = mid - 1 # 继续在左半部分寻找更左的位置
else: # 当前元素小于target
left = mid + 1 # 在右半部分继续搜索

return ans

def linear_search_left_bound(arr, target):
"""线性搜索验证:查找>=target的最左位置"""
for i in range(len(arr)): # 从左到右遍历
if arr[i] >= target: # 找到第一个满足条件的位置
return i
return -1 # 未找到

查找右边界:<=target的最右位置

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
def binary_search_right_bound(arr, target):
"""
在有序数组中查找 <= target 的最右位置
参数: arr - 有序数组, target - 目标值
返回: 满足条件的最右索引,不存在返回-1
"""
if arr is None or len(arr) == 0:
return -1

left, right = 0, len(arr) - 1
ans = -1 # 记录答案

while left <= right:
mid = left + (right - left) // 2

if arr[mid] <= target: # 当前元素满足条件
ans = mid # 更新答案
left = mid + 1 # 继续在右半部分寻找更右的位置
else: # 当前元素大于target
right = mid - 1 # 在左半部分继续搜索

return ans

def linear_search_right_bound(arr, target):
"""线性搜索验证:查找<=target的最右位置"""
for i in range(len(arr) - 1, -1, -1): # 从右到左遍历
if arr[i] <= target: # 找到第一个满足条件的位置
return i
return -1 # 未找到

峰值元素查找

问题定义

在数组中找到任意一个峰值元素(比左右邻居都大的元素),假设边界外的元素为负无穷。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
def find_peak_element(arr):
"""
查找数组中的峰值元素
参数: arr - 整数数组(相邻元素不相等)
返回: 任意峰值元素的索引
时间复杂度: O(log n)
"""
n = len(arr)

# 边界情况处理
if n == 1: # 单元素数组
return 0
if arr[0] > arr[1]: # 第一个元素是峰值
return 0
if arr[n-1] > arr[n-2]: # 最后一个元素是峰值
return n - 1

# 在 [1, n-2] 范围内二分搜索
left, right = 1, n - 2

while left <= right:
mid = left + (right - left) // 2

if arr[mid-1] > arr[mid]: # 左邻居更大,峰值在左半部分
right = mid - 1
elif arr[mid] < arr[mid+1]: # 右邻居更大,峰值在右半部分
left = mid + 1
else: # arr[mid-1] < arr[mid] > arr[mid+1]
return mid # 找到峰值

return -1 # 理论上不会到达这里

峰值查找的正确性证明

定理:在满足相邻元素不相等的数组中,上述算法一定能找到峰值。

证明:

  1. 边界已处理端点峰值。
  2. 二分查找时,每次都能缩小到含有峰值的半区。
  3. 因为每次都“爬坡”,必然最终会达到一个峰值。
  4. 相邻元素不等消除了平台的歧义。
  5. 因此,算法在O(log n)时间内一定能找到一个峰值。

二分搜索验证框架

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
def test_binary_search_algorithms():
"""二分搜索算法综合测试"""
N = 100 # 数组最大长度
V = 1000 # 元素值域
test_times = 500000 # 测试次数

print("二分搜索算法测试开始...")

for _ in range(test_times):
# 生成随机有序数组
n = random.randint(0, N - 1)
arr = [random.randint(1, V) for _ in range(n)]
arr.sort() # 确保数组有序

target = random.randint(0, V - 1) # 随机目标值

# 验证基础二分搜索
if binary_search_exist(arr, target) != linear_search_exist(arr, target):
print("基础二分搜索错误!")
return False

# 验证左边界查找
if binary_search_left_bound(arr, target) != linear_search_left_bound(arr, target):
print("左边界查找错误!")
return False

# 验证右边界查找
if binary_search_right_bound(arr, target) != linear_search_right_bound(arr, target):
print("右边界查找错误!")
return False

print("所有二分搜索测试通过!")
return True

007【入门】时间复杂度和空间复杂度

时间复杂度的数学基础

渐近记号系统

设 $f(n)$ 和 $g(n)$ 为定义在正整数集上的函数:

  • 大O记号 $O(g(n))$:$f(n) = O(g(n))$ 当且仅当存在正常数 $c$ 和 $n_0$,使得对所有 $n \geq n_0$ 有 $f(n) \leq c \cdot g(n)$
  • 大Ω记号 $\Omega(g(n))$:$f(n) = \Omega(g(n))$ 当且仅当存在正常数 $c$ 和 $n_0$,使得对所有 $n \geq n_0$ 有 $f(n) \geq c \cdot g(n)$
  • 大Θ记号 $\Theta(g(n))$:$f(n) = \Theta(g(n))$ 当且仅当 $f(n) = O(g(n))$ 且 $f(n) = \Omega(g(n))$

其实和泛函的函数的范数有点像,也就是这个映射算是有界的那种感觉。

常见复杂度级别

$$O(1) < O(\log n) < O(n) < O(n \log n) < O(n^2) < O(2^n) < O(n!)$$

复杂嵌套循环分析

等差数列型循环

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
def quadratic_complexity_demo(N):
"""
演示O(n²)时间复杂度
等差数列求和:1 + 2 + ... + n = n(n+1)/2 = O(n²)
"""
operations = 0 # 记录操作次数

for i in range(1, N + 1): # 外层循环:i从1到N
for j in range(i, N + 1): # 内层循环:j从i到N
operations += 1 # 模拟一次基本操作
# 当i=1时,内层执行N次
# 当i=2时,内层执行N-1次
# ...
# 当i=N时,内层执行1次
# 总计:N + (N-1) + ... + 1 = N(N+1)/2

print(f"N={N}, 总操作次数={operations}, 理论值={N*(N+1)//2}")
return operations

调和级数型循环

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
def n_log_n_complexity_demo(N):
"""
演示O(n log n)时间复杂度
调和级数:1 + 1/2 + 1/3 + ... + 1/n ≈ ln(n) = O(log n)
"""
operations = 0 # 记录操作次数

for i in range(1, N + 1): # 外层循环:i从1到N
j = i # 内层循环起始值
while j <= N: # 按i的倍数递增
operations += 1 # 模拟一次基本操作
j += i # j = i, 2i, 3i, ...
# 当i=1时,内层执行N次(N/1)
# 当i=2时,内层执行N/2次
# 当i=3时,内层执行N/3次
# ...
# 总计:N(1 + 1/2 + 1/3 + ... + 1/N) = N·H_N ≈ N log N

print(f"N={N}, 总操作次数={operations}")
return operations

复杂度实验验证

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
import time

def complexity_benchmark():
"""
通过实际运行时间验证复杂度分析
"""
test_sizes = [1000, 2000, 4000, 8000] # 测试规模

print("=== 复杂度实验验证 ===")
print("规模\tO(n²)时间\tO(n log n)时间\t比率")

for N in test_sizes:
# 测试O(n²)算法
start_time = time.time()
quadratic_complexity_demo(N)
quadratic_time = time.time() - start_time

# 测试O(n log n)算法
start_time = time.time()
n_log_n_complexity_demo(N)
n_log_n_time = time.time() - start_time

ratio = quadratic_time / n_log_n_time if n_log_n_time > 0 else float('inf')
print(f"{N}\t{quadratic_time:.4f}s\t{n_log_n_time:.4f}s\t{ratio:.2f}")

单循环冒泡排序的复杂度分析

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
def single_loop_bubble_sort(arr):
"""
使用单个循环实现冒泡排序
虽然只有一个while循环,但时间复杂度仍然是O(n²)
"""
if arr is None or len(arr) < 2:
return

n = len(arr)
end = n - 1 # 未排序部分的右边界
i = 0 # 当前比较位置

while end > 0: # 外层逻辑:控制轮次
if arr[i] > arr[i + 1]: # 相邻元素比较
arr[i], arr[i + 1] = arr[i + 1], arr[i] # 交换

if i < end - 1: # 当前轮次未结束
i += 1 # 移动到下一个比较位置
else: # 当前轮次结束
end -= 1 # 缩小未排序范围
i = 0 # 重置比较位置
# 虽然是单循环,但逻辑上等价于双层嵌套
# 时间复杂度仍为O(n²)

空间复杂度分析

动态数组的均摊复杂度分析

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
def dynamic_array_analysis():
"""
动态数组扩容的均摊复杂度分析
"""
arr = [] # 初始空数组
operations = [] # 记录每次操作的代价

for i in range(16): # 插入16个元素
old_capacity = len(arr) # 当前容量
arr.append(i) # 插入元素

# 模拟扩容过程
if len(arr) > old_capacity: # 发生了扩容
# Python的list实际扩容策略比较复杂,这里简化为2倍扩容
cost = old_capacity # 扩容代价:复制所有旧元素
else:
cost = 1 # 普通插入代价

operations.append(cost)
print(f"插入元素{i}, 当前大小={len(arr)}, 本次代价={cost}")

total_cost = sum(operations)
average_cost = total_cost / len(operations)
print(f"总代价={total_cost}, 平均代价={average_cost:.2f}")

# 数学分析:
# 扩容发生在容量为1,2,4,8,...时
# 总扩容代价:0 + 1 + 2 + 4 + 8 + ... < 2n
# 总插入代价:n
# 均摊代价:(2n + n) / n = 3 = O(1)

递归算法的空间复杂度

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
def recursive_space_analysis(n):
"""
递归算法空间复杂度分析
计算阶乘的递归实现
"""
if n <= 1: # 基础情况
return 1

# 每次递归调用占用O(1)空间
# 最大递归深度为n,所以空间复杂度为O(n)
return n * recursive_space_analysis(n - 1)

def iterative_space_analysis(n):
"""
迭代版本的阶乘计算
空间复杂度为O(1)
"""
result = 1 # 只使用常数额外空间
for i in range(1, n + 1):
result *= i
return result

复杂度分析的实用技巧

主定理(Master Theorem)

对于递归关系 $T(n) = aT(\frac{n}{b}) + f(n)$,其中 $a \geq 1, b > 1$:

  • 如果 $f(n) = O(n^{\log_b a - \epsilon})$,则 $T(n) = \Theta(n^{\log_b a})$
  • 如果 $f(n) = \Theta(n^{\log_b a})$,则 $T(n) = \Theta(n^{\log_b a} \log n)$
  • 如果 $f(n) = \Omega(n^{\log_b a + \epsilon})$,则 $T(n) = \Theta(f(n))$

均摊分析方法

  • 聚合分析:分析一系列操作的总代价
  • 核算法:为每种操作分配均摊代价
  • 势能法:定义势能函数分析代价分布

实际性能考虑因素

1
2
3
4
5
6
7
8
9
10
11
def practical_performance_factors():
"""
影响实际性能的因素
"""
print("影响算法实际性能的因素:")
print("1. 常数因子:O(n)算法的常数可能很大")
print("2. 数据规模:小规模时简单算法可能更快")
print("3. 内存访问模式:缓存友好的算法性能更好")
print("4. 分支预测:减少条件分支可提高性能")
print("5. 编译器优化:现代编译器能显著优化代码")
print("6. 硬件特性:利用SIMD等特性可大幅提速")

模式识别期末笔记

基于模式识别期末考纲最后一个part,符号源于课程讲义,整理了关于MLP及其网络训练、反向传播算法的相关笔记。

PDF file