生物信息学学习笔记:第 1 章 绪论
0. PDF 内容检查
1. 书名 / 章 / 节 / 小节结构
- 书名:生物信息学(第二版)(中文教材,配套有《生物信息学实验指导》)
- 章标题:第 1 章 绪论
- 节与小节结构(严格按 PDF 顺序):
- 第一节 生物信息与生物信息学
- 一、迅速增长的生物信息
- 二、生物信息学概念
- 第二节 生物信息学历史与展望
- 一、发展简史
- 二、应用领域
- 三、学科展望
- 习题(5 题)
- 历史与人物:“bioinformatics”之名的由来(Paulien Hogeweg / 林华安 Hwa A. Lim)
- 第一节 生物信息与生物信息学
2. PDF 页与印刷页对应
- PDF 共 15 页,对应教材印刷页码 第 1~15 页(页脚可见“第 1 章 绪论 1/2/3…”与“生物信息学 2/4/6…”交替,为奇偶页页眉页脚)。对应关系基本 1:1。
3. 缺页 / 重复 / 乱码 / OCR 错误
- 无明显缺页,章节从开头到习题、历史人物完整。
- 存在少量 OCR/排版小瑕疵:
- 图 1.1 的坐标轴数字(14/12/10…)与图注被打散夹在正文里,图本身无法从文本还原,只能读文字说明。
- 个别外文拼写按原文保留(如 “Fleischman” 应为 Fleischmann、“Ensemble” 应为 Ensembl、“Neighbour-Joining”),这些是教材/OCR 层面的小笔误,我在术语表会给出正确写法。
- “kisac.ki.se,现为 www.bea.ki.se” 一句被排到图 1.2 描述前面(排版跨页所致),不影响理解。
4. 图表公式可识别性
- 图 1.1~1.7 只能读到文字标题和说明,图像内容(曲线、漫画、网页截图)无法从文本判读。
- 表 1.1(学科发展主要事件)、表 1.2(高被引论文)文本完整可读,是本章最有价值的可提取信息。
- 本章无任何数学公式。
5. 是否完整章节:是,绪论完整。
6. 缺失上下文:本章多次以“详见第 2/3/4 章”“附录 2”指向后续内容(数据类型、数据库、序列联配、系统发生等),这些属于后续章节,不在本 PDF 中。
1. 本节定位与知识地图
1. 本章解决什么问题
回答三个入门问题:①什么是生物信息(biological information)以及它为何爆炸式增长;②什么是生物信息学(bioinformatics)这门学科;③它从哪来、往哪去(历史、应用、展望、就业、我国发展)。
2. 在全书与整个学科体系中的位置
它是全书的“地图与导言”:先建立“数据海洋”的世界观和学科边界,再由后续章节逐一展开数据类型(第 2 章)、数据库(第 3 章)、序列联配(第 4 章)等。
3. 属于哪个子领域:学科概论 / 学科史,不属于任何具体计算子领域。
4. 在真实研究 pipeline 中的位置:不对应任何 pipeline 步骤。它是“为什么要有 pipeline”的动机层。
5. 上游输入 / 6. 下游分析:不适用(无数据流)。可类比理解为:上游是“测序技术产生海量数据”,下游是“本书后续所有分析方法”。
7. 与其他章节 / 实验指导的对应
- 与主教材:第 2 章(数据类型)、第 3 章(数据库、Dayhoff)、第 4 章(序列联配、Waterman)、进化分析章(Sankoff、NJ、自举法)均在本章被点名预告。
- 与《实验指导》:本章本身无配套实验,但它列出的工具(BLAST、ClustalW、ORF finder、HMMER、FGENESH、NCBI/EBI 在线服务)正是后续实验的主角。
前置知识
- 生物学:中心法则(DNA→RNA→蛋白质)、碱基与氨基酸、基因/基因组的基本概念。
- 数学统计:本章几乎不需要;仅需理解“数据量指数增长/翻番”这类直觉。
- 算法/数据结构:无硬性要求;了解“动态规划、图论”是名词即可(后续章节才展开)。
- 编程工具:无;但本章明确建议未来要会 命令行 + Python/Perl + C/C++,会用 Unix/Linux。
知识结构树
1 | 绪论(生物信息学是什么) |
2. 按教材顺序精读
第一节 · 一、迅速增长的生物信息 【应该理解】
- 要回答的问题:生物信息指什么?增长有多快?
- 主要内容:生物信息包含分子序列(核酸/蛋白)、蛋白二级/三维结构等;原始数据构成初级数据库,分析衍生数据构成二级数据库;核酸库数据约每 14 个月翻一番。
- 核心结论:数据爆炸 → 催生“如何有效管理、准确解读、充分使用”的新需求。
- 重要术语:初级数据库(primary database)、二级数据库(secondary database)、功能区/结构域(domain)、WGS。
- 数据(作为素材):DNA 字母表 {A,T,G,C};蛋白 20 个氨基酸字母;GenBank 2000 年底 >100 亿 bp,2020 年 4 月 4158 亿 bp(+WGS 7.8 万亿 → 合计约 8.2 万亿 bp / 14.8 亿条)。
- 方法:无(描述性)。
- 易错点:“每 14 个月翻一番”是核酸库的历史经验值,不同来源/年份数字不同(人类基因组测序另有“每 5–7 个月翻番”)——不要当作精确定律。
- 前后关系:为下一小节“为何需要一门新学科”做铺垫。
- 页码/图:印刷 p.1–2,图 1.1(GenBank/WGS 增长曲线)。
第一节 · 二、生物信息学概念 【必须掌握】
- 要回答的问题:生物信息学是什么?
- 主要内容:一般定义=研究生物信息的采集、处理、存储、传播、分析、解释;三大组成部分=①新算法与统计方法;②数据分析与解释;③数据管理利用工具。引用 Claverie(2000)、Wikipedia 定义。研究范式=假设—实验(如“该序列在库中无同源序列”是无效假设,数据库搜索就是一次验证实验)。
- 核心结论:生物信息学不是“移植信息学技术到生物学”的纯应用技术,而是有丰富科学内涵、有大量未解科学问题(生物学的+计算的)的独立学科。
- 重要术语:bioinformatics、假设—实验模式、无效假设。
- 方法/数据:无。
- 易错点:两个常见误解——“人人可做/不花钱/软件都免费”与“只是敲键盘写论文”。教材明确反驳:需算力投入、需实验验证、需想象力。
- 前后关系:给出全书立场(学科定位),承上(数据爆炸)启下(历史)。
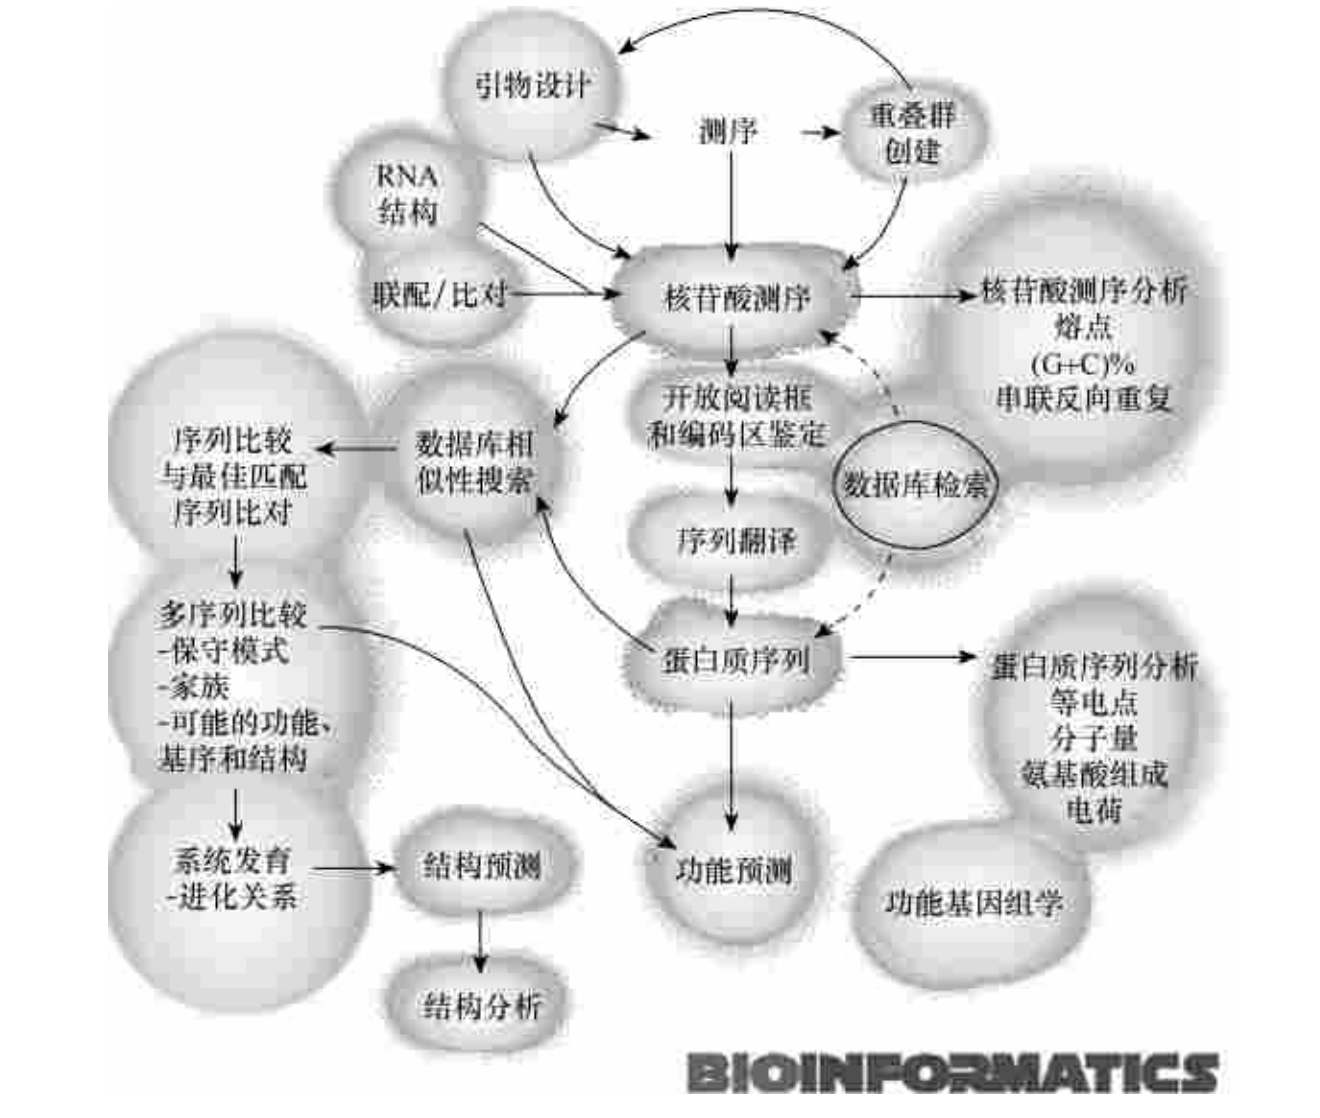
- 页码/图:p.2–4,图 1.2(早期“路线图”)、图 1.3(NCBI 在线工具网页)。
第二节 · 一、发展简史 【应该理解 + 部分必须掌握】
- 要回答的问题:这门学科怎么来的?关键里程碑有哪些?
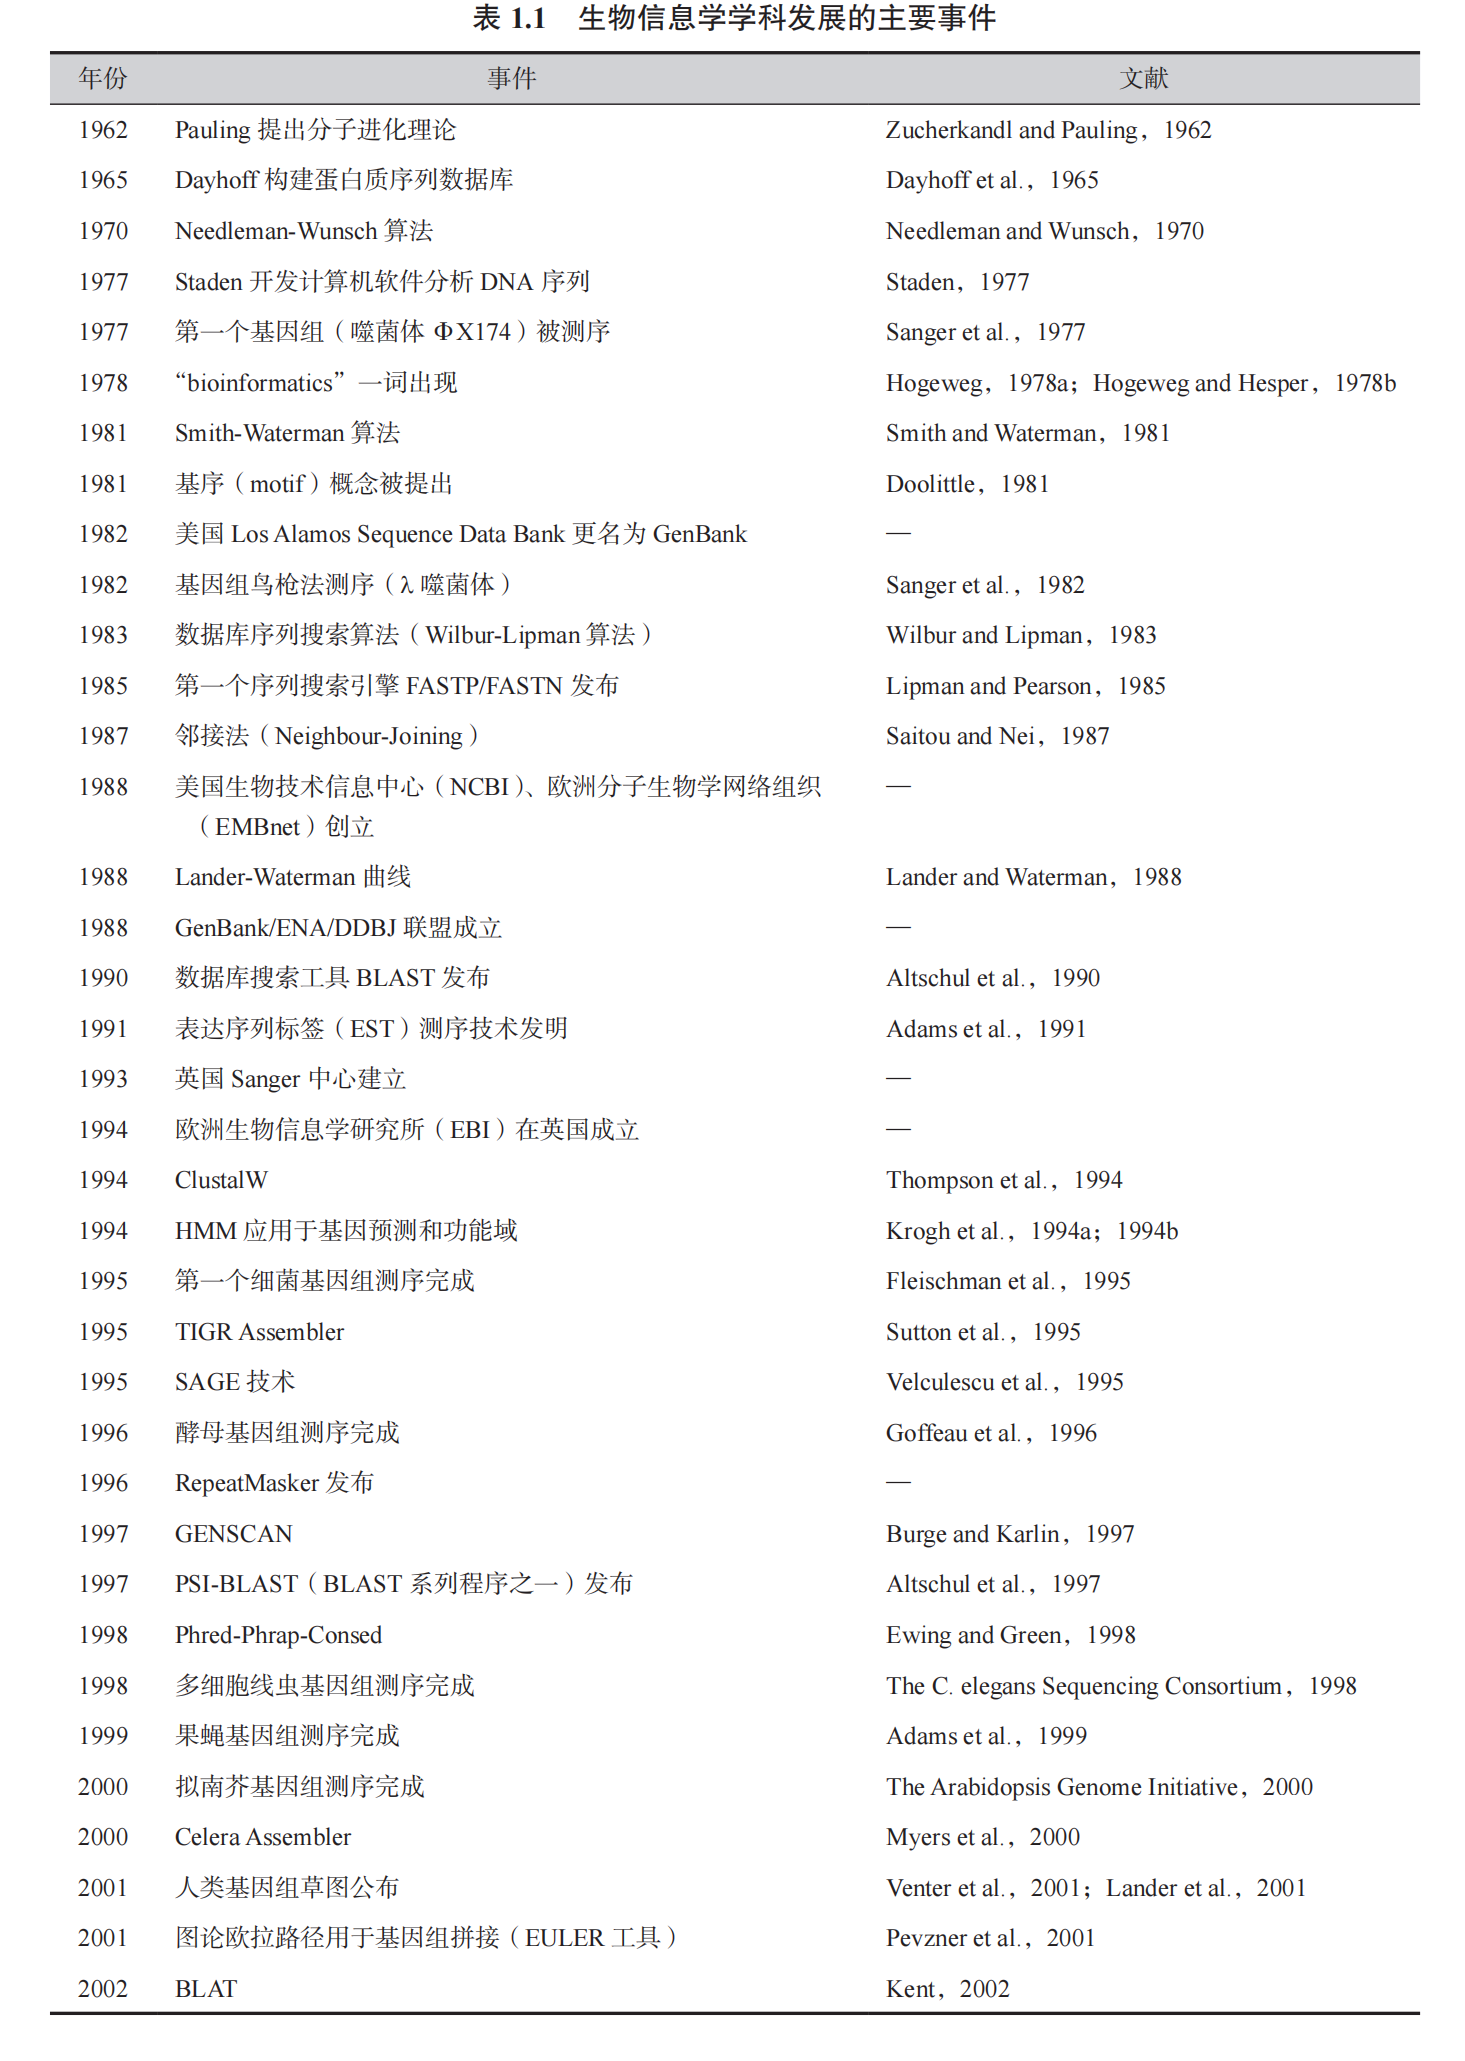
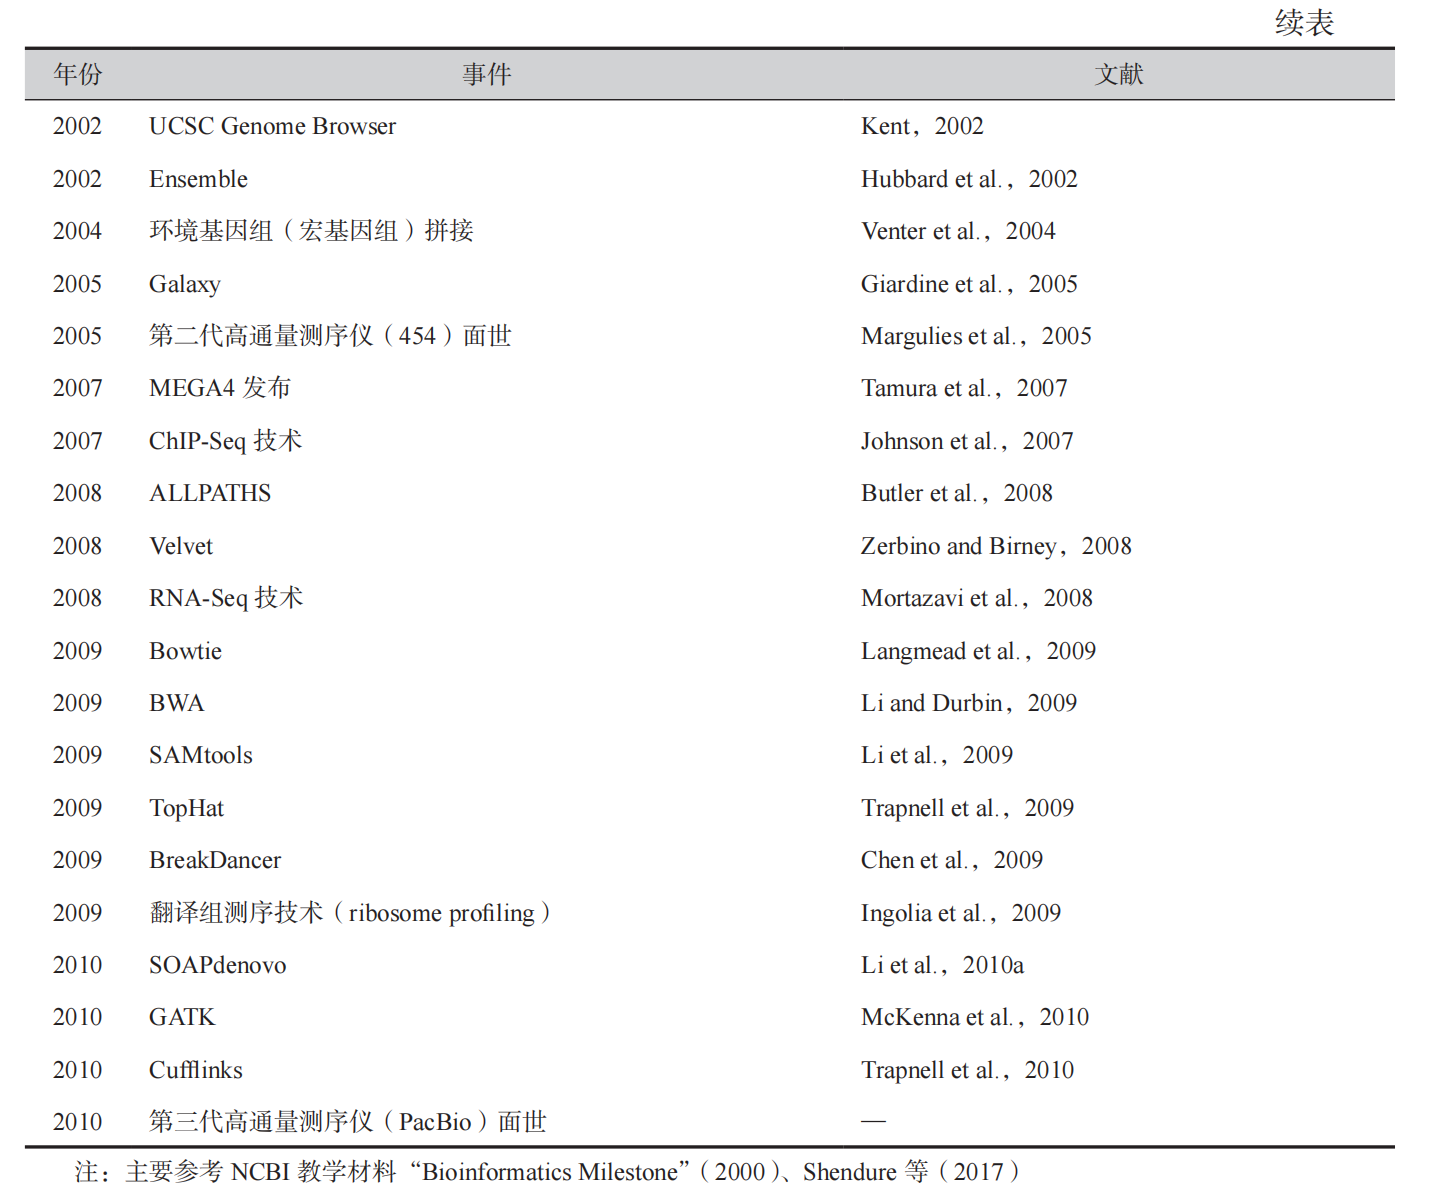
- 主要内容:起源可追溯到 1960s;术语最早由 Paulien Hogeweg (1978) 提出(“the study of informatic processes in biotic systems”),另一说 1990 年由 林华安 (Hwa A. Lim) 提出并办首届会议。学科奠基人:Margaret Dayhoff、Michael Waterman、David Sankoff。四阶段划分(必须掌握):①萌芽期(1960s–70s,Dayhoff 替换矩阵、Needleman-Wunsch);②形成期(1980s,分子数据库+BLAST/FASTA);③基因组与互联网期(1990s–2005,基因组测序、Phred-Phrap-Consed、在线数据库);④高通量测序期(2005 至今,NGS/三代)。
- 核心结论:最核心的算法在 1960–70s 就已奠基(序列联配是最基本内容),之后是不断改进。
- 重要术语:替换矩阵、Needleman-Wunsch、Smith-Waterman、BLAST/FASTA、Phred-Phrap-Consed、NGS。
- 数据:表 1.1(发展大事记)——本章最值得记的干货。
- 易错点:术语“谁最早提出”有两种说法(Hogeweg 1978 vs Lim 1990),教材两者并存;别只记一个。
- 前后关系:承接“学科定位”,为“应用/展望”提供时间脉络。
- 页码/表:p.4–7,表 1.1。
第二节 · 二、应用领域 【应该理解】
- 问题:生物信息学有什么用?入门者能做什么?
- 主要内容:Nature 高被引 100 篇中生物信息学(含系统发生)占 10 篇(表 1.2,含 ClustalW、BLAST、NJ、自举法、MEGA4、ModelTest、MrBayes 等);“平民化”两条路——Windows 桌面软件 与 在线 Web 服务;EBI 把在线平台分三类 SSS(序列搜索)/MSA(多序列联配)/BSA(序列分析);NAR 每年 Database Issue(1993 起) 和 Web Server Issue(2004 起) 两大专刊是“两座桥梁”。给出“何时该找专业人员帮忙”的判据(>100 条序列、需 Linux、NGS、大规模芯片数据、复杂统计等)。
- 核心结论:绝大多数生物学家日常工作集中在数据库搜索 + BLAST + ClustalW。
- 术语:SSS、MSA、BSA、workflow management system、Database Issue、Web Server Issue。
- 易错点:“在线服务方便”≠“适合所有场景”;超过一定规模/复杂度必须转向命令行与专业分析(本章已明说)。
- 前后关系:把历史落到“今天能干嘛”,并引出展望。
- 页码/表:p.8–9,表 1.2。
第二节 · 三、学科展望 【了解即可 + 少量必须掌握】
- 问题:学科往哪走?我国现状?关键待解难题?就业?
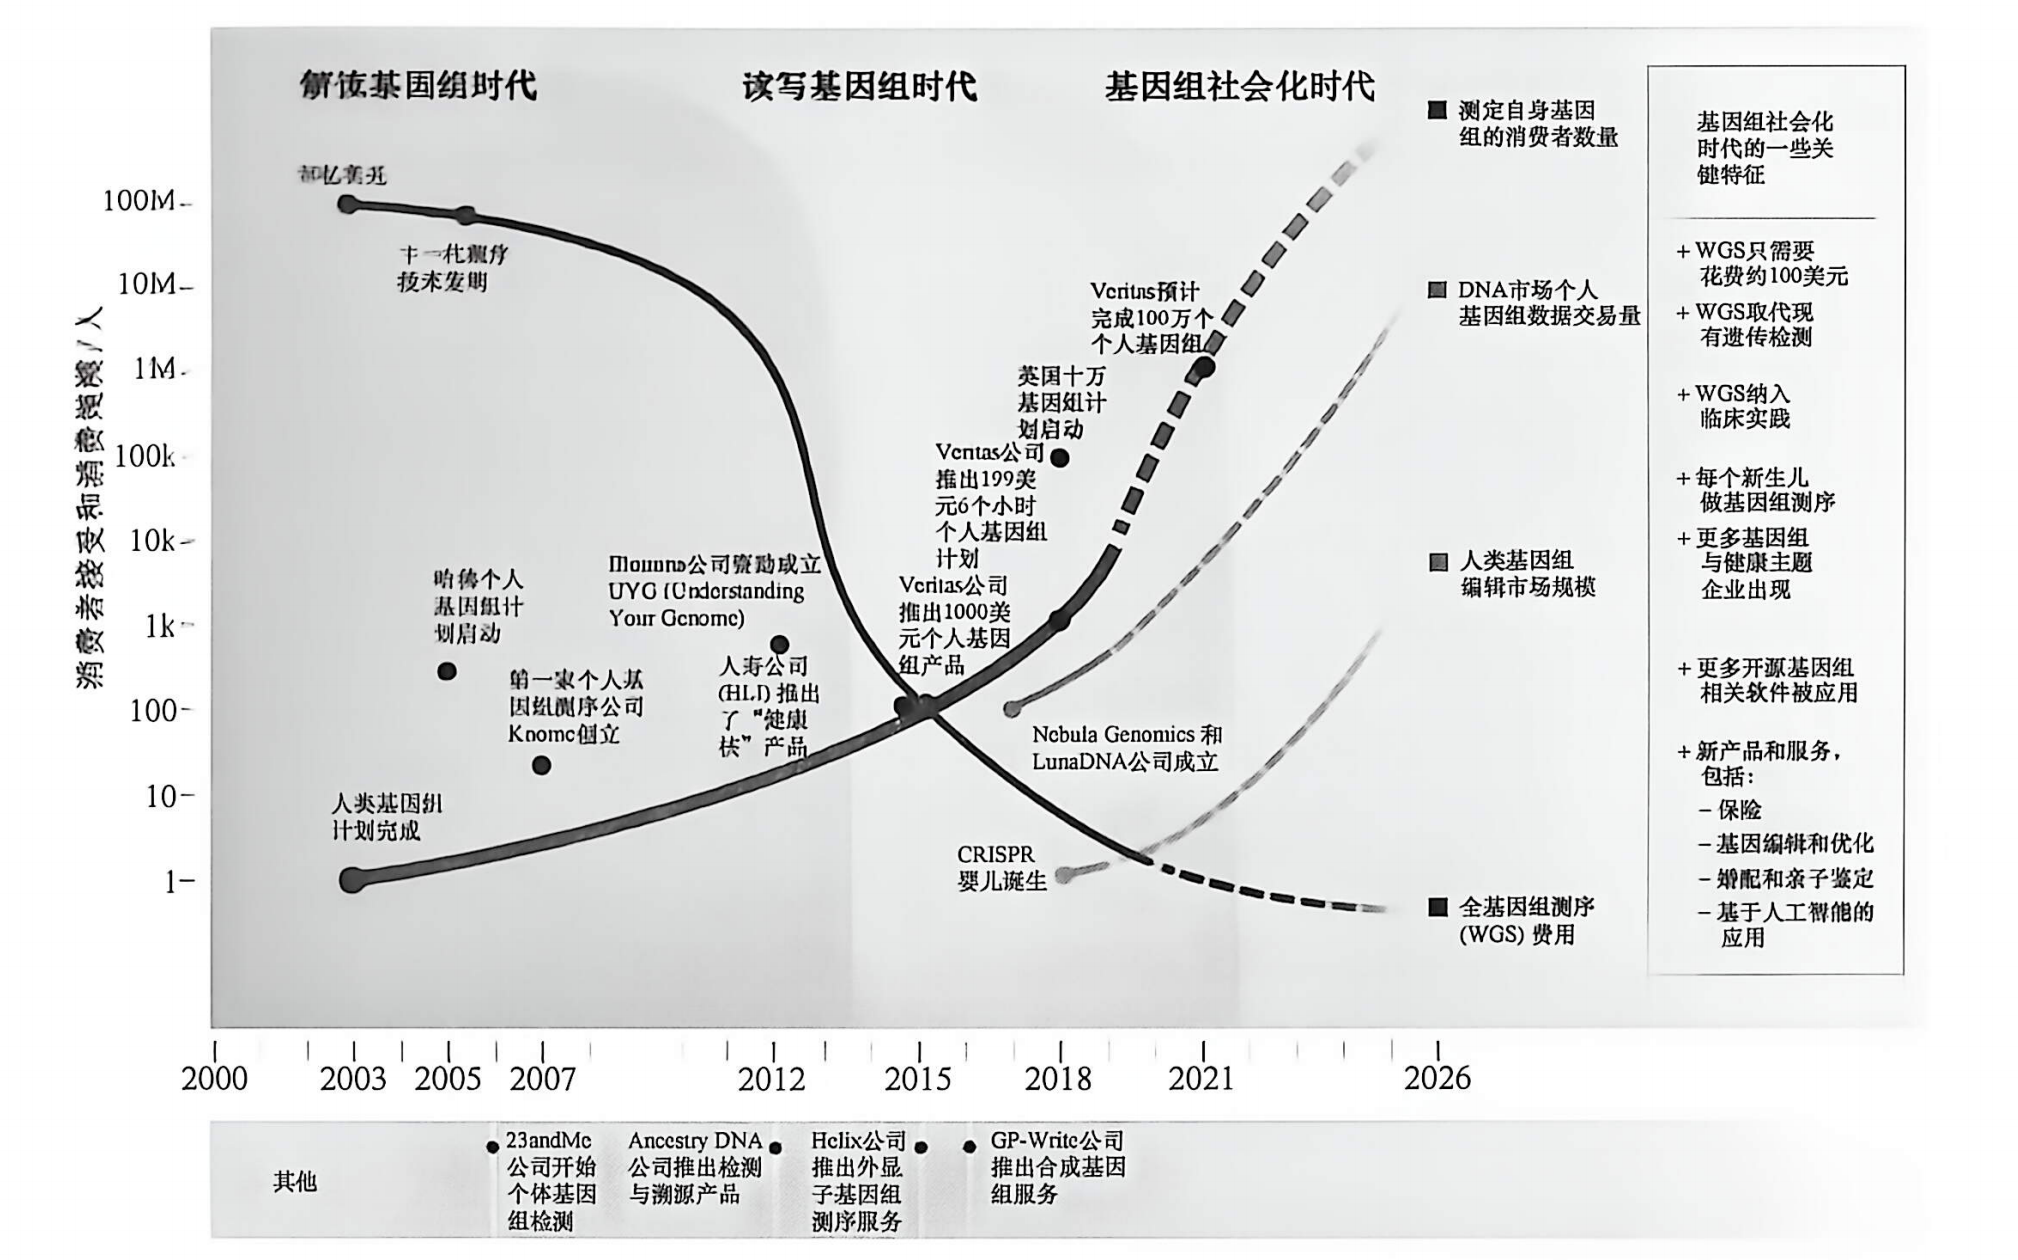
- 主要内容:研究重心从数据积累转向数据解读(图 1.4);人类基因组测序数据每 5–7 个月翻番(图 1.5);从“读懂基因组”走向“书写基因组/基因组社会化”(图 1.6);我国机构与人物(北大 CBI、清华、NGDC/CNCB/CNGB、终身成就奖名单);五大急需攻关技术(必须掌握其类别):①大基因组从头组装;②基因组注释;③比较基因组与进化;④群体重测序变异检测(SNP/Indel/SV/CNV);⑤RNA 分析。
- 核心结论:大数据时代“产生 > 处理能力”,生物信息学是瓶颈也是马达;就业前景好但要求“生物学理解 + 编程 + 统计 + Linux + 沟通”。
- 术语:de novo assembly、注释 annotation、SNP/Indel/SV/CNV、精准医疗、合成生物学、后基因组时代。
- 易错点:图 1.5/1.6 的“预测曲线”是预测,教材已注明“实际增长超过预测”——别把预测当事实。
- 前后关系:收束全章,指向后续章节的技术内容。
- 页码/图:p.9–14,图 1.4–1.7。
习题 & 历史与人物 【了解即可】
- 习题 5 道(见第 14 节 G 我已整理并给参考答案思路)。
- 人物:Hogeweg(1978,理论生物学,迭代多序列联配、RNA 折叠预测);林华安(1988 提 bio-informatique→bioinformatics,1990 办首会)。属背景故事。
3. 生物学问题到计算问题的映射
本章是导论,没有一个具体的计算任务可映射。但它反复给出了整个学科的“总链路直觉”,我据此给出学科级映射(而非某算法的映射)。
- 生物学对象:核酸/蛋白质序列、结构、表达、通路、群体变异。
- 不可直接观测的状态:基因功能、进化关系、调控机制、分子结构。
- 原始生物学问题:如何管理、解读、使用爆炸增长的生物数据。
- 实验技术测量:(测序等)——本章不展开,属后续章节。
- 计算任务归类(本章点名的学科任务,非本章实现):序列搜索(BLAST)、序列比对/联配(NW/SW/ClustalW)、基因组拼装(assembly)、基因预测/分类(HMM、GENSCAN)、系统发生推断(NJ、MrBayes)、变异检测(SNP/SV)。
- 转换中丢失/推断的东西:本章的核心洞见是——生物信息学结论大多是“预测/估计”,是指示实验方向的“路灯”,最终仍需湿实验验证(“你最终还是需要具体的实验”)。
学科级链路(本章的世界观):
1 | 生物学问题(功能/进化/机制) |
4. 数据对象、文件格式和 shape
本章不定义任何文件格式,也没有可给出 shape 的数据矩阵。为忠实原文,我只把本章**提到的“数据概念”**列出,并标注“具体格式见后续章节”。请不要把下表当作可直接编程的对象。
| 数据对象 | 生物学含义 | 产生方式 | 文件格式 | 字段含义 | shape | 备注 |
|---|---|---|---|---|---|---|
| 核酸序列 | DNA/RNA 一级序列 | 测序仪 | 本章未给(后续 FASTA 等) | — | 概念上 seq ∈ {A,T,G,C}^L |
字母表 4 字符 |
| 蛋白质序列 | 氨基酸一级序列 | 由核酸推导/测定 | 本章未给 | — | seq ∈ {20 aa}^L |
字母表 20 字符(教材列出 A R N D C Q E G H I L K M F P S T W Y V) |
| 初级数据库 | 原始序列/结构集合 | 测序/结构测定汇交 | GenBank/EMBL/DDBJ(名称提及,格式未展开) | — | — | 三库联盟 |
| 二级数据库 | domain/二级结构/疏水位点等 | 对原始数据分析 | 未展开 | — | — | 衍生信息 |
| 结构数据 | 蛋白二级/三维结构 | 结构测定/预测 | 未展开 | — | — | 后续章节 |
唯一可明确写出的“数据表示”直觉(本章反复强调):
- 一批 DNA 序列:
sequences ∈ {A,T,G,C,N}^(n × 变长) - 一批蛋白序列:
sequences ∈ {20 种氨基酸,X}^(n × 变长)
坐标系统、0/1-based、链方向、FASTA/FASTQ 结构等——本章均未涉及,属第 2–3 章。
5. 端到端数据处理流程
本章不适用(无 pipeline)。
它只给出了“学科级的宏观流程直觉”(见第 3 节链路图),以及一个重要的实践决策规则(值得记):
何时从“在线服务/桌面软件”升级到“找专业人员 / Linux / 脚本 / workflow”:
- 序列数 > ~100
- 需要 Linux-only 软件
- 使用高通量测序数据
- 大规模数据(如芯片/表达矩阵)
- 数据结构/完整性有问题
- 需要复杂统计(多假设/前提/检验)
这条规则本身就是你未来搭建真实 pipeline 的“分流开关”。
6. 算法、统计模型和公式
本章不适用——无任何算法细节或公式。
但本章点名了后续要学的核心算法,先建立“待学清单”(都不在本章展开):
| 算法/模型 | 首次年份 | 任务类别 | 将在哪学 |
|---|---|---|---|
| Needleman-Wunsch | 1970 | 全局序列联配(动态规划) | 第 4 章 |
| Smith-Waterman | 1981 | 局部序列联配(动态规划) | 第 4 章 |
| Dayhoff/PAM 替换矩阵 | 1965/1978 | 打分矩阵 | 第 3/4 章 |
| BLAST/FASTA | 1990/1985 | 数据库序列搜索(启发式) | 后续章 |
| Neighbor-Joining | 1987 | 距离法建树 | 进化章 |
| 自举法 Bootstrap | 1985 | 系统发生置信度 | 进化章 |
| HMM (GENSCAN/功能域) | 1994/1997 | 基因预测/domain(概率模型) | 后续章 |
| MrBayes | 2003 | 贝叶斯系统发生推断 | 进化章 |
7. 软件、数据库与工具
本章是“工具全景图”,非常适合建立总览。以下区分教材角色与现状。
| 工具/数据库 | Pipeline 位置 | 用途 | 教材角色 | 当前状态 |
|---|---|---|---|---|
| GenBank / EMBL(ENA) / DDBJ | 数据存储 | 国际核酸序列数据库(三库联盟) | 经典+现代 | 仍在用(EMBL 现为 ENA) |
| NCBI / EBI / BIGD(NGDC) | 门户 | 数据+在线分析 | 现代常用 | 活跃 |
| BLAST / PSI-BLAST | 序列搜索(SSS) | 相似性搜索 | 经典+现代 | 仍是标准工具 |
| FASTA/FASTP/FASTN | 序列搜索 | 早期搜索引擎 | 经典 | 较少用,历史地位重要 |
| ClustalW / Clustal X | 多序列联配(MSA) | MSA | 经典 | 部分被 MAFFT/MUSCLE 取代 |
| ORF finder / HMMER / FGENESH | 序列分析(BSA) | ORF/结构域/基因预测 | 教材工具 | HMMER 仍主流 |
| Phred-Phrap-Consed | 测序碱基识别/拼接 | Sanger 时代主力 | 经典 | 已被 NGS 工具取代 |
| Bowtie/BWA/SAMtools/GATK/TopHat/Cufflinks | 比对/变异/RNA-Seq | NGS 分析 | 现代常用 | 仍高度活跃(表 1.1 提及) |
| Velvet/SOAPdenovo/ALLPATHS/Celera/EULER | 基因组拼接 | de novo assembly | 经典/现代混合 | 部分被 SPAdes/长读工具取代【需要查证具体版本】 |
| UCSC Genome Browser / Ensembl / Galaxy | 浏览/workflow | 可视化与流程 | 现代常用 | 活跃 |
| MEGA4 / ModelTest / MrBayes | 系统发生 | 建树/模型选择/贝叶斯 | 经典+现代 | MEGA 已到 MEGA11+ |
教材实验偏向在线服务 + Windows;真实科研需补充:
- Linux 命令行版(如
blastn/blastp、mafft、hmmsearch、bwa mem、samtools、gatk); - 批量/脚本化(Bash + Python/R);
- workflow(Nextflow / Snakemake / Galaxy);
- 环境管理(conda/mamba、容器 Docker/Singularity);
- HPC(SLURM 作业调度)。
- 本章给出的官方入口(部分可能变动,需要查证):
www.bea.ki.se(早期路线图)、bigd.big.ac.cn(NGDC)、www.bioinformatics.org。
8. 实验设计、QC、偏差与结果解释
本章无具体数据分析,故传统 QC 项目不适用。但它明确了一条方法论红线,值得抽成检查清单:
分析前检查清单(本章精神)
- 我是否清楚自己的无效假设是什么?(如“该序列无同源序列”)
- 数据规模/复杂度是否超过在线工具能力(>100 序列、NGS、需 Linux)?
- 我是否具备该问题的生物学背景知识(避免误解合作方需求)?
结果解释检查清单(本章反复强调)
- 我的结果是预测/估计还是观测事实?(生物信息学多为预测=“路灯”)
- 是否需要湿实验验证?(“你最终还是需要具体的实验”)
- 相关性是否被误当因果?
能/不能由本章支持的结论
- 能支持:学科定义、历史脉络、工具全景、方法论立场。
- 不能支持:任何具体数据的分析结论(本章无数据分析)。
9. 易混淆概念
| 概念 A | 概念 B | 核心区别 | 联系 | 例子 | 常见误区 |
|---|---|---|---|---|---|
| 初级数据库 primary | 二级数据库 secondary | primary 存原始数据(序列/结构);secondary 存分析衍生数据(domain/二级结构) | secondary 由 primary 分析而来 | GenBank(primary) vs Pfam-类 domain 库(secondary) | 以为二级=次要/低质量 |
| 生物信息学 bioinformatics | 计算生物学 computational biology | 侧重不同、常混用;前者偏数据/工具/数据库,后者偏建模/理论 | 高度重叠,界限模糊 | Claverie 一文即讨论二者关系 | 认为完全等同或完全不同 |
| 序列相似性 similarity | 同源性 homology | 相似是可测量的数值;同源是“有共同祖先”的进化推断 | 高相似常提示同源,但相似≠一定同源 | BLAST 报 similarity;结论说 homolog 是推断 | 把高相似直接当作同源 |
| SSS / MSA / BSA | — | EBI 三类在线平台:搜索/多序列联配/序列分析 | 常串联使用 | BLAST(SSS)→ClustalW(MSA)→ORF finder(BSA) | 把三类混为一谈 |
| 预测 prediction | 事实/注释验证 | 计算预测 vs 实验证实 | 预测指导实验 | 基因预测≠已证实的基因 | 把预测当已确证 |
| 从头拼接 de novo | 参考比对 mapping | 无参考 vs 有参考 | 都属基因组分析第一步族 | de novo assembly vs BWA mapping | 本章仅提名,细节在后续章 |
10. Toy example
本章不适用(无可计算的方法)。
作为替代,给一个能手工完成的“字母表核对”小练习(源于本章唯一具体的“数据”——字母表):
- 生物学背景:本章说 DNA=4 字符、蛋白=20 字符。
- 练习:教材列出的 20 个氨基酸单字母为
A R N D C Q E G H I L K M F P S T W Y V
→ 数一数是否恰好 20 个?(答案:是,20 个) - 反向核对:标准 20 种氨基酸单字母中未在 DNA 字母表出现的、也未被用作特殊符号的字母有哪些?(如 B、J、O、U、X、Z 不在标准 20 内;X 常表示未知氨基酸,N 常表示未知核苷酸)
- 意义:理解“alphabet”是后续所有序列算法的基础(打分矩阵、联配、搜索都建立在字母表上)。
最小项目目录(供你未来做真实实验时预先建立的规范,本章不产出文件):
1 | project/ |
11. 从教学实验到真实科研
本章无配套实验,但它本身就在讨论“教学式在线工具 vs 真实科研”的差别,我据此整理:
| 维度 | 教材/在线服务式(本章描述) | 真实科研流程 |
|---|---|---|
| 数据规模 | 少量序列(<100) | 海量(NGS、群体、芯片) |
| 运行环境 | Windows/浏览器点击 | Linux/HPC/云 |
| 工具 | 在线 BLAST/ClustalW | 命令行 + workflow |
| 参数 | 多用默认 | 显式记录、可调 |
| 自动化 | 手工逐条 | 脚本/Snakemake/Nextflow |
| 可复现 | 弱(无日志) | 强(版本+种子+env) |
| QC | 几乎无 | 系统化 QC |
| 计算资源 | 一台 PC | 多核/大内存/集群 |
| 结果验证 | 依赖直觉 | 对照+统计+湿实验 |
本章要训练的能力:建立学科世界观 + 知道有哪些工具 + 明白“何时该升级到专业流程”。
真实项目必须补充:命令行技能、脚本化、版本与参数记录、统计设计、验证。
12. 与现代机器学习的联系
本章只在“展望/就业”中点到 AI、机器学习、数据挖掘、模式识别、文本挖掘、Hadoop/MySQL,作为“未来趋势与就业技能”,没有任何可建模的数据或标签。
- 是否适合把本章内容做成 ML 任务:不适用。
- 唯一可记的联系(学科层面):教材把“模式识别、数据挖掘、机器学习、可视化”列为生物信息学实现目标的手段,并把 HMM 作为早期概率序列模型的代表(1994/1997)——这是经典方法通向现代序列建模(乃至今天的深度学习/大模型)的历史脉络起点。
13. 研究复现视角
本章不涉及可复现的分析,故传统复现清单不适用。
但本章提出了一个与复现直接相关的重要主张(值得作为科研伦理/复现意识记住):
- 数据共享与尽早释放:HGP 采用“正式发表前即上网释放”的政策,许多基因组计划沿用。
- 复现的前提是原始数据(primary data)可获取——本章反问:“测序仪每天产生的初级数据归谁所有?何时公开?能否设限?”这些正是今天数据可获得性 / 复现性的核心议题。
给你的实操提醒:从现在起养成记录 软件版本、数据库版本(如 GenBank Release 号)、访问日期、参数 的习惯——本章多处引用“GenBank Release 120/236”“数据截至 2020 年 2 月”,正示范了“引用数据库要写版本和日期”。
14. 最终汇总
A. 一页式总结
- 核心生物学问题:生物数据爆炸(核酸库约每 14 个月翻番),如何管理、解读、使用。
- 核心实验:无(本章为导论);学科动机来自高通量测序。
- 核心数据:核酸序列 {A,T,G,C}、蛋白序列(20 氨基酸);初级 vs 二级数据库。
- 核心 shape:
seq ∈ {A,T,G,C}^L(概念性)。 - 核心算法:无本章算法;预告 NW/SW/BLAST/HMM/NJ 等。
- 核心工具:BLAST、ClustalW、NCBI/EBI 在线服务(SSS/MSA/BSA)。
- 核心 pipeline:无;给出“何时升级到 Linux/专业流程”的分流规则。
- 核心假设/范式:假设—实验模式(数据库搜索=一次实验)。
- 核心 QC:区分“预测”与“事实”。
- 核心解释边界:生物信息学结论多为预测,是“路灯”,最终需湿实验验证。
B. 必须记住的知识点(12 条)
- 生物信息学=研究生物信息的采集/处理/存储/传播/分析/解释的学科(分子生物学+遗传学+计算机科学)。
- 三大组成:新算法与统计、数据分析与解释、数据管理工具。
- 初级数据库(原始) vs 二级数据库(衍生 domain/结构等)。
- DNA 字母表 4 个;蛋白字母表 20 个(会背单字母更好)。
- 术语提出者两说:Hogeweg(1978) / 林华安(1990)。
- 三位奠基人:Dayhoff、Waterman、Sankoff。
- 历史四阶段:萌芽/形成/基因组与互联网/高通量测序。
- 里程碑算法年份:NW 1970、SW 1981、NJ 1987、BLAST 1990、HMM 应用 1994。
- 三大数据库联盟:GenBank + EMBL(ENA) + DDBJ。
- EBI 在线平台三类:SSS / MSA / BSA;NAR 两大专刊:Database Issue(1993)、Web Server Issue(2004)。
- 研究范式=假设—实验;结论多为预测,需实验验证(“最终还是需要具体的实验”)。
- 五大待攻关技术:从头组装、注释、比较基因组/进化、群体变异检测(SNP/Indel/SV/CNV)、RNA 分析。
C. 术语表
| 缩写/术语 | 英文全称 | 中文含义 | 本节作用 |
|---|---|---|---|
| bioinformatics | bioinformatics | 生物信息学 | 学科主题 |
| primary database | primary database | 初级数据库 | 存原始数据 |
| secondary database | secondary database | 二级数据库 | 存衍生信息 |
| domain | domain | 结构域/功能区 | 二级数据库内容 |
| WGS | Whole Genome Shotgun | 全基因组鸟枪法(数据) | GenBank 单列大类 |
| NGS | Next-Generation Sequencing | 二代/高通量测序 | 第四阶段核心 |
| SSS | Sequence Search Service | 序列搜索服务 | EBI 平台分类 |
| MSA | Multiple Sequence Alignment | 多序列联配 | EBI 平台分类 |
| BSA | Biological Sequence Analysis | 生物序列分析 | EBI 平台分类 |
| NW | Needleman-Wunsch | 全局联配算法 | 萌芽期里程碑 |
| SW | Smith-Waterman | 局部联配算法 | 形成期里程碑 |
| HMM | Hidden Markov Model | 隐马尔可夫模型 | 基因预测/domain |
| NJ | Neighbor-Joining | 邻接法 | 建树 |
| SNP/Indel/SV/CNV | 见全称 | 单核苷酸多态/插入缺失/结构变异/拷贝数变异 | 群体变异类型 |
| HGP | Human Genome Project | 人类基因组计划 | 数据共享范例 |
| NAR | Nucleic Acids Research | 期刊名 | 两大专刊来源 |
| ISCB | International Society for Computational Biology | 国际计算生物学会 | Bioinformatics 期刊主办 |
| NGDC/CNCB/CNGB | 见正文 | 国家基因组科学数据中心/国家生物信息中心/国家基因库 | 我国机构 |
正名:EMBL Data Library → 现 ENA;表 1.1 中 “Ensemble”应为 Ensembl,“Fleischman”应为 Fleischmann。
D. 数据 shape 汇总表
| 阶段 | 数据对象 | 行/列/字段 | shape | 数据类型 | 文件格式 |
|---|---|---|---|---|---|
| 概念 | DNA 序列 | 字符序列 | {A,T,G,C}^L |
字符 | (后续 FASTA) |
| 概念 | 蛋白序列 | 字符序列 | {20 aa}^L |
字符 | (后续 FASTA) |
本章仅此两项为概念性;无真实矩阵/坐标/文件结构。
E. 工具汇总表
| 阶段 | 工具 | 输入 | 输出 | 核心参数 | QC |
|---|---|---|---|---|---|
| 序列搜索 | BLAST | 查询序列+库 | 相似命中(E-value 等) | 见后续章 | 区分相似/同源 |
| 多序列联配 | ClustalW | 多条序列 | MSA | 见后续章 | 人工检查列 |
| 数据/门户 | NCBI/EBI/NGDC | — | 数据+在线分析 | — | 记录版本日期 |
参数细节本章未给,均属后续章节/官方文档,需要查证。
F. 掌握程度清单
- 应能口头解释:生物信息学定义、三大组成、初级/二级数据库、假设—实验范式、历史四阶段、“预测=路灯,需实验验证”。
- 应能手工计算:本章无(仅字母表计数练习)。
- 应能从头编程实现:本章无算法(NW/SW 留待第 4 章)。
- 应能调用工具完成:能在 NCBI/EBI 上做一次在线 BLAST(作为体验,细节后续学)。
- 应能设计的 pipeline:本章无;但应记住“何时升级到 Linux/脚本/专业流程”的判据。
- 只需知道其存在:具体人物生平、我国机构名单、期刊史、就业调查细节、表 1.1 全部年份(记大事件即可)。
G. 自测题
概念题
- 用一句话给出生物信息学的定义,并列出其三大组成部分。
- 初级数据库与二级数据库有何区别?各举一例。
- 为什么说生物信息学结论常是“预测”而非“事实”?举例说明假设—实验范式。
- 谁被认为是“bioinformatics”一词的提出者?为何有两种说法?
- EBI 把在线分析平台分为哪三类?各对应什么任务?
数据格式与 shape 题
6. DNA 与蛋白质序列的字母表各有多少字符?分别写出。
7. 用集合记号写出“一条 DNA 序列”的概念表示,并说明 L 代表什么。
8. GenBank 为什么把 WGS 数据单列一类?这提示序列数据具有什么特征?
算法/公式题(本章仅涉及“提名”,考查历史定位)
9. Needleman-Wunsch 与 Smith-Waterman 分别属于哪种联配、分属哪个历史阶段?
10. HMM 在生物信息学中最早被用于哪两类任务(举本章提到的例子)?
11. 按提出年份排序:BLAST、Neighbor-Joining、Needleman-Wunsch、Smith-Waterman。
pipeline 设计题
12. 你拿到 500 条蛋白序列要做进化分析,为什么不建议全程用在线网页工具?给出本章依据。
13. 请据本章“何时求助专业人员”的判据,列出至少 4 种应转向专业/Linux 流程的情形。
14. 若要让一次 BLAST 分析可复现,你至少应记录哪些信息?(结合第 13 节)
批判性思考题
15. 教材说数据每若干月翻一番、并给出“预测曲线”,你如何看待“预测被实际超过”这一事实对“数据处理能力滞后”论断的支持或削弱?
16. “人人都能做生物信息学”这一说法错在哪里?请从经费、软件、验证三方面反驳。
参考答案
- 研究生物信息的采集、处理、存储、传播、分析与解释的交叉学科(分子生物学+遗传学+计算机科学);三大组成=新算法与统计方法、数据分析与解释、数据管理与利用工具。
- 初级库存原始数据(如 GenBank 的序列、PDB 的结构);二级库存由原始数据分析衍生的信息(如结构域 domain、二级结构、疏水位点)。
- 因为多数结果是从数据中推断/估计出来的(如同源、基因位置、结构),不是直接观测;它像“路灯”指示实验方向。范式:先立无效假设(如“该序列无同源序列”),用数据库搜索作为“实验”去验证,拒绝或接受假设,最终仍需湿实验确证。
- 两说:Paulien Hogeweg(1978,最早文献)与林华安 Hwa A. Lim(1990 年被普遍认为提出并办首会);因不同来源追溯口径不同,教材两者并存。
- SSS(序列搜索)、MSA(多序列联配)、BSA(序列分析)。
- DNA 4 个:A、T、G、C;蛋白 20 个:A R N D C Q E G H I L K M F P S T W Y V。
seq ∈ {A,T,G,C}^L,L=序列长度(碱基数),不同序列 L 可变。- 因为 WGS(全基因组鸟枪法)数据体量极大(万亿 bp 级),单列便于管理;提示序列数据规模巨大、增长极快、异质。
- NW=全局联配,属萌芽期(1970);SW=局部联配,属形成期(1981)。
- 功能域(domain)分析 与 基因预测(GENSCAN)。
- NW(1970) → SW(1981) → NJ(1987) → BLAST(1990)。
- 序列数已接近/超过在线工具适用上限(本章以 >100 条为经验阈值),且进化分析常需模型选择、自举、复杂统计与批处理,网页工具难以胜任、不可批量、难复现——本章明确建议此类情形求助专业/Linux 流程。
- ①>100 条序列;②需 Linux-only 软件;③使用高通量测序数据;④处理大规模数据(如芯片/表达矩阵);⑤数据结构或完整性有问题;⑥需复杂统计(多假设/前提/检验)。(任列 4 项)
- 查询序列与数据库、数据库版本与访问日期、程序与版本、参数(矩阵、E-value 阈值、gap 罚分等)、运行环境。
- 开放题要点:实际增长超过预测,说明数据产生速度被低估,反而强化“数据产生 > 处理能力”的论断;同时提醒“预测曲线”不可当精确定律,应关注趋势方向而非具体数值。
- ①经费误解:算力/大型机与商业软件昂贵,并非零成本;②软件误解:先进商业软件多需付费,非全免费;③验证误解:计算结果是预测,“最终还是需要具体实验”,仅有电脑和教科书不足以产出可靠科学结论。
H. 下一步学习建议
- 下一节/章:进入第 2 章(生物数据/数据类型),把本章“核酸/蛋白/结构/初级二级库”的概念落到具体文件格式与 shape;随后第 3 章(数据库、Dayhoff)、第 4 章(序列联配 NW/SW,Waterman)。
- 需补的前置:中心法则、碱基/氨基酸生化基础;命令行入门(bash)、Python 基础——本章已明确点名为必备技能。
- 值得亲手实现的算法:读到第 4 章时,自己用 Python 实现 Needleman-Wunsch(本章埋下的最经典起点)。
- 值得实际运行的工具:去 NCBI 做一次在线 BLAST,体验 SSS 流程;再用 EBI 做一次 ClustalW/MSA。
- 值得手工查看的文件格式:下一章的 FASTA(本章尚未出现,但是所有后续分析的入口)。
- 配套实验:本章无专属实验;从第 2/3 章起对接《实验指导》中数据库检索与 BLAST/ClustalW 实验。
- 需查最新官方资料:GenBank/ENA/DDBJ 现状与最新 Release、NGDC(bigd.big.ac.cn)、BLAST/ClustalW 现行版本与替代工具(MAFFT/MUSCLE、DIAMOND)——本章数字截至 2020 年,需要查证更新。